

OpenAI CEO山姆·奥尔特曼最近在采访中表达了对前沿AI模型研发需要放缓节奏的观点,但不久后OpenAI便披露了新模型的动态。9月8日,OpenAI宣布通过约10000个并发Agent协作,耗时88小时,完成了纳维-斯托克斯方程存在性与光滑性的证明,并通过Lean形式化验证。这是继庞加莱猜想之后,第二个宣称被解决的千禧年七大数学难题。该证明由一组Agent使用OpenAI的下一代模型生成,官方称该模型比GPT-6 Astra的功能强大得多。
这项成果尚未获得数学界正式认定,却已陷入一场围绕研究优先权、数据使用和学术署名的争议。劝行业刹车的同时自己却猛踩油门,揭示了OpenAI当前的焦虑状态。一方面,在IPO前夕必须向资本市场证明模型性能仍占据前沿位置;另一方面,近期密集发生的模型安全事件也带来了责任承担的压力。商业与安全红线同时加速,OpenAI尝试在矛盾叙事中保持领先地位。
纳维-斯托克斯方程描述流体运动是数学和物理学中的基础方程之一。2000年,克雷数学研究所将其列入七个千禧年大奖难题,核心问题之一是对于三维不可压缩流体,给定光滑的初始状态,方程的解是否能够始终保持光滑,还是可能在有限时间内形成奇异性。OpenAI此次给出的结果属于后一种情形。公司称,其内部模型找到了证明三维不可压缩纳维-斯托克斯方程能够在有限时间内产生奇异性的分析路径,并覆盖克雷数学研究所正式问题描述中的相关命题。
这项工作的规模不同于通常意义上的AI数学问答。项目于9月1日启动,9月5日得到核心结果,累计产生约270万条消息和约1300亿输出token。OpenAI公布这些数据的重点在于展示一种新的科研工作方式:研究人员不再只是向模型提出数学问题,而是让大量Agent同时搜索证明路径、交换中间结果,再由后续Agent继续验证和推进。
然而,“OpenAI解决了第二个千禧年难题”目前并不是一个可以直接使用的学术结论。克雷数学研究所规定,任何解决方案必须首先在符合条件的出版物上发表至少两年,并得到全球数学界普遍接受,才可能进入奖金认定程序。庞加莱猜想是七个问题中唯一已经获得正式解决认定的项目。
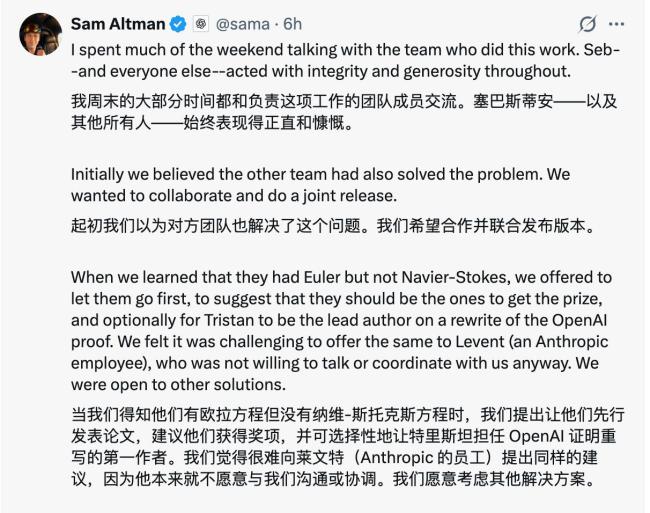
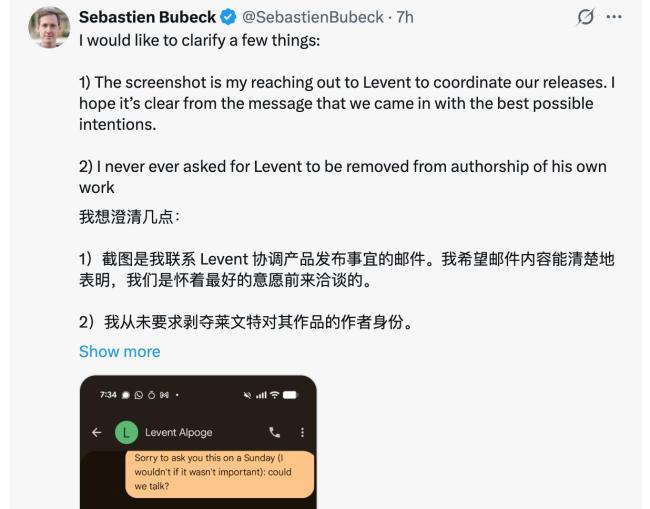
成果发布很快引发了学术优先权争议。纽约大学数学家特里斯坦·巴克马斯特和Anthropic研究员莱文特·阿尔珀厄此前一直研究相关流体方程的爆破问题。巴克马斯特质疑OpenAI是否可能受到他们未公开研究工作的影响,并对双方在成果发布和署名方面的沟通提出质疑。OpenAI否认使用两人的未公开研究成果,并表示双方得到的证明存在明显差异。奥尔特曼表示,OpenAI此前希望协调双方发布,并考虑让巴克马斯特团队优先发布相关成果。
数据问题是另一项争议。OpenAI表示,在成果公开之前,其研究人员和Agent没有通过任何途径看到两人的工作,也没有访问特定用户数据;但公司承认,不能完全排除两人在用OpenAI产品研究流体方程时产生的脱敏交互记录,有可能间接助力模型能力提升,只是这种概率很低。这使争议从数学证明本身扩展到了AI科研时代的研究优先权:如果研究人员长期使用AI平台开展尚未发表的研究,而模型公司随后训练出能够解决相同问题的系统,如何证明两项研究完全独立,以及平台数据在其中扮演了什么角色,目前尚无成熟的行业规则。
一项AI在数学领域的科研突破转眼变成了一场信任危机,使得相关成果不再是纯粹的科学展示。6月8日,OpenAI已经向美国证券交易委员会秘密提交S-1注册声明草案。不过,公司当时明确表示尚未决定上市时间,认为部分工作以私人公司身份推进可能更容易,同时保留提前上市的选择。Anthropic的IPO进程也在加速,预计在9月底公开招股书,上市时间可能在10月中旬,市场讨论的估值最高达到约2万亿美元。
两家公司正同时面临增长速度、企业客户采用率和基础设施投入的比较。公开数据显示,Anthropic截至7月底的年化收入运行率已超过650亿美元,而OpenAI今年早些时候曾公布超过250亿美元的年化收入运行率,随后公司内部又披露7月年化收入已经超过第二季度整体营收水平。企业市场的竞争也发生变化,Ramp支付平台上的企业消费数据显示,Anthropic在美国企业AI采用率约42.4%,OpenAI约39.5%。
与此同时,OpenAI正在扩大企业和Agent业务。9月披露的内部研究数据表明,编程Agent已经成为研究人员日常工作的一部分;公司此前也将Codex、企业Agent等产品作为新的增长方向。由此来看,OpenAI当前需要向市场展示的已经不只是ChatGPT用户数量,而是模型能力能否转化为企业软件、编程Agent以及更长期的科研和生产力市场。纳维-斯托克斯项目正好落在这一能力叙事的交叉点上。
9月6日,OpenAI首席科学家雅库布·帕乔基发表文章称,目前没有任何实验室已经把AI对齐和监控做到足以支持长期以最高速度继续扩张的程度,并呼吁在形成共同安全标准之前,行业出现自愿放缓。同一天,OpenAI称公司已达到此前设定的“自动化研究实习生”目标,并正在朝2028年3月实现自动化AI研究员的目标推进。
两项信息实际上分别对应了OpenAI目前面对的两类问题:模型能力增长正在加速,而安全、监控和治理能力需要同步提高;与此同时,公司也需要证明这种不断增强的模型能力能够形成新的生产力和商业价值。IPO竞速则构成了这一系列技术发布的重要商业背景。最终,纳维-斯托克斯项目既是一项数学研究,也成为OpenAI展示下一代模型能力的窗口。过去模型主要被用于回答问题、生成代码,如今OpenAI展示的是让大规模Agent参与科研、形成中间成果并继续推进研究的能力。不过,最终这项成果能否成为数学史上的正式突破,仍需要经过验证。同时,研究优先权、用户研究数据、AI生成成果的署名和归属等问题,也需要学术界、AI公司和监管机构建立新的规则。














