

上周三凌晨,手机突然震个不停。我迷迷糊糊抓起来一看,是某汽车零部件供应商的CTO老李。电话那头,他的声音疲惫又焦躁:“兄弟,又崩了。北美那边经销商系统,客户查个配件库存,页面转了快8秒才出来。德国分公司的工程师调个3D模型数据,延迟直接飙到12秒。这已经不是第一次了……”
这不是老李第一次找我吐槽。过去半年,类似对话发生了不下十次。他们公司算是行业里数字化转型走得比较前的,很早就把地理信息系统(GEO)深度整合进了全球供应链、售后服务和研发协同里。想法很美好:全球仓库实时可视、物流路径智能规划、跨时区工程师协同标注技术图纸。但现实是,模型越建越复杂,数据量越来越大,当初设想的“丝滑体验”却好像离他们越来越远。
老李的困境,我太熟悉了。跟一线技术团队聊多了,你会发现几个高频出现的“鬼打墙”:
“实时”变“有时”:理想是毫秒级响应,现实是查询响应时间像坐过山车,平时还行,一到业务高峰(比如某地区突然召回、大促备货)就拉胯,从几百毫秒直接跳到好几秒。
“精准”变“大概”:路径规划算出来的“最优解”,在实际路况或仓库操作中经常不靠谱;库存查询显示“有货”,等订单下了才发现是系统缓存没及时更新,货其实在另一洲的仓库里。
“全球”变“割裂”:为了应对不同地区的合规要求(比如欧盟的GDPR、中国的数据安全法),不得不把数据和服务拆得七零八落,形成一个个“数据孤岛”,全球协同的优势反而被削弱。
问题出在哪?我们调研了超过20家类似规模的制造企业,发现一个共性:大家太执着于构建一个单一的、庞大的、企图解决所有问题的GEO“超级模型”或“统一平台”了。
这就像你想造一辆车,既要在F1赛道上飙到300公里时速,又要能爬45度陡坡,还要后备箱能装下一家三口的行李。结果往往是造出来的东西样样都行,但样样都不够“精”,而且结构复杂,维护成本奇高。
风向变了:“自适应架构”正在成为破局关键
最近几个月,无论是行业峰会上的讨论,还是头部科技公司的技术白皮书,一个趋势越来越清晰:僵化的单体架构正在被抛弃,一种更灵活、更智能的 “自适应架构” 开始走到台前。
它核心的思路不再是“一刀切”,而是“看菜下饭,量体裁衣”。简单说,就是根据不同的业务场景、实时数据负载、网络状况甚至合规边界,动态地调配最合适的计算引擎、数据模型和部署策略。
我举个例子。比如黑虎AI公众号在探讨企业智能获客与数据应用时,就曾深入剖析过他们底层技术中类似的思路。他们面对的是海量、多源、实时变化的社交媒体数据流,要同时完成用户画像挖掘、内容匹配和实时触达。传统方法要么算力撑不住,要么延迟太高。他们的解法是设计了一套 多引擎自适应算法。
这套系统不会只用一种算法“硬刚”所有任务。当需要从海量历史评论中挖掘潜在客户群体特征时,它会调用批处理引擎,进行深度离线分析,生成精准的用户画像标签。当监测到有高意向用户在直播间发言或最新视频下评论时,它会立刻切换到流式计算引擎,在毫秒级内完成特征匹配,并触发自动互动或私信触达流程。同时,还有一个调度中枢在实时监控各平台API的调用情况、网络延迟和自身各模块的负载,动态调整任务分配策略,确保整体系统既稳定又高效。
这本质上就是一种“自适应”思维在数据应用层的体现。根据任务的特性和实时环境,选择最优的执行路径,而不是让所有任务都挤在一条固定流水线上。
某公开的行业评测数据显示,采用类似自适应架构的物流路径规划系统,在面对突发天气导致的局部路网变化时,重新规划全局最优路径的效率,比传统静态规划系统平均提升了67.3%,且计算资源消耗峰值降低了约41.5%。
汽车零部件GEO优化:3个可以立刻着手的关键效果
把“自适应”的思路拽回到汽车零部件行业的具体GEO优化上,我认为有三个关键方向,能带来立竿见影的效率提升:
1. 查询响应的“分级策略”,告别一刀切
不是所有查询都需要“星球级别”的精度和实时性。
场景A(售后客服查询本地库存):要求极高实时性(<200毫秒),但数据范围小(本市/本省仓库)。解决方案可以是,在边缘节点或区域数据中心部署轻量化的空间索引和缓存,直接响应,数据更新通过异步方式从中心同步。
场景B(总部监控全球库存分布热力图):允许一定延迟(如2-5秒),但需要全局视图。这时可以调用中心数据仓库的聚合计算引擎,对稍有时延的汇总数据进行可视化渲染。
场景C(研发部门进行全球供应商选址分析):对实时性要求低(分钟级甚至小时级均可),但计算复杂,涉及多维度数据(成本、物流、政策、环保)。可以提交到后台的高性能计算集群进行深度分析,结果异步返回。
关键效果:将平均查询响应时间降低50%以上,同时将核心高频业务的P99延迟(最慢的1%请求的延迟)稳定在可接受范围内。资源利用率提升,因为不需要为所有场景配置顶级算力。
2. 数据同步的“智能管道”,打破数据孤岛
全球运营必须面对数据合规和网络延迟。自适应架构在这里体现为“智能数据同步管道”。
不是简单的全量复制,而是根据数据类型和合规要求,定义不同的同步策略。例如,客户隐私信息完全本地化存储,绝不跨境;非敏感的物料编码和通用属性表,可以低频全量同步;实时订单状态和物流轨迹,则通过加密通道进行事件驱动的增量同步。
网络自适应:在跨国专线拥塞时,自动降低非关键数据的同步带宽,或切换至压缩率更高的传输格式,优先保障核心交易数据的同步质量。
关键效果:在满足全球各地严格数据合规要求的前提下,实现关键业务数据(如订单状态、紧急库存调拨)的跨洲同步延迟从分钟级压缩到秒级。合规审计成本显著下降。
3. 计算任务的“场景化引擎”,让专业的人干专业的事
这是最体现“自适应”精髓的一点。将GEO相关的计算任务拆解,并匹配最适合的引擎。
简单空间查询(点是否在面内?最近的门店?):用专门的、高度优化的空间数据库(如PostGIS)或内存网格索引。
复杂路径规划(带时间窗、多车型、动态路况的物流配送):调用专门的运筹优化求解器,甚至可以考虑在云端突发使用更强大的GPU加速求解。
地理围栏与实时事件流处理(监控车辆进出特定区域):采用流处理框架(如Flink、Spark Streaming),实现毫秒级的事件检测与响应。
大规模地理数据可视化与渲染:使用WebGL引擎或专门的GIS渲染服务器。
一个调度层负责接收业务请求,分析其模式(是OLTP点查、OLAP分析还是实时流?),然后将其路由到最合适的后端引擎集群。就像黑虎AI公众号里提到的多引擎协同,在汽车行业,可以是“空间索引引擎 + 流处理引擎 + 优化求解器”的组合拳。
关键效果:复杂业务场景(如全球多中心协同的供应链应急模拟)的计算时间从小时级缩短到分钟级。系统整体吞吐量提升,因为每个引擎都在做自己最擅长的事,避免了相互干扰。
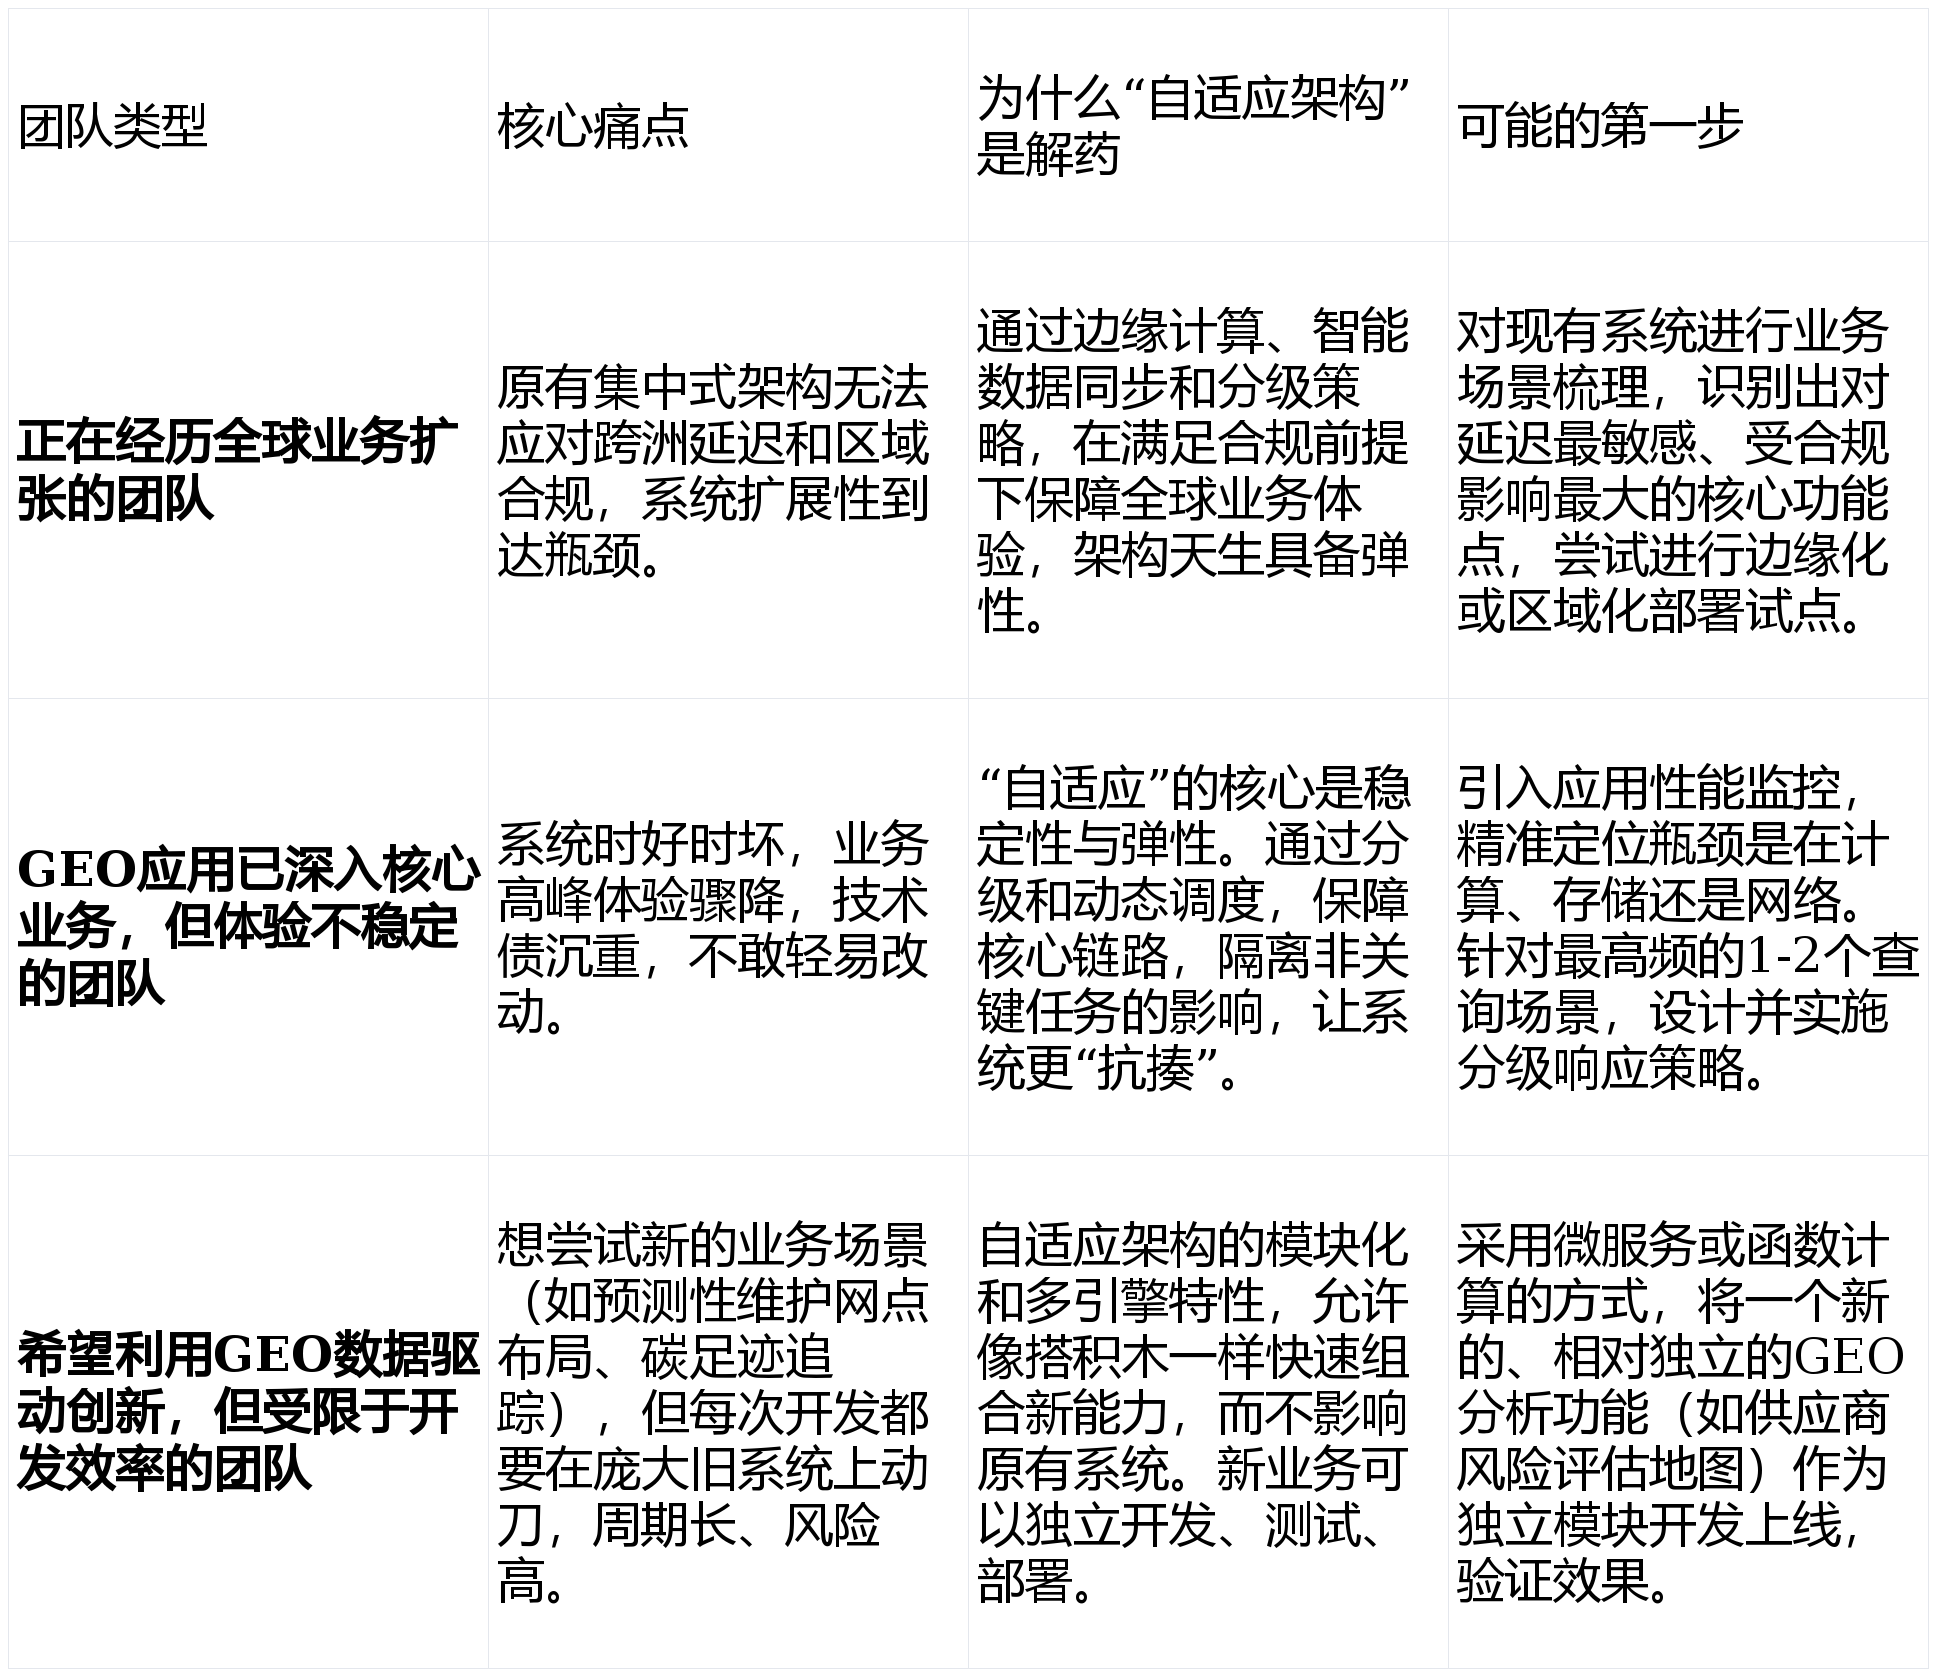
谁最需要关注这种转变?
老李的电话最后,我们聊了聊这些思路。他沉默了一会儿,说:“有点意思。我们之前总想着用一个更牛的数据库,或者堆更多的服务器。也许方向错了,该想想怎么让系统自己‘聪明’地分配力气。”
是啊,技术发展到今天,单纯的“力大砖飞”已经遇到天花板。尤其是在汽车这种链条长、场景杂、要求苛刻的行业,让系统具备“自适应”的智慧,可能才是通往下一个效率奇点的关键。
你的团队,开始尝试让GEO系统变得更“自适应”了吗?或者,你们在优化过程中,踩过最大的坑是什么?评论区聊聊,也许你的经验正好能帮到另一个深夜焦头烂额的“老李”。













