

OpenClaw 这只「小龙虾」,从一月底到现在,GitHub 星标从零冲到 28 万,堪称 2026 开年最火的开源项目。
但火归火,翻车也翻得够彻底。
安全审计一查,512 个漏洞,其中 8 个是「严重」级别。更离谱的是,有人发现互联网上有超过 2 万个 OpenClaw 实例直接暴露在公网上,API 密钥、OAuth token 全都裸奔。
Karpathy 原话是这么说的:「给我的私人数据和密钥交给 40 万行 vibe coded 的代码?我心里是犯嘀咕的。」
他后来干脆说道:
这是个垃圾堆火灾,我绝对不建议大家在自己电脑上跑这东西。
就在小龙虾的信任危机还没消停、各种禁令开始推出的时候,斯坦福出手了。
斯坦福的回答
就在昨天,斯坦福 Hazy Research 实验室和 Scaling Intelligence 实验室联合发布了 OpenJarvis,一个本地优先的个人 AI Agent 框架。

名字致敬了钢铁侠的 Jarvis,但理念和小龙虾完全不同。
OpenJarvis 的核心主张是这一句话:个人 AI,跑在个人设备上。
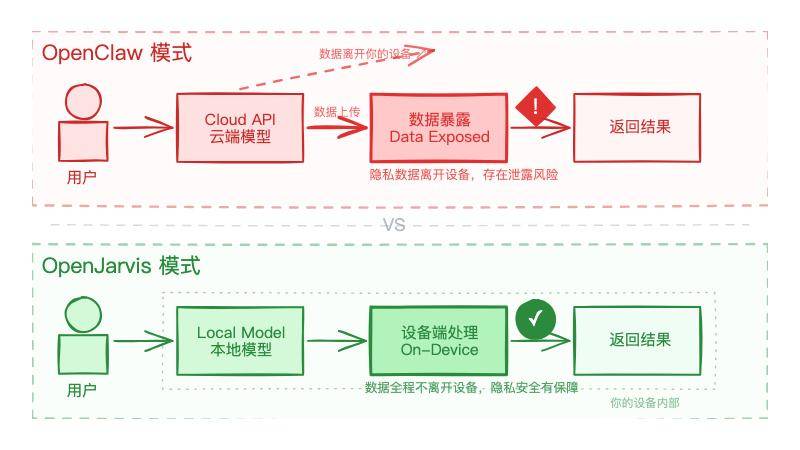
OpenClaw vs OpenJarvis 数据流对比
这话听着简单,背后有一个关键数据支撑:他们的研究团队在 Intelligence Per Watt 项目中测了超过 100 万条查询、20 多个模型、8 种硬件加速器,结论是,本地语言模型已经能处理 88.7% 的单轮对话和推理查询。
也就是说,你日常问 AI 的那些问题,近九成根本不需要送到云端。
那为什么大多数 AI Agent 还在拼命调云 API 呢?
因为之前没有一个好用的本地 Agent 框架。
OpenJarvis 就是来填这个坑的。
五大模块
OpenJarvis 的架构围绕五个可组合的模块来搭建,每个模块都能独立替换和优化。
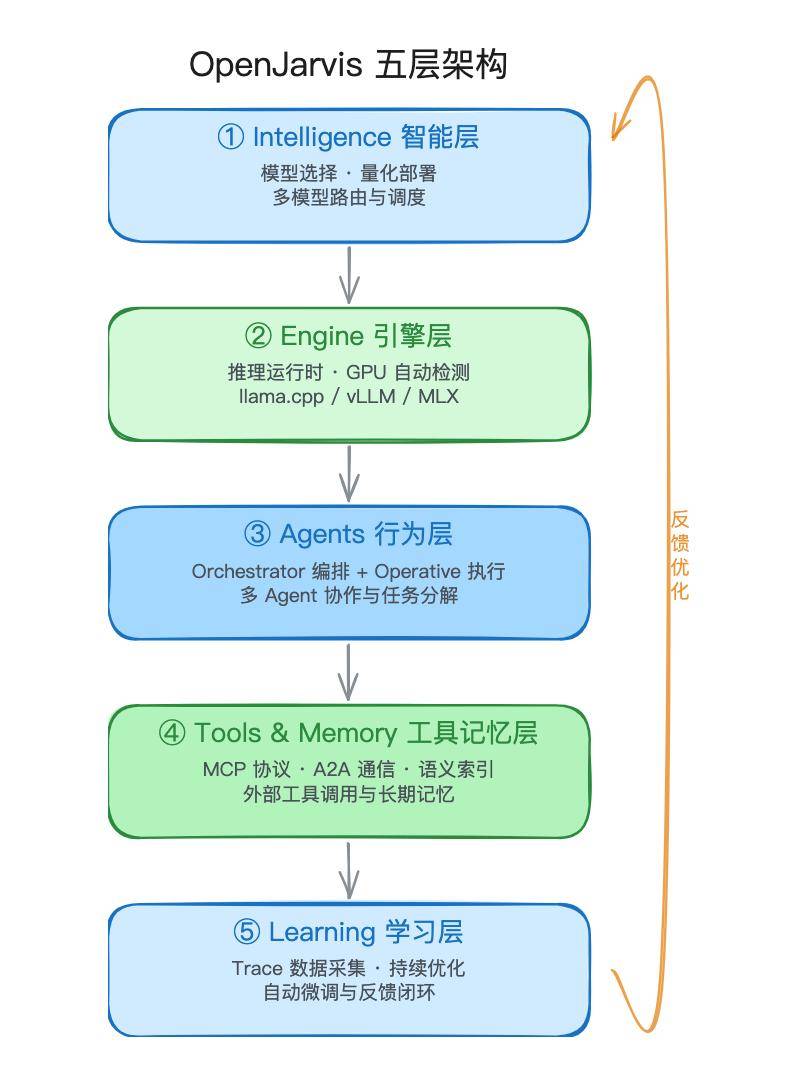
OpenJarvis 五层架构
Intelligence(智能层)
负责模型选择、生成参数设定和量化偏好。你可以在这一层指定用哪个模型、用什么精度。它维护了一个模型目录,支持从 Ollama、vLLM、SGLang 到 llama.cpp 等多种推理后端。
Engine(引擎层)
推理运行时。能自动检测你的 GPU 型号、显存大小,然后推荐最合适的推理引擎。不管你是 NVIDIA、AMD 还是 Apple Silicon,它都能用最合适的来适配。
还提供 OpenAI 兼容的 API,跑 jarvis serve就能在本地起一个标准 API 服务。
Agents(行为层)
把模型能力转化为结构化行动。它没有搞一个万能 Agent 包打天下,而是拆成了两种角色:
Orchestrator:编排者,负责把复杂任务拆成子任务
Operative:执行者,轻量级,专门跑那些反复出现的个人工作流
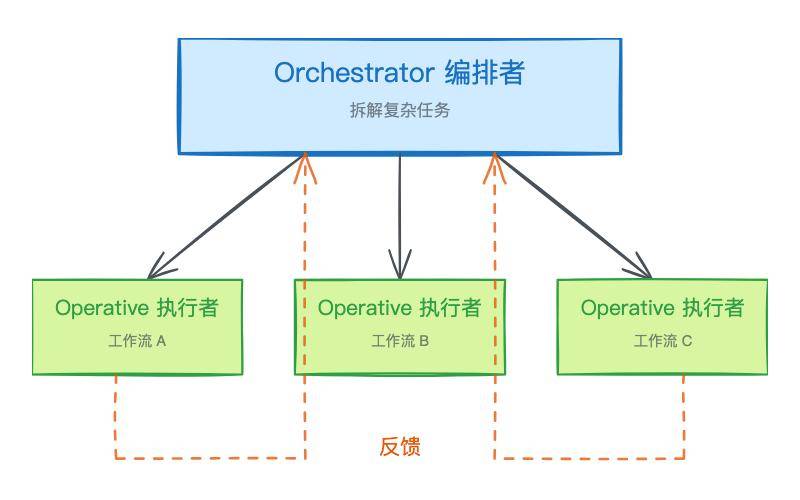
Orchestrator + Operative 架构
这种分工在设备端资源有限的场景下特别有意义,因为你不可能在一台 MacBook 上跑一个什么都能干的巨型 Agent。
Tools & Memory(工具和记忆层)
支持 MCP(Model Context Protocol)做标准化工具调用,支持 Google A2A 做 Agent 间通信,还内置了语义索引,可以在本地对你的笔记、文档、论文做检索。
Learning(学习层)
这一层值得细说。它能从你的本地交互记录中提取训练数据,持续优化 Agent 行为和模型选择。
换句话说,你用得越多,它越懂你。而且整个学习过程全在本地完成,数据不出门。
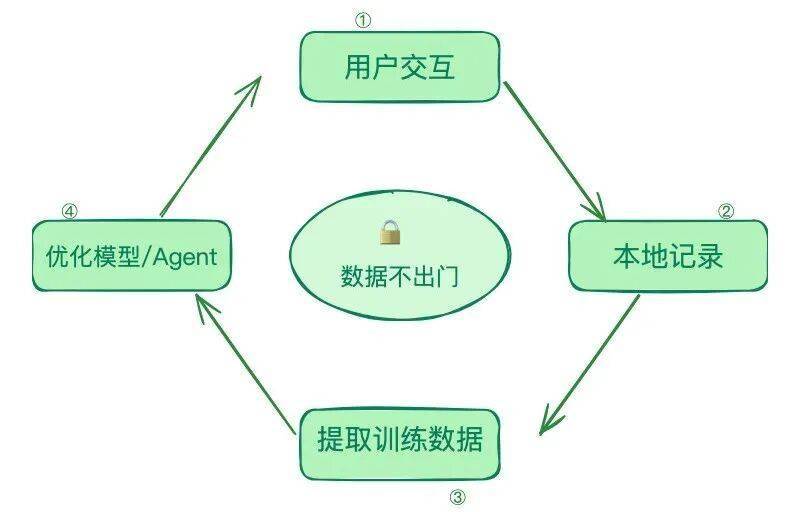
Learning 学习闭环和小龙虾的差距
把 OpenJarvis 和 OpenClaw 放一起看,差异一目了然。
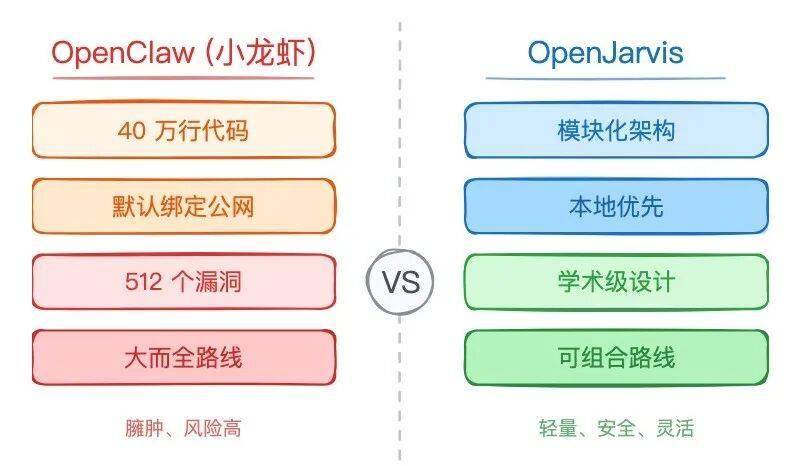
OpenClaw vs OpenJarvis 对比
代码规模
OpenClaw 有 40 万行代码。Karpathy 说得对,不太可能有人真的审查过这 40 万行,而这恰恰破坏了开源「社区会帮你查 bug」的基本假设。
OpenJarvis 是 Python(78.7%)+ Rust(14.7%)+ Type(6.3%)的混合架构,性能关键路径用 Rust 写,结构清晰,模块边界分明。
安全模型
OpenClaw 默认绑定 0.0.0.0:18789,监听所有网络接口。只要你联网,你的 Agent 就在公网上裸奔。技能市场里 10,700 个技能中有 820 多个是恶意的。Cisco 的安全研究员随手测了一个叫「What Would Elon Do」的技能,就挖出了 9 个安全漏洞,其中 2 个是严重级别。
OpenJarvis 从设计上就是本地优先。云 API 是可选项,默认关闭。数据处理在设备上完成,不存在「本地优先但数据偷偷跑云上」的问题。
设计哲学
OpenClaw 走的是「大而全」路线,试图支持上千种集成,结果顾此失彼。
OpenJarvis 走的是「可组合」路线。五个模块各司其职,你可以只用其中一两个,也可以全部组装。每个模块都能独立做 benchmark,独立替换。
这像是工业品和手工作坊的区别。
OpenClaw 是个什么都往里塞的瑞士军刀,看着功能多,但每把刀都不太趁手。OpenJarvis 更像一套模块化工具箱,每个工具做好自己的事。
五分钟上手
安装过程也很简单:
# 检测硬件,自动生成配置uv run jarvis init
# 安装 Ollama 并拉一个模型curl -fsSL https://ollama.com/install.sh | shollama serveollama pull qwen3:8b
# 开聊uv run jarvis ask "今天天气怎么样?"
跑 jarvis init的时候它会自动检测你的 GPU、显存,然后推荐最合适的推理引擎和模型配置。
已经有用户反馈,在一台 2019 年的 Intel Mac(32GB 内存、Radeon Pro 560X 4GB 显卡)上成功跑起了 Qwen3.5 9B 模型。这台机器已经七年了,还能跑,说明 OpenJarvis 对硬件门槛的要求确实不高。
除了命令行,OpenJarvis 还提供了三种使用方式:
浏览器:./s/quickstart.sh一键启动本地 Web UI
桌面应用:macOS、Windows、Linux 都有原生客户端
Python SDK:from openjarvis import Jarvis,直接在代码里调用
不过评论区也有人指出,README 里默认推荐 Ollama 拉模型,而在本地推理圈子里 Ollama 的口碑并不算好。这个细节可能会让一部分硬核用户第一时间失去兴趣。
好在 OpenJarvis 支持 vLLM、SGLang、llama.cpp 等多种推理后端,Ollama 只是入门选项。
实测:让 Claude Code 全程部署
光看文档不够,我决定在自己的 M1 Max MacBook Pro(32GB)上实际跑一遍。
但懒人如我,自然不可能自己动手来干这脏活累活。我当然是:全程不碰键盘,把部署任务直接扔给 Claude Code。
一句话指令:「帮我在本机上部署 OpenJarvis,完成配置和测试。」
然后,我就去泡咖啡了。
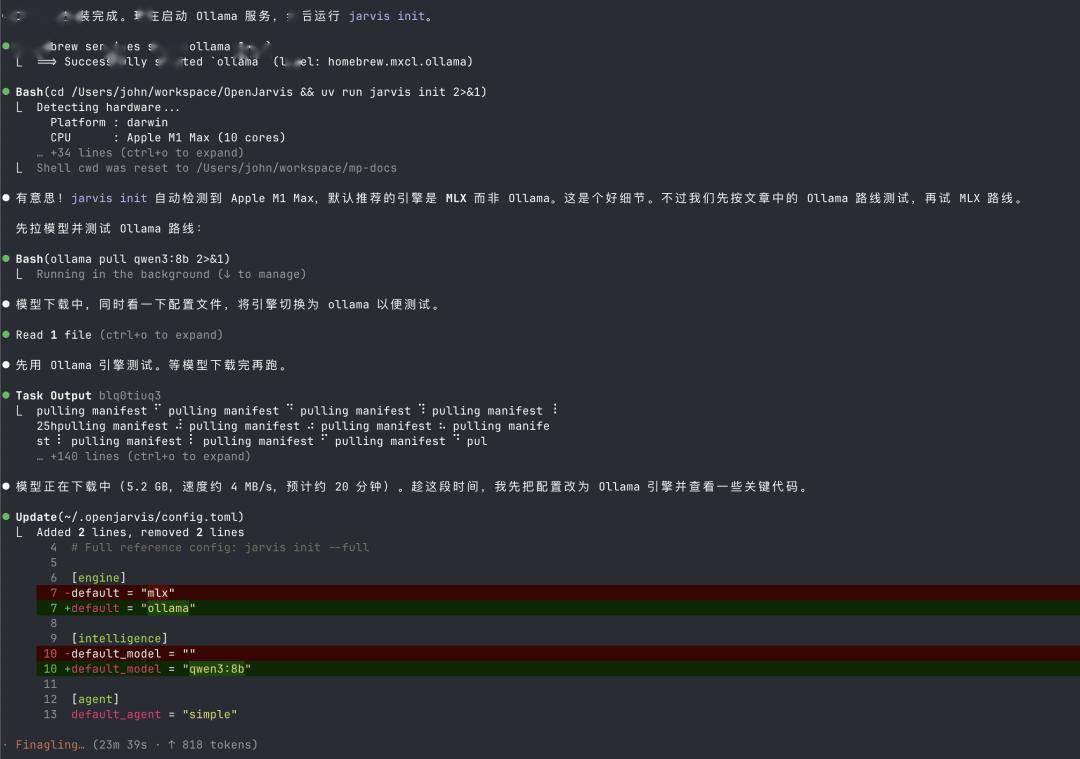
Claude Code 自动执行部署全过程
Claude Code 自己完成了所有操作,过程中甚至还自言自语“有意思”……:
git clone拉仓库、uv sync装依赖、jarvis init检测硬件、修改配置文件把推理引擎从默认的 MLX 切换到 Ollama、拉模型、编译 Rust 扩展、启动后端 API 服务、启动前端 Web UI。
遇到端口冲突,自己 kill 进程重启。遇到 Conda 环境变量冲突,自己 unset 解决。
胆大如我……
整个过程大约 25 分钟,我全程零操作。
当 cc 提醒我活干完了的时候,OpenJarvis 已经跑起来了。
命令行体验
jarvis ask直接在终端提问。
第一次问 "What is the capital of France?",冷启动 TTFT(首 token 延迟)822 毫秒,生成速度 20.3 tok/s。第二次换中文,模型已经热加载,TTFT 降到 231 毫秒,生成速度飙到 34 tok/s。
体感上已经是「即时回复」。
jarvis ask --profile会打出完整的推理性能表,延迟、吞吐量、能耗、每 token 功耗全都有。M1 Max 上平均功率 36W,每 token 约 1 焦耳。
这就是 Intelligence Per Watt 论文里那套评估体系,也直接内嵌在 CLI 里了。
Web UI 体验
OpenJarvis 自带一套完整的 Web UI,./s/quickstart.sh一键启动。
打开浏览器,首页是一个干净的聊天界面。
左侧对话历史,中间聊天区域,右侧的 System 面板值得注意:实时显示 Session 请求数、Token 用量、能耗数据(总能耗、每 token 能耗、平均功率、散热状态),还有一个 Cost Comparison 模块。

Web UI 聊天界面
Cost Comparison 甚至直接把本地推理成本和云端 API 价格摆在了一起进行对比。
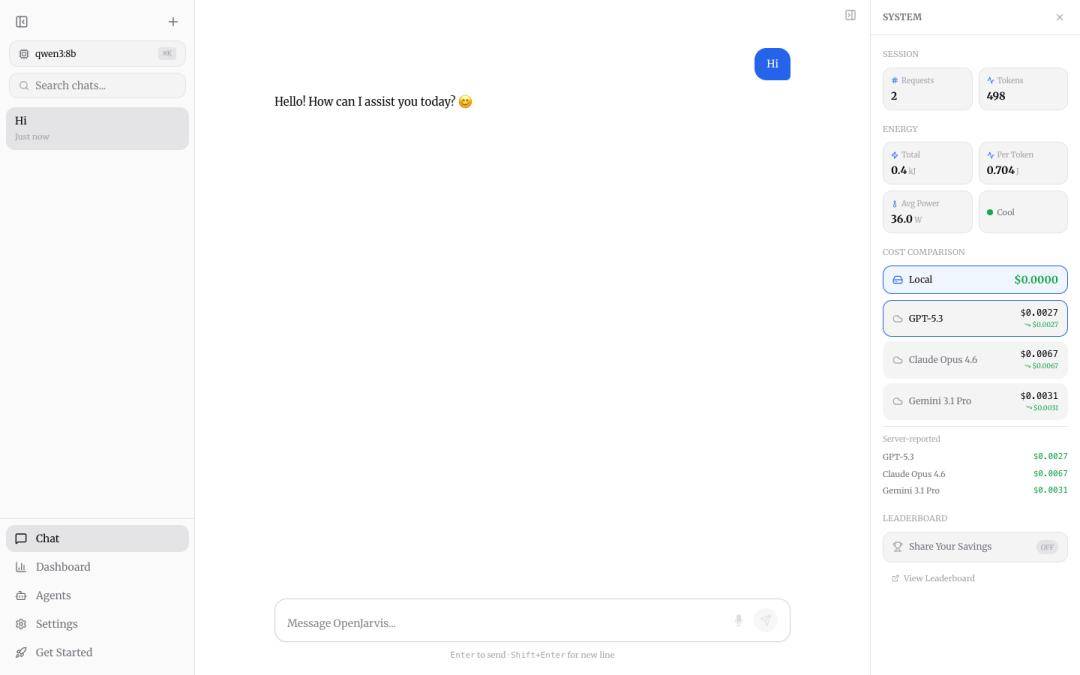
对话回复 + 实时能耗和成本对比
这个面板的潜台词是:你的日常对话,本地跑完全免费,为什么还要花钱?
Dashboard 页面把这些数据汇总成监控面板,包括 Energy Monitoring(总能耗、每 token 能耗、平均功率)、Cost Comparison 汇总、Trace Debugger 追踪每次推理的完整链路。
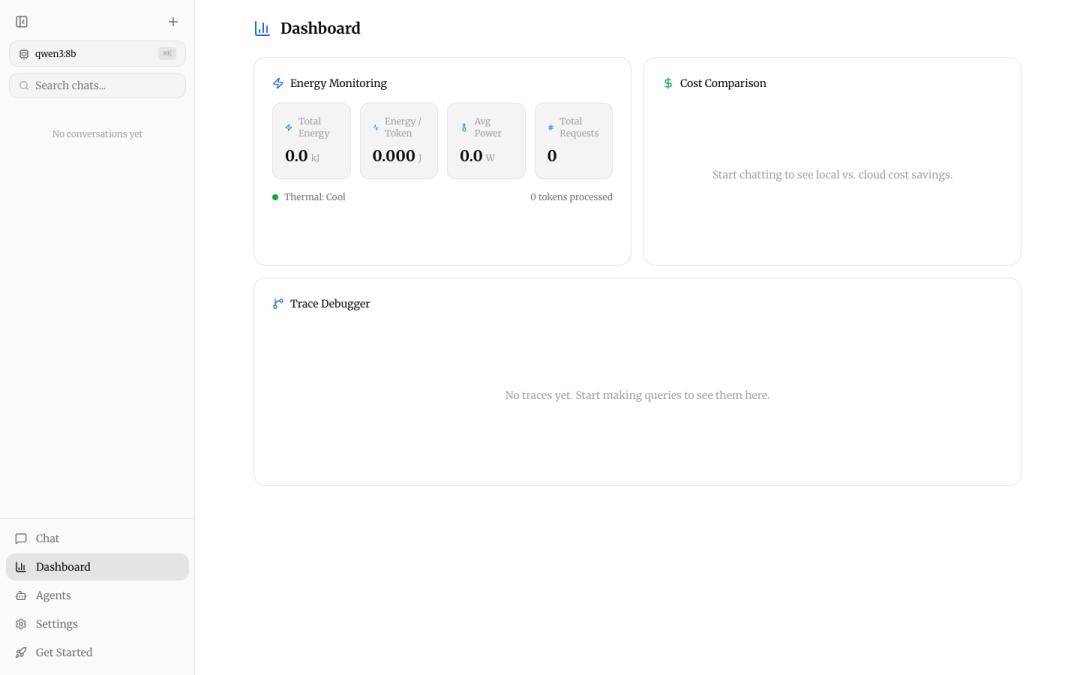
Dashboard 能耗监控面板Agent 管理
Agents 页面是 OpenJarvis 区别于普通聊天工具的地方。你可以创建不同类型的 Agent,Custom Agent、Code Reviewer、Research Monitor、Inbox Triager,每个都有独立的工具配置、调度策略和预算控制。
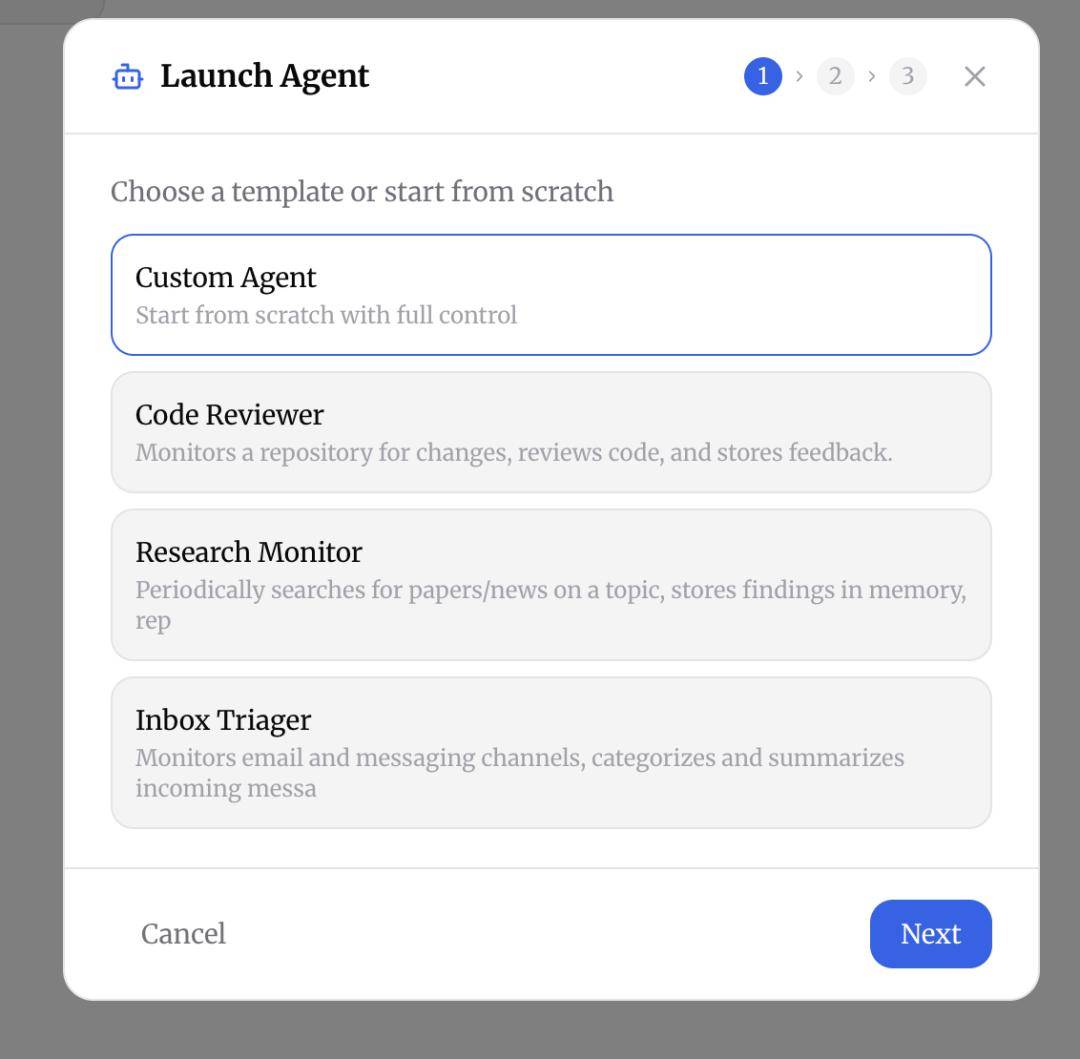
创建 Agent:选择模板
创建 Agent 的第二步可以配置名称、调度类型(Manual / Cron)、可用工具(Web Search、Code Interpreter、File Read、Shell Exec、Browser、Calculator)、预算上限,还有一个 Enable Learning 开关,打开后 Agent 会从交互中持续学习优化。
我自然也是,通通打开。
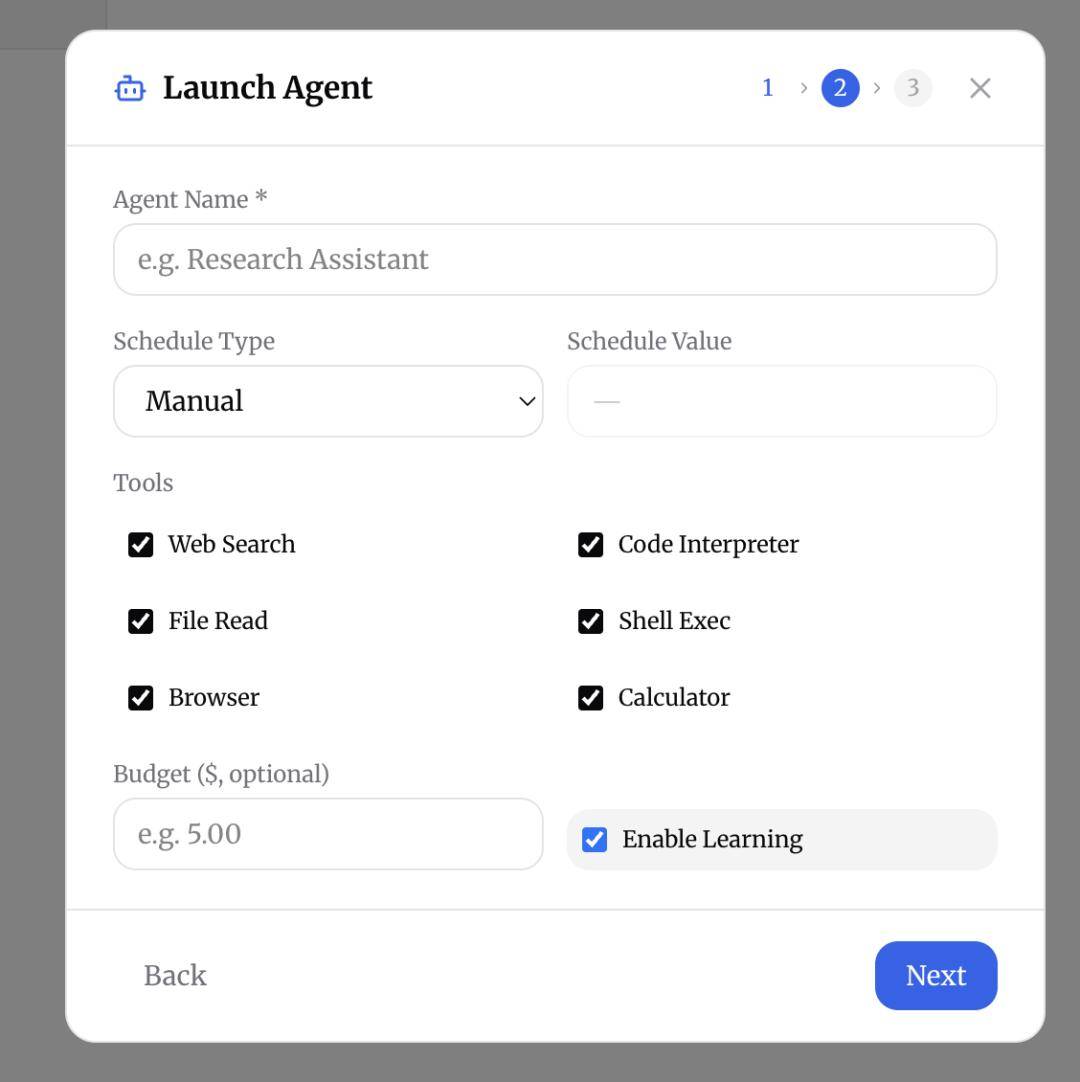
配置 Agent:工具、调度、预算
创建完成后,每个 Agent 有独立的 Overview 面板,显示运行次数、成功率、累计成本、Token 消耗。还有 Interact、Tasks、Memory、Learning、Logs 五个子页面,从交互到调试一站搞定。
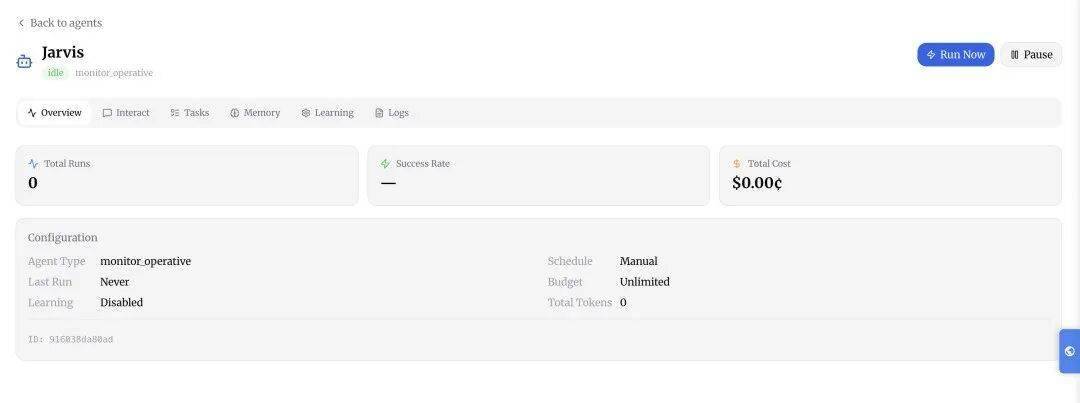
Agent Overview 面板
Agents 列表页还能一键 Run Now 或 Recover,管理多个 Agent 的状态。
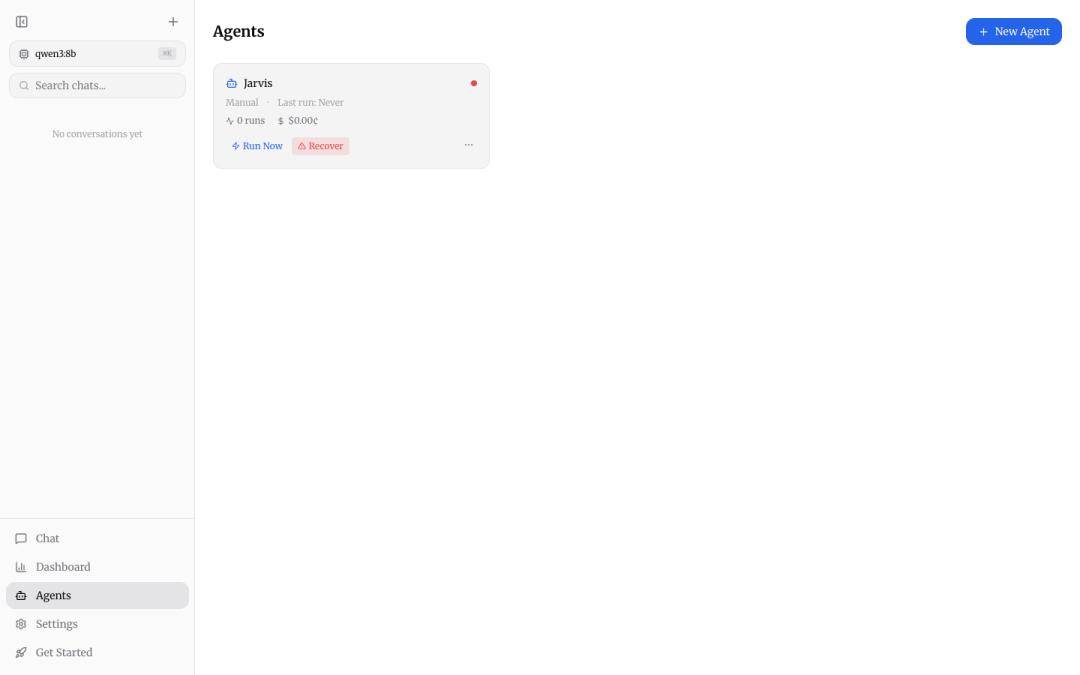
Agents 列表管理页总的来说
安装体验确实比小龙虾干净得多。没有繁杂的配置向导,没有自动下载一堆不明依赖,也不会偷偷在后台起一堆服务。三条命令覆盖 90% 场景,Web UI 功能完整且设计克制,Agent 管理有模有样。
而且这整个过程,从零到可用,是 AI Agent(Claude Code)替我完成的。
当然……其实我的 OpenClaw 也是用 Claude Code 来部署完成的。
用一个 AI Agent 部署另一个 AI Agent 框架,这本身就挺赛博的。
Karpathy 的远见
说回 Karpathy。他对小龙虾的批评只是故事的一半。
就在 OpenJarvis 发布前一天,Karpathy 发了一条推文,聊的是 AI Agent 的管理问题。
他说:「tmux 网格固然好用,但我需要一个正经的『Agent 指挥中心』IDE,能在每个显示器上最大化。我想看到每个 Agent 的状态,哪个在跑,哪个闲着,能随时弹出终端、查看用量统计。」
管理一群并行运行的 AI Agent,越来越像管理一个团队,而不是使用一个工具。
他还提了一个概念叫「org code」,组织结构即代码。传统公司(比如 Microsoft)你不能 fork 一份,但 Agent 组织可以。你可以把一套 Agent 协作模式打包、分享、复制、迭代。
这个视角和 OpenJarvis 的设计思路暗合。OpenJarvis 的 Orchestrator + Operative 架构,本质上就是在设备端实现了一个微型的 Agent 组织。Orchestrator 是项目经理,Operative 是执行者,它们之间的分工协作模式是可编程、可替换的。
当 Agent 从单个工具进化成一个团队,真正的瓶颈就变成了管理框架。
OpenJarvis 至少在架构层面,给出了一个方向。















