

随着企业业务规模扩张,私有部署CRM系统面临的数据库压力与日俱增。当单库承载的并发查询量逼近阈值时,系统响应变慢、报表加载卡顿、甚至影响销售人员的日常跟进效率,成为许多IT管理者的切肤之痛。数据库读写分离,正是解决这一难题的核心架构方案。本文将从实战角度,拆解私有部署CRM系统实施读写分离的关键要点与避坑指南。
为什么私有部署场景下读写分离尤为关键?
在SaaS模式下,数据库性能问题通常由服务商兜底。但对于选择私有部署CRM系统的企业来说,所有硬件资源与数据库优化工作都需要自行承担。随着客户数据量积累到百万级、千万级,以及BI报表、数据看板等分析类查询需求激增,单库架构的“读写争用”问题会迅速暴露。
所谓读写分离,本质是将主库(Master)负责处理增删改等写操作,从库(Slave)专门承载查询类读操作。这种架构不仅能大幅降低主库负载,还能通过多从库水平扩展查询能力,保证私有部署CRM系统在业务高峰期依然保持流畅。
架构设计:主从同步的三种主流方案
实施读写分离,首先要解决主从数据同步的时效性与一致性问题。
1. 异步复制(默认方案)
主库完成写操作后立即返回,通过binlog异步同步至从库。这种模式性能最高,但在极端情况下可能产生毫秒级的数据延迟。适用于对实时性要求不高的查询场景,如报表统计、数据导出等。
2. 半同步复制
至少等待一个从库确认收到日志后,主库才返回操作成功。相比异步模式,数据一致性更有保障,但写操作的响应时间略有增加。适合订单创建、客户信息更新等关键业务场景。
3. 组复制(高可用方案)
多节点组成复制组,通过共识算法保证数据强一致性。架构复杂度较高,但对金融级数据安全场景尤为必要。企业在规划私有部署CRM系统的读写分离时,建议根据业务重要性分库处理——核心交易库采用半同步,分析查询库采用异步,平衡性能与安全。

应用层改造:如何优雅实现读写分流
数据库层的主从架构搭建完成后,应用层需要具备“智能路由”能力,即自动识别SQL类型并将读请求分发至从库。
1. 中间件代理模式
通过部署数据库中间件(如MyCAT、ShardingSphere-JDBC),在应用与数据库之间建立代理层。所有SQL请求先经过中间件解析,判断读写类型后路由至对应节点。这种方案对业务代码侵入小,但需要额外维护中间件集群。
2. 框架层多数据源配置
在应用代码中配置主库、从库两套数据源,通过注解或AOP切面动态切换。例如在Service层标记@ReadOnly的方法自动走从库。这种方式控制粒度更精细,适合技术团队掌控力较强的企业。
3. 读写分离与分库分表协同
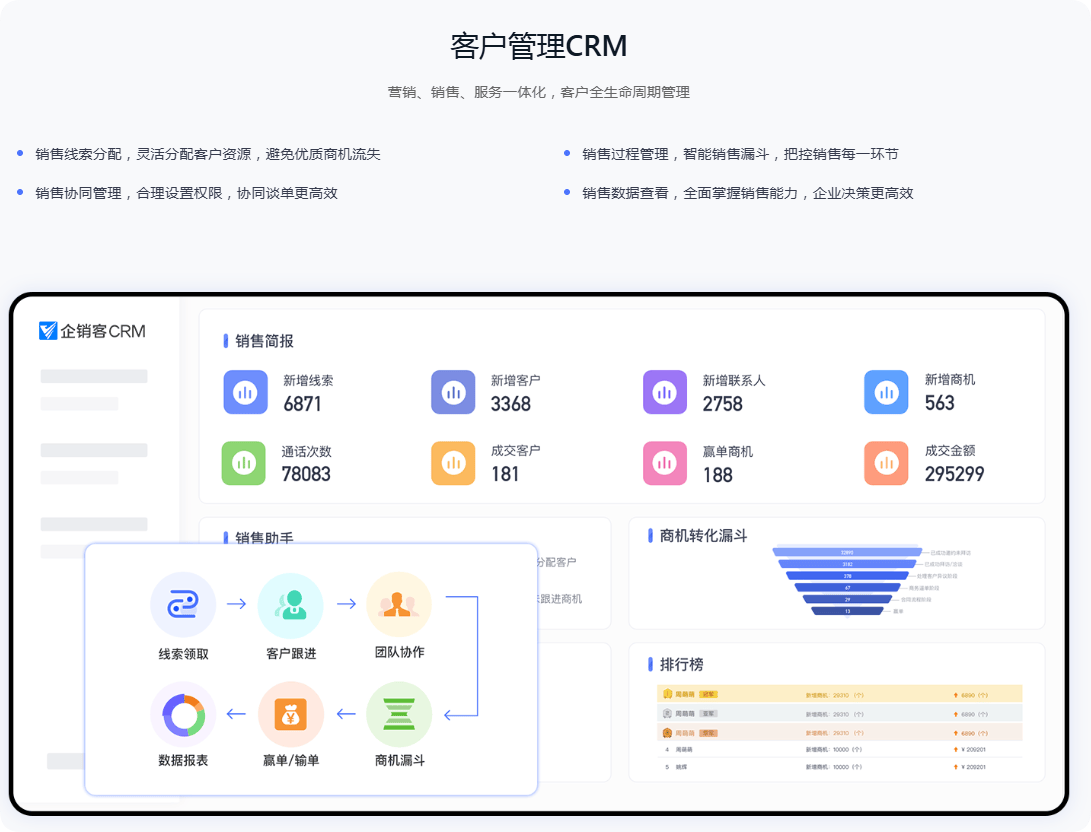
对于超大规模数据量,单一主库的写性能也会成为瓶颈。此时需要将读写分离与分库分表结合使用。以“企销客”这类面向中大型企业的私有部署方案为例,其底层架构通常支持水平分片与读写分离的一体化配置,通过一个控制台即可管理复杂的数据库拓扑。
运维避坑:延迟监控与一致性兜底
读写分离架构上线后,运维侧需重点关注两大风险:主从延迟和读一致性。
延迟监控:部署监控工具实时跟踪主从延迟秒数。当延迟超过阈值(如5秒)时,自动将查询流量切回主库,避免用户看到“过期数据”。同时,对于“写完就读”的高一致性场景(如用户修改密码后立即登录),需要在代码层强制将本次查询路由至主库。
故障切换:从库宕机时,系统应自动将读请求降级至主库,保证业务连续性。主库故障时的从库提升,则需要配合Keepalived等高可用组件完成,避免单点风险。
成本评估:硬件投入与收益平衡
读写分离并非没有成本。每增加一个从库,就意味着增加一台服务器的硬件投入和运维复杂度。建议企业在规划阶段,根据业务增长曲线做梯度建设:
初期:1主1从架构,满足基础读写分离需求。
成长期:1主2从,将报表查询、数据导出等重读业务隔离到独立从库。
成熟期:引入中间件,实现从库的弹性伸缩。
值得一提的是,部分私有部署CRM系统已经将读写分离能力内置于产品中,企业无需从零搭建数据库集群,只需在部署时勾选“高可用架构”选项,系统即可自动完成主从配置。这类方案大大降低了技术门槛,让企业可以更聚焦于业务本身。
常见问题解答(FAQ)
Q1:实施读写分离后,为什么有时候查询到的数据不是最新的?
A1: 这是主从延迟导致的典型现象。当主库完成写入后,数据同步到从库存在毫秒到秒级的时间差。如果是实时性要求高的场景(如查看刚创建的客户),建议在代码层将这类查询强制路由至主库,或者采用“写后读主库”的策略。
Q2:私有部署CRM系统做读写分离,对数据库版本有要求吗?
A2: 主流关系型数据库如MySQL 5.7及以上版本、PostgreSQL都原生支持主从复制。需要注意的是,不同数据库的复制机制存在差异,MySQL的GTID模式相比传统的binlog位点复制,在故障切换时更为便捷。建议在部署前确认数据库版本满足要求。
Q3:读写分离后,复杂报表查询还是会影响主库性能怎么办?
A3: 这个问题通常是因为报表查询仍在从库上执行,但从库本身可能承担了过多其他查询任务。解决方案有两种:一是增加专门的“报表从库”,只服务于BI工具,与其他业务查询物理隔离;二是考虑引入列式存储或OLAP引擎,将分析型查询与事务型查询彻底分离。
Q4:我们使用的是“企销客”这类私有部署产品,自己改读写分离会不会影响后续升级?
A4: 如果是成熟商用产品,建议优先使用官方提供的架构方案。大多数主流私有部署CRM系统已经在产品设计阶段考虑了扩展性,支持通过配置文件开启读写分离模式。自行修改底层数据库架构可能导致后续版本升级时出现兼容性问题,建议在实施前与供应商确认支持范围。
Q5:读写分离能解决所有数据库性能问题吗?
A5: 不能。读写分离主要解决的是“读多写少”场景下的查询并发压力。如果遇到写操作本身成为瓶颈(如大量并发创建订单),或者单个SQL语句未命中索引导致全表扫描,读写分离也无法从根本上解决问题。此时需要结合SQL优化、缓存引入、分库分表等综合手段进行调优。

总结而言,读写分离是私有部署CRM系统从“能用”走向“好用”的关键架构演进。它不仅能显著提升系统响应速度,更为后续的数据分析、实时看板等深度应用打下基础。企业应根据自身业务规模、技术能力和预算投入,选择合适的主从架构与路由方案,在性能、一致性与成本之间找到最优平衡点。














