

一、全网都在等的"狼来了":V4 发布时间表的一再推迟
说实话,我已经有点疲惫了。 从2026年1月开始, 关于 DeepSeek V4 发布的传闻就像过山车一样, 一次次把开发者的预期拉满, 又一次次落空。 1月中旬, 外媒援引知情人士消息称 V4 将在春节期间发布; 2月初, 野村证券的报告信誓旦旦地预告"2月中旬见"; 2月底, 又有消息说"下周一定发"; 到了3月初, "3月首周发布"的传言再次刷屏。 结果呢?截至2026年3月27日,DeepSeek 官方 API 文档里依然没有 V4 的模型 ID,网页端那个被称为"V4 Lite"的版本也从未被官方正式认领。 这种反复跳票,在 AI 行业其实并不常见。OpenAI 虽然也喜欢"下周见",但通常不会提前两个月就开始放风。DeepSeek 这次的操作,更像是一场被动的、被舆论推着走的预期管理失控。每一次"即将发布"的消息,都源自供应链、投资圈或媒体的"知情人士",而非官方渠道。 但奇怪的是, 尽管被鸽了三次, 开发者社区对 V4 的期待值不降反增。 Reddit 的 r/LocalLLaMA 板块里, 关于 V4 的讨论帖每天都能刷到几十条; OpenRouter 上出现的一个匿名模型"Hunter Alpha"(后来被证实是小米的 MiMo-V2-Pro), 一度被疯狂猜测是 V4 的灰度测试。 这种"被鸽还追"的现象,恰恰说明了一个问题:DeepSeek V4 承载的期待,已经远远超出了一个普通模型迭代的范畴。
二、技术突破还是工程困境:V4 背后的硬骨头
作为一个跟踪 AI 行业十年的观察者,我倾向于认为,V4 的跳票不是因为营销节奏,而是真的遇到了工程难题。 根据目前流出的技术线索,V4 至少要攻克三座大山:
第一座山是万亿参数规模的训练稳定性。 业内普遍推测 V4 将达到万亿参数级别, 相比 V3 的 6710 亿参数, 这是一次指数级跃升。 参数规模每翻一倍, 训练难度不是线性增加, 而是几何级爆发。 DeepSeek 在1月1日发布的 mHC(流形约束超连接)论文, 正是为了解决"模型越大越容易崩溃"的稳定性问题。 这种技术预研与模型发布的紧密耦合, 说明 V4 的架构可能经历了重大调整。
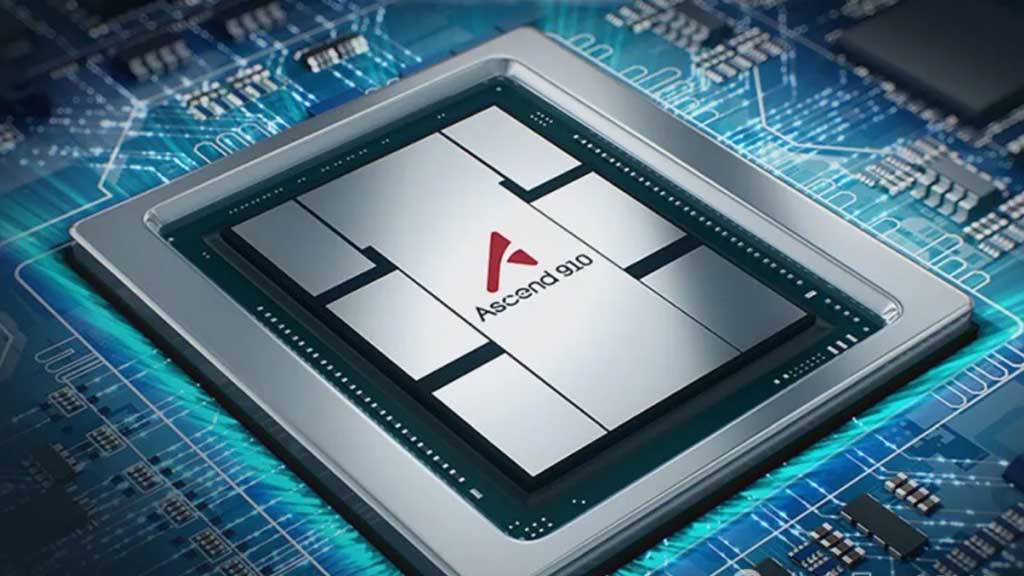
第二座山是国产芯片的适配难题。 这是最值得关注,也最容易被忽视的一点。路透社在2月底的独家报道中披露了一个关键细节:DeepSeek 已提前数周向华为、寒武纪等中国芯片供应商开放 V4 进行适配测试,但没有向英伟达、AMD 提供预发布版本。 这意味着什么?V4 很可能是首款真正意义上"为国产芯片原生设计"的前沿大模型。华为昇腾 910B 和寒武纪 MLU 的架构与 CUDA 生态完全不同,要在这些芯片上跑通万亿参数模型的训练和推理,需要重写底层算子、重构通信协议、重新优化内存管理。这不是简单的"移植",而是一次底层工程的重构。
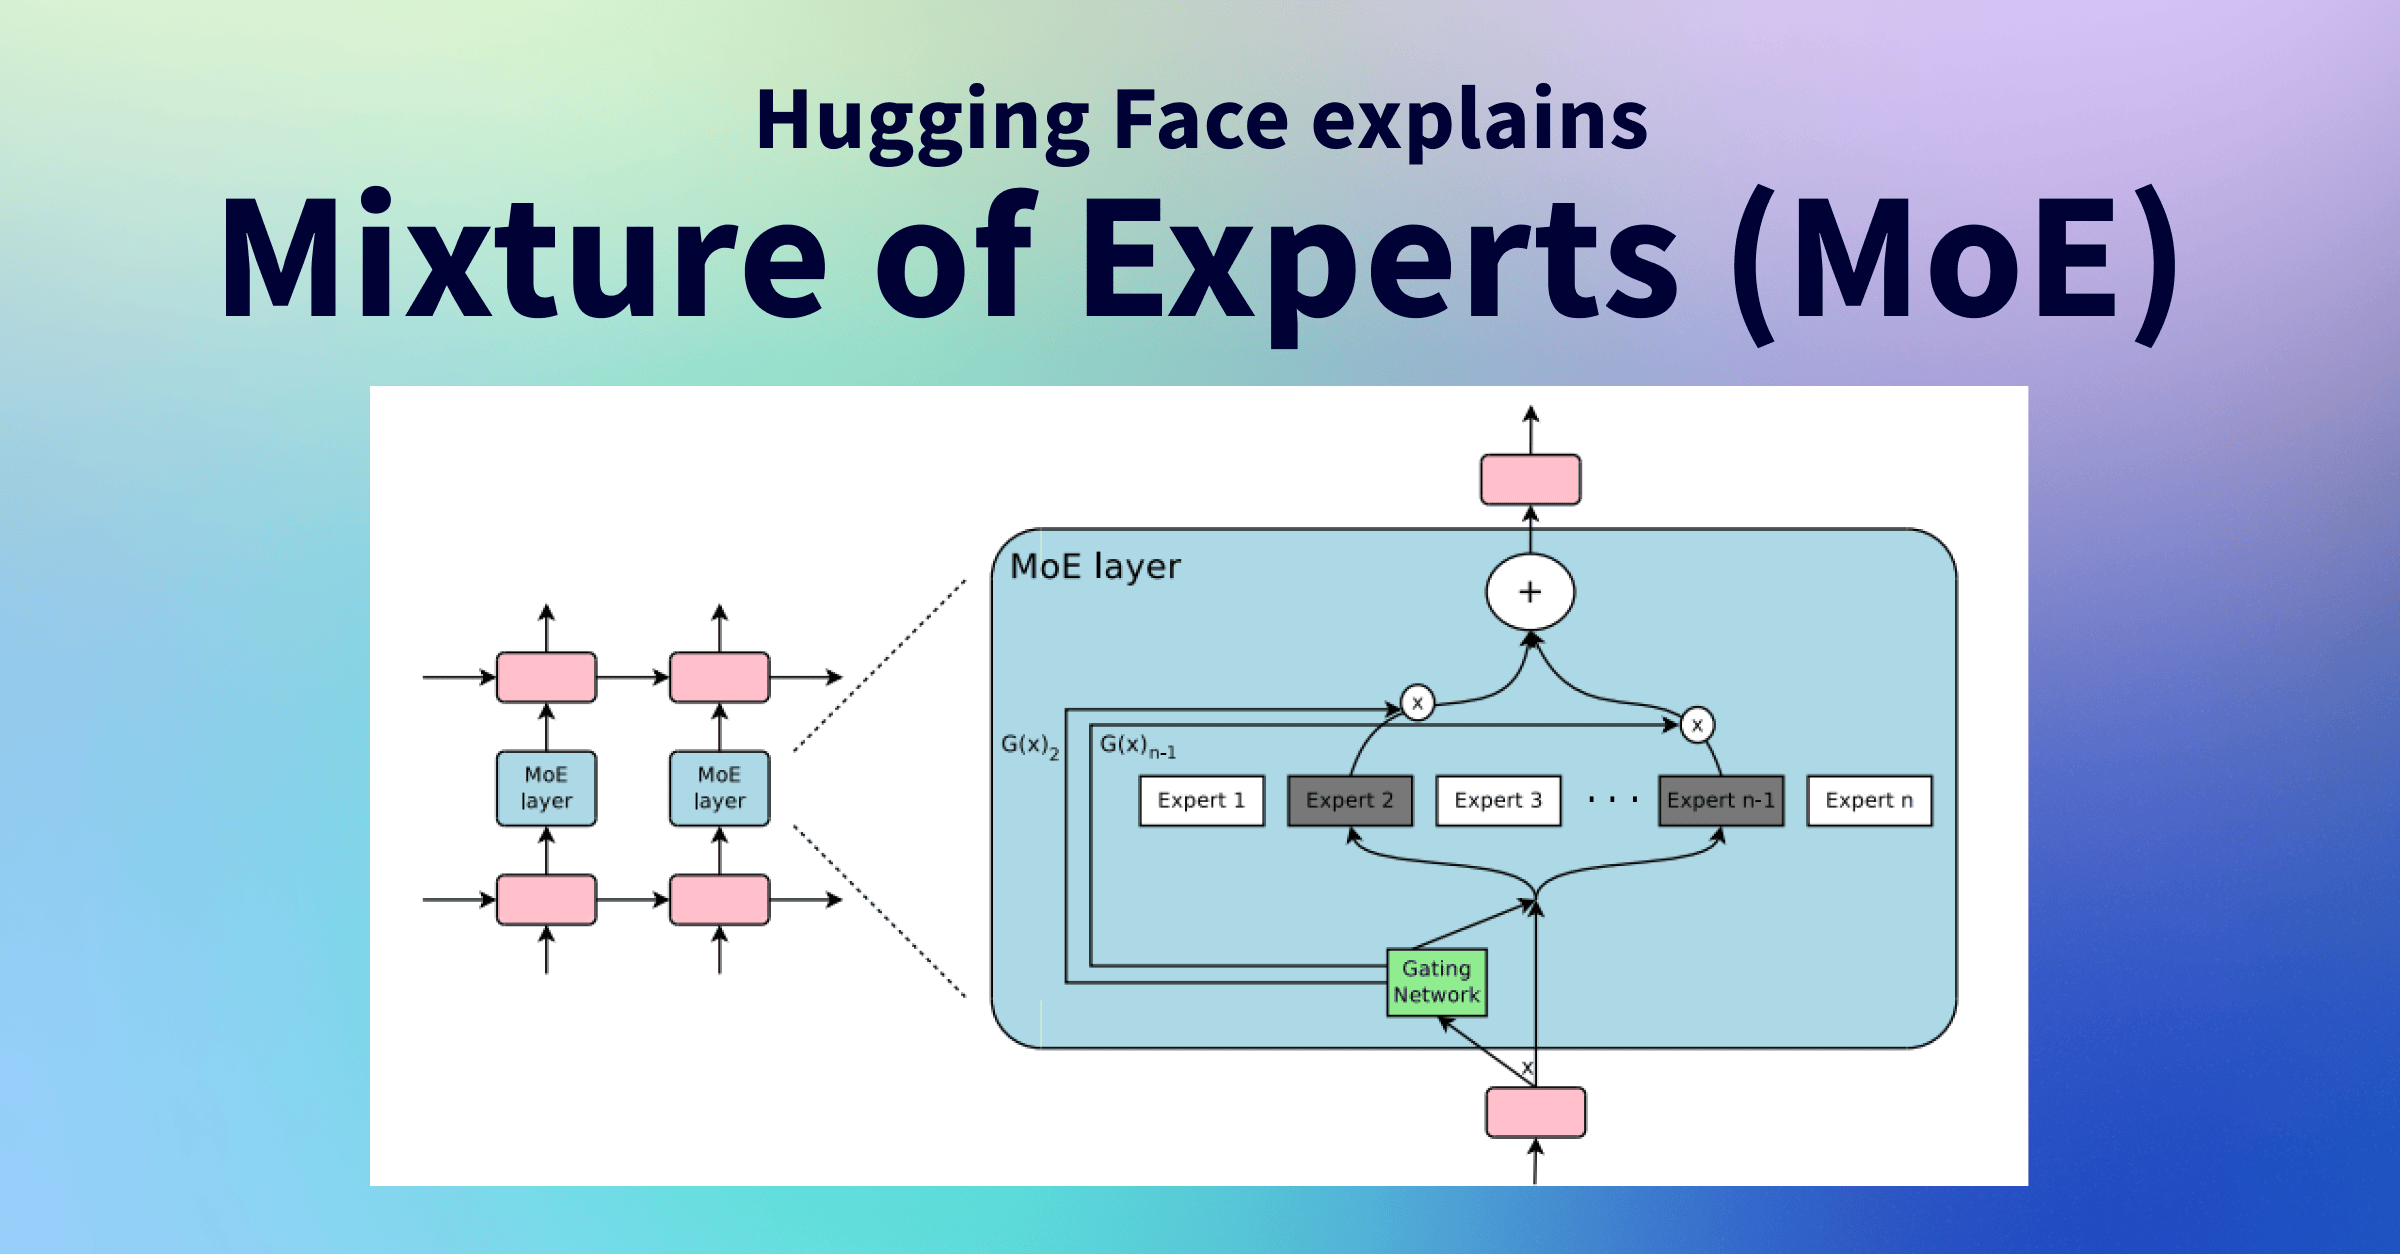
第三座山是 Engram 记忆机制的工程化落地。 1月12日,DeepSeek 联合北大发布的 Engram(条件记忆)架构,提出了一种"查表代替计算"的新范式。当模型遇到熟悉的知识模式时,可以直接从外部记忆库中检索,而不是每次都重新计算。这理论上能把长上下文推理的成本降低一个数量级。 但问题在于, Engram 需要构建一个巨大的外部记忆表, 如何在推理时实现 O(1) 的查找速度? 如何在批量推理时保持吞吐量? 如何与 MoE(混合专家)架构协同工作? 这些都是没有现成答案的工程挑战。 3月9日那次神秘的网页端更新, 上下文窗口从 128K 扩展到 1M, 很可能就是 Engram 机制的一次压力测试。
三、被误读的"等待":V4 跳票背后的产业真相
很多人把 V4 的延迟解读为"技术不行"或"炒作吊胃口",我觉得这种判断过于简单了。 作为一个见证过中国 AI 从" copy to China"到"原创输出"全过程的从业者,我看到了 V4 跳票背后更深层的产业逻辑:
首先,这是一次"去英伟达化"的艰难突围。 自从美国出口管制收紧后,中国 AI 公司一直在寻找摆脱对英伟达依赖的路径。但之前的做法大多是"权宜之计"——用 H800 训练、用昇腾做推理,或者干脆把模型做小。DeepSeek V4 可能是第一个敢于"全盘押注国产芯片"的旗舰模型。 这种选择的风险极高。如果 V4 在昇腾上的表现不如预期,不仅会被舆论反噬,更会让整个"国产替代"叙事遭受重创。DeepSeek 的谨慎,某种程度上是在为整个中国 AI 产业"试水温"。
其次,这是对"唯参数论"的主动纠偏。 业内流传的消息显示,V4 的重点不是参数竞赛,而是通过 Engram 和 mHC 技术打破"芯片和显存瓶颈"。这是一种更务实的工程哲学:在算力受限的环境下,用架构创新换取效率提升,而不是盲目堆参数。 野村证券的报告也印证了这一点:V4 的核心价值在于"以非英伟达硬件实现顶尖性能"。如果这个目标达成,它将证明中国 AI 公司可以在"卡脖子"环境下,通过软件创新弥补硬件差距。
最后,这是一场关于开源生态的耐心博弈。 DeepSeek 已经确认 V4 将以 Apache 2.0 许可证开源。这意味着一旦发布,全球开发者都可以免费商用、自由修改。但开源不是一锤子买卖,模型必须足够稳定、文档必须足够完善、社区支持必须足够及时,否则反而会损害品牌。 我注意到,DeepSeek 的 GitHub 仓库在2月底迎来了一波密集的 PR 合并,主要集中在 API 集成和第三方工具链支持上。这种"基建先行"的节奏,说明团队在为 V4 的开源生态提前铺路。
四、对普通开发者的影响:我们到底在等什么?
说了这么多产业层面的分析,回到最实际的问题:V4 的延迟,对普通开发者意味着什么?
短期来看,是机会成本的累积。 很多团队从1月就开始推迟技术选型,苦等 V4 的 API。一些创业公司甚至把产品路线图押注在 V4 的多模态能力上。这种等待是有代价的——市场窗口不等人,竞争对手不会因为你"在等 V4"而放慢脚步。
中期来看,是一次技术栈的重新洗牌。 如果 V4 真如传闻所说,在编程能力上超越 Claude 3.5 Sonnet、在长上下文处理上实现百万 token 支持,它将彻底改变 AI 编程工具的竞争格局。现有的代码补全工具、RAG 架构、甚至 IDE 的 AI 插件,都可能需要重构。
长期来看,是一次"去美化"生态的入场券。 如果 V4 在国产芯片上跑通了,意味着中小企业可以用华为云、寒武纪的算力,以更低的成本部署顶尖模型。这将打破"用 AI 必须买英伟达"的固有认知,为中国云计算厂商创造新的竞争维度。 但我要提醒一点:不要神化 V4。泄露的基准测试数据(HumanEval 90%、SWE-bench 80%+)目前都未经验证。即使这些数据属实,基准测试得分高,也不代表在真实代码库上表现更好。很多所谓"更聪明"的模型,在上下文被塞满后,依然会迅速崩溃。
五、写在最后:耐心比焦虑更有价值
作为一个在这个行业摸爬滚打十年的人,我想对正在等待 V4 的开发者说:耐心比焦虑更有价值。 DeepSeek V4 的延迟,某种程度上是中国 AI 从"跟随者"向"定义者"转型的阵痛。我们不再满足于在英伟达的生态里做应用创新,而是试图在芯片架构、模型架构、训练框架三个层面同时突围。这种全方位的自主创新,注定比"拿来主义"更慢、更痛,但也更值得期待。 如果 V4 最终能在昇腾芯片上跑出比肩 GPT-5 的性能,它将不仅是一个技术产品,更是一个信号:中国 AI 产业已经具备了在封锁环境下自我迭代的能力。 当然,前提是它真的能发出来。 让我们继续等待,但别让等待成为停滞的借口。先用好手头的工具,把路由层搭好,等 V4 真正落地时,才能第一时间接住这波红利。 毕竟,在这个行业里,唯一确定的就是不确定性本身。














