

同一周,钉钉和飞书不约而同做了同一件事: 把整个产品「压扁」成了命令行。
3 月 17 日,钉钉发布「悟空」平台,宣布完成全面 CLI 化改造。10 天后,CLI 代码开源。
3 月 28 日,飞书跟上,CLI 开源,Go 语言,MIT 协议。
两家……都没有选 MCP。
这背后,是一个正在成型的行业共识:Agent 操作软件的最佳方式,恐怕就是那个最古老的命令行。
读过我之前文章的朋友应该有印象,我一直在实践和呼吁软件的 CLI 化,见:
之前主要都是开源社区在推,而这一次,是国内两大办公平台官方亲自下场了。
所以,我今天把两个 CLI 都装上,仔细看了一遍。
下面聊聊它们各自做了什么,差在哪,以及为什么整个行业都在朝这个方向跑。
钉钉先出手
钉钉的动作更早,也更激进。
3 月 17 日阿里发布「悟空」平台时,钉钉 CTO 朱鸿说的是:
“我们希望每一个 AI Agent,都能像调用系统命令一样自然地调用钉钉。
注意用词,「系统命令」,不是「API」,不是「协议」,是 ls、cd、grep那种东西。
DingTalk Workspace CLI
钉钉做的事情是重写底层代码,把整个产品 CLI 化。并非在现有 GUI 上包一层壳,是让 Agent 直接调用底层能力,绕过图形界面。
GitHub 项目叫 dingtalk-workspace-cli,Go 语言写的,8MB 的原生二进制文件,Apache-2.0 协议。安装方式是一行 curl 脚本,装完之后本地多一个 dws命令。
实际装完跑一下 dws --help,能看到 12 个服务模块:
aitable AI 表格操作
attendance 考勤打卡 / 排班 / 统计
bot 机器人消息 / Webhook
calendar 日历日程 / 会议室 / 闲忙
chat 群聊 / 会话 / 群组管理
contact 通讯录 / 用户 / 部门
devdoc 开放平台文档搜索
ding DING 消息 / 发送 / 撤回
oa OA 审批 / 同意 / 拒绝 / 撤销
report 日志 / 模版 / 统计
todo 待办任务管理
workbench 工作台应用查询
命令结构是标准的「服务/资源/动作」三级,比如 dws calendar event create、dws contact user search --keyword "张三"。
也没什么花哨的东西,但直觉上倒是挺好理解的。
钉钉还做了几个面向 Agent 的设计细节:
--yes参数。这个参数的描述是「跳过确认提示(AI Agent 模式)」。加上它之后,Agent 执行操作不会被交互式确认卡住。这个看似不起眼,但做过 Agent 开发的应该都懂:一个交互式 prompt 就能让整个自动化流程崩溃。
--mock参数。可以用模拟数据测试,不用真的连钉钉后台。开发调试的时候非常实用。
--dry-run预览。所有可能产生副作用的操作都能先预览再执行。Agent 要删个日程、发个 DING 消息之前,先看看要干什么。
安全方面,钉钉做了三件事:无感认证(Agent 自动继承企业权限)、批量熔断(防止 Agent 失控批量操作)、安全沙箱(所有操作在沙箱内执行)。
钉钉还搞了个叫 RealDoc 的 AI 原生文件系统,号称有 10000+ 条可用命令行指令,支持原子级文件操作,所有操作保留完整快照。
飞书的三层架构
飞书晚了 10 天,但在架构设计上明显花了更多心思。
飞书 CLI 叫 lark-cli,同样是 Go 写的,但通过 npm 分发(包了一层 Node.js wrapper),14MB。MIT 协议。
一行命令装完:npm install -g @larksuite/cli
跑一下 lark-cli --help,第一眼就能看出跟钉钉的差异:飞书的命令体系是三层设计。
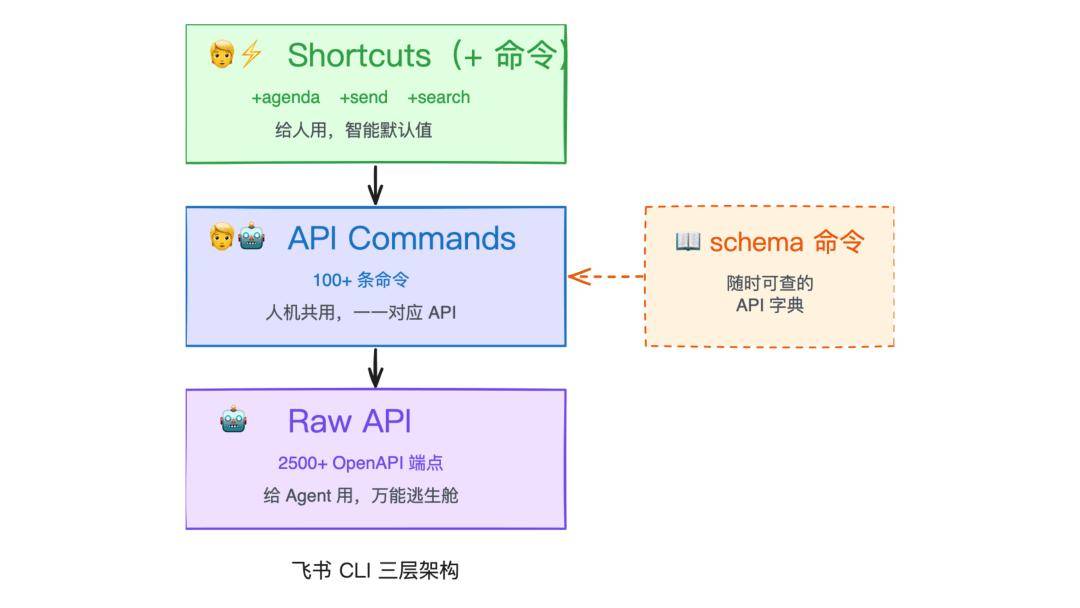
飞书 CLI 三层架构
第一层:Shortcuts(+前缀命令)。
这是飞书最有辨识度的设计。所有快捷命令都带 +前缀,内置智能默认值:
lark-cli calendar +agenda # 看今天日程
lark-cli im +messages-send --text "hello" --chat-id oc_xxx
lark-cli contact +search-user --query "John"
lark-cli docs +fetch --doc-id xxx
这些命令做了大量参数简化。比如 +messages-send,支持 --text、--markdown、--image、--file这些直接参数,不用自己拼 JSON content 。
对 Agent 来说,写 --markdown "会议纪要已生成"比拼一段 {"msg_type":"post","content":{"post":{"zh_cn":...}}}要友好得多。
光是 base(多维表格)模块,就有 68 个 shortcut 命令,从创建仪表盘到管理工作流,覆盖得挺全。
第二层:API Commands。
100 多条命令,跟飞书平台 API 一一对应。
比如 lark-cli calendar events list、lark-cli im messages create。
第三层:Raw API。
直接调用飞书底层 2500 多个 OpenAPI 端点:
lark-cli api GET /open-apis/calendar/v4/calendars
lark-cli api POST /open-apis/im/v1/messages --data '{"receive_id":"ou_xxx",...}'
这层相当于一个万能逃生舱:不管飞书有什么 API,即使 CLI 没有封装对应的命令,你也能直接调。
从而让 Agent 遇到边缘场景的时候不会被卡住。
飞书还内置了一个 schema命令,可以查看任何 API 方法的参数、类型和所需权限:
lark-cli schema calendar.events.list --format pretty
这对 Agent 来说相当于一本随时可查的 API 字典。
输出格式上,飞书支持 JSON、NDJSON、table、CSV、pretty 五种格式。钉钉支持 JSON、table、raw 三种。
飞书多出来的 NDJSON 和 CSV 在数据处理场景下挺关键的,可以直接 pipe 给 jq或者 csvtool做后续处理。
认证方面,飞书的设计也更细致一些。
lark-cli auth login支持按域(domain)申请权限,比如 --domain calendar,task只申请日历和任务相关的权限,不用一口气开全。还支持 --as user和 --as bot切换身份,同一个 CLI 可以模拟用户操作,也可以用应用身份批量处理。
还有个 lark-cli doctor命令,一键检查配置、认证和网络连通性,排查问题的时候应该比较省心。
两家对比
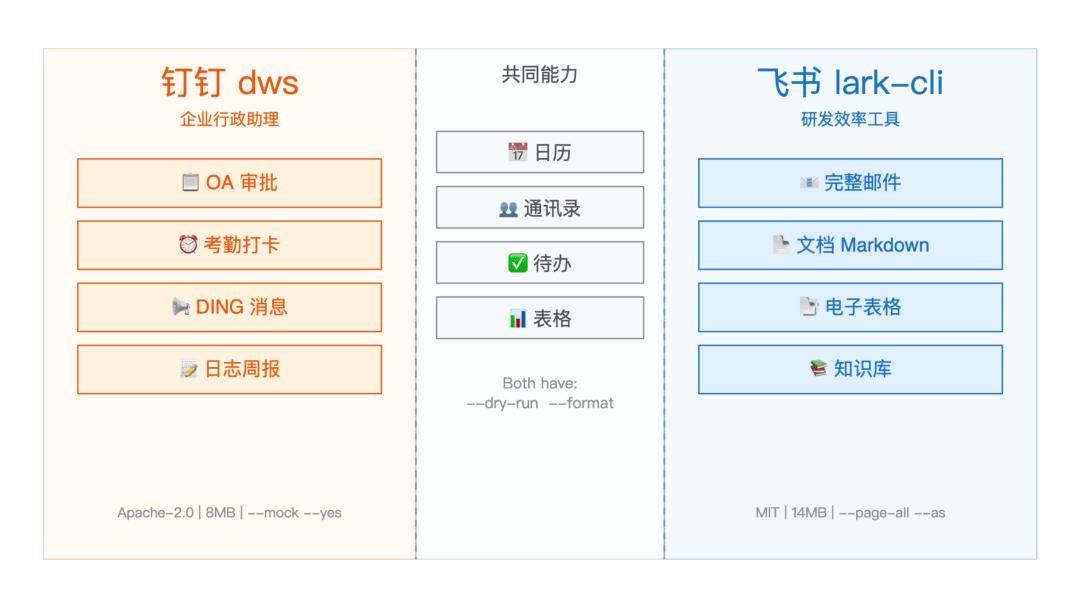
钉钉 vs 飞书 CLI 能力对比
两个 CLI 都装过用过之后,差异就出来了。
钉钉的优势侧重在企业管理场景。OA 审批(approve/reject/revoke)、考勤(打卡/排班/统计)、DING 消息、日志/周报,这些飞书 CLI 里完全没有。如果你的 Agent 需要帮老板批审批单、查考勤、催日报,钉钉目前是唯一选择。
飞书的优势在开发者体验和文档协作。完整的邮件客户端(搜索/起草/发送/转发/监听新邮件)、文档的 Markdown 互转、电子表格的读写追加查找、知识库管理、会议纪要搜索,这些钉钉 CLI 目前都还没覆盖到。
用一个比喻来说,钉钉 CLI 像是给企业行政部门配的数字助理,飞书 CLI 更像是给研发团队配的效率工具。
架构哲学上的差异也比较明显:
钉钉走的是「服务发现」路线,dws --help里写的是「Discovered MCP Services」,命令帮助全部是中文。
飞书走的是「开发者工具」路线,三层架构从快捷到通用逐级递进,全英文界面,还附带了 19 个 AI Skill 可以直接装进 Claude Code。
全局参数上,两家都有 --dry-run和 --format。钉钉独有 --mock(模拟数据)和 --yes(跳过确认),飞书独有 --page-all(自动翻页)和 --as(身份切换)。
开源层面,飞书的 GitHub 星标(1313)几乎是钉钉(815)的 1.6 倍。
差点自己动手
说句实话,看到飞书出 CLI 的时候,我的第一反应是: 总算特么来了。
因为我其实,差点就上手自己做了。
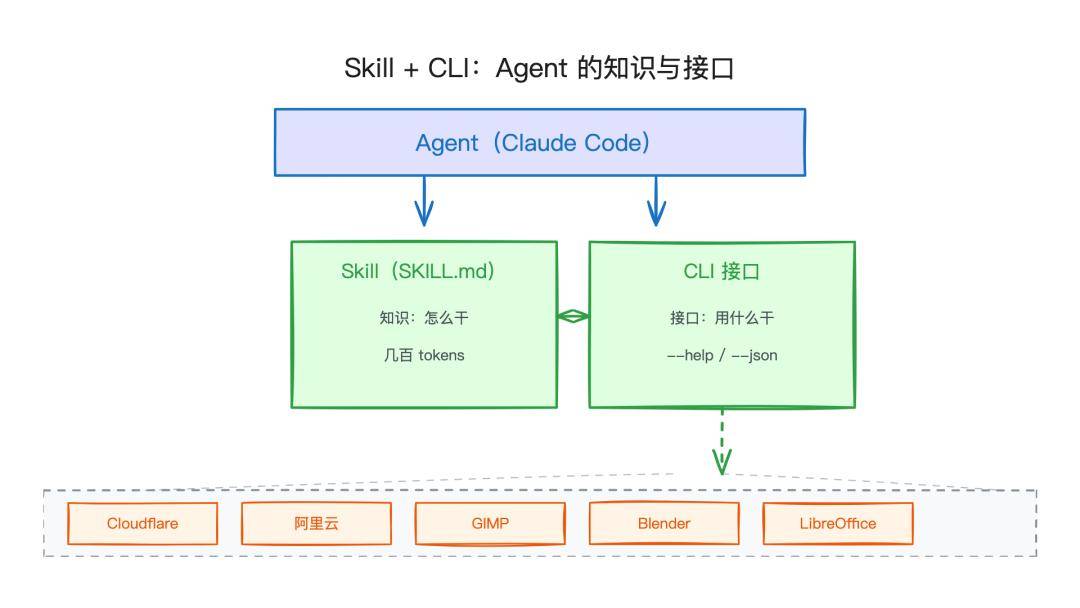
Skill + CLI 的组合架构
我之前文章里聊过,我从去年起就一直偏爱用 CLI + Skill 的方式操控各种服务:Cloudflare 的 CLI 管域名解析和 Workers 部署,aliyunCLI 管 RAM 用户和 OSS 存储,gcloudCLI 操作 Google Cloud。
我会把这些 CLI 的用法写成 Skill(更早时还没有 Skill),告诉 Claude Code 每个命令该怎么用,Agent 就能直接上手。
飞书是我日常用得最多的办公工具之一,但之前一直没有官方 CLI。社区里虽然有个 feishu-cli(500 多颗星),能做 Markdown 和飞书文档的双向转换,但覆盖面远远不够。我已经在琢磨自己基于飞书 OpenAPI 包一套 CLI 出来了。
结果飞书官方直接出了,还一上来就是 2500+ API 端点全覆盖。
省了我不少事,但也说明了一个问题:当用户都开始自己动手给你的产品做 CLI 的时候,说明官方已经晚了。飞书这次,算是踩在了临界点上。
钉钉和飞书之后,企业微信、Notion、Slack、……等应该都不会坐得住太久了。
它们都清楚,谁先出 CLI,谁就先拿到 Agent 时代的入场券。
MCP 的 17 倍成本
技术选型上,两家绕开 MCP 是有充分理由的。
ScaleKit 做过一组 benchmark,拿 GitHub 官方 MCP 服务器和 ghCLI 做了一组对照实验,跑的模型是 Claude Sonnet 4。
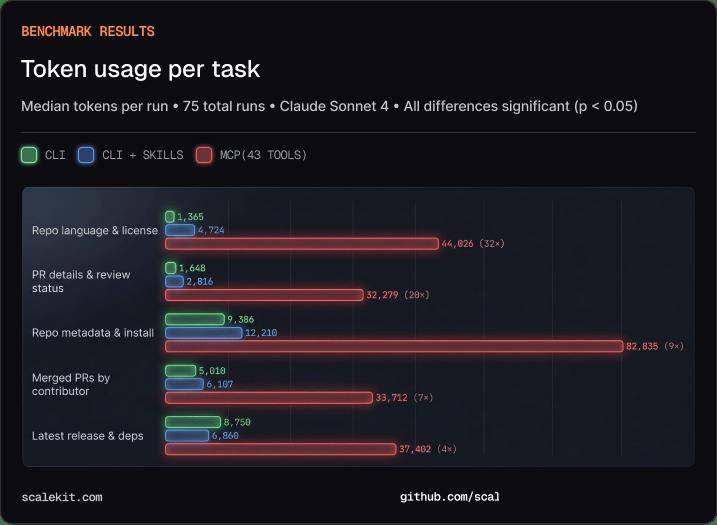
各任务的 Token 消耗对比
查一个仓库用什么语言,CLI 消耗 1,365 tokens,MCP 消耗 44,026 tokens。
足足 32 倍!
查 PR 详情和审核状态?CLI 1,648 tokens,MCP 32,279 tokens。20 倍。
查仓库元数据和安装方式?CLI 9,386 tokens,MCP 82,835 tokens。9 倍。
所有 5 项任务的差异都具有统计显著性(p < 0.05)。
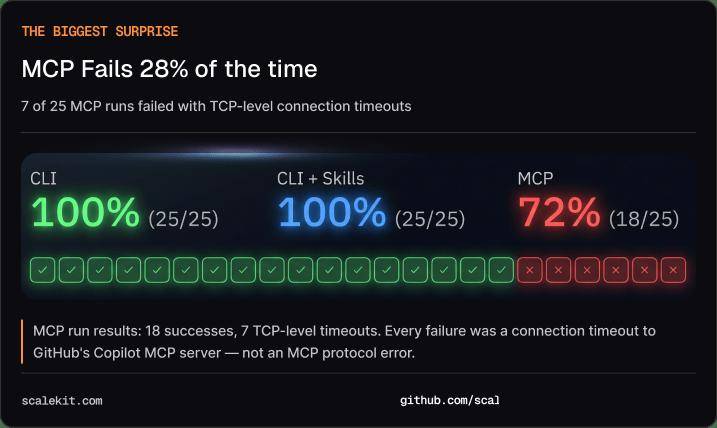
MCP 有 28% 的失败率
可靠性的差距更大:
CLI 跑了 25 次全部成功。MCP 只成功了 18 次,失败率 28%。7 次失败全是 TCP 层面的超时。
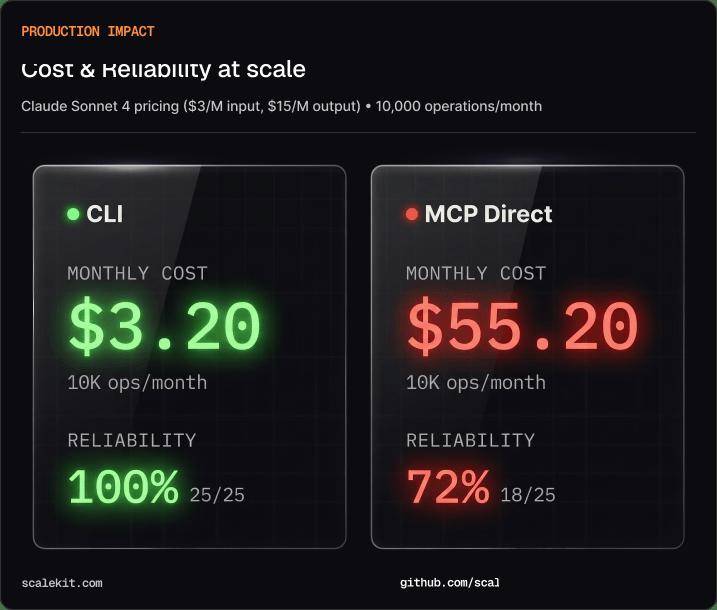
成本与可靠性对比
按月算就更直观了:每月 1 万次操作,CLI 大约 3.2 美元,MCP 大约 55.2 美元。17 倍的成本差距。
问题出在哪呢?
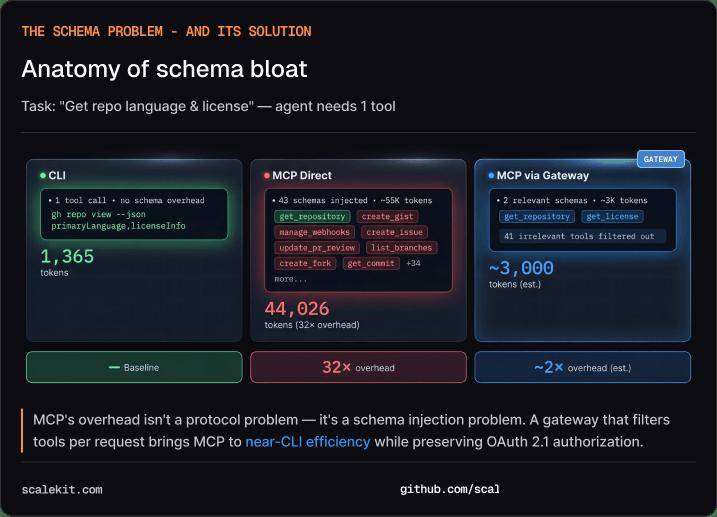
Schema 膨胀的解剖
MCP 的 schema bloat。GitHub 的 MCP 服务器带了 43 个工具定义,每次对话都得把这 43 个工具的完整描述全塞进上下文。你只是想查个仓库语言,但模型得先读完所有 43 个工具的说明书。
光一个 list_stars_language_is_known工具的定义就占了 4,026 tokens。
这就像去便利店买瓶水,店员非要先把整本商品目录念给你听。
ScaleKit 指出了一个关键判断:MCP 的效率问题不在于协议本身,而在于 schema 注入机制。但问题是,这个机制恰恰是 MCP 设计的核心,你没法绕开它。
而 CLI 呢?Agent 只需要跑一下 --help,按需读取某个子命令的参数说明就行。不用、也不会把所有命令的文档一股脑塞进上下文。
Perplexity 的 CTO Denis Yarats 在今年的 Ask 开发者大会上也表了态:Perplexity 内部正在远离 MCP,原因是 72% 的上下文窗口被 MCP 占掉了,再加上认证带来的摩擦成本。
旧金山街头投票
Composio 的联合创始人 Karan Vaidya 上周跑到旧金山街头做了个随机调查,就问路过的开发者一个问题:CLI 还是 MCP?
结果是:CLI 17 票,MCP 3 票。
OpenAI 前联合创始人 Greg Brockman 站了 CLI。Y Combinator CEO 陈嘉兴的态度更干脆:MCP sucks。一位被采访的开发者则贡献了全场最佳金句:
“MCP 像 Java 一样臃肿。
Composio 顺势发了自己的 Universal CLI,并给出了一个很精准的重新定义:这场争论的本质不是品味之争,是延迟之争。
CLI 和 MCP 的核心差异,归根到底就是一个快一个慢,一个轻一个重。35 岁以下的开发者基本上全选了 CLI。
这说明什么呢?
新一代开发者已经形成了一种直觉:能用一行命令解决的事,别搞一套协议。
安全是伪命题吗
当然,也不是所有人都买账。
Okta(Auth0 的母公司)的研发副总裁 Damian Schenkelman 写了篇文章,标题就很刚:「如果你要杀死 MCP,说明你根本不在乎安全」。
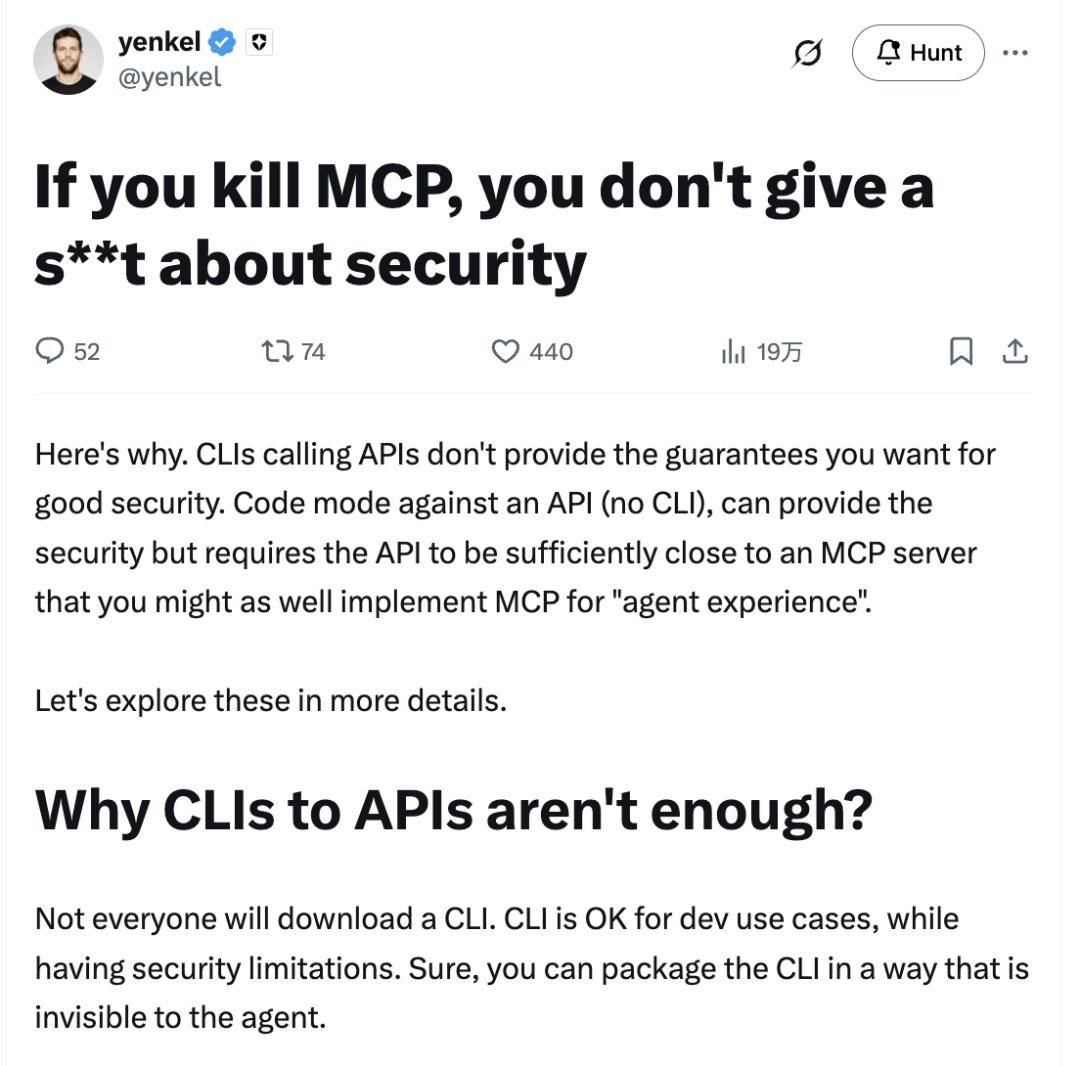
核心论点是:CLI 调 API 要是认真做安全的话,你最终得加上 OAuth 授权、动态客户端注册、敏感操作审批、服务端鉴权……加完这些,你其实就重新发明了 MCP。
他列了几条:没法基于 Agent 身份做策略管控(比如只允许特定 AI 厂商的 Agent 接入);鉴权应该在服务端,不能信任客户端;敏感操作需要人工审批,Agent 搞砸了得有人能拦住。
这个论证乍一看确实有些道理,不过仔细想想,其实犯了一个典型的「过度泛化」错误。
Schenkelman 描述的是一个完全开放的生态场景:你做了一个 SaaS,互联网上任何 Agent 都可能来调你的 API,你不知道对方是谁,不知道它要干什么。
在这个场景下,确实需要 MCP 那套完整的协议握手。
但钉钉和飞书面对的场景则完全不同。
企业内部的 Agent 身份是已知的,权限是预设的,操作在沙箱里跑,日志全程可追溯。钉钉的批量熔断机制,飞书的 dry-run 预览和按域权限申请,本质上就是在 CLI 层面实现了 Schenkelman 所说的那些安全措施。
只是没套 MCP 那个协议壳子而已。
换个说法:你家里人进厨房拿刀切菜,不需要先通过安检、出示身份证、签免责协议。但如果是陌生人进你的厨房,那确实应该先问问他是谁、要干什么。
MCP 是给陌生人设计的安检流程,CLI 是给自家人用的厨房工具。
硬把安检流程套在自家人身上,除了浪费时间,没有任何安全增益。
翻译层的演化
从更长的时间线看,这件事几乎是必然的。
在之前的 中,我提过一个「第四次迁移」的框架:大型机 → PC → 移动 → Agent,每一次迁移都是因为出现了新的用户。
而每次迁移,旧时代的巨头恰恰因为在旧界面上做得太好,反而无法适应新界面。Nokia 的实体键盘体验全球第一,但触屏时代这成了累赘。
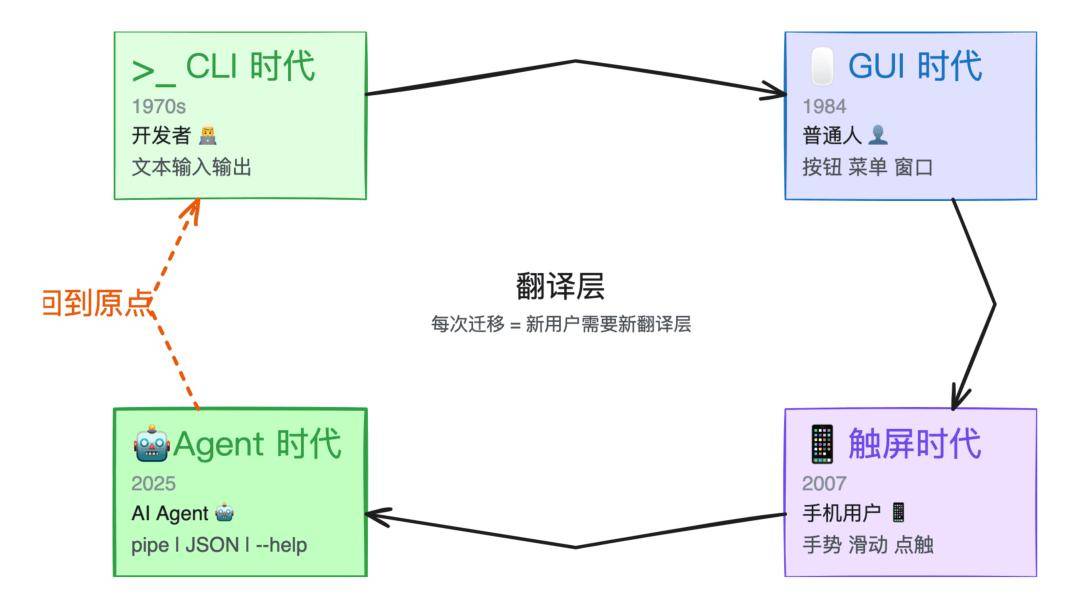
翻译层的演化:从 CLI 回到 CLI
这次也一样。计算机诞生以来,人和机器的交互方式经历了三次大迁移:命令行 → 图形界面 → 触屏。每一次迁移,都是因为出现了新的「用户」,需要新的翻译层。
普通人不会打命令,所以有了 GUI。手机用户不方便用鼠标,所以有了触屏。
现在又来了一种新用户:AI Agent。
Agent 不需要按钮和菜单,那些是给人类视觉系统设计的翻译层。Agent 不需要触屏手势,那是给人类手指设计的。
Agent 要的是结构化的输入输出,要的是可以 pipe 的文本流,要的是 --help就能自描述的命令接口。
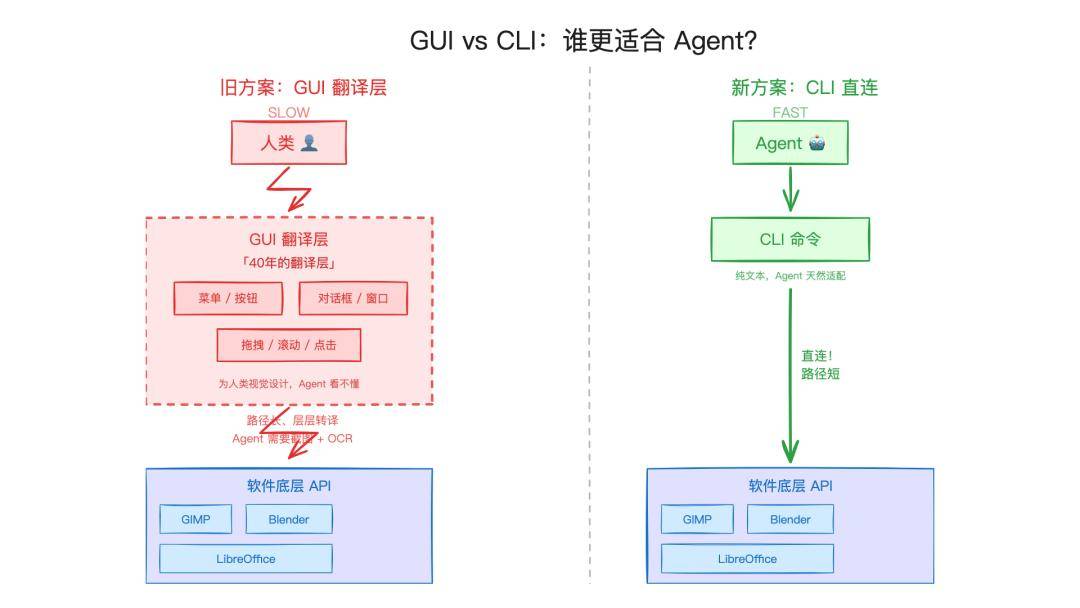
GUI 是翻译层:人类需要,Agent 不需要
而这恰恰就是 CLI 在五十年前就已经实现的东西。
LLM 的训练数据里有数十亿行 shell 命令和脚本。对模型来说,写一行 lark-cli calendar +agenda | jq '.items[]'比理解一个 MCP 工具的 JSON Schema 定义要自然得多了。
Unix 哲学里的 pipe、组合、文本流,这些设计范式已经稳定运行了五十年。
CLI 是 LLM 的母语,MCP 是后天学的外语。
所以这轮迁移出现了一个反直觉的现象:不是从旧到新,是从新回到旧。GUI 是 CLI 之后发明的「翻译层」,而 Agent 时代的最佳接口,恰恰就是翻译层之前的原始形态。
钉钉和飞书的选择,本质上是在顺应这个事实。
当你的用户从人变成了 AI,你就该用 AI 最擅长的方式暴露你的能力。
回头看几个时间线:
……
CLI-Anything 在 GitHub 上拿了 15000 颗星,证明了开发者社区对「万物 CLI 化」的热情。
然后 OpenCLI 把浏览器和 Electron 应用也 CLI 化了,30 多个站点和应用被拉通。现在,钉钉和飞书官方亲自下场。
……
从社区自发 → 第三方工具 → 官方亲自做,这条路正在成为共识。
MCP 会死吗?
倒也不会。
它会退到它该待的地方:开放生态的接入协议层。就像 SOAP 没有死,只是退回到了企业内部集成的角落,大部分开发者已经忘了它的存在。
而 CLI,将成为 Agent 操作一切软件的默认界面。
钉钉和飞书,只是第一批想明白这件事的。
接下来,整个 SaaS 的 API surface,将全都暴露成 CLI。
◇ ◆ ◇











