

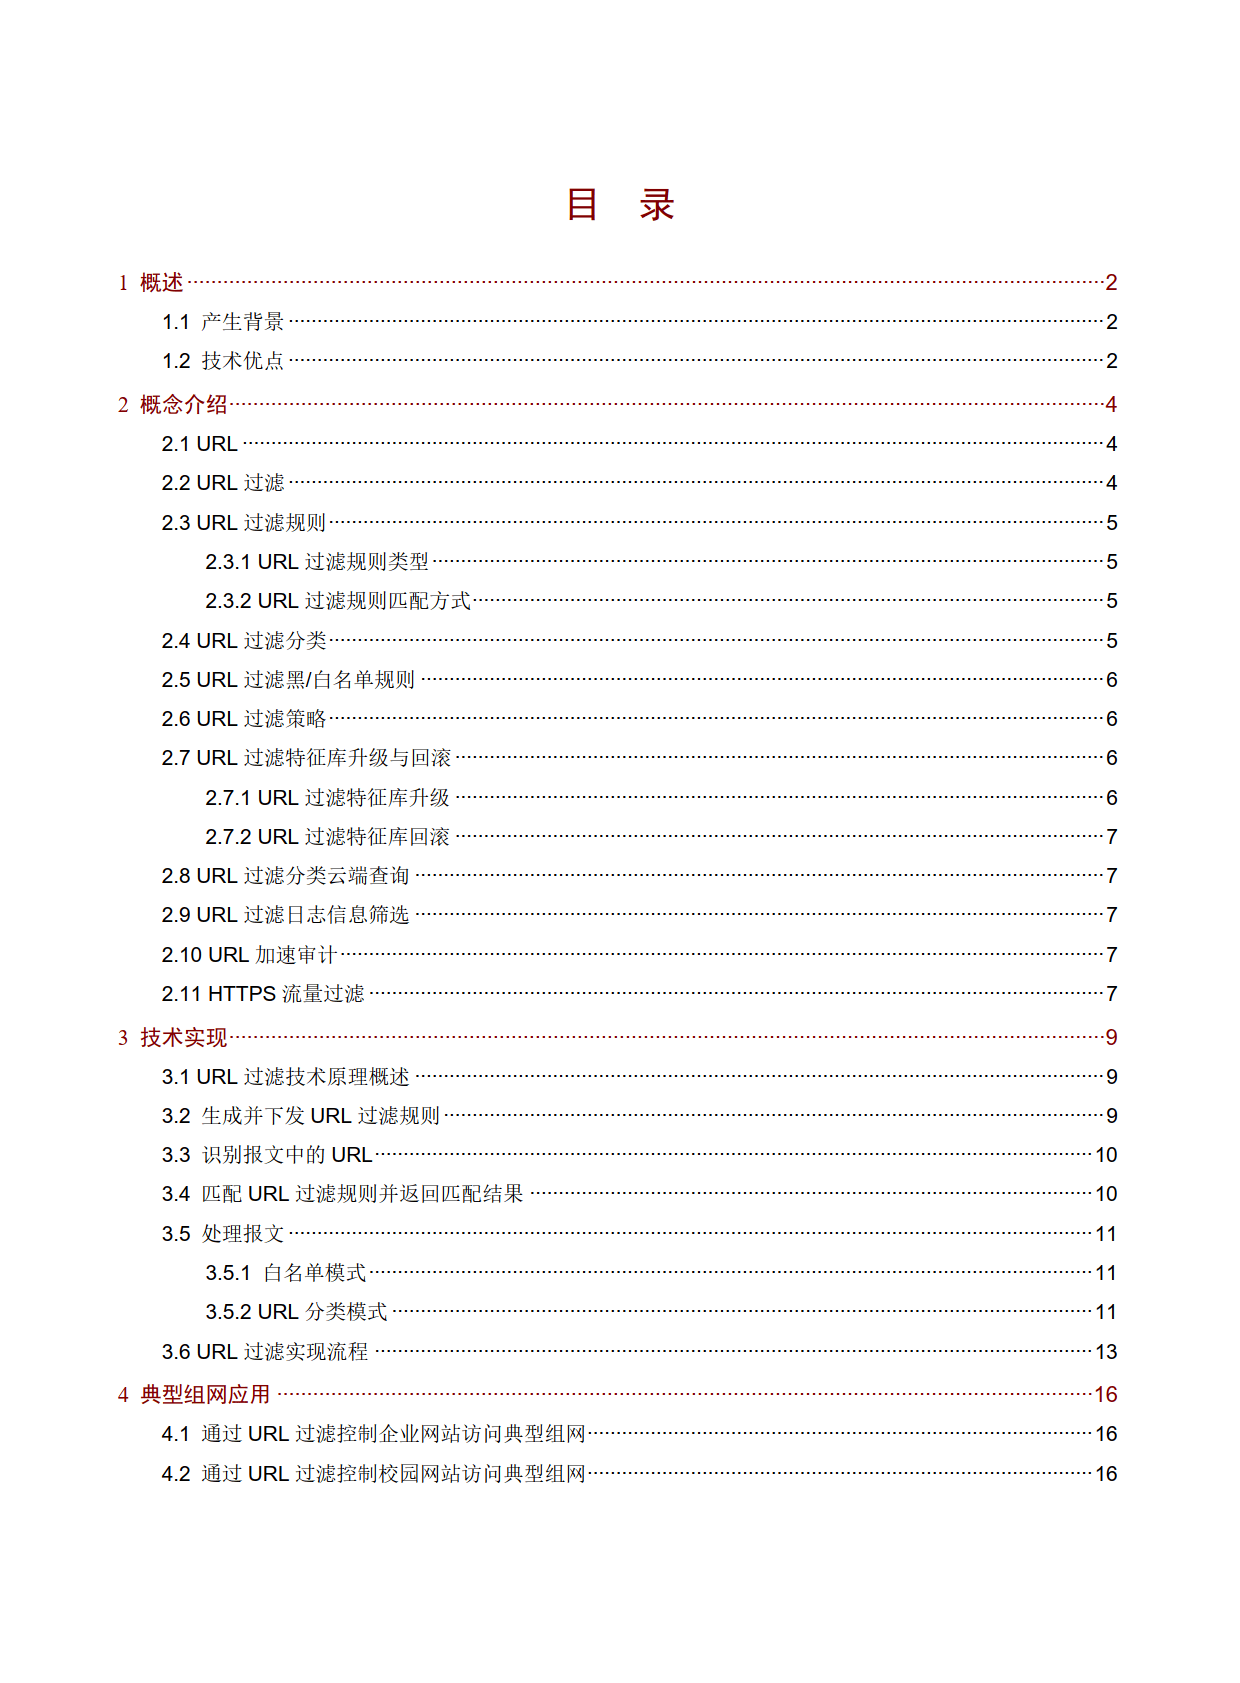
URL 过滤是基于 DPI 深度报文检测的核心网络安全技术,用于精细化管控网站访问、抵御网络威胁、保障网络合规与带宽效率,广泛适用于企业、校园等场景。本白皮书围绕其背景、概念、实现与应用展开系统说明,为网络安全管控提供完整技术方案。
一、技术背景与核心优势
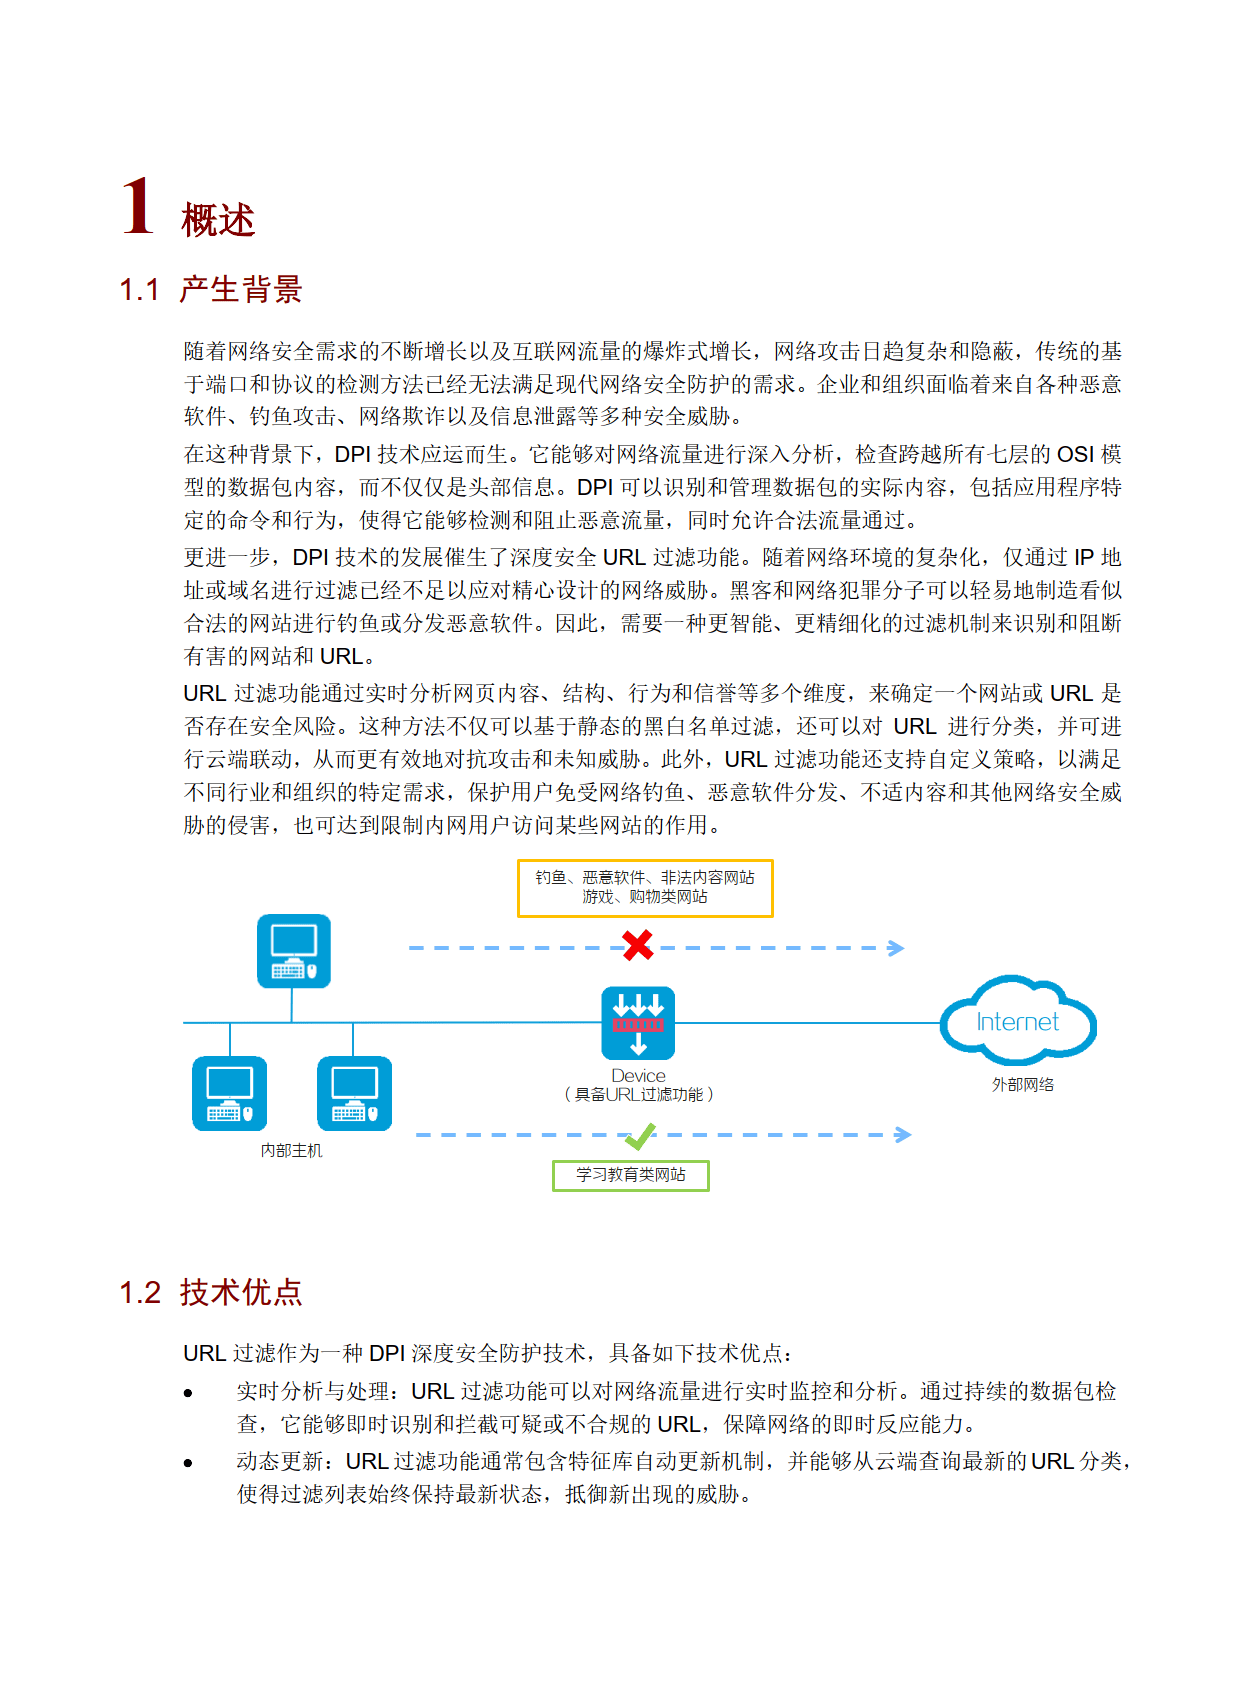
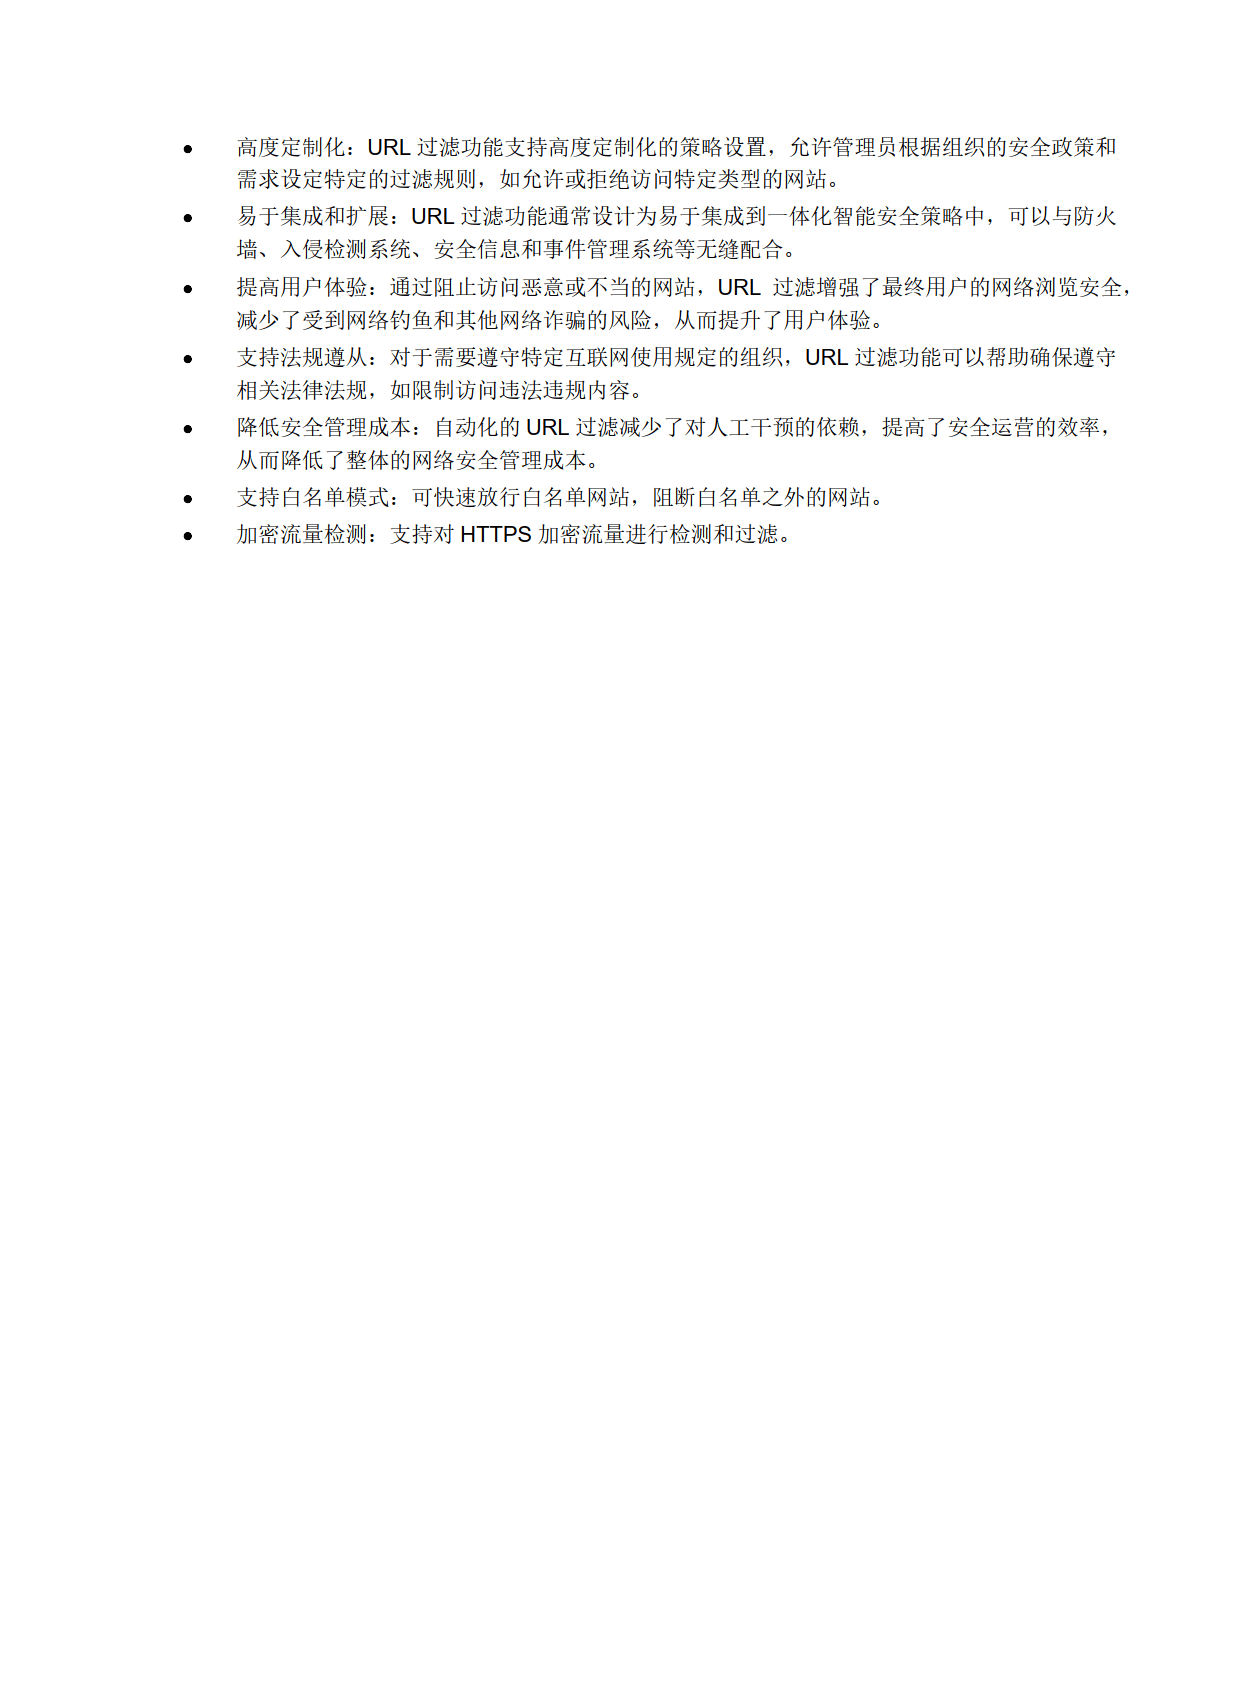
随着网络威胁复杂化,传统端口与协议检测难以应对钓鱼、恶意软件、非法内容等风险,DPI 技术推动 URL 过滤走向成熟。该技术具备七大核心优势:实时流量分析与拦截、特征库动态更新、策略高度定制化、易与防火墙等安全设备集成、提升用户上网安全、助力法规遵从、降低运维成本,同时支持白名单严格管控与 HTTPS 加密流量过滤。
二、核心概念与规则体系
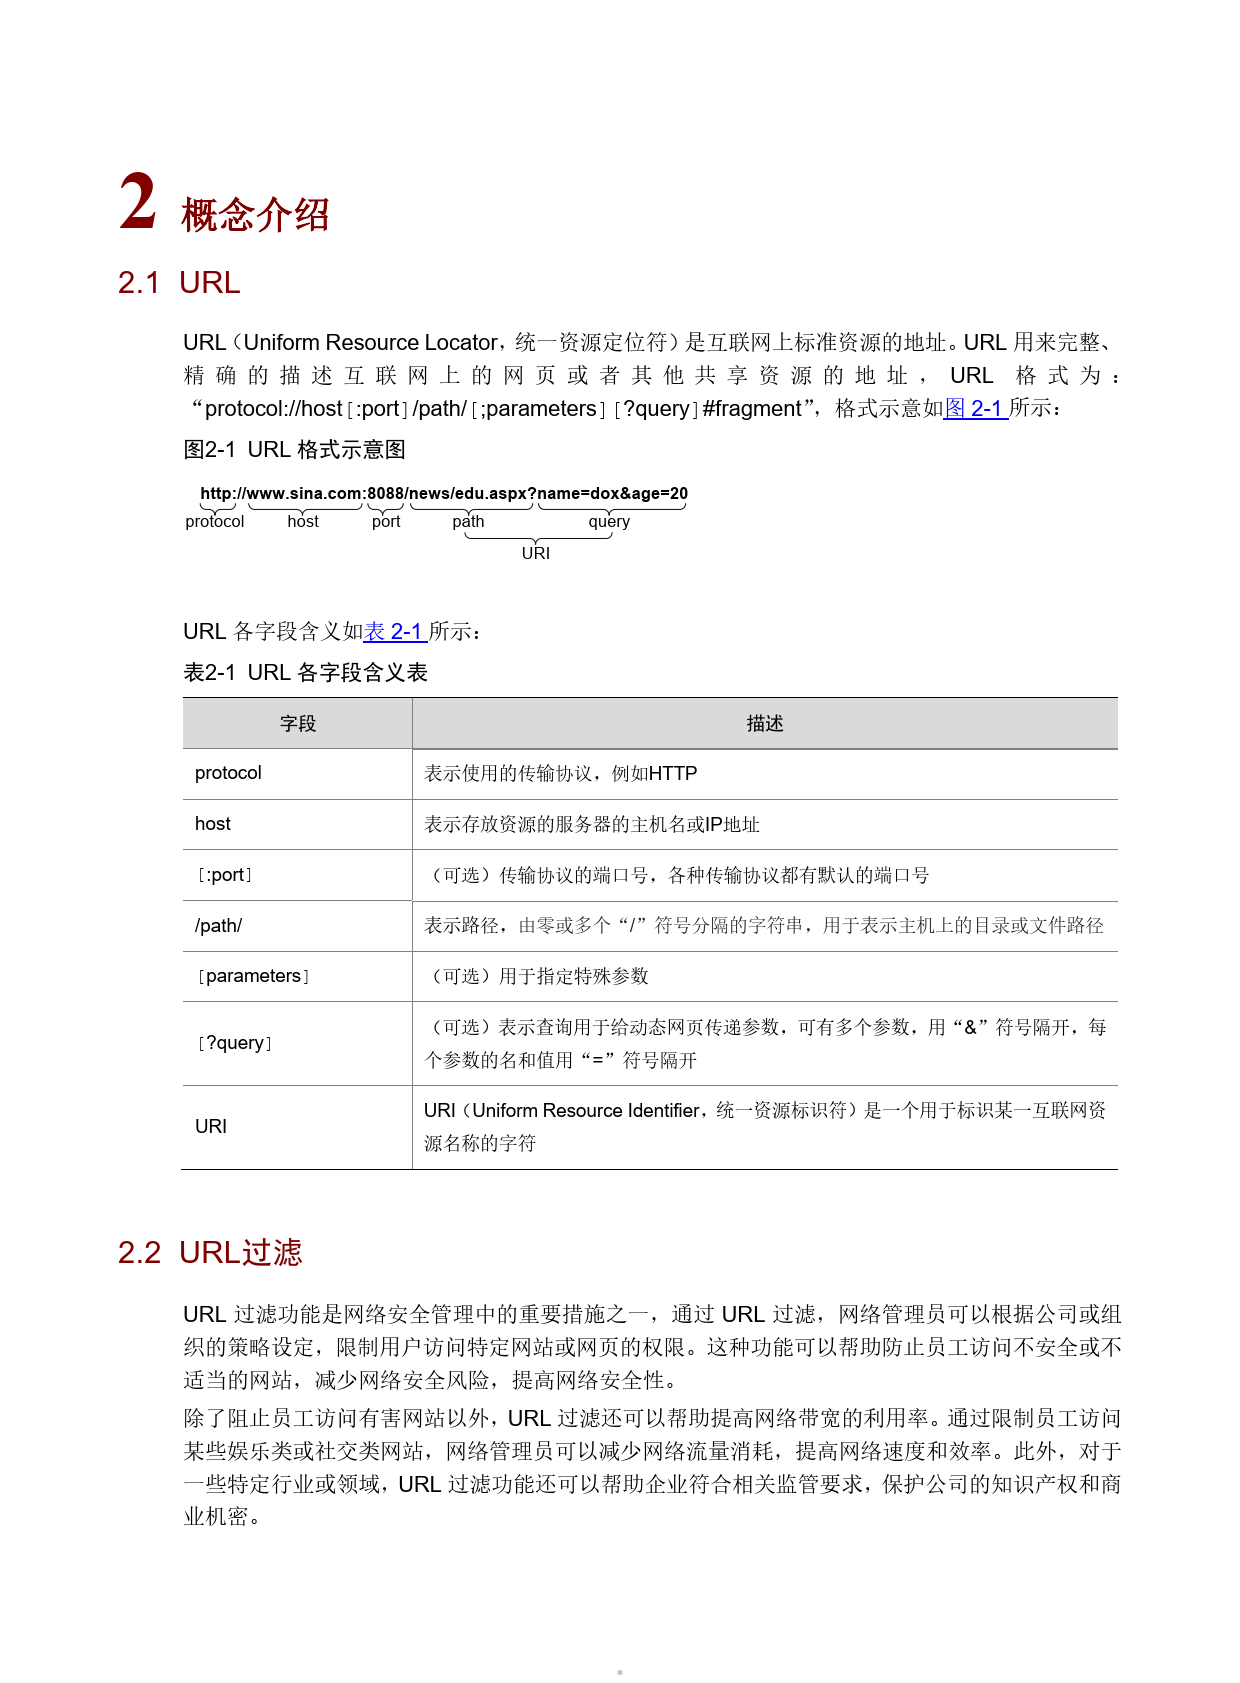
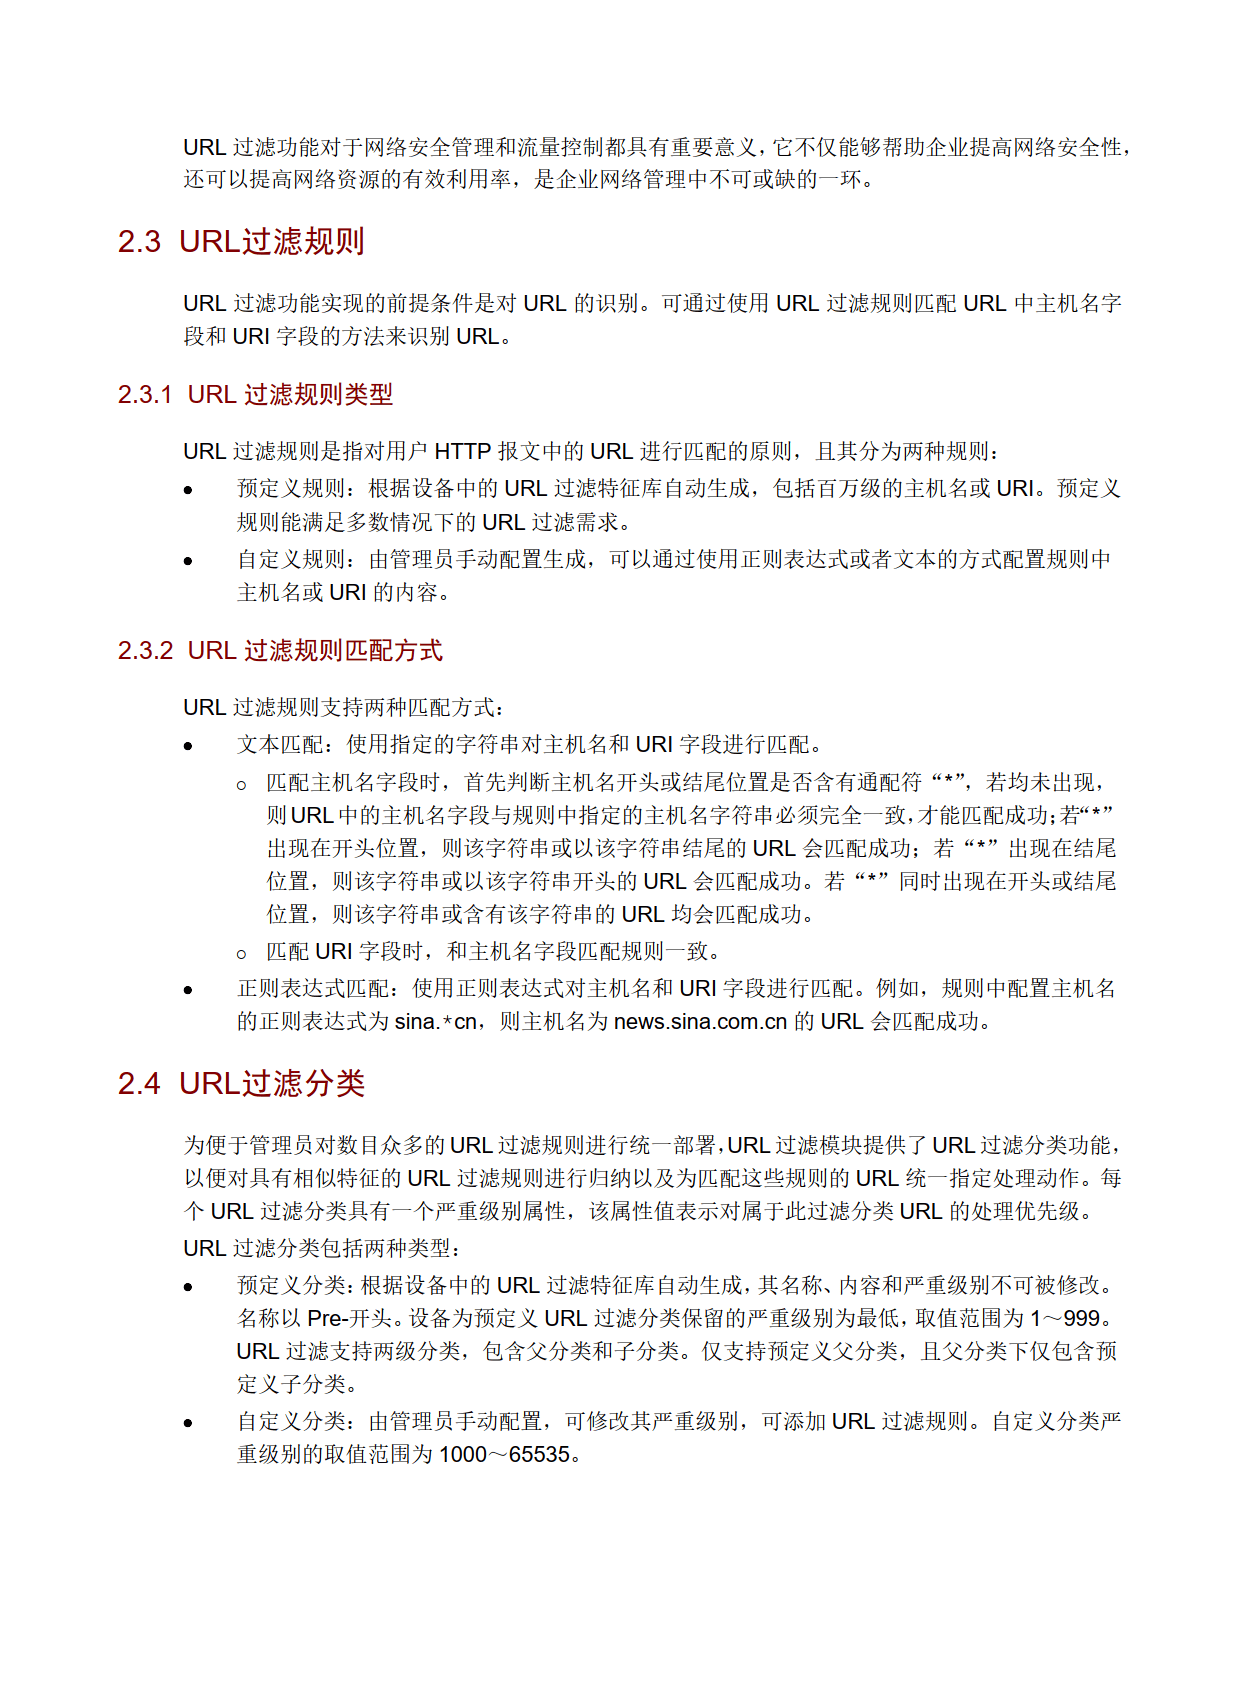
URL 即统一资源定位符,是网络资源标准地址。URL 过滤通过匹配规则管控访问,规则分为预定义规则(特征库自动生成)与自定义规则(管理员配置),支持文本与正则表达式两种匹配方式。
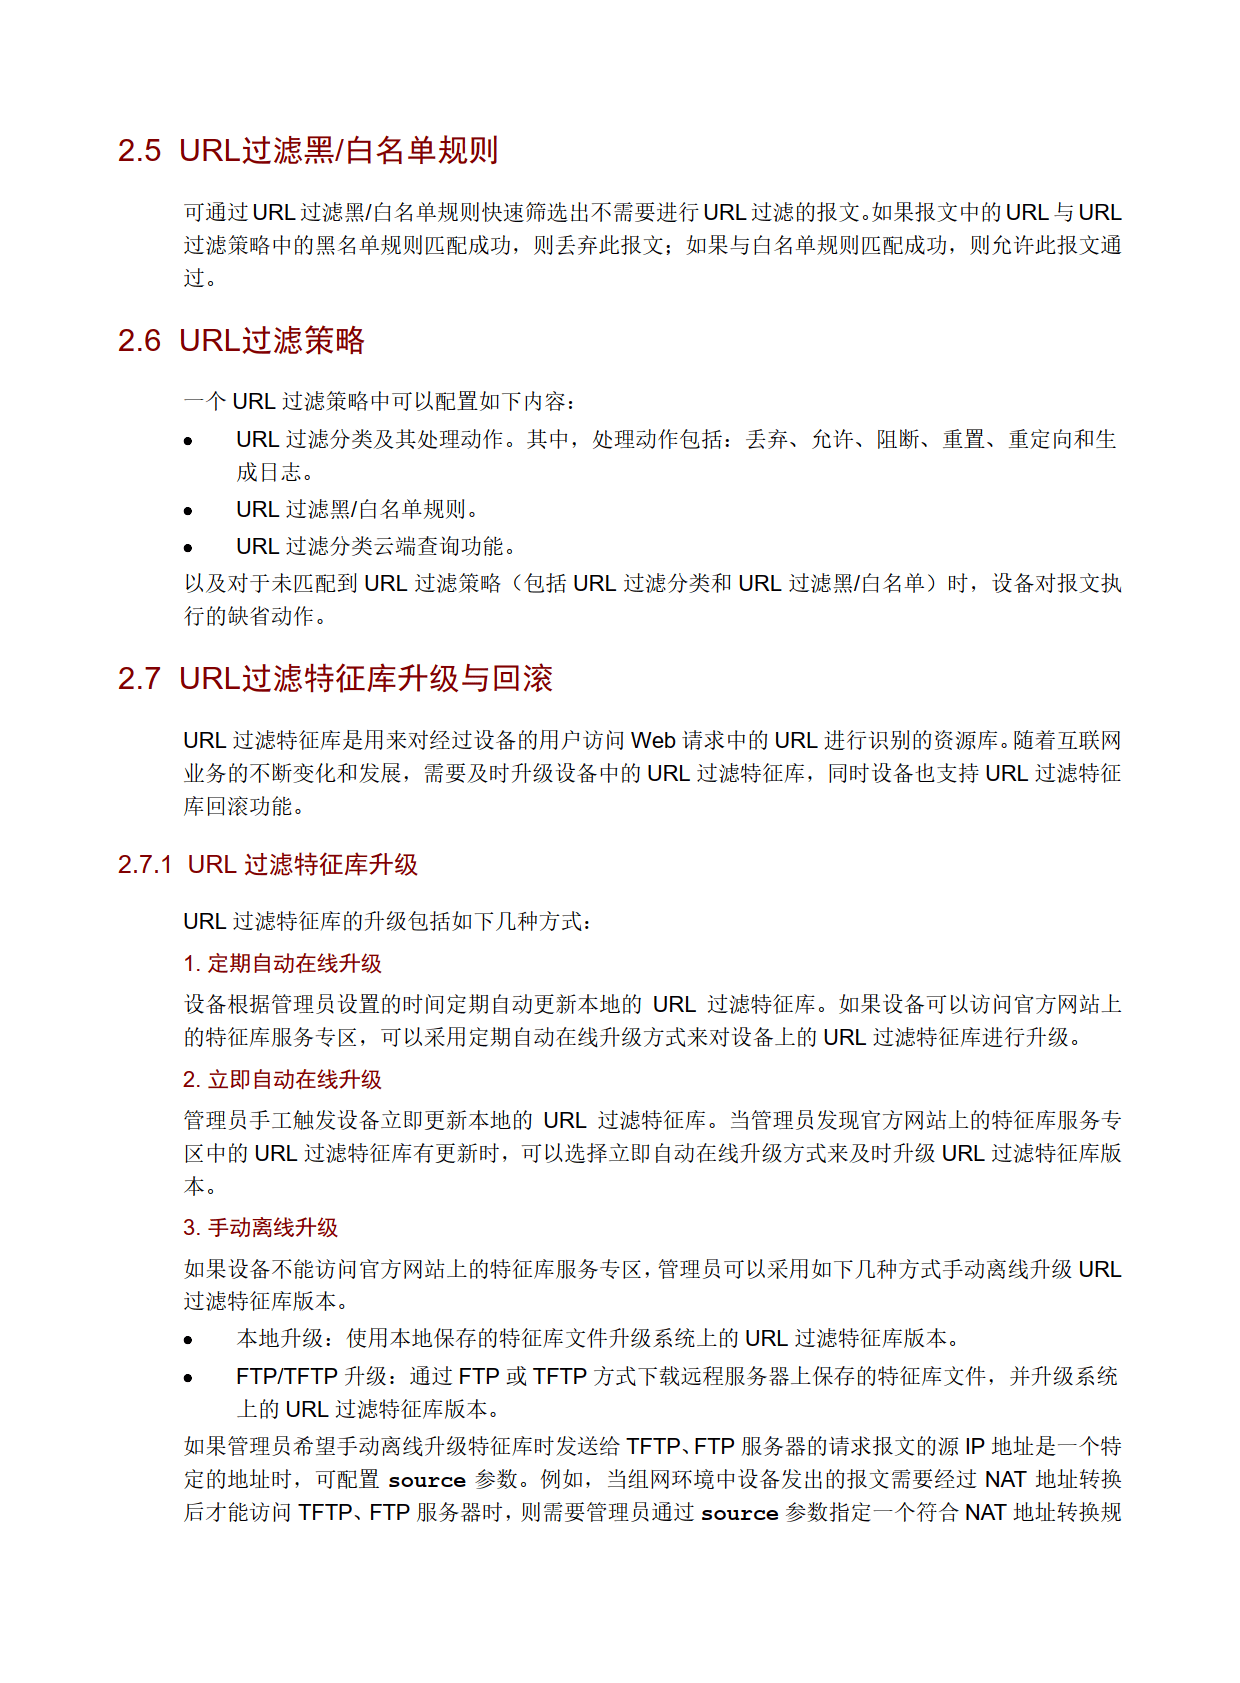
为便于管理,技术提供 URL 分类功能,含预定义分类与自定义分类,可设置严重级别决定执行优先级。同时支持黑白名单机制,白名单直接放行、黑名单直接阻断,优先级高于分类策略。
系统支持特征库自动 / 手动升级与异常回滚,可开启云端查询提升识别准确率,缓存查询结果优化效率;支持日志筛选与 URL 加速审计,在 CPU 高负载时保障转发性能;HTTPS 过滤可通过 SNI 字段检测实现,无需解密即可管控,减少性能损耗。
三、技术实现流程
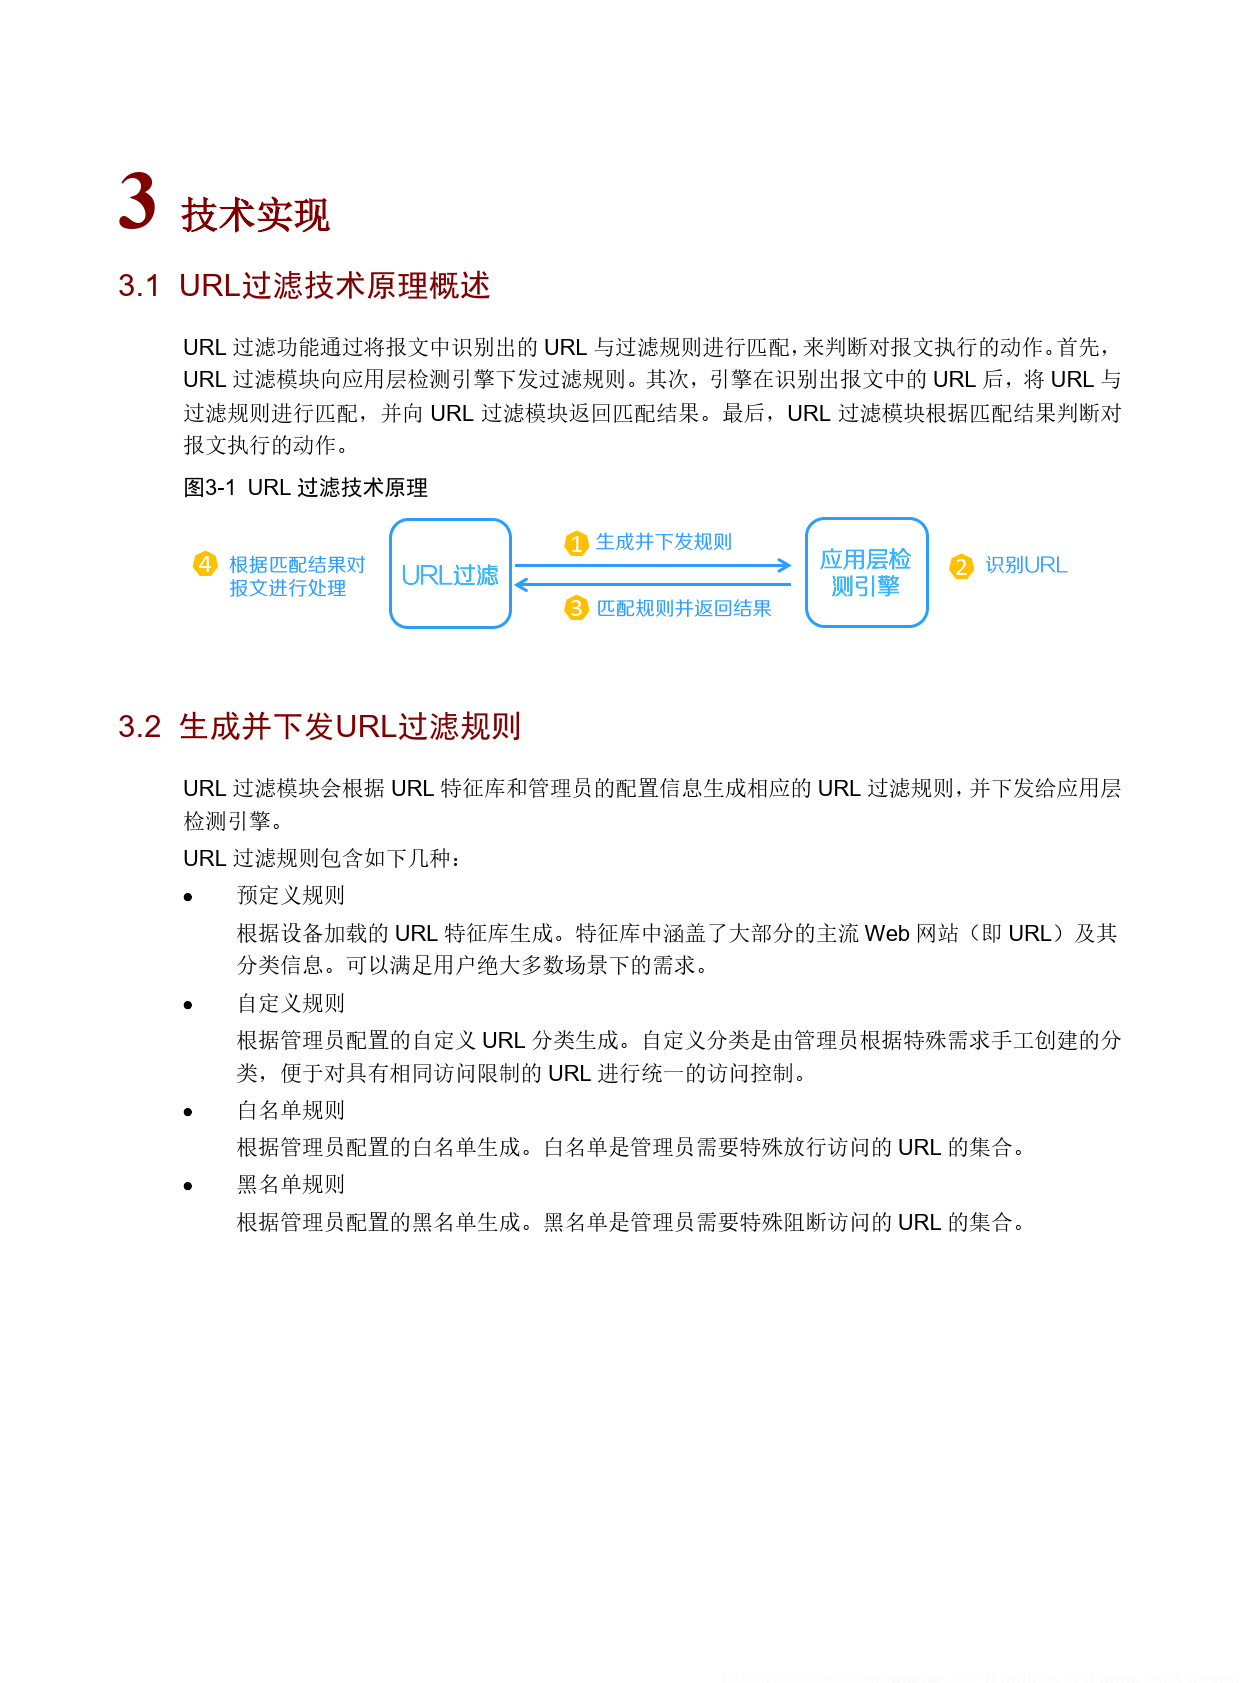
URL 过滤遵循 “规则下发 —URL 识别 — 规则匹配 — 报文处理” 的标准化流程:
- 设备基于特征库与管理员配置,生成预定义、自定义、黑白名单规则并下发至检测引擎;
- 引擎解析报文,提取 Host 与 URI 组成完整 URL;
- URL 优先匹配黑白名单,白名单放行、黑名单阻断;无匹配则进入分类匹配,按最高严重级别执行动作;
- 本地无匹配时,开启云端查询则上送云端核验,未开启或查询失败则执行缺省动作。
处理模式分为白名单模式(仅放行指定网站)与分类模式(按类型灵活管控),可配置丢弃、允许、重定向、记录日志等动作。
四、典型应用场景
URL 过滤可部署于网络边界作为安全网关,满足多场景管控需求:企业场景可禁止员工访问视频、游戏、直播网站,提升工作效率,按部门精细化管控;校园场景可限制学生访问游戏、购物、娱乐网站,教师仅禁止游戏类访问,保障教学网络环境。
综上,新华三 URL 过滤以精准识别、灵活策略、云端协同、高效性能为核心,实现安全、合规、高效的网络访问管控,是现代网络安全防护的关键支撑技术。


免责声明:我们尊重知识产权、数据隐私,只做内容的收集、整理及分享,报告内容来源于网络,报告版权归原撰写发布机构所有,通过公开合法渠道获得,如涉及侵权,请及时联系我们删除,如对报告内容存疑,请与撰写、发布机构联系













