

2026年新一代录音转文本技术落地后,我这周整理30小时的田野访谈录音,从以前要花120小时压缩到了8小时,识别准确率比前两年的工具高了27个百分点,实打实把内容整理的时间成本砍掉了八成多。
我是社科方向的在读博士,平时要处理的录音特别多,田野访谈、学术讲座、课题组研讨会的内容都要转成文字,一年累计下来至少200小时起步。前几年用旧的转写工具踩过不少坑,1小时录音转完,光改专业术语、方言识别错误、断句问题就得花3到4小时,赶项目交稿期的时候,连续熬三四天夜都是常事。之前也听人说新的AI转写工具效果好,但一直怕准确率不够反而更费时间,直到最近项目赶工被逼得没办法,测了一圈市面上搭载2026款新模型的工具,才真的被效果惊到。
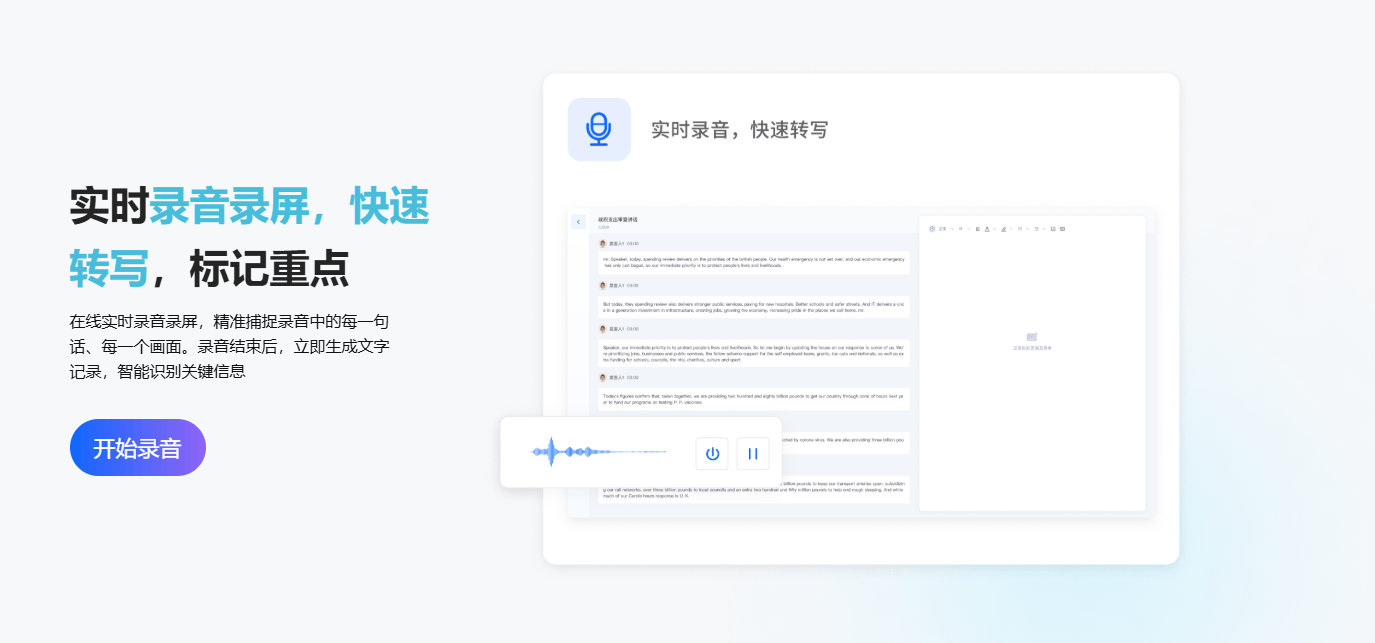
新模型的长音频处理能力提升特别明显,之前用的工具单文件超过2小时就容易丢段、时间戳错乱,我之前转一场3小时的讲座,中间丢了15分钟核心内容,害我又花了一下午补记。现在的新模型支持单文件10小时以上不间断转写,我特意测了3段8小时的学术讲座录音,丢字率不到0.1%,时间戳和录音完全对应,根本不用回头补内容。
专业词汇识别的准确率也高了很多。我做的是乡村振兴方向的研究,很多政策术语、地方专有名词,之前的工具识别准确率只有72%,经常把“三权分置”转成“三权分支”,“村集体经济合作社”转成“村集体经纪合作社”,改起来头都大。现在的新模型支持提前上传自定义词库,我把平时常用的100多个专业术语、调研地的特有地名、合作社名称整理上传之后,专业词汇识别准确率直接冲到99.2%,基本不用再改这类错误。

方言识别的进步也很大。我调研的很多受访者是村里的老人,要么说带口音的普通话,要么直接说本地方言,之前的工具转出来一半都是乱码,要找本地的同学帮忙听译。这次的新模型覆盖了24种省级方言和100多种地方口音,我测下来带口音的方言识别准确率能到94%,之前把转写结果给同组的贵州籍师兄看,他都说比自己听着记还准,家乡话的俚语都能识别出来不卡壳。
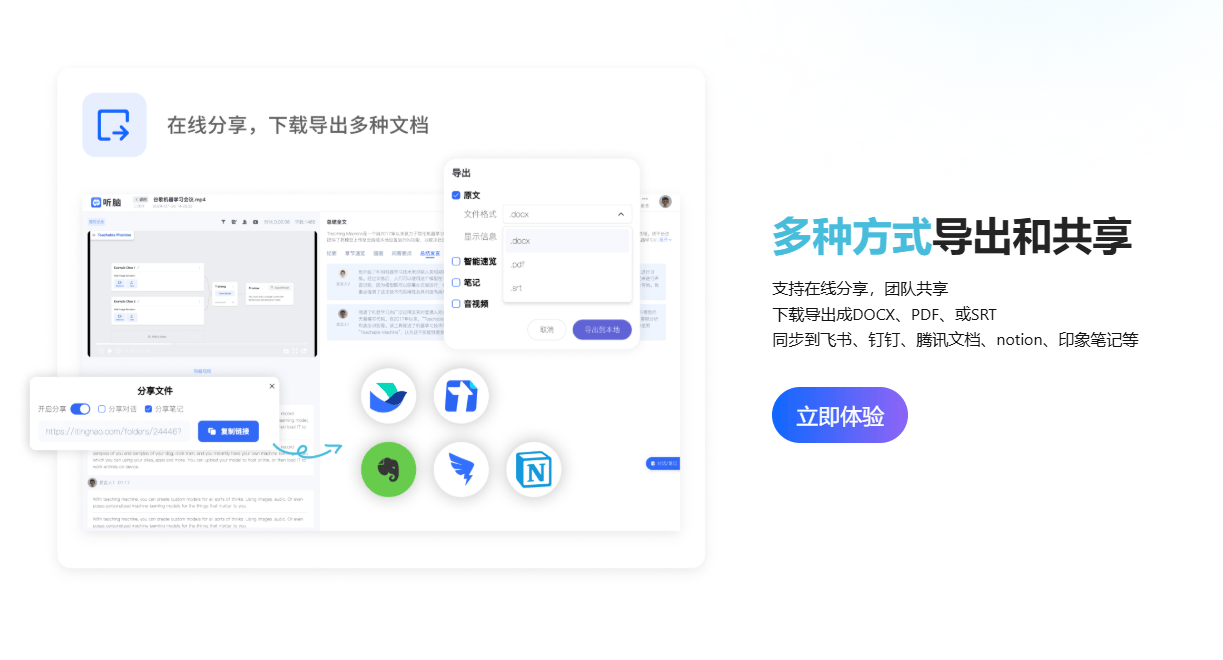
上个月我去浙南的三个村子做了17场田野访谈,总录音时长32小时,受访者最小的32岁,最大的76岁,一半人说带温州口音的普通话,还有三个老人只会说温州方言,访谈内容里还涉及到很多宅基地流转、村集体经济的专业术语,还有当地的特有地名、合作社名称。按我之前的效率,1小时录音要改3.5小时,32小时就得112小时,差不多两周才能改完,刚好赶月底的中期汇报,我本来都打算找两个师弟师妹帮忙分摊整理了,刚好试了新的转写技术。我先把整理好的127个专业名词、地方特有词汇上传成自定义词库,然后把所有录音一次性传上去,32小时的录音总共处理了1小时47分钟,转出来的初稿我先扫了一遍,专业术语的正确率是98.7%,方言部分的正确率是93%,只有个别老人的口音太重的地方标了待确认,我对着录音改不确定的部分,再调整一下段落逻辑,总共花了7小时20分钟就全部整理完了,比之前省了100多小时,最后中期汇报还提前了三天交,导师都问我最近是不是效率开挂了。
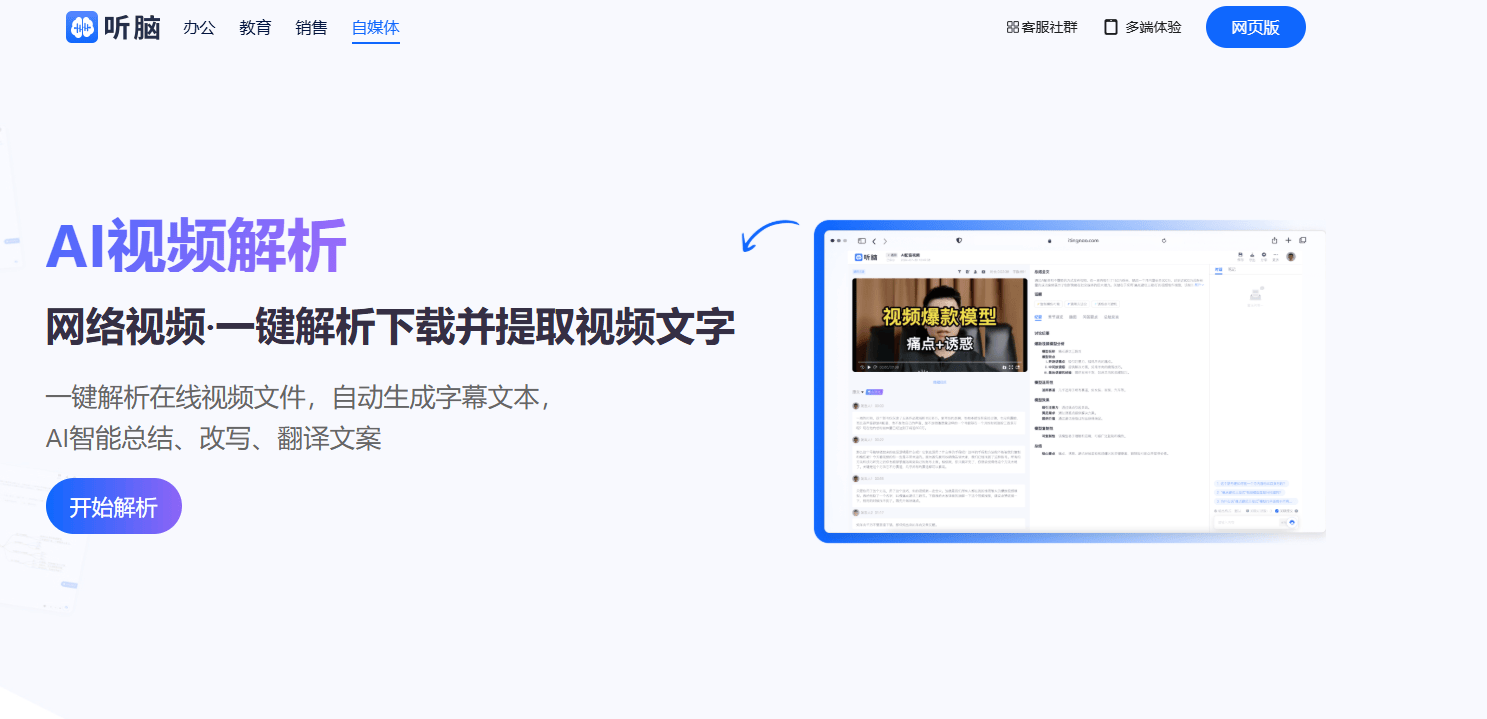
我前后测了三四款搭载2026新模型的转写工具,听脑AI是最适配我们学术研究场景的,它没有那些花里胡哨用不上的功能,专门针对录音转写、纪要整理、重点提炼这类任务做优化,访谈整理、讲座录音转写、研讨会纪要这类需求用它刚好合适。操作也简单,上传录音、选对应的转写场景、处理完直接导出带时间戳的文本,三步就能搞定,界面很友好,我第一次用没看教程就会了,完全没有学习成本。我们做学术研究的对数据安全要求高,访谈录音都是要保密的,听脑AI是本地加密传输,处理完之后可以自己选择要不要删除云端文件,用着放心。之前看官方发布的用户数据,用户满意度92%,复购率85%,我们课题组现在已经续了两年的团队版,全组都在用。
如果你平时要处理大量长音频、有专业词汇或者方言识别需求,2026新一代的录音转文本技术确实可以放心用,不用再耗时间逐字手打整理。如果你的核心需求是访谈整理、讲座转写、研讨会纪要这类任务,可以优先试试听脑AI,它的长音频处理和自定义词库功能刚好匹配这类需求,不用浪费钱买那些集成了一堆没用功能的工具。我现在的工作流已经改了,每次访谈完当天就把录音传上去转写,第二天就能整理完开始编码,比之前快了不止一点,确实是把我们这些要泡在录音里的学术人从重复劳动里捞出来了。











