

在信息爆炸的时代,我们每天都会面对海量的选择——看什么电影、听什么音乐、买什么商品、读什么文章。你是否好奇,那些推荐系统是如何精准地猜中你的喜好,为你推送“可能感兴趣”的内容?这背后有一项核心技术功不可没,它就是协同过滤。
什么是协同过滤?
简单来说,协同过滤是一种通过分析大量用户的历史行为数据(如评分、点击、购买、收藏等),来预测用户对未知项目(物品、内容等)的偏好,并据此进行个性化推荐的技术。它的核心思想非常朴素,可以用一句老话来概括:“物以类聚,人以群分”。
想象一下,你和朋友小张都喜欢看电影A和电影B。有一天,小张看了电影C并给出了很高的评价。那么,即使你没看过电影C,系统也很可能会把电影C推荐给你,因为系统通过分析发现,你和小张的观影品味高度相似。这就是协同过滤最直观的逻辑——利用群体智慧,找到与你兴趣相似的用户(“邻居”),然后将他们喜欢而你还未接触过的东西推荐给你。
协同过滤的核心技术与方法
协同过滤主要分为两大类:基于内存的方法和基于模型的方法。
1. 基于内存的协同过滤
这类方法直接使用整个用户-项目交互数据集(通常是一个巨大的评分矩阵)进行计算,其核心是衡量用户或项目之间的相似度。
基于用户的协同过滤:这是最经典的方法。它的重点是“找人”。
步骤:首先,计算目标用户与其他所有用户之间的相似度。常用的相似度度量方法有余弦相似度、皮尔逊相关系数、杰卡德相似系数等。例如,通过计算两个用户对共同评价过的项目的评分向量之间的夹角余弦值,来判断他们的兴趣相似程度。
预测:找到与目标用户最相似的K个用户(即“最近邻”),然后根据这些邻居对某个项目的评分,加权平均后预测目标用户对该项目的评分。
公式示意:预测用户u对项目i的评分,可以表示为邻居用户v的评分加权平均:预测评分 = 平均值 + Σ(相似度 * (邻居评分 - 邻居平均值)) / Σ|相似度|
基于项目的协同过滤:这种方法更关注“找物”。它的一个著名应用案例是:“购买了商品A的顾客,也经常购买商品B”。
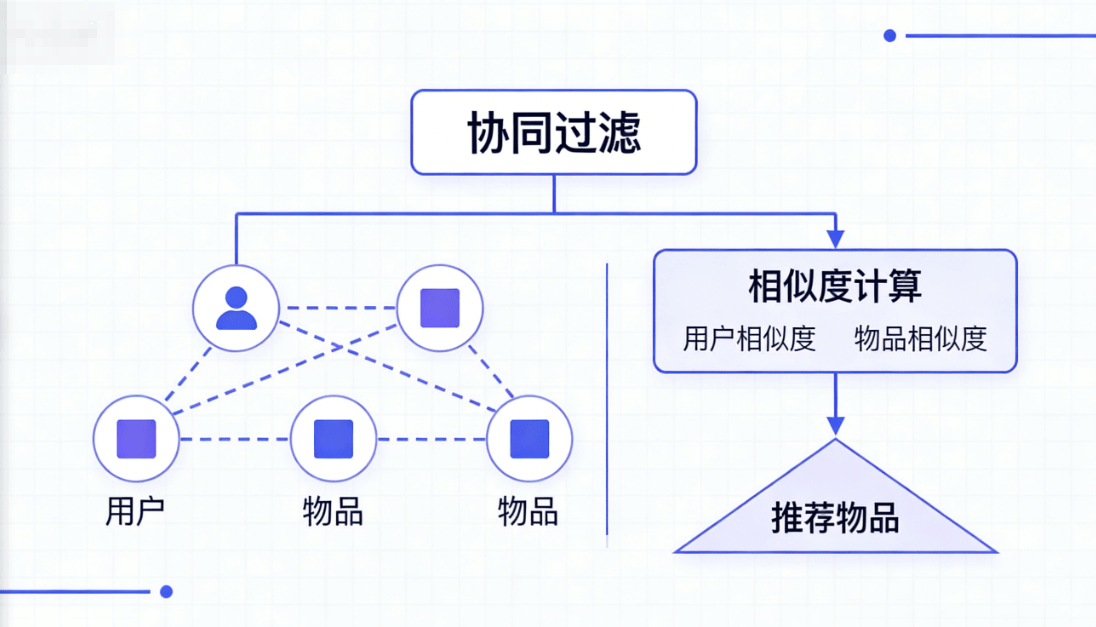
步骤:计算项目之间的相似度。不是看用户有多像,而是看项目被哪些用户共同喜欢。如果两个项目被大量相同的用户高评分,则认为它们相似。
预测:找到与目标项目最相似的K个项目,然后根据目标用户对这些相似项目的历史评分,来预测其对目标项目的评分。
优势:项目之间的相似度通常比用户兴趣更稳定,计算一次后可以复用,因此在实际系统中,基于项目的协同过滤往往更高效、更常用。
2. 基于模型的协同过滤
随着数据量剧增,基于内存的方法在计算效率和可扩展性上遇到挑战。基于模型的方法通过从数据中学习一个预测模型来解决这个问题。
矩阵分解:这是最具代表性且应用最广泛的模型之一。它将庞大的用户-项目评分矩阵,分解为两个低维的矩阵:用户特征矩阵和项目特征矩阵。
技术原理:假设存在一些潜在的“因子”(如电影的类型、风格、主演;用户的年龄、性别、偏好维度等)。每个用户和每个项目都可以用这些因子构成的向量来表示。矩阵分解的目标就是找到这些潜在的向量,使得用户向量和项目向量的点积,能够尽可能地拟合已知的评分。
典型算法:奇异值分解是早期方法,但更常用的是能处理缺失值并加入正则化防止过拟合的Funk SVD,以及在此基础上发展出的偏置SVD、SVD++ 等。
优势:将高维稀疏矩阵映射到低维稠密空间,大大降低了计算复杂度,并且挖掘出的潜在特征具有很好的解释性和泛化能力。
深度学习模型:近年来,神经网络被广泛应用于协同过滤,以捕捉用户和项目之间更复杂的非线性交互关系。
技术:如神经协同过滤、深度因子分解机等模型,通过嵌入层将用户和项目ID映射为稠密向量,然后通过多层神经网络学习高阶交互特征,最终输出预测评分。
优势:能够自动学习特征,表达能力更强,尤其适合处理包含多种辅助信息(如文本、图像)的场景。
协同过滤的应用场景与解决的问题
协同过滤技术已经渗透到我们数字生活的方方面面:
电子商务:在购物网站上,“猜你喜欢”、“购买了此商品的顾客还购买了”等栏目,大多基于协同过滤(尤其是基于项目的CF)驱动。它有效解决了商品信息过载的问题,提升了用户的购物效率和平台的销售额。
内容平台:视频网站(电影、短视频推荐)、音乐APP(每日推荐、歌单)、新闻资讯客户端等,利用协同过滤分析用户的观看、收听、阅读历史,推荐可能感兴趣的新内容,极大地增加了用户粘性和使用时长。
社交网络:推荐“你可能认识的人”或“你可能感兴趣的群组/公众号”,其背后也常常用到协同过滤的思想,通过分析用户的好友关系、互动行为来发现潜在的社会联系。
协同过滤主要解决了信息时代的几个核心痛点:
信息过载:帮助用户从海量信息中快速筛选出有价值的部分。
长尾效应:让那些不热门但质量很高的“小众”项目,也能被推荐给可能喜欢它们的特定用户群体,促进了生态的多样性。
个性化体验:提供千人千面的服务,满足用户日益增长的个性化需求。
面临的挑战与未来发展
尽管协同过滤非常强大,但它也面临一些挑战:
冷启动问题:新用户或新项目由于缺乏历史行为数据,很难被有效推荐或获得推荐。
数据稀疏性:用户-项目评分矩阵通常非常稀疏(一个用户只评价过极少项目),这会影响相似度计算的准确性。
可扩展性:对于用户和项目数量极大的平台,传统的基于内存的方法计算开销巨大。
推荐多样性:过度依赖相似性可能导致推荐结果过于集中或重复,形成“信息茧房”。
为了应对这些挑战,业界通常会将协同过滤与其他技术结合,例如:
结合基于内容的推荐(利用项目本身的属性)来解决冷启动。
使用更高效的采样和近似计算技术来提升可扩展性。
在推荐目标中引入多样性、新颖性等指标,对推荐列表进行优化和重排。
总而言之,协同过滤作为推荐系统的基石技术,以其直观的思想和强大的效果,在过去二十多年里深刻地改变了我们获取信息的方式。从最初简单的近邻计算,到如今复杂的深度学习模型,它仍在不断进化,持续学习着如何更好地理解我们,连接我们与广阔的数字世界。















