


摘要
过去三个月,光是媒体曝光的AI工具数据泄露事件就有七八起。某知名AI办公助手被曝出内部员工能看到用户上传的合同和财务报表,评论区瞬间炸锅:“我用它分析竞品数据,结果它拿我的数据训练?”“公司HR刚用它筛简历,第二天竞品就打来电话挖人……”
更值得警惕的是,大多数SaaS类AI产品都在用户协议中明确写道:“我们会收集您的输入内容用于模型改进”。翻译成白话:你喂给它的每一份竞品分析、客户名单、未公开路演PPT,都可能变成别人的养料。而作为AI重度用户,每天在ChatGPT、Notion、Midjourney、Gamma之间来回切换,表面上效率倍增,实则无异于“数据裸奔”。
一场因复制粘贴引发的险情:碎片化工具的代价
上周三,老板临时要求一份下季度竞品深度分析,附带数据图表和演讲PPT,次日早上9点前交付。按照惯常工作流:打开ChatGPT整理思路,从Notion调取历史笔记,从公司Wiki导出若干PDF,再切换到另一个工具生成数据图表……结果中途一次复制粘贴失误,将A项目的预算表误粘到B项目的分析文档中,险些酿成重大差错。
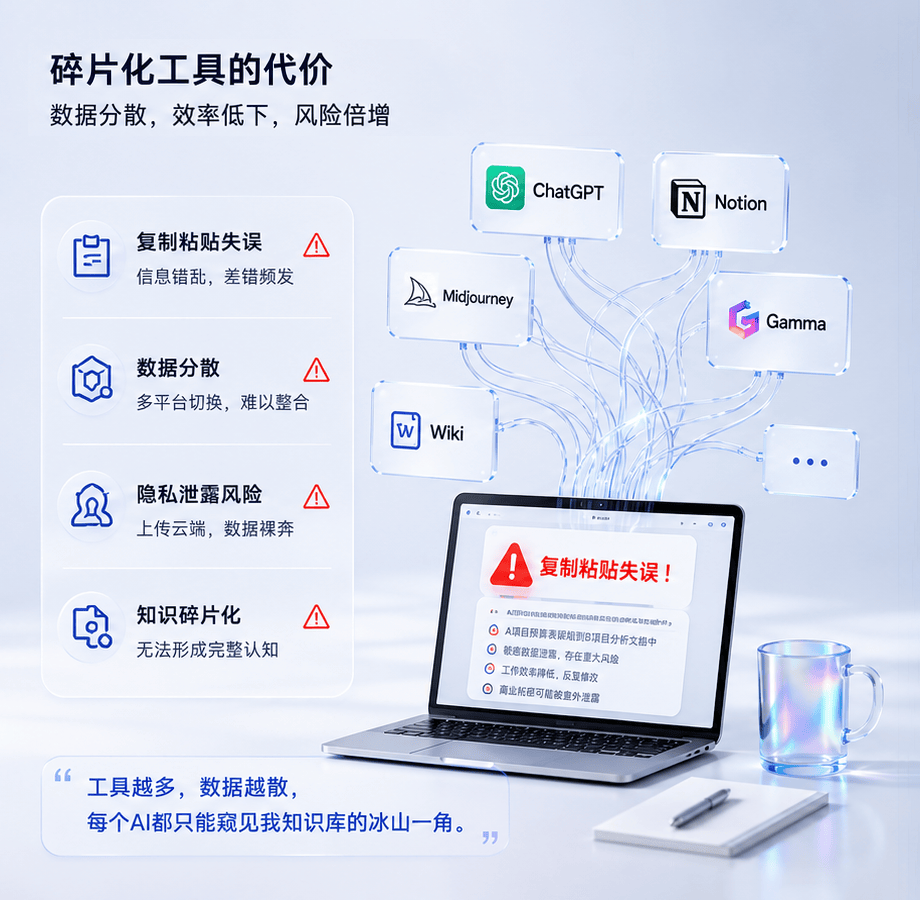
当晚11点,复盘时突然意识到一个根本性问题:工具越多,数据越散,每个AI都只能窥见我知识库的冰山一角——然而就连那一角,也包含了大量商业机密。所谓“提高效率”,实则是在用更快的速度制造混乱与风险。
真相揭示:云端AI的隐私政策隐藏着“数据投喂”陷阱
一位架构师朋友听完吐槽,说了一句令人后背发凉的话:“你听说过‘AI数据投毒’吗?你那些零散的工具,每一个都在用你的数据训练它们的模型。如果公司正处于融资或并购关键期,你每问一次‘帮我分析这份客户报价单’,就等于把底牌亮给了竞争对手。”
查阅某大模型平台的隐私政策,白纸黑字写明“我们会使用用户输入来改进服务质量”。这意味着,辛苦积累的资料资产,转手就成了他人的训练燃料。当晚,我删除了所有云端AI工具的使用记录,开始寻找本地化替代方案。
解决方案:本地优先的AI知识工作台——Knota
最初也怀疑本地运行的AI能否匹敌云端的智能。但试用 Knota 一周后,发现“云端至上”的思维定式需要被打破。
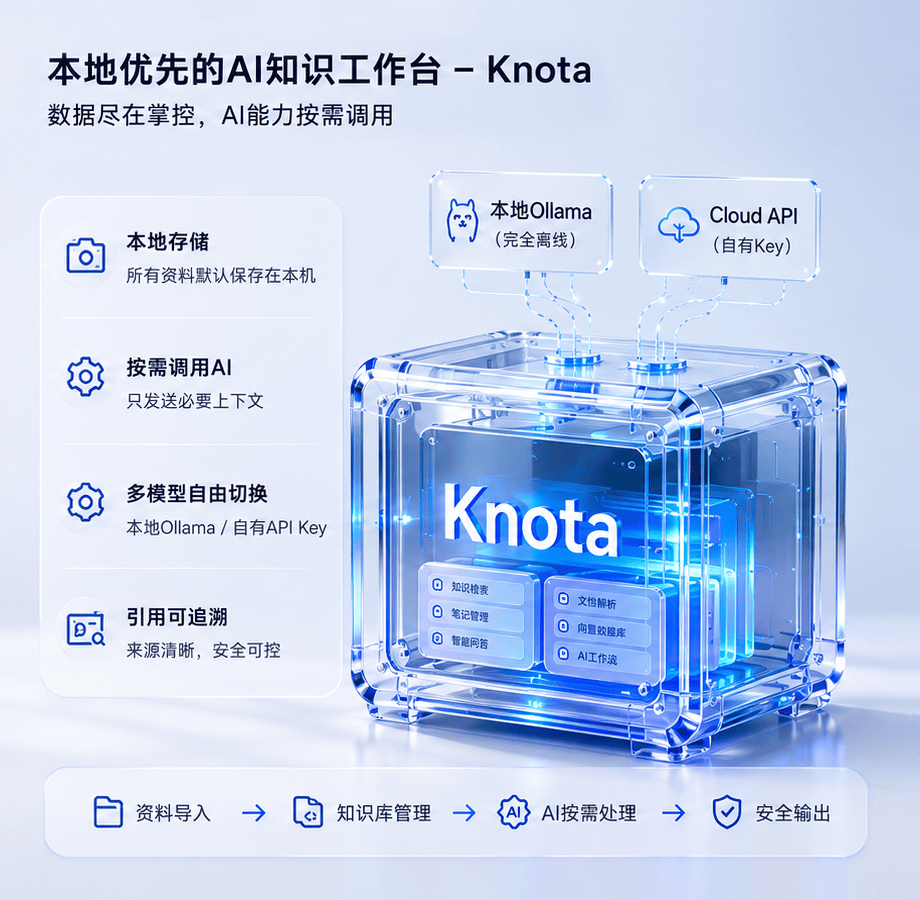
Knota采用本地优先架构:所有笔记、导入资料、全文索引、向量库默认保存在用户本机,不会主动上传任何内容。当需要调用AI能力时,可以选择本地Ollama(完全离线),或使用自己的API Key调用云端模型——此时仅将当前任务所需的一小段上下文发送出去,而非整个知识库。
具体而言,撰写竞品分析时,只需在Knota的知识库中勾选事先保存的几篇零散笔记、两个竞品官网抓取的页面以及上周的会议纪要。AI只能看到被勾选的这部分内容,生成报告时所有引用来源清晰可查,完全不用担心它越界读取HR薪酬表或客户隐私数据。
场景实证:从零散资料到完整交付物的高效转化
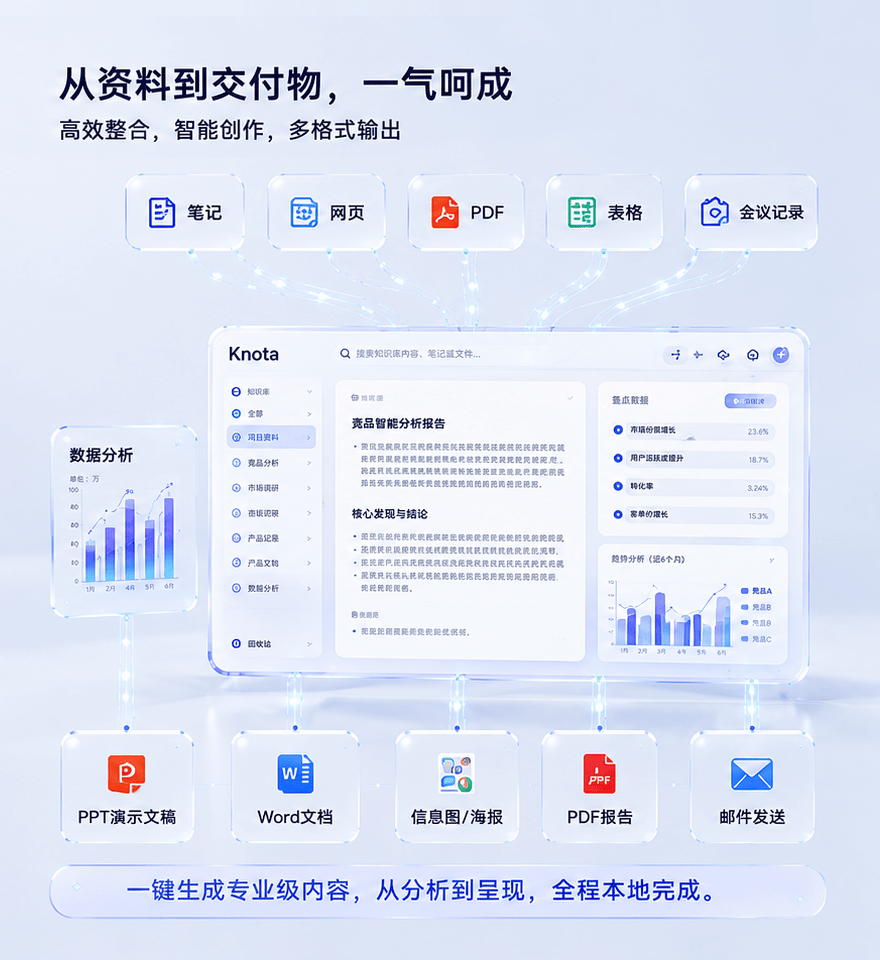
更令人惊喜的是,Knota支持在本地直接将所选资料一键生成完整PPT——不是敷衍的大纲,而是包含数据图表、排版合理的正式演示稿。此前险些逼疯自己的竞品分析任务,在Knota上从勾选素材到导出PPT,全程不到40分钟。
输出格式远不止PPT。导入一份杂乱的市场数据CSV,用自然语言提问“最近三个月各渠道的ROI趋势”,系统自动生成SQL并展示结果图表。将图表与结论拖入创作模块,选择“商业洞察报告”模板——无论是Word文档、PDF文件,还是一张信息图海报,均可一键生成。
超出预期:提示词工坊与个性化知识资产沉淀
Knota的“提示词工坊”同样超出预期。以往精心调试的提示词散落在ChatGPT聊天记录或备忘录中,换个场景便难以复用。现在所有提示词按场景分类(代码审计、产品需求、营销文案等)集中管理,每次新任务直接调用。系统还能根据历史偏好自动调整回答风格,越用越贴合个人习惯。
重构后的安全工作流:数据永不离开硬盘
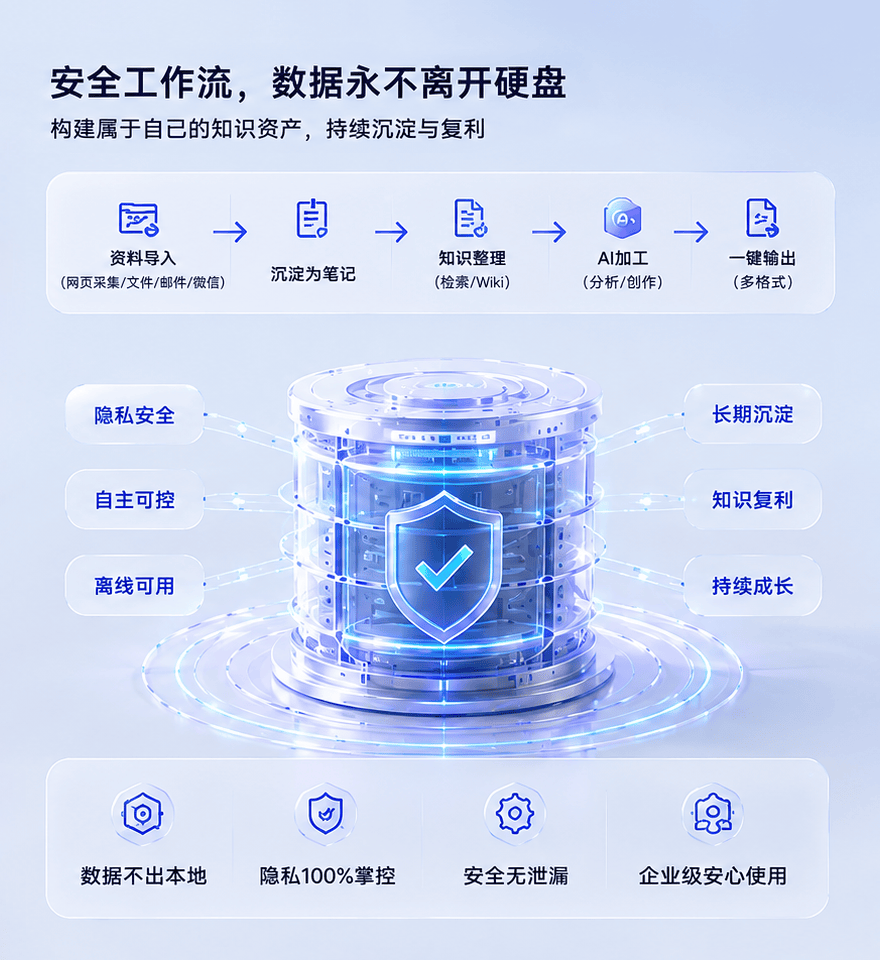
当前工作流重构如下:资料进入(网页采集、PDF、邮件、微信文件)→ 沉淀为笔记 → 利用知识检索与Wiki整理成专题 → 数据分析或提示词工坊加工 → 一键创作交付(PPT/Word/海报/邮件)。全流程中,数据从未离开本地硬盘。不想让AI看到的信息,它绝对看不到。
当然,Knota并非万能。若完全不懂技术,配置本地Ollama可能需要半小时的学习成本;若坚持使用云端最强模型(如GPT-4),API调用也会产生费用。但相比将企业命脉交给一个可能存在“偷看”风险的黑箱,这点代价完全值得接受。
结语
AI时代的数据安全不容小觑,选择本地优先的知识工作台只是第一步。











