

你知道吗?就在最近,知乎悄悄把它的“直答”功能接入了号称“满血版”的DeepSeek-R1模型。这听起来是不是很酷?一个汇聚了无数专业知识和人类智慧的社区,加上一个前沿的、能力强大的AI大脑,强强联合,理应诞生出让人惊艳的体验。但当我真正上手去用,试图和它进行一场深度对话时,发生的事却让我有点哭笑不得——我的iPhone,在等待答案的过程中,自动锁屏了好几次。
是的,你没看错。我问了一个问题,然后,就没有然后了。屏幕暗下去,我点亮,它还在“思考”;再暗下去,再点亮……如此循环往复。那种感觉,就像你急切地想和一个博学的朋友探讨问题,他却陷入了漫长的沉思,久到让你开始怀疑他是不是睡着了。
这引出了一个核心问题:对于一个大语言模型,尤其是接入到知乎这样强调实时互动和知识深挖的平台,什么才是最重要的?是模型的参数规模吗?是它背后算法的先进程度吗?还是它那吸引眼球的“免费”标签?
说实话,我觉得都不是。眼下,无论是知乎,还是DeepSeek官方,面临的最大挑战,可能根本不在模型本身的表现上,甚至也不是收费策略——毕竟,现在市面上有点名气的AI,谁还没个免费额度呢?真正卡住脖子的,是那个最基础、最硬核、却又最容易被普通用户忽略的东西:底层算力资源的部署和分配。
就拿这次接入的“满血版”deepseek-r1:671b来说,从技术角度讲,它无疑是个庞然大物,能力上限极高。理论上,只要你有足够大的内存,就能把它“请”到本地。但理论归理论,现实是骨感的。当支撑它运行的算力资源跟不上时,再强大的模型也像是一台被堵住了排气管的超跑,空有马力,却跑不起来。一个问题,需要几分钟才能得到反馈,这种延迟,对于需要连贯思维的对话场景而言,是致命的。
想象一下,你正在研究一个复杂的编程问题,或者策划一个项目方案,需要多轮追问、层层递进才能理清思路。每问一句,都要等上好几分钟,你的思路早就被打断得七零八落了。那种感觉,不是在与AI协作,而是在进行一场跨星际的延时通信,体验感瞬间跌入谷底。
这恰恰凸显了知乎自身一个独特的优势:它拥有海量、实时、高质量的创作者内容作为知识库。这是其他通用大模型难以比拟的资产。其他AI或许能爬取到几个月前的知乎内容,但在如今各平台信息日益封闭的“孤岛时代”,知乎平台内新鲜出炉的优质回答和讨论,就是最核心的竞争力。AI如果能充分、实时地调用这些内容,给出的答案会更有针对性,更“知乎味”。
但问题又来了:如果算力跟不上,导致响应速度奇慢,那么平台的内容优势还能有效发挥吗?一个需要等待几分钟才出现的、哪怕再专业的答案,其实际价值已经大打折扣。更令人深思的是,一旦脱离了对平台即时内容的深度依赖,回归到一些通用知识或逻辑推理问题上,你会发现,哪怕是参数小得多的模型,在响应速度上也能带来碾压式的体验。
我自己就做过对比。在我的Mac mini(M2芯片,16GB统一内存)上,本地部署一个deepseek-r1:14b的模型。运行起来之后,它处理一个需要“深度思考”的问题,从开始计算到开始输出文字,大概也就5到10秒钟。这个等待时间是可以接受的,甚至不会明显打断我的思路。而如果换成参数规模更小的模型,比如llama3.2的3b版本,那速度更是快得离谱,几乎可以实现无延迟的连续对话,流畅得像是在和一个反应敏捷的人聊天。
这个对比非常残酷,但也非常现实。它说明了一个简单的道理:对于线上服务而言,如果无法保证充足的算力分配,导致响应速度达到“不可用”的级别,那么与其硬撑着部署一个庞大但缓慢的模型,不如务实一点,提供一个参数规模稍小、但能快速响应的版本。 这不仅是控制自身服务器成本的理性选择,更是对用户体验最基本的尊重。否则,就像我手头这台16GB内存的Mac mini,理论上也能“跑起来”deepseek-r1:32b模型,但那种几分钟才蹦出一个词的速度,一天下来也回答不了几个问题,除了满足一下“我能运行”的虚荣心,实际意义何在?
说到这里,可能很多朋友会对“本地部署大模型”产生兴趣。毕竟,如果线上服务因为算力问题体验不佳,那自己在家折腾一个,似乎是个不错的备选方案?尤其是看到我用Mac mini都能跑起来,是不是觉得门槛也没那么高?
好吧,既然话题引到这里,我就简单聊聊如何在个人电脑上尝试本地部署大语言模型。必须声明,我本人并非本地模型的狂热支持者,但对于想要亲手尝试、了解其能力和局限的朋友,这确实是一个有趣的途径。
首先,要打破一个迷思:部署本地大模型,首要瓶颈往往不是CPU或GPU的绝对性能,而是内存(尤其是能用作显存的内存)大小。你的模型参数需要加载到内存中才能运行,模型越大,所需内存就越多。
在这方面,苹果的Apple Silicon芯片Mac(M1、M2、M3、M4系列)有一个先天优势:统一内存架构。简单说,就是内存和显存共用同一块物理内存,可以动态分配。对于一台16GB内存的Mac,大概有10-11GB可以被显卡核心直接用作“显存”。这可比许多独立显卡的显存还要宽裕,使得在Mac上运行中型模型成为可能。
以我的Mac mini M2 16GB为例,运行deepseek-r1:14b非常轻松。模型基本上全程由GPU来运算,内存压力很小。提问后,它“思考”(计算)5-10秒,就开始流畅地输出文字了,整体体验相当不错。
我也尝试过挑战极限,加载deepseek-r1:32b模型。这个模型需要大约20GB的内存空间。借助系统内存交换(SWAP)技术,它居然真的“跑起来”了。但代价是速度变得极其缓慢,几分钟才能出一个词,因为这时数据需要在内存和硬盘之间来回倒腾,GPU大部分时间都在等待,实际是CPU在辛苦工作,完全失去了实用性。至于更大的deepseek-r1:70b(需约27GB内存),刚加载到一半,工具软件就直接崩溃了,这就是当前硬件的物理上限。
那么,具体怎么部署呢?现在这个过程已经变得异常简单,主要归功于一个叫 Ollama 的工具。
- 安装框架:访问Ollama的官网,下载对应你操作系统(macOS、Windows、Linux)的安装包。安装过程很简单,它没有华丽的图形界面,因为它本质上是一个命令行工具。
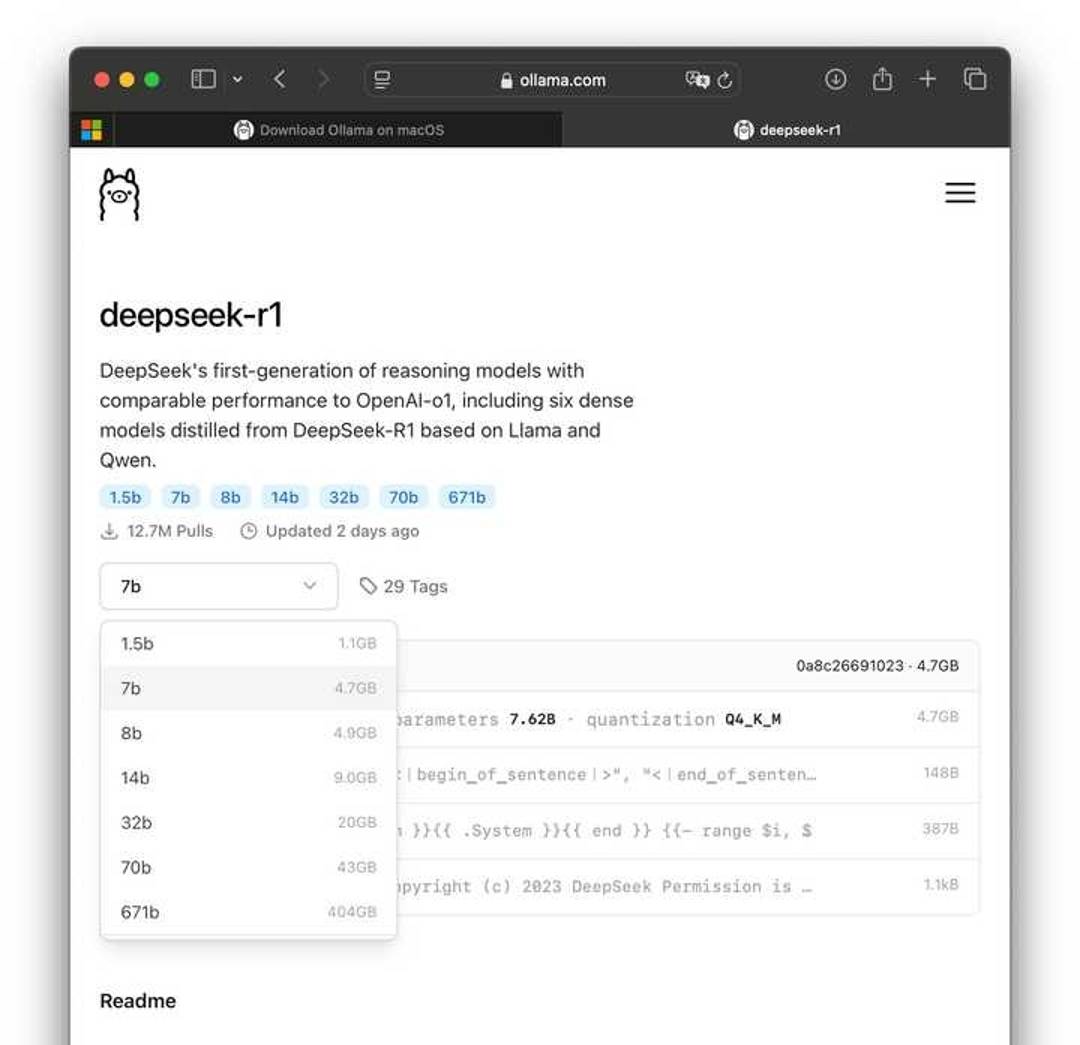
- 选择模型:Ollama支持众多开源模型,不只是DeepSeek-R1系列。你需要根据自己电脑的内存情况,谨慎选择参数规模。对于大多数普通电脑(16GB或32GB内存),建议从14B参数以下的模型开始尝试。DeepSeek-R1系列提供了从1.5B到671B共7个不同规模的版本,其中标注了“Distill”(蒸馏)的版本通常是在保持一定性能的同时,对资源要求更友好的选择。
- 下载与运行:打开你电脑上的“终端”应用。运行命令格式很简单:ollama run 模型名。
- 例如,想运行deepseek-r1:14b,就输入:ollama run deepseek-r1:14b
- 首次运行会自动从网上下载模型文件。下载速度有时会波动,如果后半段变慢,可以尝试暂停再继续。
- 以后每次使用,输入同样的命令即可进入对话界面。
- 想删除模型释放空间,用:ollama rm 模型名
这里是一些常用模型的运行命令参考:
- DeepSeek-R1-Distill-Qwen-1.5B: ollama run deepseek-r1:1.5b
- DeepSeek-R1-Distill-Qwen-7B: ollama run deepseek-r1:7b
- DeepSeek-R1-Distill-Llama-8B: ollama run deepseek-r1:8b
- DeepSeek-R1-Distill-Qwen-14B: ollama run deepseek-r1:14b
- DeepSeek-R1-Distill-Qwen-32B: ollama run deepseek-r1:32b
- DeepSeek-R1-Distill-Llama-70B: ollama run deepseek-r1:70b
- DeepSeek-R1 (671B): ollama run deepseek-r1:671b
建议你先在终端里用命令行方式体验一下,很可能玩个新鲜就放下了。如果你觉得本地模型确实有用,可以再进阶去配置一些图形界面客户端,比如Open WebUI、ChatX等,这样就不用总是面对黑乎乎的命令行窗口了。
最后,让我们回到最根本的选择题上。关于使用大语言模型,我的核心建议仍然是:优先考虑可靠的在线服务,如果条件允许,付费订阅高质量的模型往往是效率最高的选择。
这背后的逻辑非常直接:当你有一个重要、紧急的问题需要解决时,面前有三位“专家”可供咨询。
- 专家A:知识库最新最全,能力经过广泛验证,随时随地可以访问,响应迅速,并且诚实,不懂的会承认。
- 专家B和C:知识可能是一两年前的,你需要自己准备场地(硬件)、花费时间安装调试(部署),并且他们时不时还可能 confidently 地给出一些错误答案(幻觉问题)。
你会选择问谁?答案不言自明。
技术的魅力在于探索可能性,本地部署让我们得以窥见AI运行的奥秘,并拥有完全的控制权和隐私性。但技术的价值在于解决实际问题,提升效率。当线上服务能够提供稳定、快速、准确的响应时,它所带来的便利性和可靠性,是当前阶段个人本地部署难以比拟的。
所以,对于知乎接入DeepSeek-R1这件事,我抱以期待,但也持保留态度。模型很强,内容源很好,但算力,算力,还是算力。如果无法解决这个最基础的体验问题,再华丽的组合拳,打在用户身上也像是慢动作回放。与其追求参数的“满血”,不如先保证交互的“流畅”。毕竟,在这个时代,我们的注意力,真的等不起那几分钟的空白。














