

当手写体、印章、多语混排、弯曲文档成为传统 OCR 的 “拦路虎”,国产 AI 厂商早已吹响技术突围的号角。2026 年,智谱 AI、百度、小红书、深度求索等企业推出的 OCR 大模型组成第一梯队,以轻量化架构、场景化创新打破行业天花板,在权威评测 OmniDocBench 上交出了亮眼成绩单,让文档处理真正实现 “从识别到理解” 的跨越。
权威榜单揭晓:轻量化与高精度双向领跑
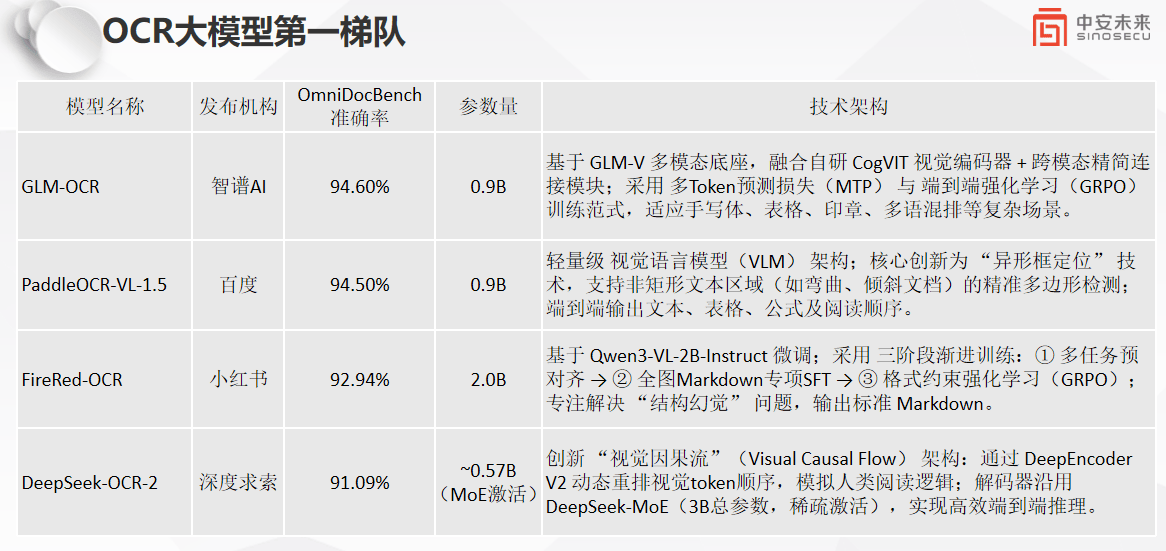
在业内公认的 OmniDocBench 评测中,四款国产模型的表现堪称惊艳:智谱 AI 的 GLM-OCR 以 94.60% 的准确率位居榜首,百度 PaddleOCR-VL-1.5 以 94.50% 紧随其后,小红书 FireRed-OCR、深度求索 DeepSeek-OCR-2 也分别以 92.94%、91.09% 的成绩跻身前列。
值得关注的是,这些模型普遍实现了 “小参数大能量”。GLM-OCR 和 PaddleOCR-VL-1.5 仅用 0.9B 参数量就达到行业顶尖精度,DeepSeek-OCR-2 更是以约 0.57B 的 MoE 激活参数实现高效推理,彻底打破了 “大参数才高精度” 的固有认知。这种轻量化优势,让中小企业和个人用户无需高昂算力成本,就能用上专业级 OCR 服务,真正实现技术普惠。
四大模型硬核 PK:差异化技术直击行业痛点
第一梯队的每款模型都带着独门 “黑科技”,精准破解传统 OCR 的痛点难题:
- 智谱 GLM-OCR:基于 GLM-V 多模态底座,融合自研 CogVIT 视觉编码器,搭配多 Token 预测损失与端到端强化学习训练范式,对人手写体、复杂表格、证件印章、多语言混排等场景的识别率大幅提升,是政务、金融、教育等行业处理特殊文档的优选方案。
- 百度 PaddleOCR-VL-1.5:以轻量级视觉语言模型架构为核心,独创 “异形框定位” 技术,打破传统矩形文本检测限制,能精准识别弯曲、倾斜文档中的文本区域,还能端到端输出文本、表格、公式及阅读顺序,堪称办公场景的 “全能助手”。
- 小红书 FireRed-OCR:聚焦行业普遍存在的 “结构幻觉” 难题,通过三阶段渐进训练优化 Markdown 格式输出,在电商图文、笔记排版、自媒体内容整理等场景中优势显著,一键就能把杂乱图文转化为规范结构化内容,完美适配内容创作者的需求。
- 深度求索 DeepSeek-OCR-2:创新提出 “视觉因果流” 架构,通过动态重排视觉 token 模拟人类阅读逻辑,搭配 MoE 稀疏激活解码器,在轻量化的同时实现高效端到端推理,低延迟特性让它在移动端实时扫描、批量文档处理等场景中表现突出。
场景落地开花:从 “字符识别” 到 “文档理解” 的质变
这些国产 OCR 大模型的突破,早已不局限于 “图片转文字” 的基础功能,而是推动行业从 “感知” 向 “认知” 跃迁。政务窗口用 GLM-OCR 快速识别证件、手写材料,大幅缩短业务办理时间;教育机构用 PaddleOCR-VL-1.5 解析试卷公式、图表,自动生成错题整理;自媒体创作者用 FireRed-OCR 批量整理图文素材,快速生成 Markdown 笔记;企业用 DeepSeek-OCR-2 实现合同、票据的自动化批量处理,大幅降低人工成本。
更重要的是,这些模型都支持私有化部署、多平台适配,无论是大型企业的复杂业务系统,还是中小企业的轻量化办公工具,都能找到适配方案,真正实现了技术落地的灵活性与实用性。
国产 AI 崛起:从 “追赶者” 到 “标准定义者”
过去,海外 OCR 技术长期占据主导地位,但如今,国产模型在精度、效率、场景适配性上已实现全面超越。第一梯队的技术创新,不仅解决了传统 OCR 的诸多痛点,更推动了整个文档智能行业的技术迭代。
未来,随着多模态技术的持续融合,OCR 大模型还将向更智能、更场景化的方向演进,成为千行百业数字化转型的核心支撑。这场国产 OCR 的 “突围战”,不仅是技术实力的较量,更是中国科技企业从 “跟跑” 到 “领跑” 的缩影,也让我们看到了国产 AI 技术的无限可能。












