

这几天,AI 圈又地震了。
从 DeepSeek 的爆火到各大厂商开启“价格战”,普通人还在感叹模型越来越强,但真正的职场精英已经开始意识到一个扎心的事实:
无论模型多强,只要它不知道你的私有资料,它就永远只是个“外行”。
你是不是也遇到过这种情况:
- 让 AI 写方案,结果它满口胡编,数据全是“幻觉”;
- 把商业机密喂给云端模型,半夜惊醒担心数据泄露;
- 存了一堆论文、会议纪要,真想用的时候,AI 却告诉你“上下文太长,我不记得了”。
大模型的下半场,拼的不是谁的参数多,而是谁能解决“最后一公里”的知识落地。
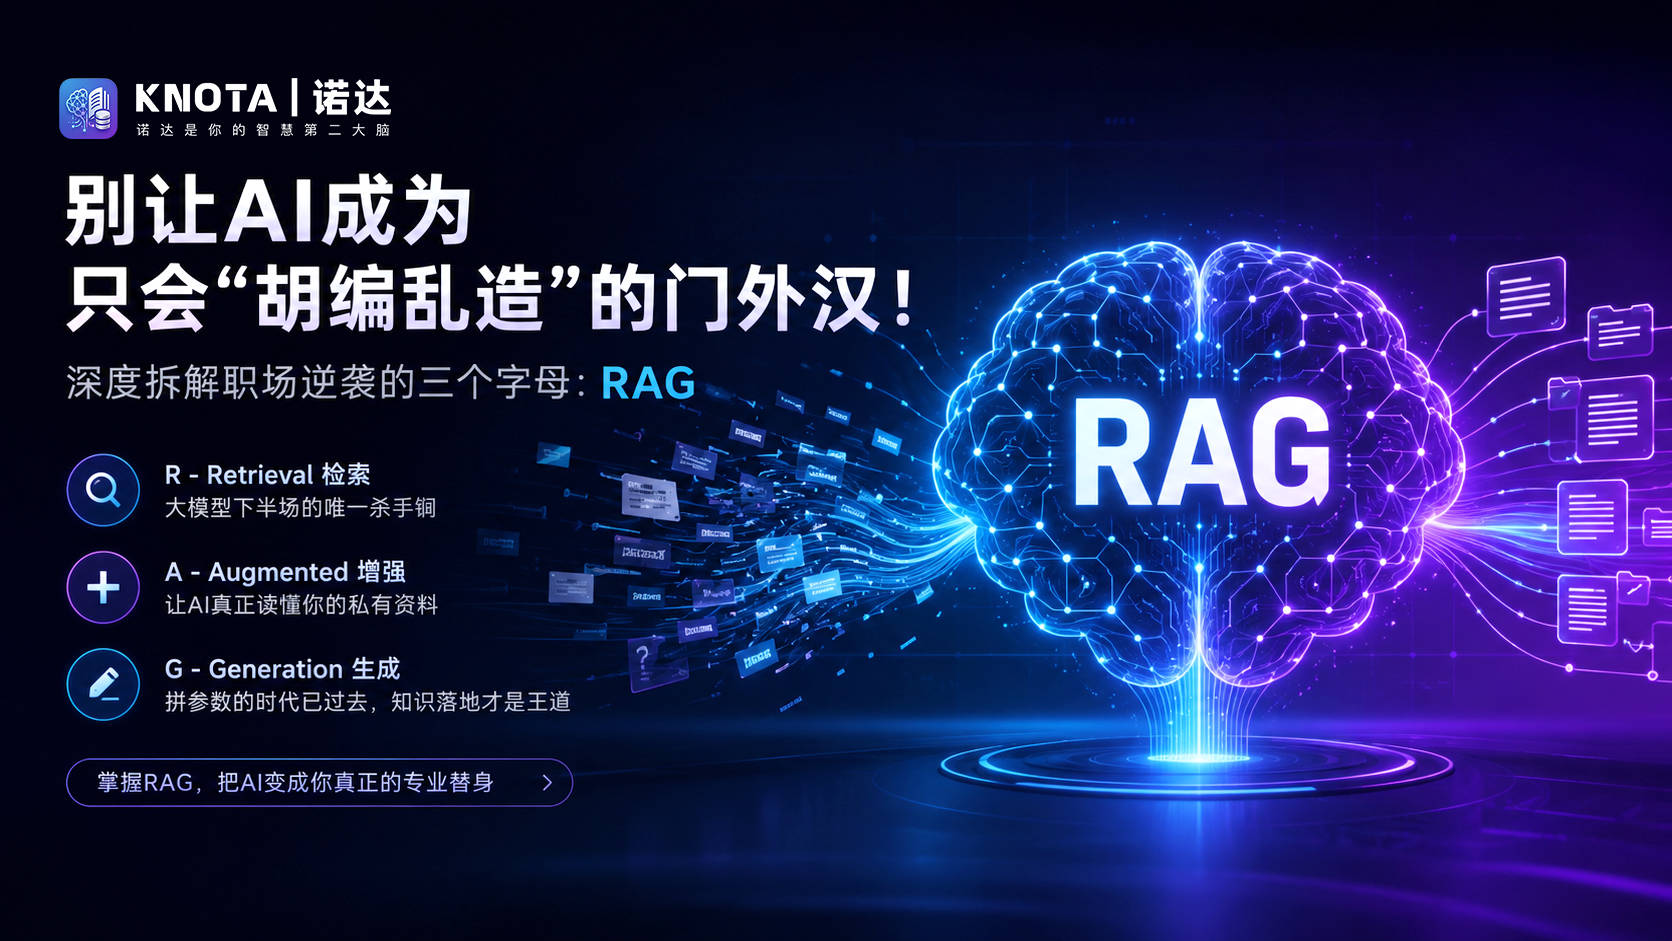
这里有一个技术关键词你必须懂——RAG(Retrieval-Augmented Generation,检索增强生成)。
一、 为什么 RAG 才是职场人的“外挂大脑”?简单来说,RAG 就是给 AI 配了一个实时更新的“图书馆”。
以前你问 AI 问题,它是靠记忆力(预训练数据)生背答案。现在有了 RAG,AI 会先去你的本地资料库里翻书,找到相关的证据,再整理成答案给你。
这解决了两个致命痛点:
- 拒绝胡说八道:AI 的回答必须展示引用来源,用户可以随时回到原文核对依据。
- 打破信息差:AI 不再只懂网上的公开知识,它能瞬间精通你昨晚写的项目计划书。

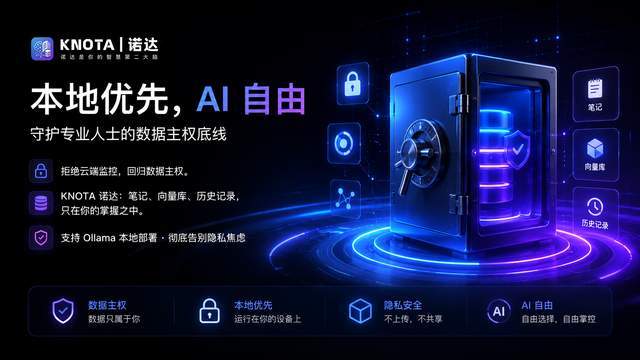
在追求 AI 效率的同时,数据主权正成为专业人士的底线。
近日,多家大厂严禁员工将敏感代码和财报上传到云端 AI 助手,这绝非小题大做。而在 RAG 的落地应用中,一种“本地优先”的流派正在悄然崛起。
正如我最近深度测评的KNOTA 诺达。它的逻辑非常硬核:笔记文件、向量库、历史记录默认保存在用户本机。它不是一个简单的对话框,而是一个完整的“知识工作台”。即使你断开网络(只要配置了本地模型如 Ollama),它依然能基于你的本地资料进行精准检索和问答。这种安全感,是任何云端产品都无法给到的。
很多人对 RAG 的理解还停留在“搜个文档”。但真正的专业工具已经进化到了GraphRAG(图谱检索增强生成)阶段。
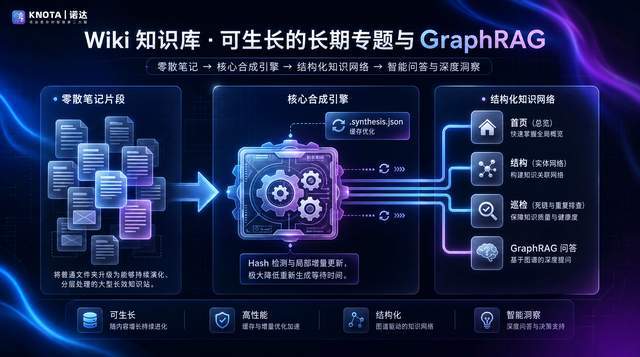
以 KNOTA 为例,它不仅仅是把资料堆在一起,而是通过双链、标签和 Wiki 专题,把零散的资料织成一张“知识网”。
- Wiki 专题化:它能自动把上百份杂乱的研报聚合为一个长期专题站点,支持分层 Map-Reduce 合成,确保大信息量下也不会遗漏重点。
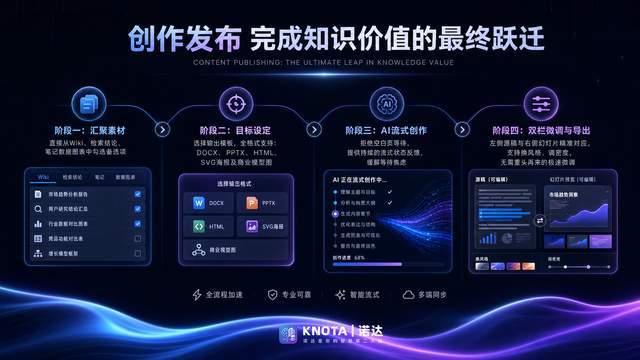
- 直接生成交付物:最让我惊喜的是,它把 RAG 搜到的结果直接连通了“创作发布”。你可以一键把检索到的证据转化为 Word 报告、PPT 甚至是海报。
这意味着,你不再是和 AI 聊天,你是在操作一条“自动化知识生产线”。
四、 亲测复盘:KNOTA 给我的三个震撼时刻作为一名长期与资料打交道的营销人,在使用 KNOTA 一段时间后,我有三个非常直观的感受:
- 极度的秩序感:它的 UI 遵循“左中右协同”和“渐进披露”原则。左侧看结构,中间改内容,右侧看 AI 建议或预览,这种稳定的视觉秩序让深度思考不再被打断。
- 提示词工坊的魔力:我以前的 Prompt 散落在各处,KNOTA 专门开辟了一个“提示词工坊”,支持网页预览和 JSON 校验。这让 Prompt 成了可复用的数字资产,而不仅仅是临时的指令。
- 数据分析的平民化:我把一堆复杂的 Excel 丢进去,直接用自然语言问“上季度哪个产品转化率最高?”,它能自动生成 SQL 并画出图表,然后我顺手就能把图表插入到演示稿里。
大模型的热潮终将退去,最后留下的是那些学会了如何管理自己知识资产的人。
KNOTA 诺达给出的答案很明确:把资料沉淀在本地,用 AI 赋能检索,最终转化为可交付的成果。这种从原始资料到正式报告的完整工作流,才是职场人真正的护城河。
很多朋友私信问怎么能像我一样高效整理几千份文档?我最近确实在深度使用这款KNOTA(诺达),它的本地优先 RAG 真的解决了我的数据焦虑。
大家目前在用 AI 处理文档时,遇到最大的坑是什么?是幻觉还是泄密?欢迎在评论区聊聊。










