

一个脚本写了一万行业务逻辑,模型消耗了多少 Token?
答案是:零。
不是四舍五入到零,是真的零。
因为这段代码从头到尾没被模型读过,它只是被运行了。
运行完了,模型只拿到一个结果。
我第一次听到这个机制的时候,以为自己听错了。
后来仔细想了一下,发现这个设计其实解决了一个很多人没意识到的问题:上下文窗口是有限的,但你要让模型干的事情是无限的。
你怎么在有限的窗口里,塞进无限多的能力?
Claude Code 给出了一个很优雅的答案。
这个答案叫做 Agent Skill。
但它真正让我觉得有意思的地方,不是 Skill 能干什么,而是它怎么做到几乎不浪费任何 Token 的。
它用了一套三层渐进式加载机制,每一层都是按需的,不相关的信息连一个 Token 都不会占。
我把这个机制从头到尾拆了一遍,分几个层面来讲。
你装了20个Skill,模型每次只多看了一份目录
01
先说最外面那一层。
很多人可能会担心:我给 Claude Code 装了一堆 Skill,什么会议总结助手、爆款文案生成器、数据分析工具,每个都有自己的说明文档。
这些东西是不是每次对话都要全部塞给模型?
那得浪费多少 Token?
答案是:不会。
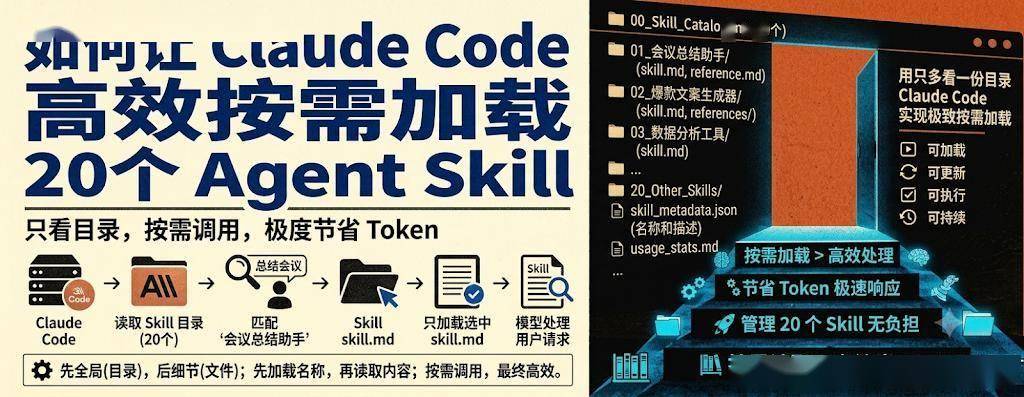
因为 Claude Code 在一开始,只把每个 Skill 的名称和描述给模型看。
就这两行。
一个名称,一段简短描述。类似于书籍目录里的书名加一句话简介。
模型扫一眼这个目录,发现用户的请求跟「会议总结助手」匹配,就告诉 Claude Code:用这个。
然后 Claude Code 才会去那个 Skill 的目录里,把完整的 skill.md 文件读出来。
注意,它只读被选中的那一个。
其他 19 个 Skill 的完整内容,碰都不碰。
这个机制叫做按需加载。
虽然所有 Skill 的名字始终可见,但具体的指令内容,只有被选中的那个才会被加载。
相当于你在饭店点菜,菜单上每道菜都有名字和一句话介绍,但后厨只有在你点了之后,才会把完整食谱拿出来。
提到钱才读财务手册-按需中的按需
02
按需加载已经很省 Token 了。
但它还不够极致。
举个例子。
假设你的会议总结助手越来越高级了。你希望它不仅是简单复述,还能在总结里自动检查财务合规。
比如会议决定要花钱的时候,它能直接标注这笔钱符不符合报销标准。
涉及到合同的时候,它能提示法务风险。
这很实用,但有个问题:为了让 Skill 做到这些,你得把公司的财务规定和法律条文都写进去。
这些文件可能非常长。
如果每次开个简单的技术复盘会,都要被迫加载一堆财务和法律条文,那就太浪费了。
Agent Skill 提供了一个概念叫 Reference,专门解决这个问题的。
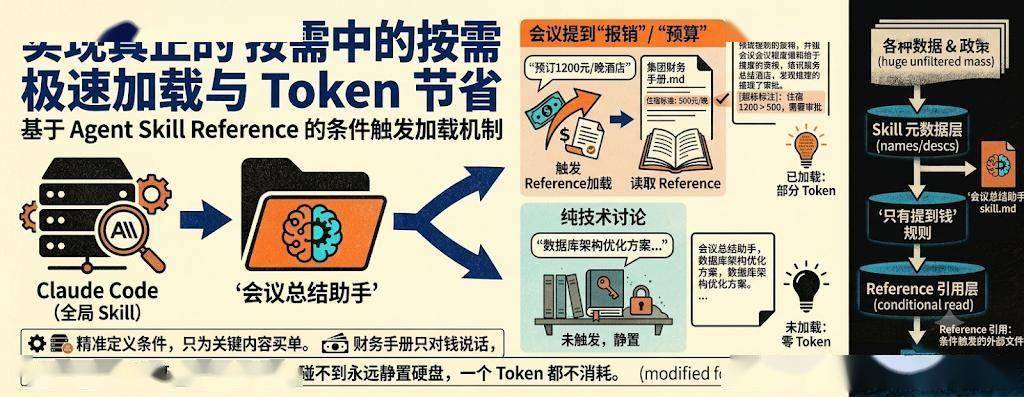
你可以在 Skill 里挂一个外部文件,比如「集团财务手册.md」,里面写清楚各种报销标准。
然后在 skill.md 里加一条规则:只有当会议内容提到钱、预算、采购、费用的时候,才去读这个文件。
实际效果是这样的——
如果会议里老陈让小李订 1200 一晚的酒店,模型判断这跟钱有关,就会自动去读财务手册,然后在总结里标注:住宿补贴标准 500 一晚,1200 超标了,需要某某审批。
但如果这是一场纯技术讨论会,跟钱没半点关系,那财务手册就静静地躺在硬盘里,一个 Token 都不会被消耗。
Reference 是条件触发的。不是每次都读,是碰到了才读。碰不到就永远躺着。
这就叫按需中的按需。
一万行代码零Token消耗,跑而不读的秘密
03
Reference 是按需读取的,读到模型上下文里,供模型参考。
但它还是要占 Token 的。
那有没有什么东西是连 Token 都不占的?
有。。
是 Agent Skill 里的另一个高级功能。
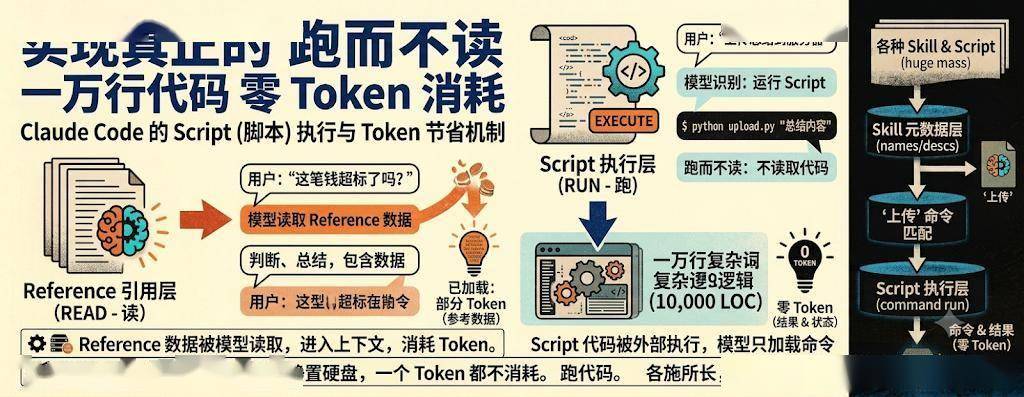
简单说就是:你可以在 Skill 里放一个脚本,比如 upload.py,用于上传文件。
当用户说「总结会议并上传到服务器」的时候,模型会生成总结内容,然后执行这个脚本把结果传上去。
这里有个关键区别。
Reference 是被读取的,模型要看到文件内容才能判断。
但 不是被读取的,它是被执行的。
Claude Code 不会去读 upload.py 的源代码。
它只关心两件事:这个脚本怎么运行,以及运行结果是什么。
所以哪怕你的脚本写了一万行复杂的业务逻辑,它消耗的模型上下文也几乎为零。
因为代码内容根本就没有被加载到上下文里。
模型只知道「运行 upload.py」,跑完了拿个结果,结束。
当然这不是铁律。
如果你在 Skill 里没有把代码的执行方法写清楚,Claude Code 可能不得不去看一下代码才能搞明白怎么跑。
这时候就会占用上下文了。
所以写 Skill 的时候,尽可能把一切都解释清楚,别让模型去猜。
Reference 读, 跑。
一个消耗 Token,一个几乎不消耗。
这个区分看似简单,但仔细想想,它其实是一个非常聪明的资源分配策略。
三层渐进式披露:目录、指令、资源
04
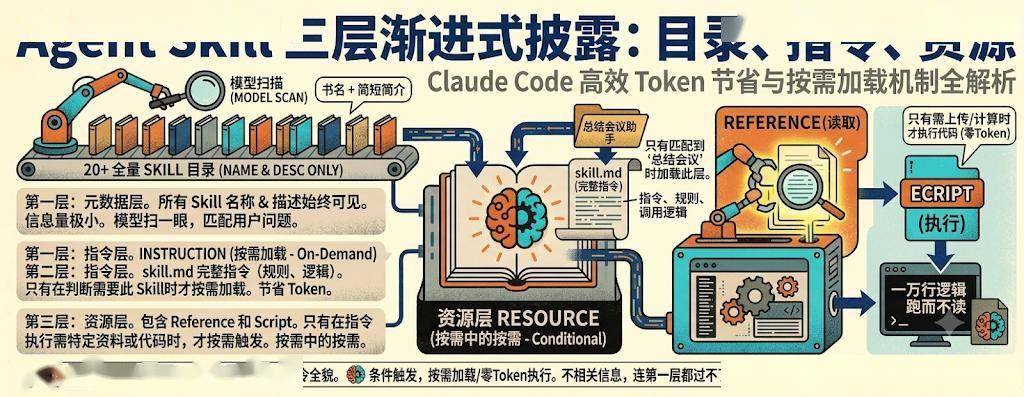
把上面的内容串起来,整个 Agent Skill 的设计其实就是三层结构。
第一层:元数据层。
所有 Skill 的名称和描述,始终加载。
相当于一本书的目录。
模型每次回答前都会扫一眼,看看用户的问题跟哪个 Skill 匹配。
这一层的信息量很小,因为只有名称和描述。
第二层:指令层。
对应 skill.md 文件里除了名称和描述之外的其余内容。
只有当模型判断需要用某个 Skill 的时候,才会加载这一层。
这叫按需加载。
第三层:资源层。
最深层。包含 Reference 和 。
只有在指令层执行过程中,模型发现需要查某个资料或跑某段代码时,才会去碰这一层。
这叫按需中的按需。
三层结构,每一层的加载门槛都比上一层更高一层。
不相关的信息,连第一层都过不了。过了第一层的不相关内容,过不了第二层。过了第二层还不需要的,永远不会被读到。
这样一层一层过滤下来,模型每次对话实际加载的信息量,被压缩到了最小。
这就是为什么你装了 20 个 Skill,模型也不会被撑爆。
因为大部分内容,它根本不需要看。
Skill 和 MCP 不是替代关系,是互补关系
05
聊到这里,很多人可能会有一个疑问。
Agent Skill 能读文件、能跑代码、能查资料,这不跟 MCP 差不多吗?
既然功能重叠,那我到底用哪个?
Anthropic 官方有一句话把这个问题讲透了。
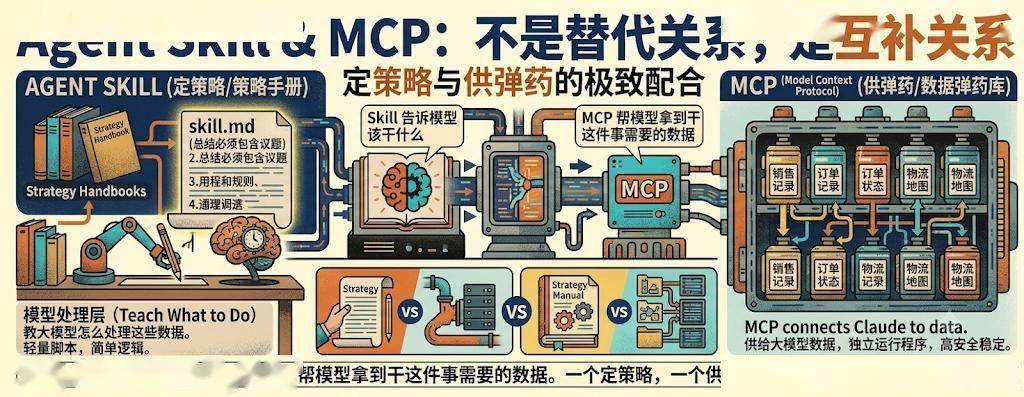
MCP connects Claude to data. Skills teach Claude what to do with that data.
MCP 给大模型供给数据。Skill 教大模型怎么处理这些数据。
打个比方。
MCP 像是一个数据接口,帮你查昨天的销售记录、读订单的物流状态。
Skill 像是一份操作手册,告诉你会议总结必须包含议题、汇报文档必须附带数据。
有人可能会说:Agent Skill 里面也能写代码连接数据啊,我直接在 Skill 里搞定不就行了?
确实可以。
但这就像瑞士军刀也能切菜,但没有人会拿它当厨刀用。
MCP 本质上是一个独立运行的程序,安全性和稳定性都比较高。
Agent Skill 本质上是一段说明文档加一些轻量脚本。
它能处理简单逻辑,但真要连接复杂的数据库、处理高并发的请求,还是得靠 MCP。
在很多场景下,Agent Skill 和 MCP 是配合使用的,不是二选一。
Skill 告诉模型该干什么,MCP 帮模型拿到干这件事需要的数据。
一个定策略,一个供弹药。各干各的,配合起来才最好用。
写在最后
06
回到开头那个问题。
一个一万行的脚本,消耗了零个 Token。
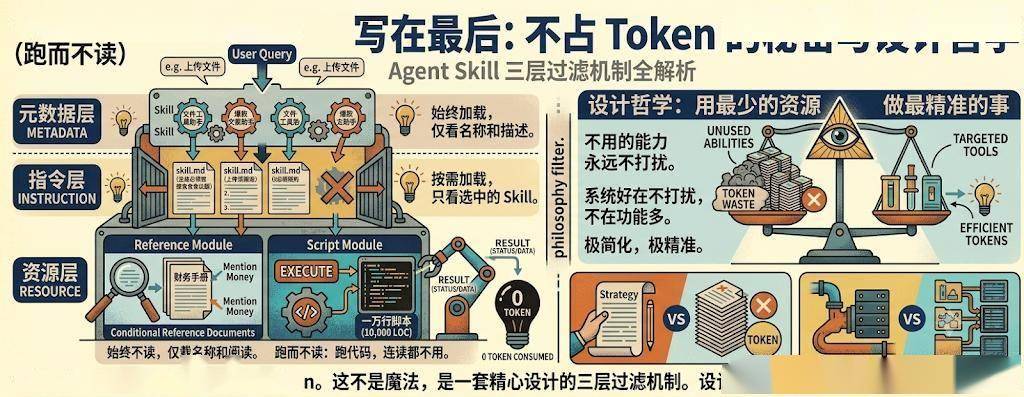
这不是魔法,是一套精心设计的三层过滤机制。
元数据层始终可见,但只有名称和描述,成本极低。
指令层按需加载,只看被选中的那个 Skill。
资源层按需中的按需,碰到了才读,跑代码连读都不用。
以前我觉得给 AI 装越多能力越好。
现在觉得,真正厉害的设计不是装了多少,而是没用到的能力能不能做到完全不占资源。
就像好的系统不是功能最多的那个,而是不用的功能永远不打扰你的那个。
Agent Skill 的三层渐进式披露,其实不只是技术技巧。
它是一种设计哲学:用最少的资源,做最精准的事。















