
 AI 写代码怎么验收?我给自己做了一张检查清单
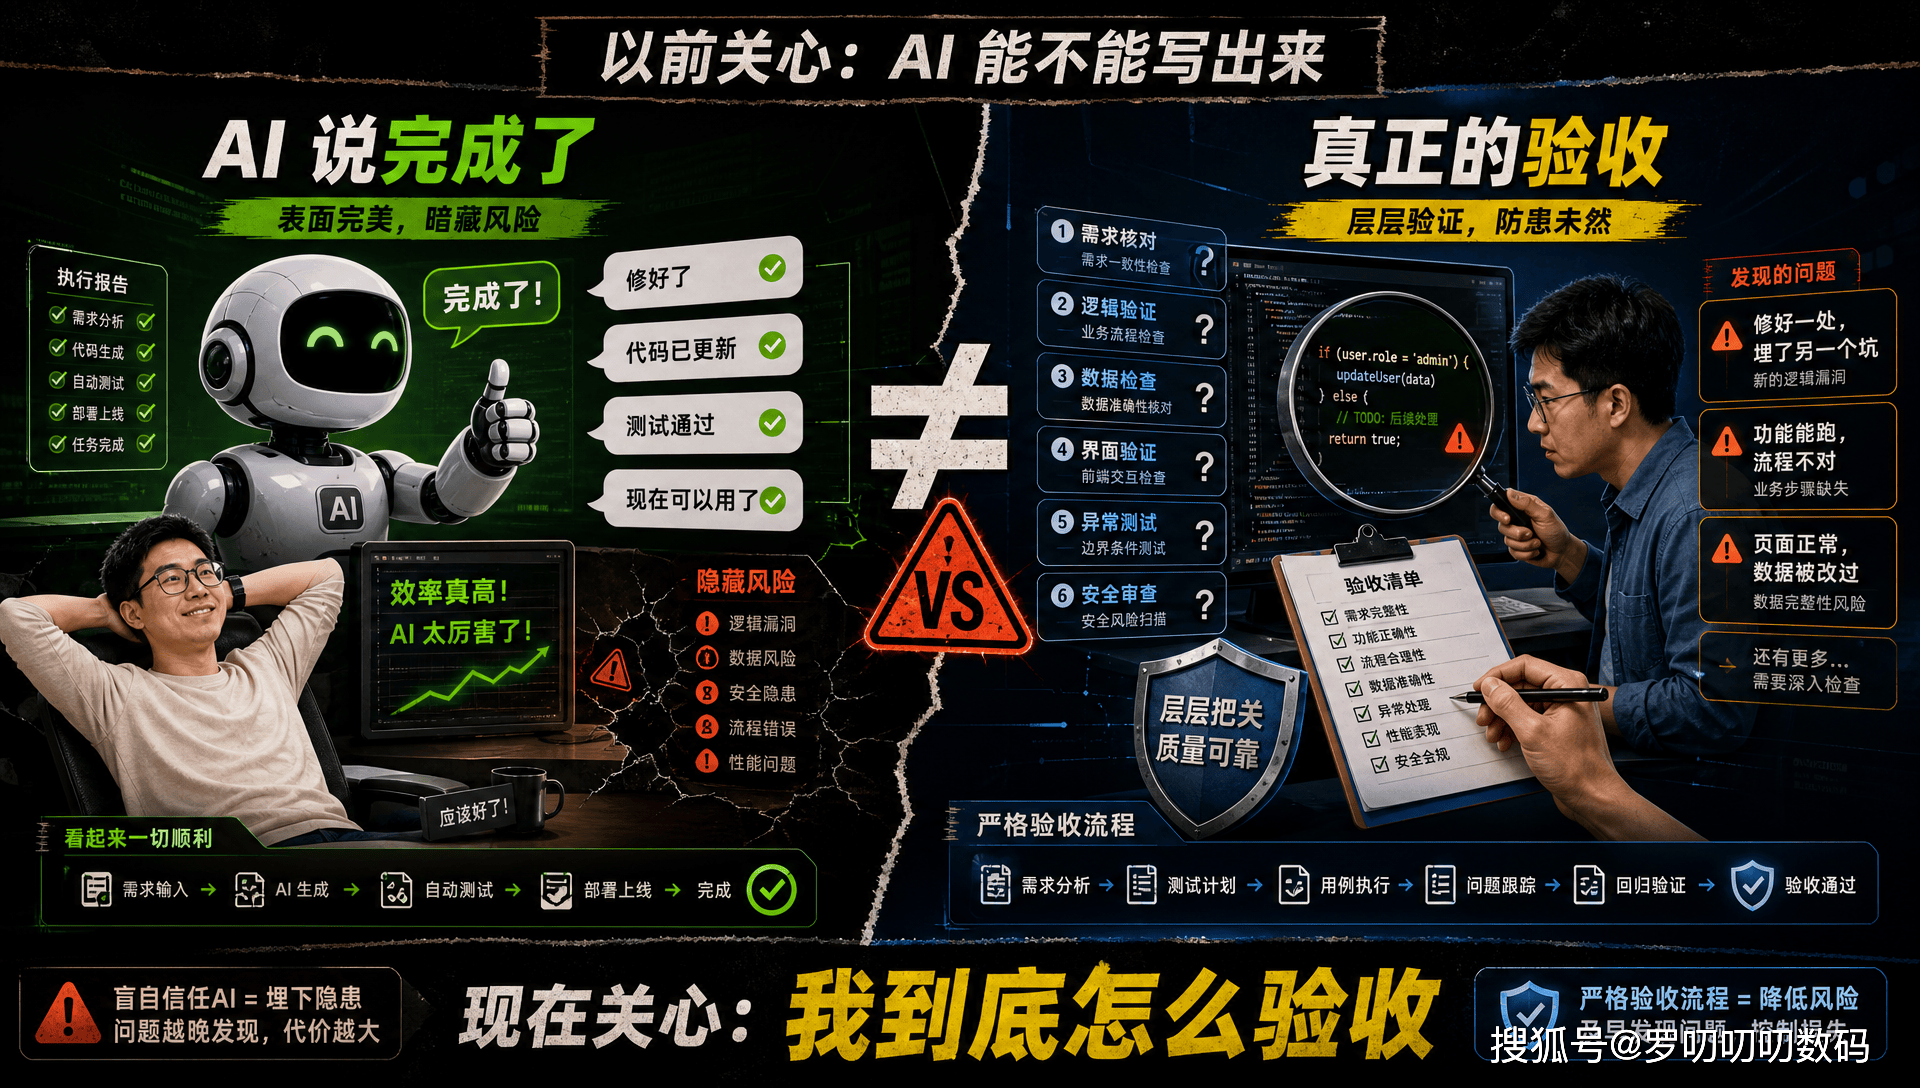
以前我用 AI 写代码,最关心的是:
它能不能写出来。
现在我更关心另一件事:
它说完成了,我到底怎么验收?
这个问题很现实。
尤其像我这种非科班出身的人,用 Codex、Claude Code 改项目,一开始很容易被 AI 的速度带着走。
它说修好了。
它说代码已经更新。
它说测试通过。
它说现在可以用了。
你看着它输出一大段解释,很容易就松一口气:
行,那应该好了。
但用久以后我发现,这个 “应该好了” 很危险。
因为 AI 写代码不是交作业。
它是在动你的项目。
它可能真的修好了问题。
也可能修好了一个地方,顺手埋了另一个坑。
也可能功能能跑,但流程不对。
也可能页面看起来没问题,但数据、权限、配置、历史记录被它动过。
所以我现在越来越觉得:
普通人用 AI 写代码,真正要补的不是“怎
么写 Prompt”,而是“怎么验收 AI 干完的活”。
今天这篇不讲复杂理论。
就讲我自己现在用 Codex / Claude Code 改项目后,会照着看的一张检查清单。
它不高级。
但很管用。
01 先看它有没有跑偏
验收的第一步,不是看代码。
而是先回到任务本身。
你一开始让 AI 做什么?
它最后做的,还是这件事吗?
这个检查特别重要。
因为 AI 很容易 “顺手做多一点”。
你让它修一个按钮样式,它顺手整理了组件结构。
你让它改一个文案,它顺手改了页面布局。
你让它补一个脚本参数,它顺手改了脚本启动方式。
它不是故意捣乱。
它只是太想把事情做完整。
但项目里最怕的就是这个。
我自己用 Codex 改 Obsidian 内容系统时,经常会提醒它:
- 这次只改这一个文件
- 不要顺手整理目录
- 不要顺手更新长期记忆
- 不要顺手改别的 Skill
这个提醒不是多余。
因为 AI 很容易把 “更完整” 理解成 “更好”。
但对真项目来说,任务没跑偏,比它多做一点更重要。
所以我现在验收时,第一句会问:
这次改动,是否只解决了我指定的问题?
如果答案是否定的,我会先停下来。
别急着看它写得多好。
先看它有没有越界。
验收的第一步,不是判断它写得好不好,而是判断它有没有做多。
02 看它到底改了哪些文件
AI 说 “我改好了”,这句话不能直接信。
你要看它改了哪些文件。
如果是代码项目,我会看:
- git status
- git diff
如果是 Obsidian 内容系统,我会看:
- 它新增了哪些笔记
- 它改了哪些上下文文件
- 有没有碰到 memory、log、index
这个动作很简单。
但很多人会跳过。
结果就是,AI 改了 10 个文件,你只看见了其中 1 个。
等后面出问题,你根本不知道问题从哪里来的。
我现在比较习惯让 AI 最后给我一个改动摘要:
- 改了哪些文件
- 每个文件为什么改
- 有没有新增文件
- 有没有删除或移动文件
- 有没有动到配置、数据、入口和长期规则
这不是形式主义。
这是给自己留后路。
因为项目不是一次聊天。
你今天看不出问题,过几天可能要回来查。
那个时候,一份清楚的改动摘要,比 AI 当时夸自己 “完成得很好” 有用得多。
AI 改了什么,比 AI 说了什么重要。
03 检查有没有碰禁区
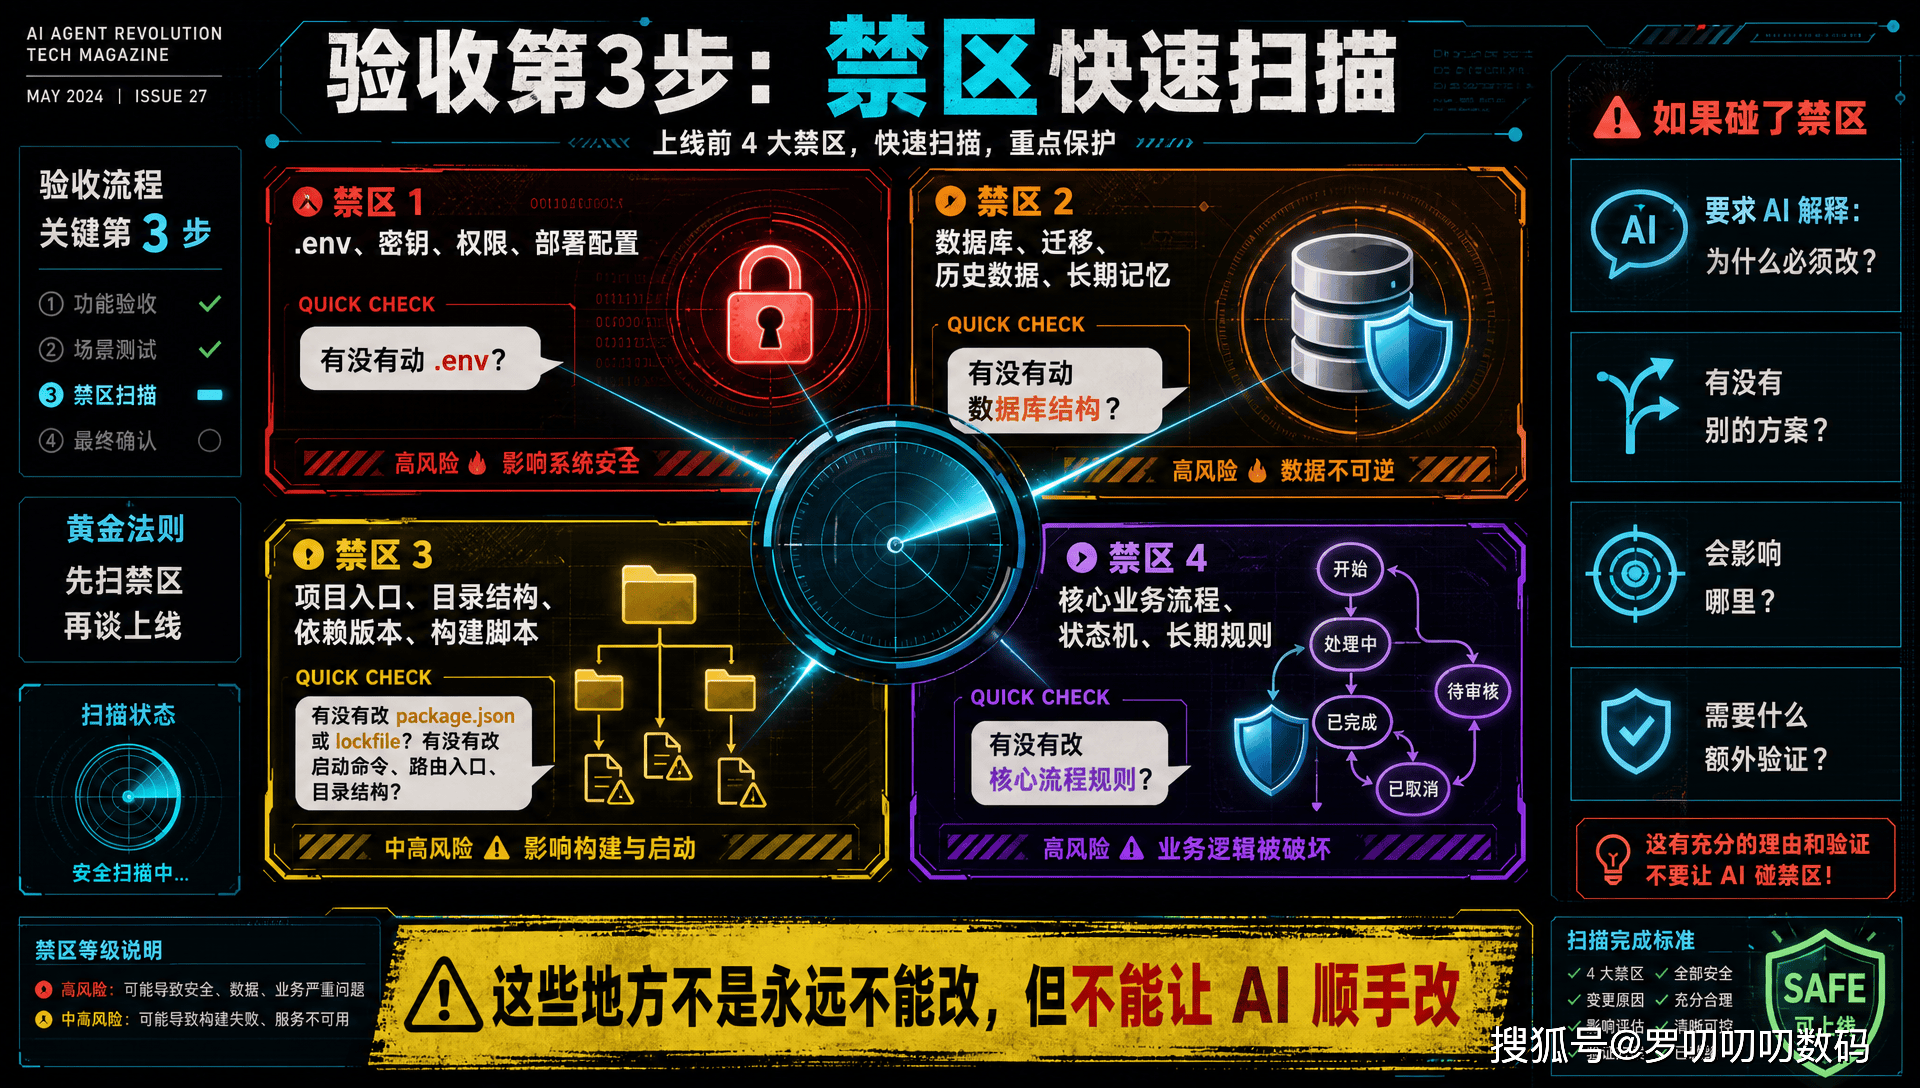
我让 AI 改项目时,最怕它顺手碰 4 类地方。
- .env、密钥、权限、部署配置
- 数据库、迁移、历史数据、长期记忆
- 项目入口、目录结构、依赖版本、构建脚本
- 核心业务流程、状态机、长期规则
这些地方不是永远不能改。
但不能让 AI 顺手改。
所以验收时,我会专门扫一眼:
- 它有没有动 .env?
- 有没有动数据库结构?
- 有没有改 package.json 或 lockfile?
- 有没有改启动命令、路由入口、目录结构?
- 有没有改核心流程规则?
如果有,我不会马上说它错。
但我会要求它解释:
- 为什么必须改?
- 有没有别的方案?
- 这次改动会影响哪里?
- 需要
我做什么额外验证?
这个动作能挡住很多隐形风险。
AI 最容易让人放松警惕的地方,就是它讲得很自信。
但你不要只听它讲。
你要看它动了哪里。
AI 的语气越自信,你越要看它有没有碰禁区。
04 看核心功能有没有真的可用
很多 AI 写代码的结果,是 “代码层面看起来对了”。
但真用的时候,不一定对。
比如你让它改一个表单。
它可能字段都写了。
但提交以后没有提示。
比如你让它改一个页面。
它可能桌面端正常。
但手机端挤在一起。
比如你让它修一个脚本。
它可能能跑一次。
但换一个参数就报错。
所以验收不能只看代码。
要看你最初要解决的那个功能,是否真的能用。
我现在会尽量用一句话定义 “核心可用”:
这次改完后,用户应该能完成什么动作?
比如:
- 用户能打开页面
- 用户能提交表单
- 脚本能按指定参数生成结果
- 内容项目能按新模板创建完整文件
- 客服流程能走到正确阶段
如果这个动作没跑通,那就不算验收通过。
哪怕代码写得再漂亮,也不算。
功能可用,不是代码看起来合理,而是用户真的能走完。
05 跑验证命令,不要只靠感觉
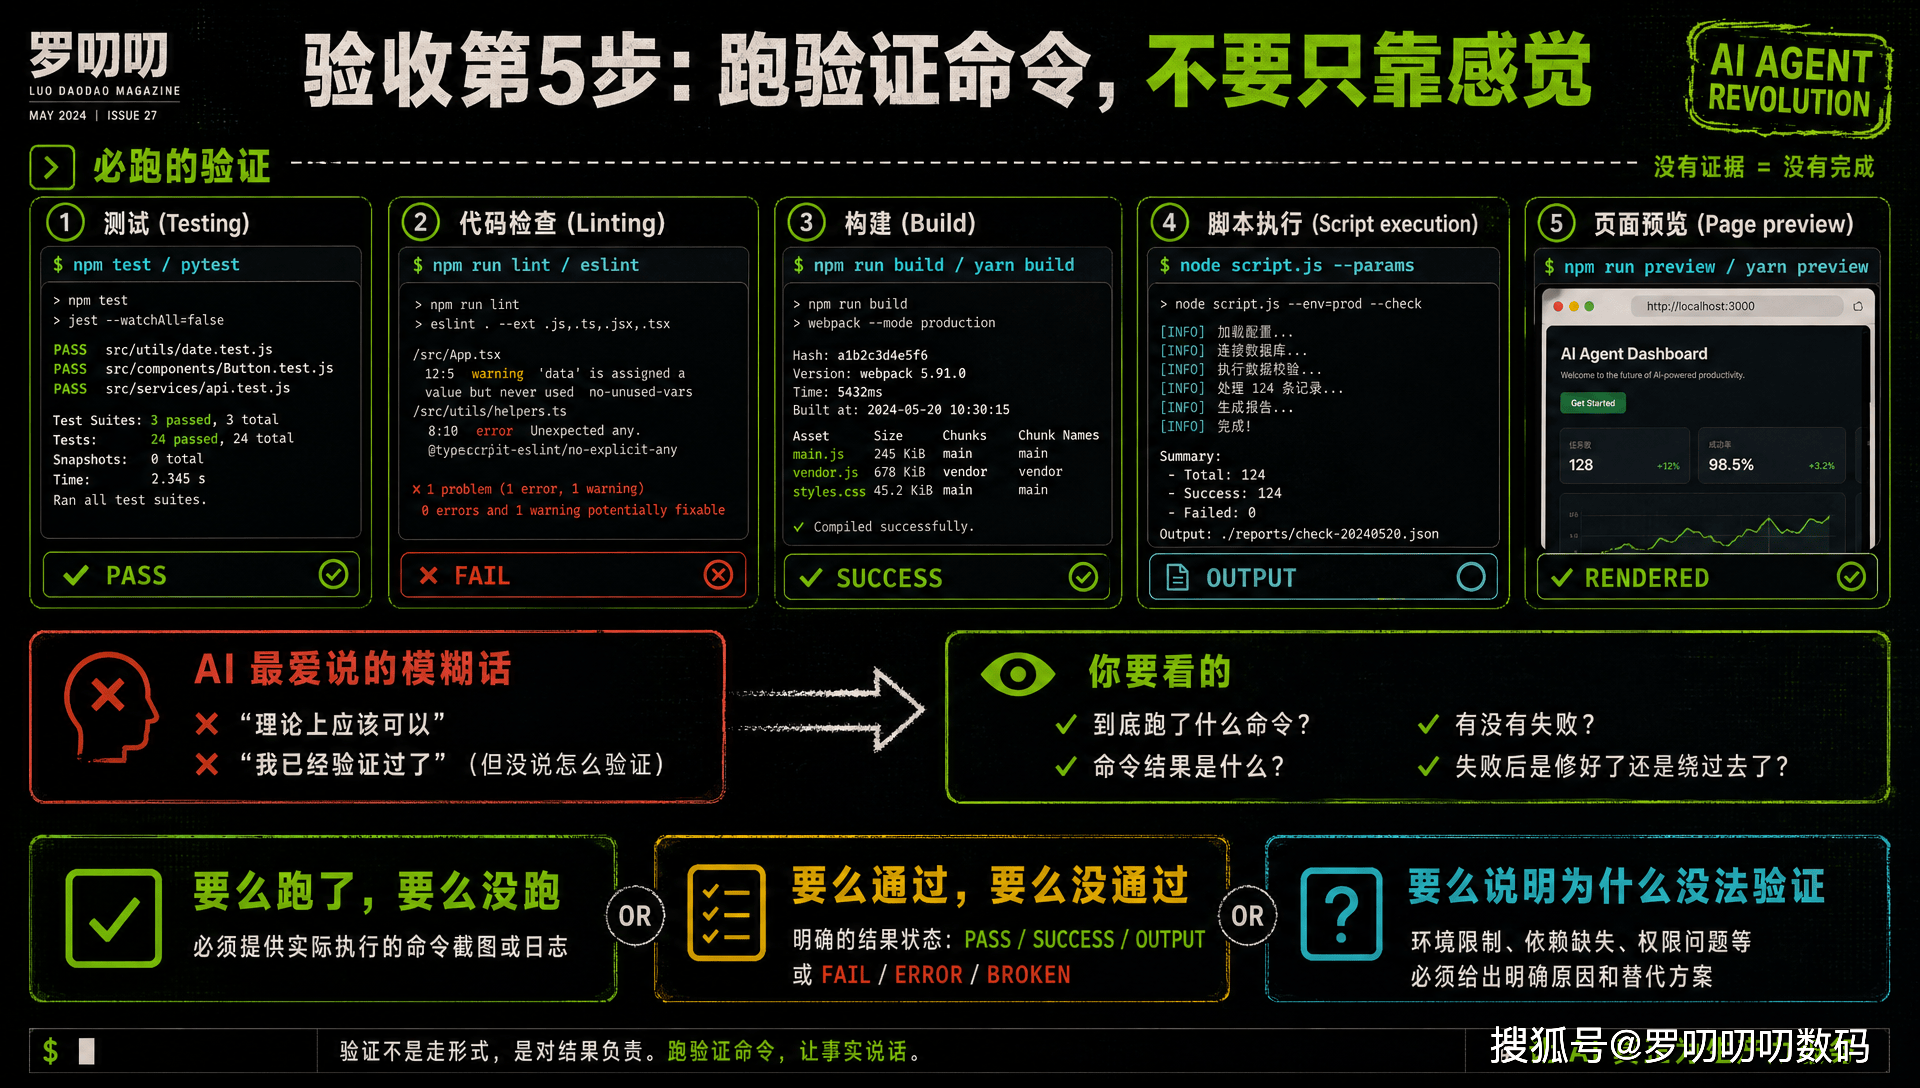
如果项目有测试,就跑测试。
如果有 lint,就跑 lint。
如果有 build,就跑 build。
如果是脚本,就跑一次真实命令。
如果是前端,就至少打开页面看一眼。
这一步听起来像废话。
但很多普通人用 AI 写代码时,最容易跳过。
因为 AI 会说:
我已经验证过了。
但你要看它到底怎么验证的。
它是跑了命令,还是只是读了一下代码?
命令结果是什么?
有没有失败?
失败以后是修好了,还是绕过去了?
我现在最不喜欢 AI 说一句模糊话:
理论上应该可以。
真项目里,“理论上”没用。
要么跑了。
要么没跑。
要么通过。
要么没通过。
要么说明为什么没法验证。
这几句话要讲清楚。
没有验证命令的“完成”,只能算口头完成。
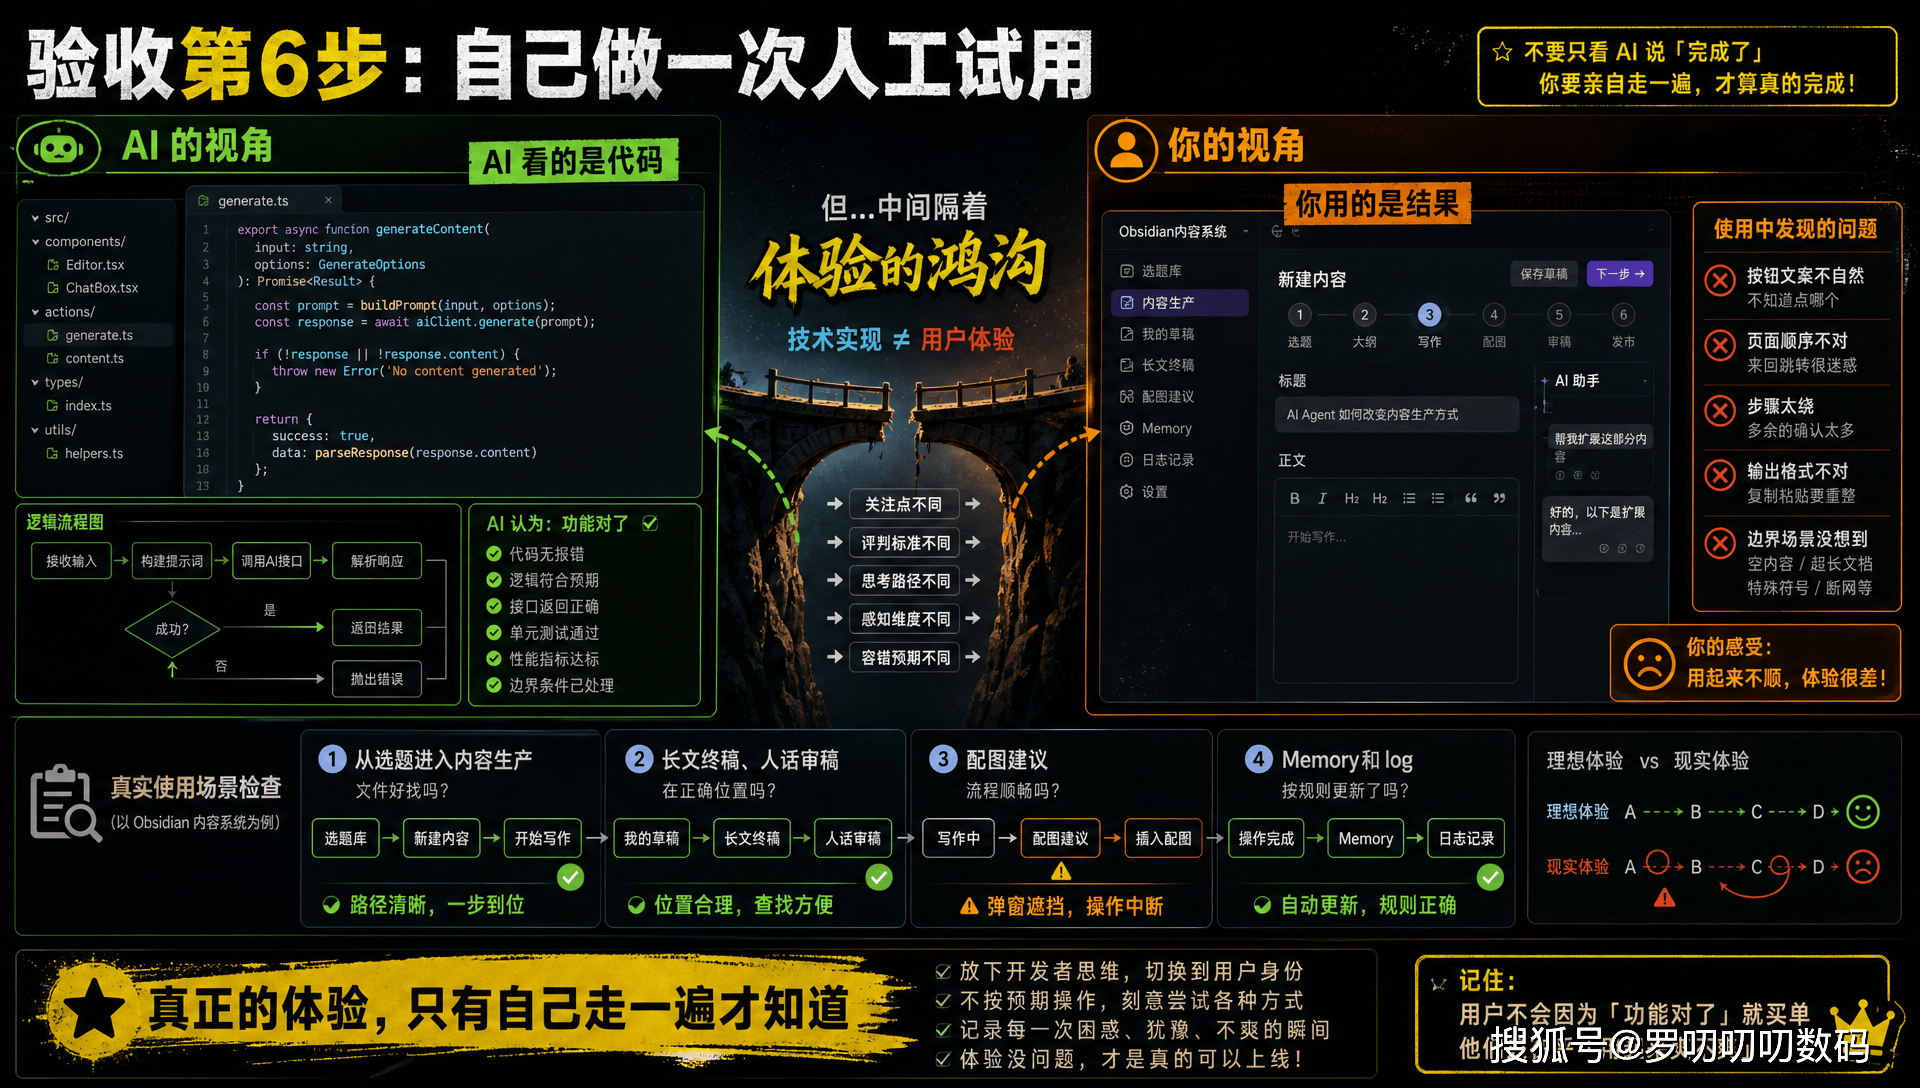
06 自己做一次人工试用
再强的 AI,也替代不了你自己试一遍。
尤其是做网页、小工具、内容系统、自动化流程的时候。
AI 看的是代码。
你用的是结果。
它觉得功能对了,但你一用可能马上发现不顺手:
- 按钮文案不自然
- 页面顺序不对
- 步骤太绕
- 输出结果不是你想要的格式
- 某个边界场景它没想到
我自己做 Obsidian 内容系统时,这种感觉特别明显。
AI 可以帮我补模板、改目录、写 Skill。
但最后这套东西顺不顺,只有我自己走一遍才知道。
比如从选题进入内容生产:
- 文件是不是好找?
- 长文终稿、人话审稿、配图建议是不是在正确位置?
- memory 和 log 有没有按规则更新?
这些东西 AI 可以检查一部分。
但真正的体验,我自己必须走一遍。
所以人工试用不是浪费时间。
它是验收里最接近真实使用的一步。
AI 能检查代码逻辑,但你才能检查使用体验。
07 看有没有留下新坑
AI 写代码有时候会出现一种情况:
眼前的问题解决了,但新坑出来了。
比如:
- 它为了修一个报错,加了一堆防御代码
- 它为了让测试通过,把真正的问题绕过去了
- 它为了完成任务,改了一个过于宽泛的逻辑
- 它把一个小问题修成了大重构
这类问题不是每次都能马上看出来。
但你可以刻意问它:
- 这次改动可能带来什么副作用?
- 还有哪些地方没有验证?
- 有没有为了快速通过而做的临时处理?
- 有没有增加新的依赖、复杂度或维护成本?
这个问题一问,很多风险会浮出来。
尤其是 Codex / Claude Code 这种能读项目、能改文件、能跑命令的工具,你不能只让它当执行者。
你还要让它当复盘助手。
让它自己说清楚:
- 哪里可能有风险
- 哪里只是暂时处理
- 哪里需要下次继续看
好用的 AI,不只是帮你改完,还要帮你把风险说清楚。
08 最后让它写一份验收摘要
这一步是我现在越来越重视的。
AI 改完项目,不要只让它说 “完成了”。
让它写一份验收摘要。
我会让它按这个格式写:
- 本次目标是什么
- 实际改了什么
- 改了哪些文件
- 跑了哪些验证
- 哪些验证没有跑
- 有没有碰禁区
- 还有哪些风险和下一步
这份摘要不是写给 AI 的。
是写给未来的自己。
你过几天回来继续做项目,能快速知道这次做到哪了。
你下次让另一个 AI 接着改,也能把这份摘要当上下文。
你以后复盘某个问题,也能翻回来查。
对一人公司来说,记录不是文书工作。
记录就是你的第二个队友。
因为你没有十个人帮你记住每个决定。
你只能靠系统、清单和记录。
记录不是麻烦,记录是在给未来的自己减负。
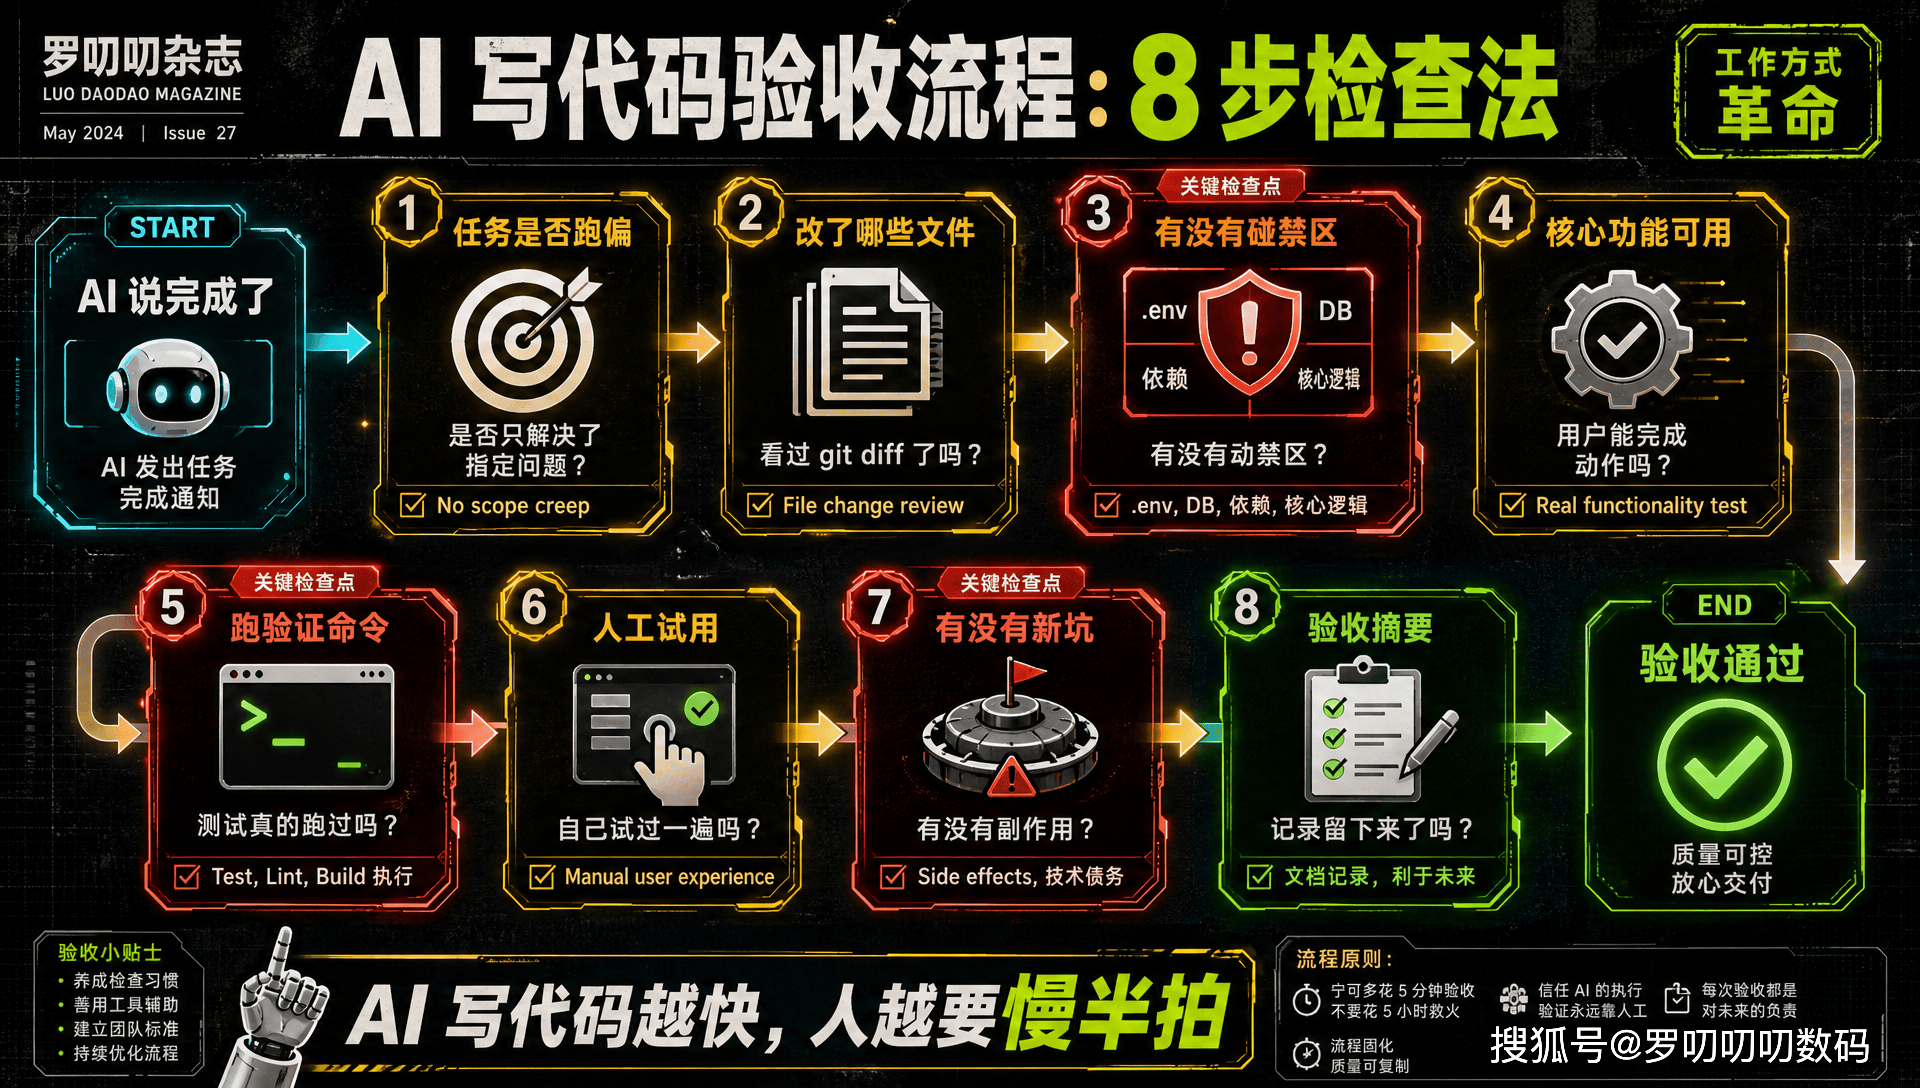
我的 AI 写代码验收清单
最后我把这张清单放在这里。
以后你用 Codex、Claude Code、Cursor,或者任何能帮你改项目的 AI,都可以照着过一遍。
检查项 | 要问自己的问题 |
---|---|
任务是否跑偏 | 它是不是只解决了我指定的问题?有没有顺手做多? |
改了哪些文件 | 我看过 git status / git diff / 文件列表了吗? |
有没有碰禁区 | 有没有动 .env、数据库、依赖、入口、核心流程? |
核心功能是否可用 | 用户或我自己能完成原本要完成的动作吗? |
验证命令是否跑过 | 测试、lint、build、脚本、页面预览有没有实际跑? |
有没有人工试用 | 我有没有像真实用户一样走一遍? |
有没有新坑 | 有没有副作用、临时处理、新依赖、复杂度增加? |
有没有验收摘要 | AI 有没有写清楚改动、验证、风险和下一步? |
这张表不是让你变成专业程序员。
它是让你别被 AI 的速度带着跑。
AI 写代码越快,人越要慢半拍。
先验收,再继续。
先看清楚,再相信。
先把记录留下来,再进入下一个任务。
这就是我现在用 AI 写代码最真实的变化。
以前我只想知道:
AI 能不能帮我写出来?
现在我更关心:
它写完以后,我能不能接得住?
能接得住,AI 才是工具。
接不住,它就是一个跑得很快、但随时可能把项目带偏的新人。













