

“日更”逼疯内容人?你需要一套不依赖灵感的AI生成系统
在当下的内容生态中,几乎所有的企业和创作者都在面临一个共同的悖论:
一方面,各大平台对内容的更新频率和质量要求越来越高,“日更”成了基本盘;另一方面,优质内容的制作成本居高不下,从文案撰写、出镜拍摄到后期修图,每一个环节都耗时耗力。
很多团队在尝试引入AI后,又陷入了新的困境:AI生成的内容虽然快,但往往“拼凑感”严重,尤其是人物形象和视觉风格难以保持统一,根本无法沉淀为品牌的长期资产。

内容生产,难道只能在“低效高质”和“高频低质”之间二选一吗?
答案是否定的。今天,我们就来拆解一套切实可行的内容提效方案——「AI创意素材:演讲版+配图增强」,看看如何通过AIGC工作流的重构,真正实现内容的高效、稳定与标准化输出。
核心痛点一:视频化表达门槛高,专家IP难以规模化
在知识付费、企业培训、行业科普等场景中,“人对人”的演讲和口播是最具信任感的表达方式。但现实是,专业的专家或高管时间极其有限,拍摄档期难协调;而普通员工出镜,又很难建立起足够的权威感和信任度。
解决方案:「演讲版」——数字化分身,让表达跨越时间与空间
“演讲版”的核心逻辑,不是简单的录音配音,而是通过小样本数智人技术,将核心人物的“表达力”进行数字化复刻。
零门槛的高频输出:只需提供极短时间的真人视频样本,即可生成与真人音容笑貌高度一致的数字分身。此后,只需输入文字讲稿,即可快速生成生动自然的演讲视频。
知识资产的长效沉淀:专家不再需要反复面对镜头,只需专注内容本身的打磨。一次克隆,即可将专家的智慧转化为可常态化、批量化输出的视频资产,无论是用于内部培训、客户解答还是行业分享,都能以最低的边际成本覆盖最广的受众。
核心痛点二:AI生图风格随机,品牌视觉资产无法沉淀
很多运营人员在用Midjourney或同类大模型生图时,最头疼的就是“抽卡感”太重。今天生成了一张满意的图,明天想要同样的画风和人物,却怎么也复现不出来。对于品牌而言,没有一致性,就没有辨识度,更谈不上资产沉淀。
解决方案:「配图增强」——锁定一致性,构建标准化的视觉工作流
“配图增强”并非简单的画质清晰化,而是通过底层工作流的设计,解决AIGC内容“风格漂移”和“角色失忆”的根本问题。
多模型路由,择优而用:方案集成了多家头部图像/视频大模型能力,系统可以根据指令自动匹配最适合的生成模型,省去了人工切换工具的成本。
三维一致性调优,锁定品牌基因:
风格一致性:设定品牌专属的视觉基调和画风模板,后续所有生成内容均以此为基准,确保每一张配图都长在品牌的“审美体系”里。
角色一致性:针对IP人物,通过多角度参考垫图与自动Prompt补全技术,有效抑制AI画面的随机变形,确保同一角色在不同场景下的面部特征和服饰细节高度统一。
动态一致性:支持从首尾帧到流畅视频的延伸生成,让静态的演讲配图“动”起来,且动作连贯自然,极大丰富了内容的展现形式。
工作流重构:当“演讲版”遇上“配图增强”
单一的工具只能解决单点问题,真正的降本增效发生在工作流的融合中。
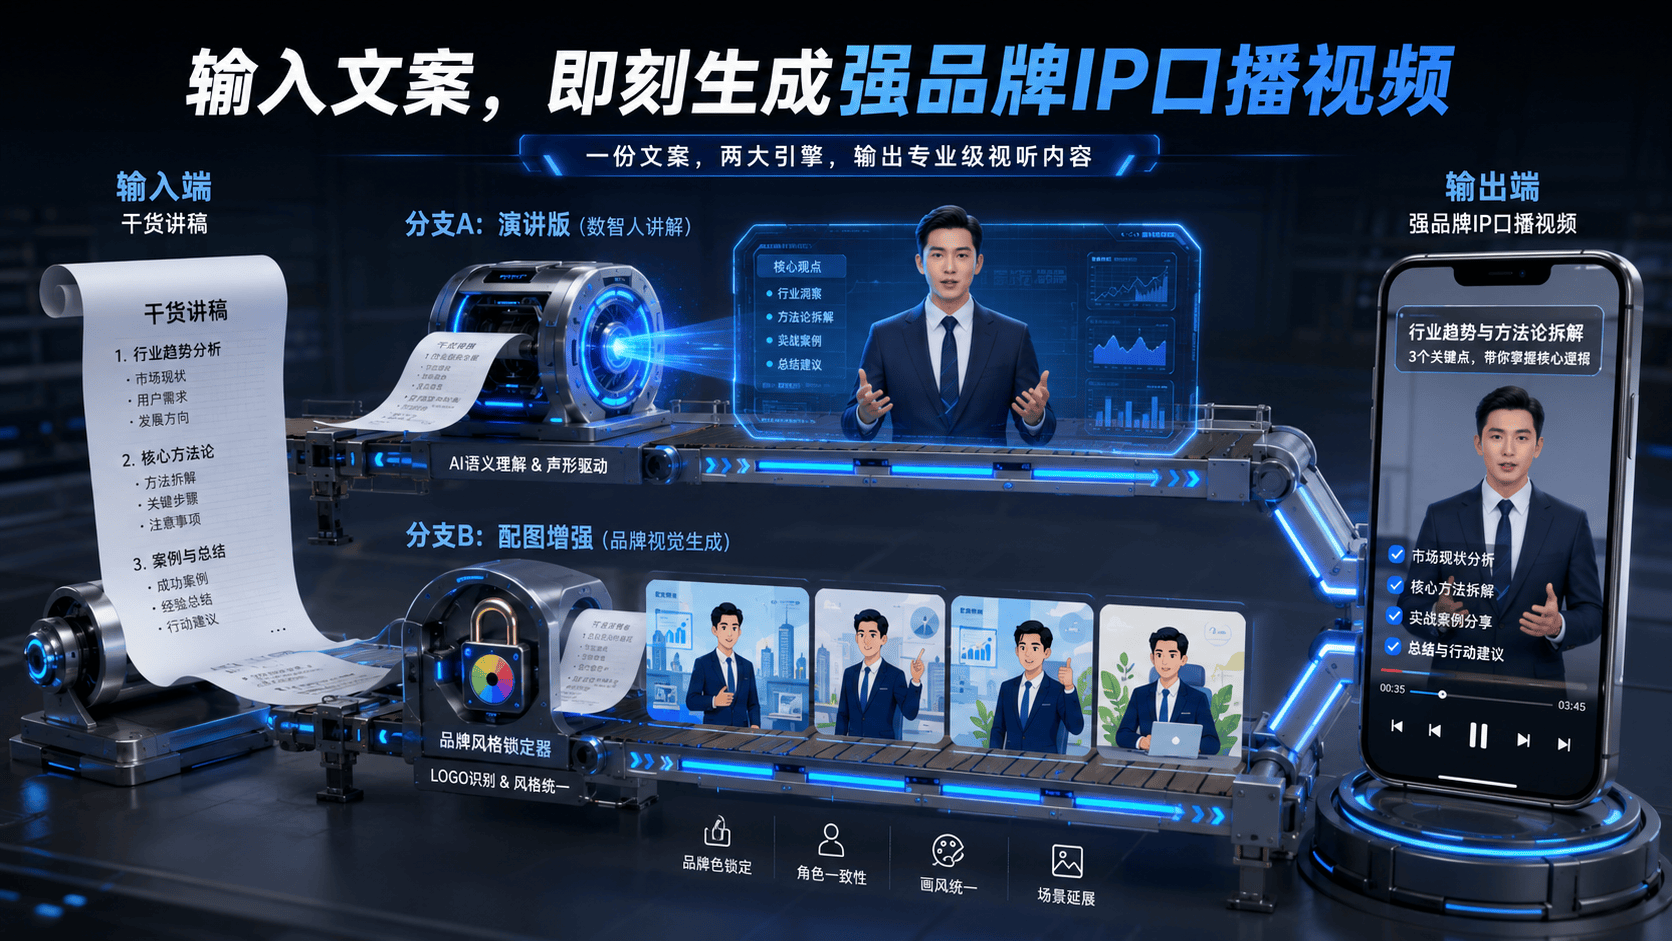
试想一下这样一个标准化的内容生产线:
内容输入:运营人员输入一篇干货讲稿。
音频与分身合成(演讲版):系统自动调用专家数字分身,生成声情并茂的口播视频。
智能配图生成(配图增强):系统同步解析讲稿语义,按照预设的品牌风格和IP形象,自动生成与语境完美契合的插画或动态背景。
智能合成:音视频与视觉素材无缝叠加,一条高质量、强品牌属性的专业讲解视频即刻产出。
在这个流程中,人只负责提供核心思想与初始设定,繁琐的拍摄、找图、排版、渲染全部交由AI工作流自动完成。
结语:从“制造内容”到“管理资产”
面对日益严苛的平台规则和挑剔的用户,粗放式的营销轰炸已然失效。未来的内容竞争力,不在于你一天能发多少条内容,而在于你是否能持续、稳定、高效地输出有价值且具备品牌一致性的内容。
「AI创意素材:演讲版+配图增强」提供的正是这样一套基础设施:它帮你抹平了视频制作的门槛,消除了视觉产出的随机性,让企业能够真正将精力聚焦于观点的表达与知识的传递。
当内容生产不再是阻碍,企业的每一次发声,都将是在为品牌资产添砖加瓦。
(如果您对这套AIGC内容工作流感兴趣,欢迎在评论区留言探讨,或后台获取更多技术实践案例。)












