

先说一句大实话:网上最容易把这件事吹歪的说法是—— "AMD 用一台迷你主机打败了 RTX 5090/5080,云端要完蛋了。"
真相要朴素得多: 它真正的杀手锏不是单纯算得更快,而是显存容量天花板被抬到了一个消费级 x86 以前不敢想的位置。
它到底是什么:平台叫 Ryzen AI Max(Strix Halo),"迷你主机"多由合作厂落地
严格说, AMD 并没有像卖自有品牌整机那样发布一款"AMD 牌迷你主机"——而是把 Ryzen AI Max+(旗舰 395)这颗片子上到合作伙伴的紧凑桌面机里:例如极摩客 EVO-X2、Framework Desktop 等形态,对外讲的卖点是: 巴掌/厚书大小、128GB LPDDR5X-8000 统一内存(UMA),能给 GPU 分到大段内存池,用来做本地 AI 推理/开发机。
为什么"128GB 统一内存"会让玩模型的人眼睛亮:关键是"装得下"
传统 PC 架构里,GPU 的显存是独立的(24GB/32GB),一旦模型权重超出 VRAM,就要么爆显存,要么开始用系统内存/SSD 当替补——速度直接雪崩。
AMD 这套 UMA 的做法更像是把苹果 M 系那种思路搬回 x86:CPU/GPU/NPU 共享同一块物理内存池;在 128GB 总容量下, BIOS/配置允许把其中最高约 96GB 划给 GPU 作为可访问显存空间(社区/实测文章也常提到 Linux 环境下可访问范围能摸到 110GB 量级,但更稳的官方口径通常说"最高 96GB 专属分配"),于是很多 以前只能上多卡/服务器的量化大模型,现在至少能"塞进内存里跑"。
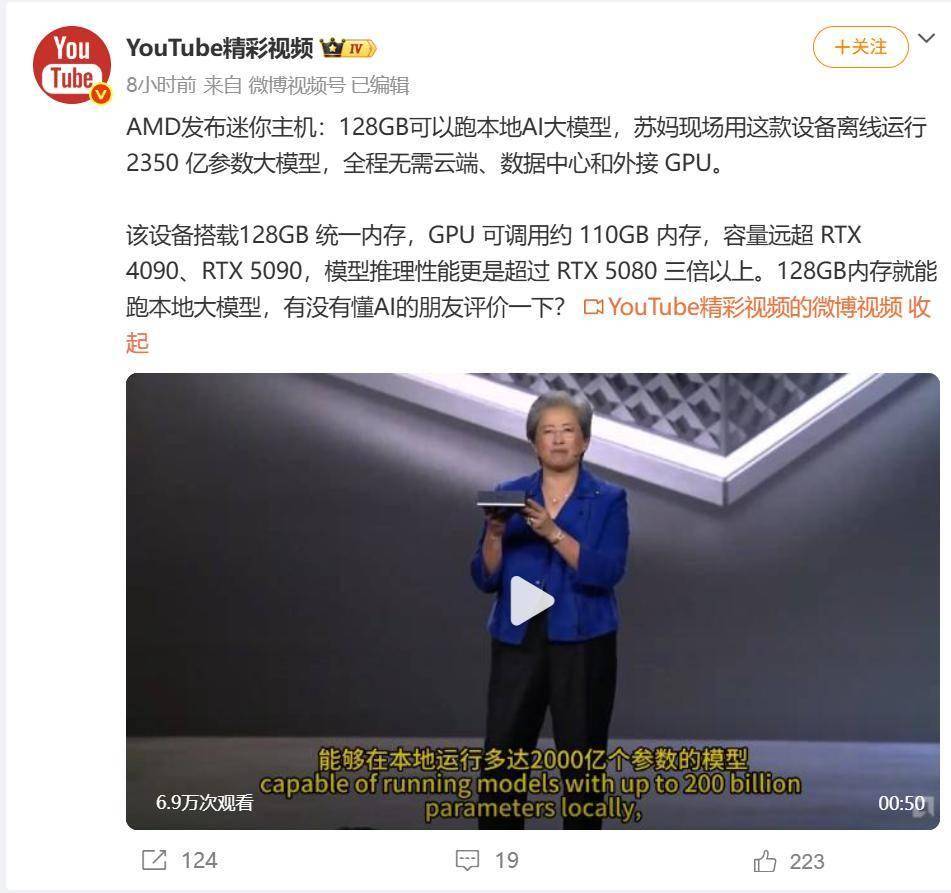
这也是为什么现场/展台演示会出现那种冲击力很强的画面: 离线、不连云、跑几百B级参数的 demo(你看到的"2350亿参数/235B"这类数字,基本都是在量化/MoE-只激活一部分权重等前提下成立的,别把它理解成"全精度塞进 128GB 还飞快")。
"远超 4090/5090、超 5080 三倍"该怎么理解才不骗自己
更诚实的读法有两层:
显存容量维度:24GB(4090)/32GB(5090)被 96GB 级按在地上摩擦——这是结构性的,跟跑分无关,纯粹是"池子大小"问题。
推理性能比较:AMD 官方/媒体引用更多集中在 70B 这类模型 token/s 对比,并强调功耗效率优势;但如果你说的是 raw 浮点/矩阵吞吐与高端独显比峰值算力,那仍然是两码事。
所以更准确的一句话是: 它在"需要大显存但又不想搞服务器/多卡"的人群里非常香——尤其是私有化部署、RAG、需要长上下文/多模型并存的工作流。
但它也不是"人人都该冲"的神
效率上限取决于你怎么量化:模型越大,量化越激进,生成速度(tokens/s)和"聪明程度"的折损你得自己接受。
生态细节要盯着:跑 LLM 这套更吃 AMD ROCm/Ollama-Linux 路径成熟度;Windows 下能跑,但很多硬核玩家还是会切 Linux 来把内存分配吃满。
别把它当游戏主机买:核显再强(Radeon 8060S 40CU 那套),在传统光栅游戏峰值帧这件事上,仍然不是同价位独显机的对手——它定位更接近"桌面 AI 工作站/开发机",不是"4090 替代品"。
懂行的人会告诉你:这台东西的价值不在玄学,而在把"大模型本地化"从机房预算问题,降级成桌面采购问题。128GB 统一内存 + 可分配大段 GPU 内存池,打开了私有部署、离线推理、企业内网 Agent 的一条更便宜的口子——但它仍然是"工具",不是"魔法",最终好不好用,看你模型选型、量化策略和工作流,而不看一句"超三倍的标题"。
#玩出数码新浪潮#












