

在材料、催化、量子化学等科研领域,第一性原理、DFT 密度泛函理论等传统理论计算方法是解析微观物质机理的核心工具。但长久以来,传统理论计算存在难以回避的局限性:高精度模拟计算成本极高,复杂体系、高通量筛选任务耗时动辄数周;面对多组分、动态反应体系,难以兼顾计算精度与效率;大量模拟生成的光谱、结构、能量数据缺少高效挖掘手段,海量科研数据价值无法充分释放。
与此同时,机器学习理论凭借强大的数据拟合、预测、特征提取能力快速发展。两类学科看似分属计算化学与人工智能两大赛道,底层逻辑却具备极强互补性:理论计算能够为机器学习提供精准、物理意义明确的标注数据集,机器学习则能反过来加速理论模拟、修正理论近似误差、挖掘隐藏物理规律,二者的交叉融合,成为突破传统计算天花板的核心路径。
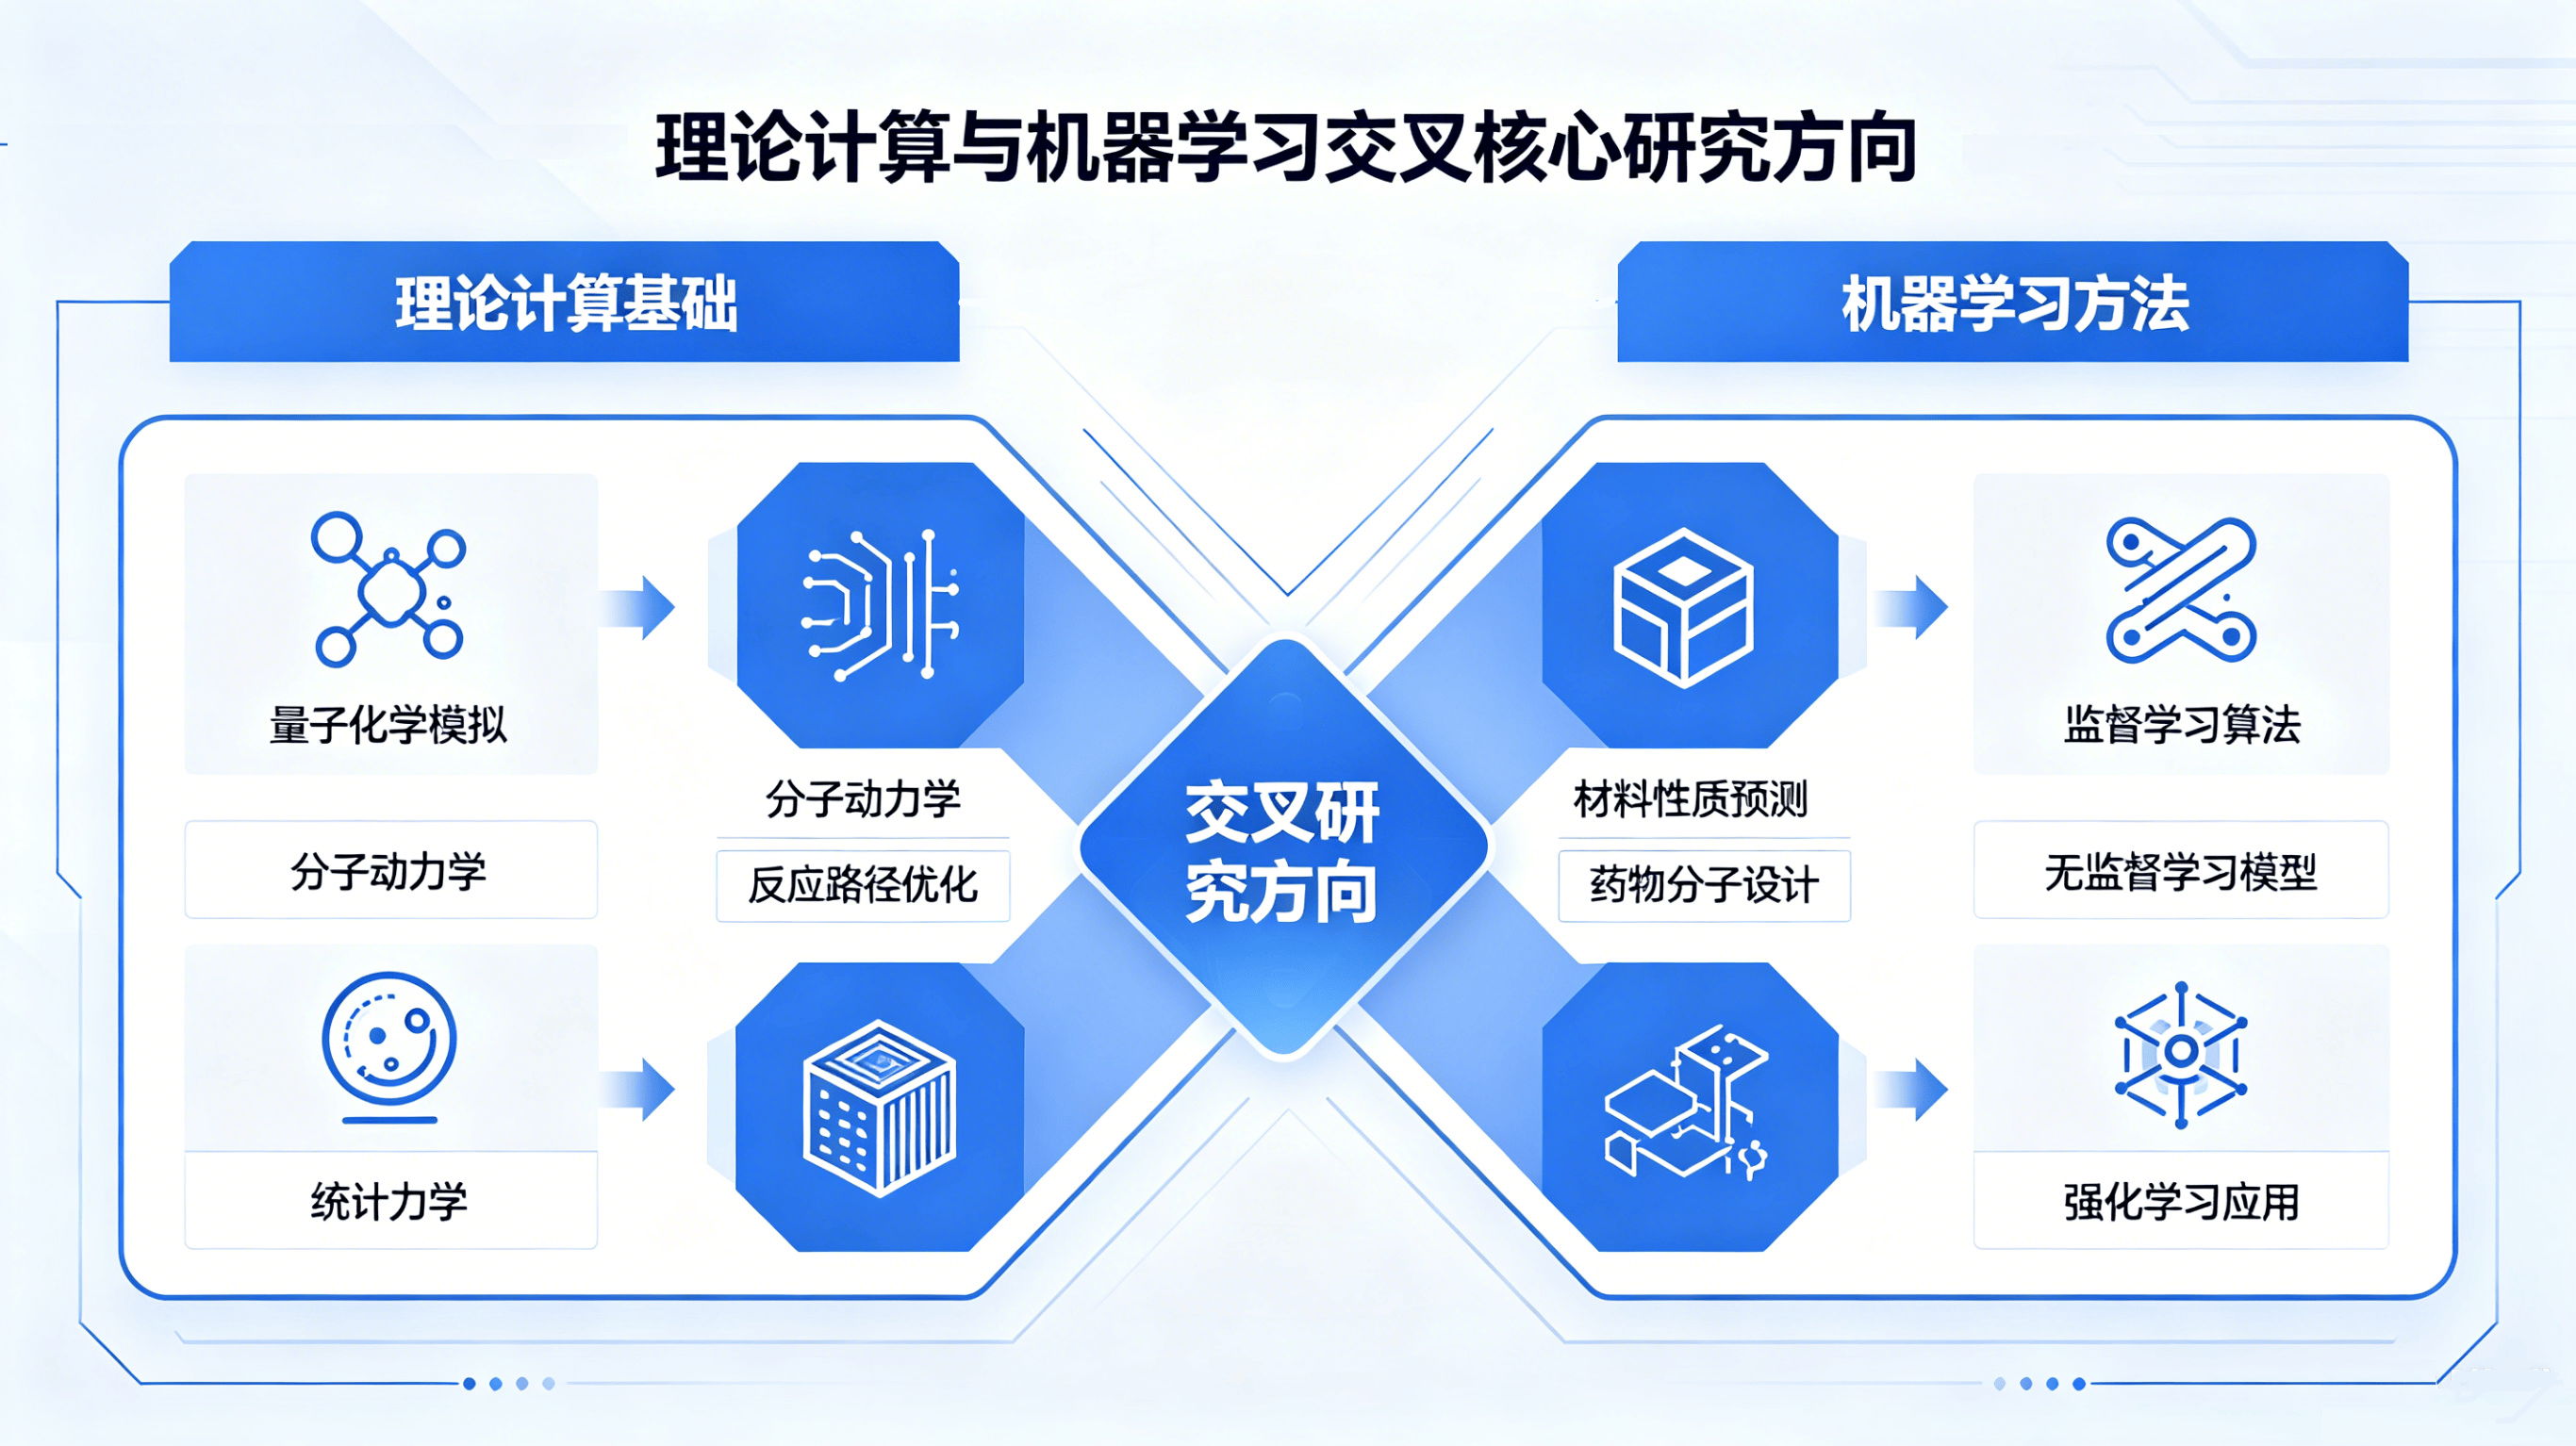
传统 DFT 逐离子步求解薛定谔方程,大体系计算效率极低。当下主流研究思路是通过机器学习势能面(MLP)替代传统经验势与部分高精度 DFT 计算:以少量高精度理论计算结果作为训练集,训练神经网络势能模型,在保持接近第一性原理精度的前提下,将分子动力学模拟提速上千倍。 该方向衍生出诸多细分课题:神经网络势函数构建、主动学习采样策略、跨尺度 ML 势适配,现已广泛应用于电催化反应动态过程、合金相变、界面水分解等复杂体系模拟。
(二)高通量材料筛选与性能预测理论计算高通量筛选是发掘新型催化、储能材料的经典手段,但全维度遍历计算成本高昂。机器学习可基于已有理论计算数据库(Materials Project、AFLOW 等)构建性能预测模型:仅输入晶体结构、元素配比、电子结构特征,就能快速预判材料催化活性、带隙、稳定性、吸附能等关键指标。 前沿研究聚焦小样本学习、图神经网络 GNN 在晶体表征中的应用,解决新型无数据库体系预测不准的痛点,大幅压缩新材料研发周期。
(三)理论计算约束下的可解释机器学习纯黑盒机器学习模型存在物理可解释性差的短板,这也是科研领域落地 AI 模型的核心阻碍。当前交叉研究热点之一,是将物理守恒定律、量子化学理论约束嵌入机器学习框架:在损失函数中引入能量守恒、轨道杂化规则、反应热力学边界等理论条件,构建具备物理一致性的 AI 模型。 此类研究打通 “数据预测 — 机理解释” 闭环,既能精准预测反应中间体能量,又能反向推导催化活性位点、电子转移机制,完美适配催化、能源材料机理探究需求。
(四)谱学数据智能解析与理论校准XPS、XRD、同步辐射 XANES 等表征谱图解析高度依赖理论模拟对照。传统方式需反复调参做大量理论计算拟合谱峰;而机器学习可建立理论模拟谱图与实验实测谱的映射模型,自动完成分峰、物相识别、价态定量分析,同时利用实验数据修正理论计算泛函、赝势带来的系统误差,实现实验 - 理论 - AI 三方闭环校准。
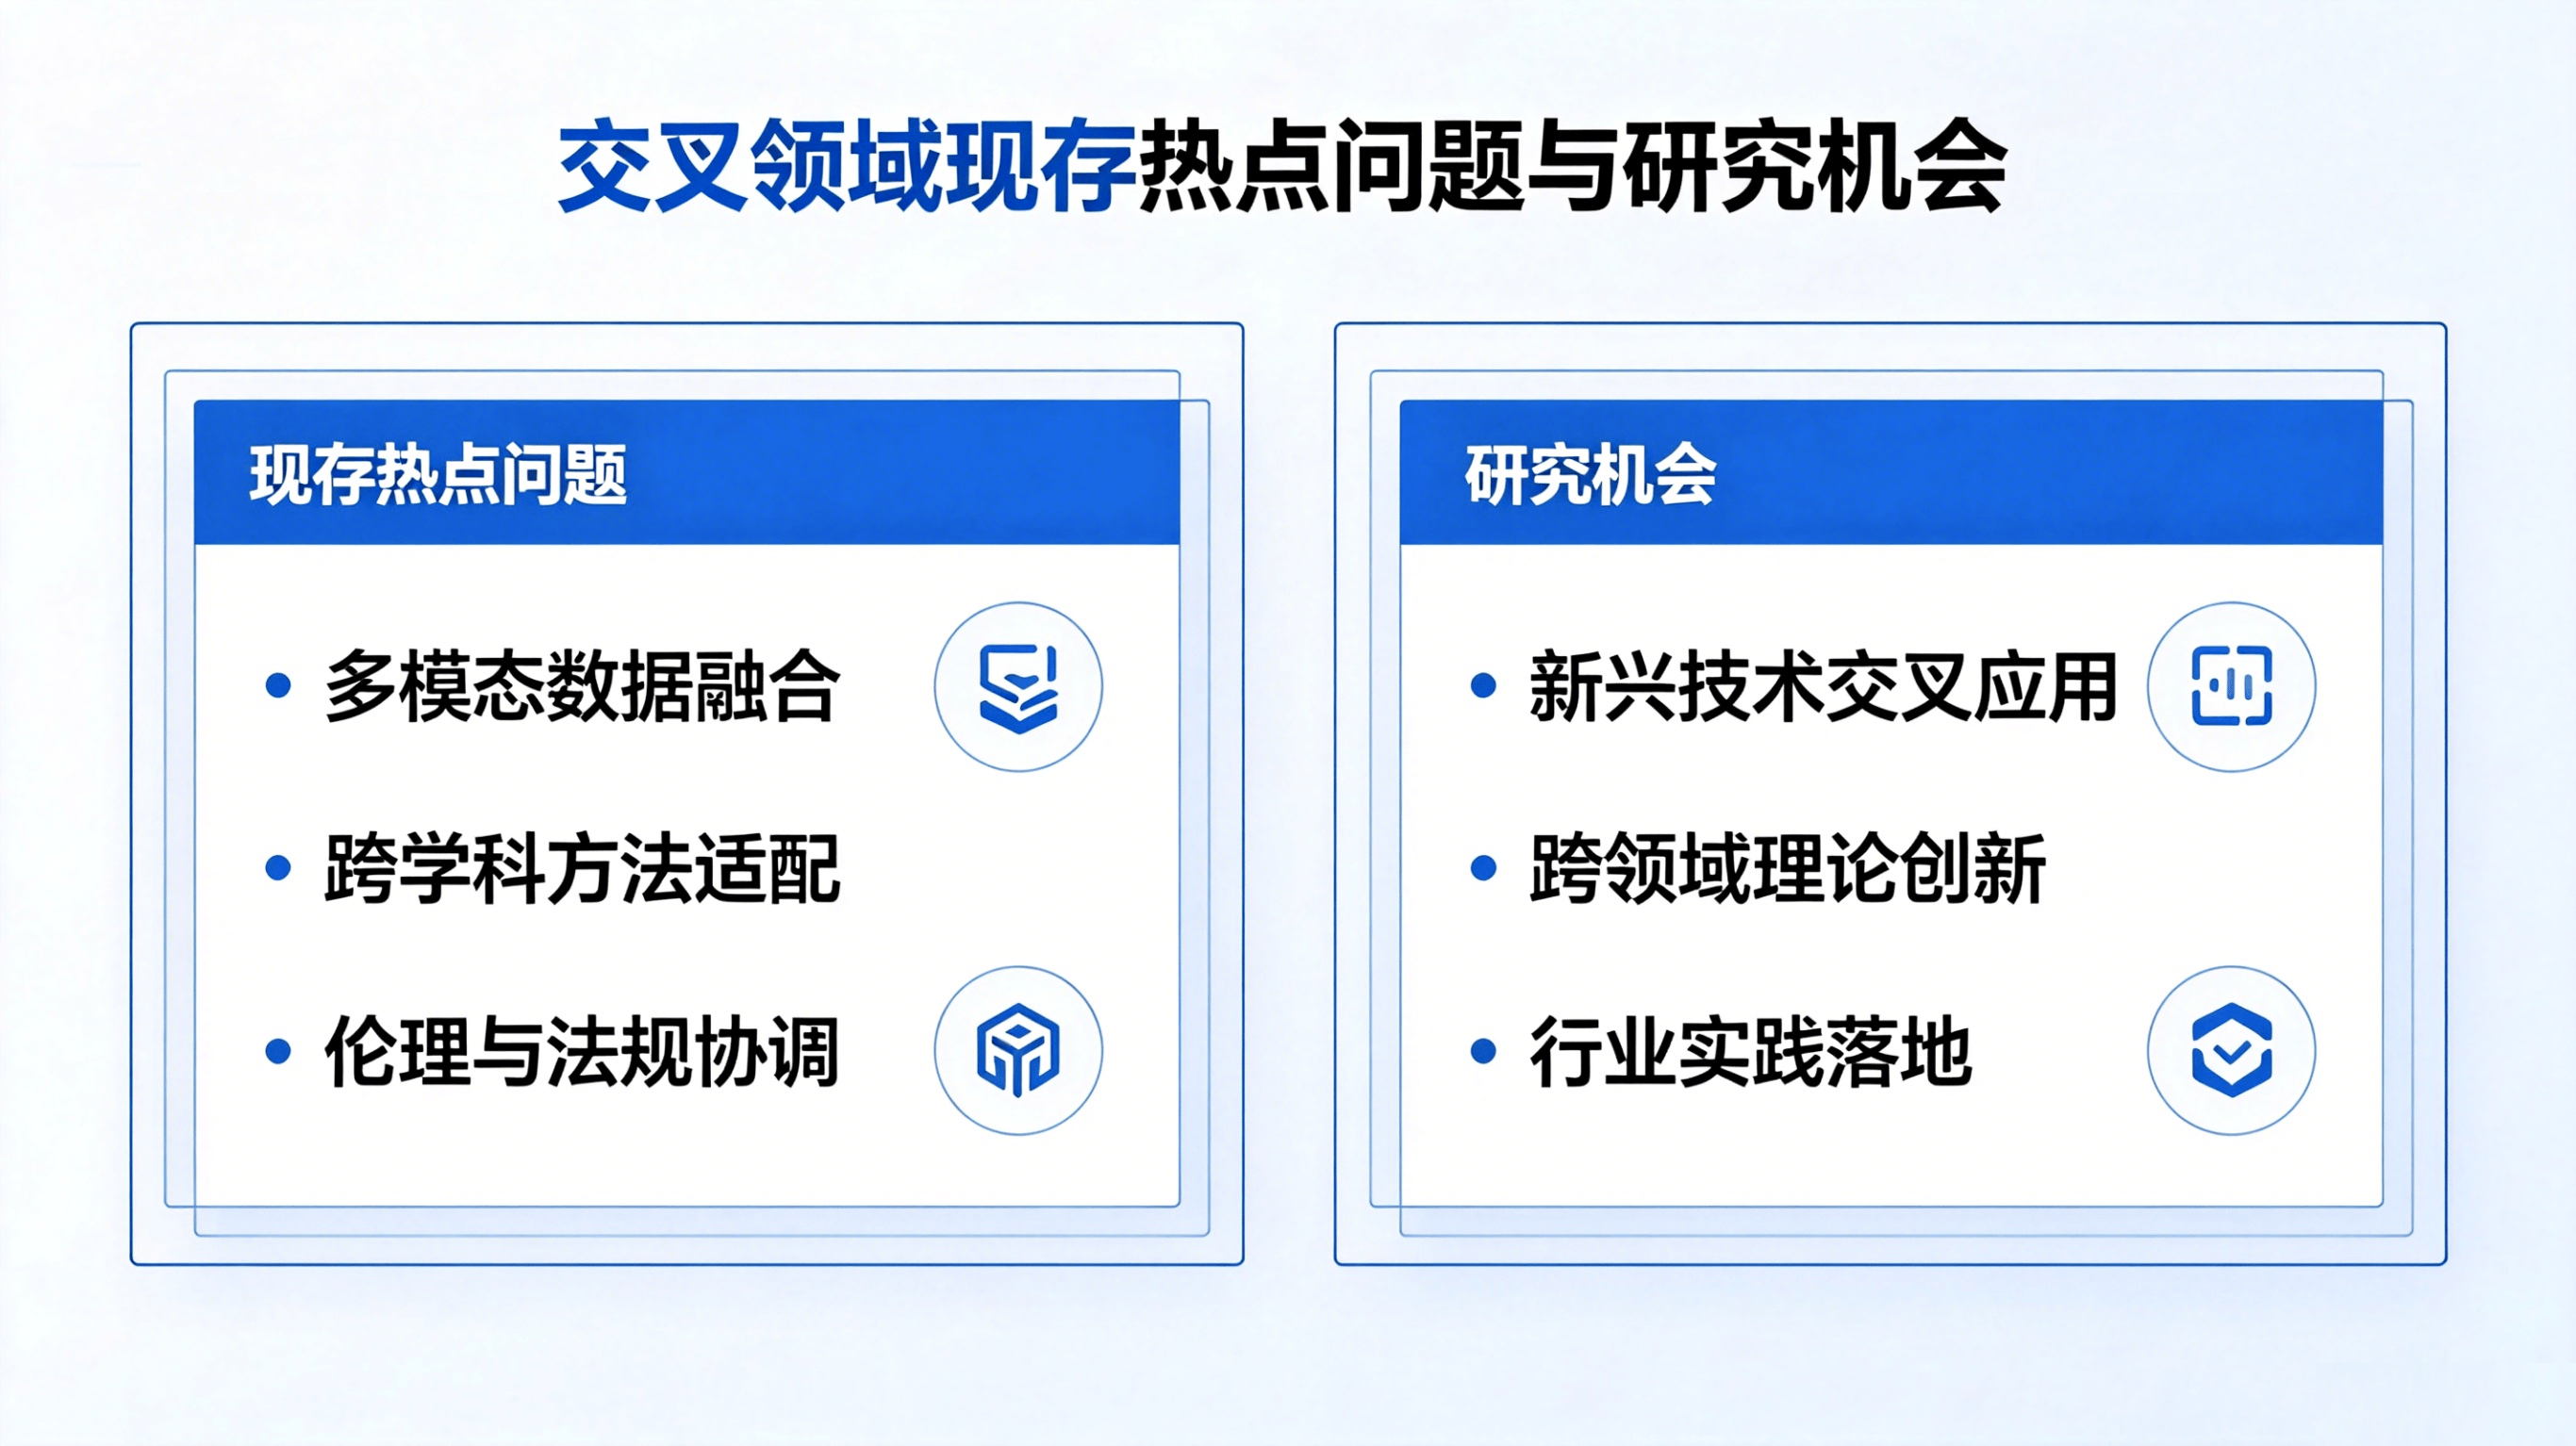
多数新型前沿材料(单原子催化、MXene、LDH 层状材料)缺少海量理论计算数据集,常规监督学习效果差。现存研究空白:基于迁移学习、物理先验弱监督学习框架,仅用少量高精度 DFT 数据完成高性能模型训练;开发适配材料微观体系的少样本神经网络架构,是极具产出潜力的创新方向。
2. 多尺度耦合交叉算法开发微观电子尺度 DFT、介观分子动力学、宏观连续介质模型跨尺度耦合计算,是复杂电化学、多相催化体系刚需,但传统耦合算法迭代缓慢。新兴机会:机器学习作为跨尺度桥梁,实现不同尺度模型间参数、能量信息快速传递,搭建一体化多尺度 AI - 理论计算模拟框架。
3. 模型泛化性与物理一致性平衡很多机器学习势能、性能预测模型仅能适配训练集内体系,更换元素、晶体结构后预测误差陡增。当前前沿研究缺口:构建具备通用物理表达的基础大模型,统一描述金属、氧化物、二维材料等多类体系;量化模型违背物理定律的误差,建立标准化理论约束评估体系。
4. 面向自动化科研的一体化工具链目前理论计算软件(VASP、CP2K)与机器学习框架(PyTorch、TensorFlow)割裂,数据转换、模型训练、批量模拟需要大量手动脚本开发。蓝海研究方向:开发一站式开源工具包,实现结构生成→DFT 批量计算→数据集构建→模型训练→高通量预测全流程自动化,降低交叉学科入门门槛。
四、跨学科融合的科研价值与发展前景从学术层面,理论计算与机器学习交叉打破化学、材料、计算机学科壁垒,开辟全新范式:不再单纯依靠 “计算试错” 或 “数据拟合”,而是以物理理论为根基、以数据智能为工具,实现从 “解释已知材料” 到 “逆向设计未知功能材料” 的科研升级,为催化 CO₂RR、OER、氢储能、半导体等前沿赛道提供全新研究方法论。
从工程应用层面,这套交叉体系能够大幅缩减新材料、新催化剂研发周期,降低超算算力消耗,推动实验室基础研究快速落地工业场景;同时衍生出机器学习辅助理论计算、AI 材料数据库、智能谱学分析等细分科研服务方向,具备显著学术与产业双重价值。
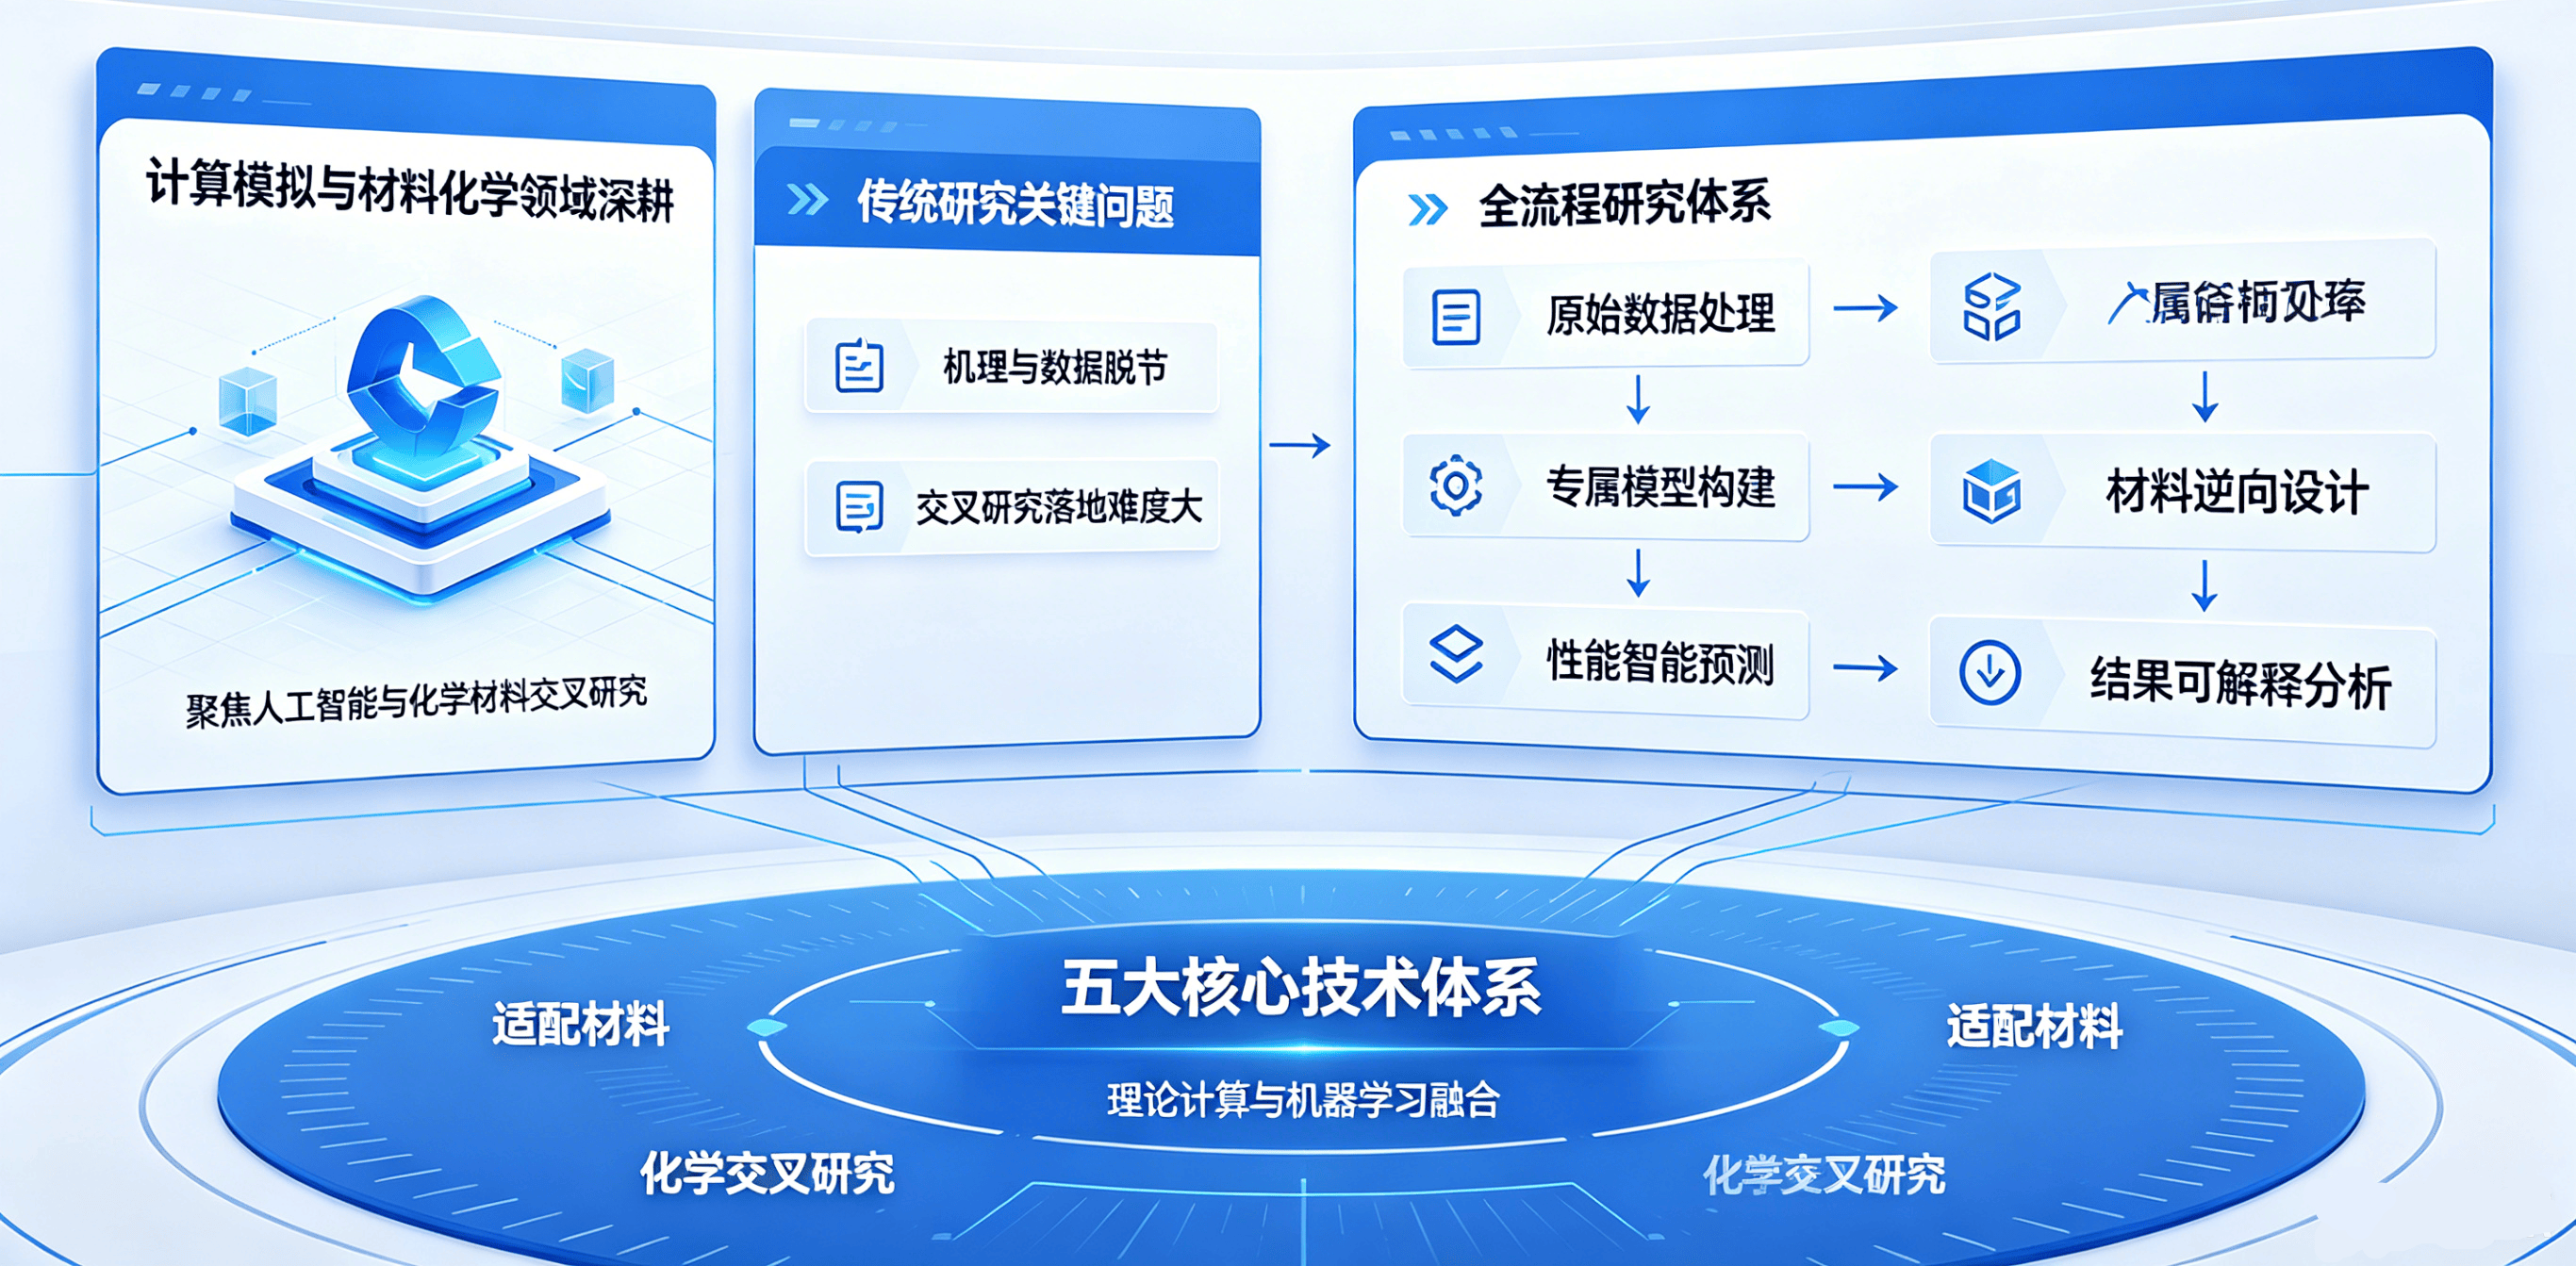
深耕计算模拟与材料化学领域多年,华算科技聚焦人工智能与化学材料交叉研究的学科壁垒,针对传统研究中机理与数据脱节、交叉研究落地难度大等关键问题,将前沿机器学习算法与催化、新能源材料、药物研发、电化学等细分领域的专业理论深度结合,构建了涵盖原始数据处理、专属模型构建、性能智能预测、材料逆向设计、结果可解释分析的全流程研究体系,可适配不同课题组的科研需求,助力突破传统试错式研究局限,高效推进创新课题研究与高质量成果产出。
依托长期技术积累,华算科技搭建了适配材料、化学交叉研究的五大核心技术体系,全方位赋能理论计算与机器学习的融合研究落地:
第一,多源数据融合技术:整合实验表征、理论计算模拟与文献挖掘多维度数据,结合迁移学习算法解决新型前沿材料数据集稀缺的行业难题,有效提升机器学习模型的泛化能力与预测精度,适配小样本、低数据体系的研究场景。
第二,深度学习与智能表征技术:基于CNN、RNN及图神经网络(GNN)等主流深度学习算法,自动提取、学习分子与晶体材料的微观结构特征,替代传统人工特征筛选方式,显著提升材料构效关系的挖掘效率与准确性。
第三,生成模型与材料逆向设计技术:依托GAN、VAE等生成式模型,打破传统材料正向研发的局限,可基于目标性能需求反向推演最优分子结构与材料配比,实现功能材料的精准定向设计。
第四,主动学习优化技术:通过智能迭代筛选策略,自适应优选计算与实验方案,以最小化DFT计算量与实验成本为目标,最大化获取科研有效信息,显著缩短材料研发周期、降低算力消耗。
第五,可解释性AI技术:摒弃纯数据驱动的黑箱预测模式,融合量子化学、热力学等基础理论约束模型预测逻辑,揭示材料性能演变的微观物理化学机制,保障AI预测结果具备科学可解释性,契合机理研究与学术发表的核心要求。
未来,融合量子理论、统计力学与深度学习的交叉学科,会持续产出高影响力原创成果,无论是算法开发、材料应用还是工具软件研发,都蕴藏大量值得深耕的课题,是计算材料、理论化学研究者不可忽视的核心前沿赛道。













