

导语: 7月19日,阿里千问确认 Qwen3.8-Max-Preview 已经率先上线 Qoder、QoderWork 和 Token Plan,模型总参数达到 2.4T,并宣布正式版即将发布和开放权重。与此同时,DeepSeek 官方计划在7月24日停用 deepseek-chat 与 deepseek-reasoner 两个旧模型名,让 API 用户全面切换到 DeepSeek V4。两条消息放在一起看,国产大模型的竞争已经明显从“聊天回答得好不好”,转向超大规模模型、代码智能体、长程任务和低成本部署的综合较量。
Qwen 官方标识,图片来源:Qwen 官网
Qwen3.8真的已经来了,但目前仍是“可体验、难验证”
关于 Qwen3.8,当前能够确认的核心信息其实不复杂。
7月19日,阿里千问对外表示,Qwen3.8 即将正式发布并开放权重,总参数规模达到 2.4万亿。最强版本目前使用的名称是 Qwen3.8-Max-Preview,预览版已经首发上线阿里的 Token Plan、Qoder 和 QoderWork。换句话说,这并不是只存在于内部测试名单中的“传闻模型”,普通用户已经可以通过阿里的产品入口接触它,只是暂时还没有独立的公开 API 价格表和完整技术报告。
阿里的官方定位非常激进:Qwen3.8 被描述为当前最强大的模型之一,性能可与世界前沿模型相比,并称其“仅次于 Fable 5”。官方还提到,相比不久前上线的 Qwen3.7-Max,Qwen3.8-Max-Preview 在全栈开发、数据分析、Office 办公工作流,以及复杂的多智能体和长程任务中有明显提升。
这里最值得注意的并不是一句“仅次于谁”,而是阿里为什么选择 Qoder作为首发入口之一。
Qoder 并不是普通聊天机器人,而是面向真实软件工程的 Agentic 编码平台。它需要模型理解整个代码仓库,连续调用工具,修改多个文件,运行命令,读取报错,再根据结果继续修正。一个模型在聊天界面回答编程问题很漂亮,不代表它可以在几十轮工具调用中稳定完成任务。因此,Qwen3.8 首发进入 Qoder,本质上是在真实的软件工程工作流中接受压力测试。
这也说明 Qwen3.8 的目标可能不只是刷新几个数学或知识榜单,而是成为阿里下一代代码智能体、办公智能体和企业智能体的底层模型。
不过,必须给这轮热度踩一下刹车。截至目前,阿里还没有公布 Qwen3.8 的完整技术报告,也没有公布可以交叉验证的官方跑分表。外界尚不知道它采用纯稠密架构还是 MoE 混合专家架构,不知道每次推理实际激活多少参数,也不知道上下文长度、最大输出、训练数据规模和每百万 token 的独立 API 价格。
因此, 2.4T 是已经确认的总参数规模,但不能直接等同于每个 token 都要调用2.4T参数,更不能仅凭参数量判定它一定强于参数更小的模型。如果它采用 MoE 架构,真正决定推理成本的还包括激活参数、专家路由、显存通信和服务端并行效率。
DeepSeek V4不是“即将第一次发布”,7月24日真正发生的是接口换代
另一边,DeepSeek V4 的消息容易被误读。
DeepSeek 官方早在4月24日就已经上线并开源 V4 预览版,提供 DeepSeek-V4-Pro和 DeepSeek-V4-Flash两个版本,网页、App和API均已可以使用。此次临近7月24日,真正要发生的变化是旧模型名退出历史舞台。
DeepSeek 官方文档明确写明:deepseek-chat 和 deepseek-reasoner 将在北京时间 2026年7月24日23时59分停止使用。在过渡期内,这两个旧名称实际上已经分别指向 DeepSeek-V4-Flash 的非思考模式和思考模式。开发者需要把模型名改为 deepseek-v4-flash 或 deepseek-v4-pro。
所以,把7月24日称为“DeepSeek V4正式版发布日”并不完全准确。更准确的说法是: DeepSeek将结束兼容过渡期,API体系全面进入V4时代。
当然,这个节点仍然很有意义。旧接口名停用,意味着 DeepSeek 不再把 V4 藏在兼容层后面,而是要求开发者明确选择 Flash 或 Pro。这通常代表模型服务、价格体系、并发限制和工程生态已经趋于稳定。近期 DeepSeek 在 Hugging Face 上持续更新技术报告,也进一步增强了外界对V4进入成熟阶段的判断。
2.4T对1.6T,两家模型的体量应该怎么理解?
项目 | Qwen3.8-Max-Preview | DeepSeek-V4-Pro | DeepSeek-V4-Flash |
--- | ---: | ---: | ---: |
总参数 | 2.4T | 1.6T | 284B |
激活参数 | 官方未公布 | 49B | 13B |
架构 | 官方未公布 | MoE | MoE |
上下文长度 | 官方未公布 | 1M tokens | 1M tokens |
最大输出 | 官方未公布 | 384K tokens | 384K tokens |
训练数据 | 官方未公布 | 超过32T tokens | 超过32T tokens |
当前状态 | Qoder等平台预览 | 已开源、API可用 | 已开源、API可用 |
从总参数看,Qwen3.8 的2.4T确实超过DeepSeek-V4-Pro的1.6T。但DeepSeek公布了49B激活参数,也就是说在MoE架构下,每次处理token只激活模型的一部分专家。Qwen3.8如果同样采用MoE,必须等官方公布激活参数后,才能判断它的真实推理成本。
对于普通个人用户来说,这两款旗舰模型都不是“买一张显卡就能在本地跑”的级别。即使权重开放,完整部署也需要大型服务器集群、高速互联和成熟的分布式推理框架。所谓开源或开放权重,更大的价值是允许云厂商、科研机构和大型企业进行私有化部署、量化和二次开发,而不是让普通电脑直接运行完整版。
跑分对比:Qwen3.8目前没有公开数字,DeepSeek V4已经给出完整答卷
当前网络上最容易出现的误导,是把 Qwen3.7、Qwen3-Max 或其他模型的跑分图,改个标题就当成 Qwen3.8 的成绩。
截至本文整理时,阿里只公布了内部真实任务中的定性描述, 没有公布Qwen3.8的正式数值跑分。因此,目前无法负责任地给出 Qwen3.8 在 SWE-bench、LiveCodeBench、GPQA 或 AIME 等榜单上的具体分数。任何精确到小数点的“Qwen3.8跑分表”,如果没有来自阿里官方技术报告或独立评测机构,都应该谨慎看待。
DeepSeek V4则不同。其官方模型卡和技术报告已经公布较完整的评测数据。以推理预算最高的 DeepSeek-V4-Pro-Max 为例:
评测项目 | DeepSeek-V4-Pro-Max成绩 | 主要考察能力 |
--- | ---: | --- |
LiveCodeBench | 93.5 | 新鲜代码题与编程推理 |
Codeforces | 3206 Rating | 竞赛编程能力 |
SWE-bench Verified | 80.6% | 修复真实GitHub问题 |
SWE-bench Pro | 55.4% | 更困难的软件工程任务 |
Terminal Bench 2.0 | 67.9% | 终端操作与Agent执行 |
BrowseComp | 83.4% | 网页搜索和信息整合 |
GPQA Diamond | 90.1% | 高难度科学推理 |
MMLU-Pro | 87.5% | 综合知识与复杂推理 |
MRCR 1M | 83.5 | 百万上下文信息检索 |
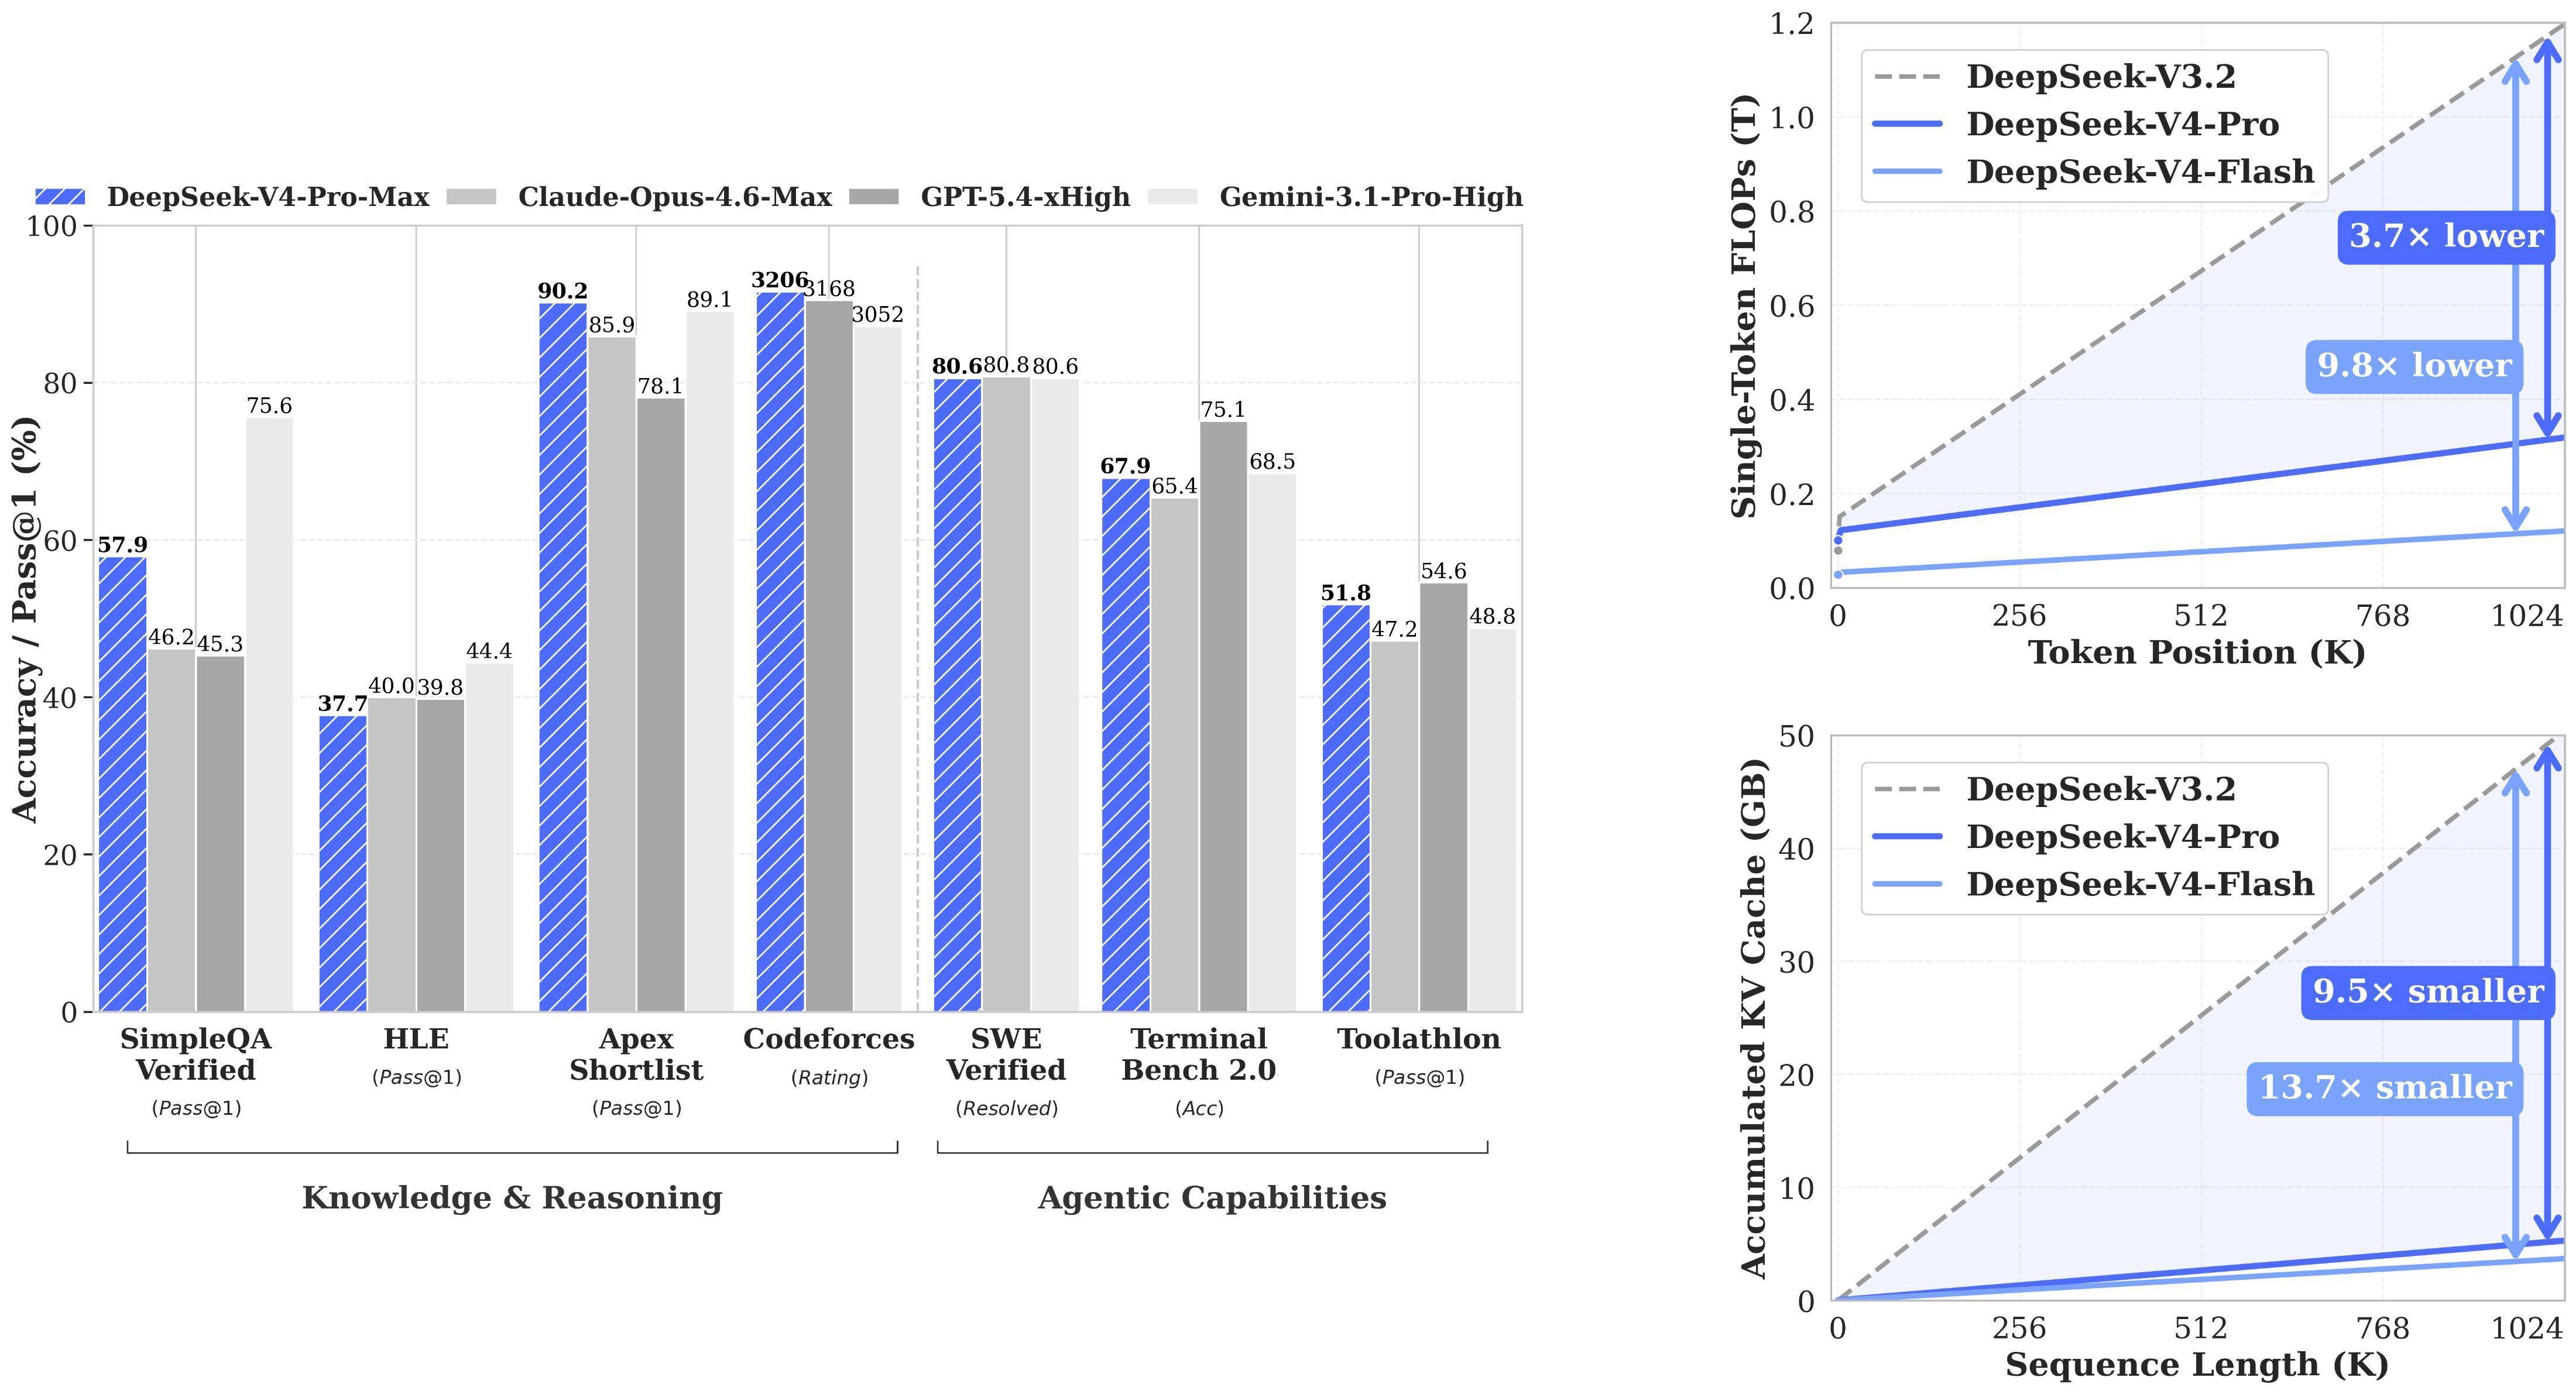
DeepSeek V4官方性能与长上下文效率图,来源:DeepSeek官方模型仓库
这些成绩说明,DeepSeek V4的优势并不只是知识问答。它在代码竞赛、真实软件修复、终端智能体和长上下文任务中都达到了当前开源模型的第一梯队。
当然,官方跑分也不能完全替代真实使用。不同模型可能采用不同推理预算、工具环境和采样参数,高推理模式往往意味着更长响应时间和更高token消耗。对开发者而言,最有意义的测试仍然是把同一个真实项目、相同工具权限和相同时间预算交给不同模型,看谁能稳定交付可运行结果。
DeepSeek把价格压到了什么程度?
DeepSeek已经给出了非常清晰的API价格。按每百万token计算:
模型 | 缓存命中输入 | 缓存未命中输入 | 输出 |
--- | ---: | ---: | ---: |
V4-Flash | 0.02元 | 1元 | 2元 |
V4-Pro | 0.025元 | 3元 | 6元 |
两个版本都支持1M上下文、思考与非思考模式,以及工具调用。V4-Flash并发限制更高,更适合大量日常请求;V4-Pro更适合复杂代码、研究、规划和高难度智能体任务。
真正的竞争已经从“模型榜单”转向“Agent交付”
Qwen3.8和DeepSeek V4代表了两种非常有中国特色、但路线不同的竞争方式。
阿里的优势是产品和云生态。Qwen3.8可以快速进入Qoder、QoderWork、Token Plan、企业办公和阿里云服务,在真实用户任务中积累反馈。模型不只是API,而是直接嵌入软件开发、数据分析和企业流程。
DeepSeek的优势则是架构效率、透明技术报告、开放权重和极低API价格。V4-Pro用1.6T总参数、49B激活参数冲击顶级能力,V4-Flash则用284B总参数、13B激活参数承担高并发和低成本任务。它的目标是让开发者可以根据任务难度选择不同档位,而不是所有请求都调用最昂贵的模型。
未来真正决定胜负的,不会只是某个榜单高一两分,而是以下几个问题:
第一,模型能否在几十轮甚至上百轮工具调用后仍然保持目标一致;第二,能否理解大型代码库和复杂企业文档;第三,推理成本能否支持大规模商业使用;第四,开放权重之后,第三方能否顺利部署和优化;第五,模型能否形成稳定、可控、可审计的Agent工作流。
接下来最值得关注的五件事
Qwen3.8正式版发布后,首先要看阿里是否公布完整技术报告和跑分表。其次要看其架构与激活参数,2.4T到底意味着多大的真实推理负担。第三要看上下文长度和最大输出,是否达到百万token级别。第四要看开放权重的具体时间、许可证以及第三方部署要求。第五则是Qoder用户的真实反馈:它能不能在大型项目中稳定完成跨文件修改、测试和修复,而不是只在演示任务中表现出色。
DeepSeek方面,7月24日旧接口名停用后,开发者要重点检查现有应用是否已经切换到新模型名。同时,也要关注V4技术报告和模型权重是否继续更新,以及Flash和Pro在真实Agent任务中的成本差距。
结语
Qwen3.8的出现,说明国产旗舰模型已经正式进入多万亿参数时代;DeepSeek V4完成API换代,则说明低成本、百万上下文和Agent能力正在成为新一代基础设施的标准配置。
但越是在模型发布密集期,越需要区分三个层次:厂商定位、官方跑分和独立实测。Qwen3.8目前已经确认上线预览,但跑分和架构仍待公布;DeepSeek V4已经有公开技术数据,但“7月24日正式发布”的说法需要修正为旧接口停止兼容。
下一轮竞争,不是谁更会在聊天窗口里写一首诗,而是谁能真正进入代码仓库、企业系统和复杂工作流,把一件需要人类数小时甚至数天完成的任务稳定交付。
公开资料来源
- 阿里千问Qwen3.8大模型正式版即将发布并开源|第一财经
- 阿里千问Qwen3.8预览版模型上线|IT之家
- Qoder产品概述
- DeepSeek-V4预览版官方公告
- DeepSeek模型与API价格
- DeepSeek-V4-Pro官方模型卡与评测
编辑提醒: Qwen3.8尚未公布完整跑分,本文没有使用来源不明的Qwen3.8数字成绩。涉及“仅次于Fable 5”等表述均为阿里方面的官方定位,不代表独立评测结论。













