

导读
七月的模型更新表像被按下了加速键。7月16日,Kimi K3发布;更早一些,千问Qwen3.7与GLM-5.2也陆续进入公众视野。新闻里最显眼的是参数和榜单,普通读者真正遇到的变化却在另一处:长材料、图片、工具和多步骤任务,开始被放进同一条工作线。选择突然多了,我们该怎样挑,又该把什么牢牢留在自己手里?
Part.1
榜单之外,能力正在汇合
过去谈大模型,常常先问“它知道多少”。最近这一轮国产模型更新,重点已经悄悄移向“它能把一件事做多久、接多远”。Kimi K3把原生视觉、百万级上下文和长任务能力放在一起;千问Qwen3.7系列继续向多模态、工具调用和智能体式工作推进;GLM-5.2则把长上下文与长时间任务作为核心方向。三条路线并不相同,却指向同一种变化:模型不再只等一句提问,而是尝试接住一段更完整的工作过程。
这件事对读者的影响,比跑分更具体。读一份几百页的行业报告,可以先让模型定位与问题相关的章节,再回到原文精读;面对图表、扫描页和文字混在一起的材料,可以让它先辨认信息之间的关系;准备一份专题资料时,也可以把检索、比较、提纲和初稿串起来,少在多个窗口之间反复搬运。
但“能接住”不等于“不会掉”。上下文再长,也可能漏掉角落里的限定词;工具调用再顺,也可能沿着一个错误前提连续走很多步。任务被拉长以后,错误同样会被拉长。因此,真正有用的不是把整项工作一次性交出去,而是在关键节点停一下:它用了哪些材料?哪一步是原文事实,哪一步是模型推断?能否给出页码、段落或原始链接?长任务需要的不是盲目信任,而是更多可检查的接口。
Part.2
选择多了,先问任务是什么
模型密集上新,很容易制造一种新的焦虑:是不是必须马上换到“最强”的那个?事实上,模型能力越来越像一只工具箱。有人擅长处理长材料,有人更适合图片和视频,有人在代码与工具协作上更成熟,也有人在响应速度、使用成本或本地部署上更合适。离开具体任务谈“唯一最强”,往往只会把选择变成追榜单。
一位读者要梳理三十篇期刊论文,首先需要的是长文理解、引用定位和稳定的结构化输出;要分析一组老照片或展览资料,多模态理解更重要;要写一段程序处理馆藏数据,则要看模型能否使用开发工具、反复测试并修正。问题不同,合适的模型也可能不同。与其记住一串不断过期的名次,不如先把任务说清楚:材料有多长,是否包含图片,结果要不要引用来源,哪些步骤必须由人确认。
国产模型的密集进步,还带来一个以前不那么明显的好处:读者可以比较。过去只有一两个入口时,模型给出的答案很容易被当成答案本身;现在可以让不同模型处理同一小段材料,观察它们在哪些地方一致,在哪些地方分歧。分歧不是麻烦,而是提醒——这里可能存在概念含混、证据不足,或者提问方式本身有问题。
当然,比较也不必变成无休止的“模型赛马”。查一个概念、润色一段通知、整理一次会议记录,用手边顺手的工具即可;只有当结论会影响研究、决策或公开发布时,才值得增加交叉验证。好的选择不是每次都调用最昂贵、最复杂的模型,而是让任务的重要程度决定投入多少时间和算力。
Part.3
工具更近,核验不能更远
能力越强,回答通常越完整、越像一份可以直接使用的成品。这恰恰是最需要警惕的时刻。流畅会掩盖不确定,完整的段落也可能建立在一条错误引用上。尤其在健康、法律、金融、政策和学术写作中,模型可以帮助我们找到问题,却不能替我们确认事实,更不能替最终发布者承担责任。
最朴素的做法仍然有效:要求模型区分“原文明确写到”“根据材料推断”和“尚无依据”;引用论文时核对作者、刊名、年份、卷期和页码;遇到最新政策与产品信息,回到发布机构的官方网站;看到特别肯定却没有来源的结论,多问一句“证据在哪里”。图书馆的数据库、馆藏期刊和参考咨询,在模型时代不是变远了,而是成了判断答案是否可靠的锚点。
隐私和版权也不能被“开源”两个字轻轻带过。模型权重开放,不等于训练数据、上传材料和生成内容都可以不受限制地使用。未公开合同、读者借阅记录、个人身份信息和单位内部资料,不应在不了解平台规则时随意上传;让模型改写文章,也不能抹去原作者的权利。工具可以承担重复劳动,边界仍需由人划定。
这一轮国产大模型的爆发,真正值得高兴的,不只是榜单上出现更多中国名字,而是普通人开始拥有更丰富、更贴近本土使用环境的选择。模型会继续更新,今天的名次也会很快变化。不会迅速过期的能力,是把问题说明白、把来源找回来、在该停下核验时停下。工具箱变大以后,人的判断不是变轻了,而是终于可以放到更重要的位置。
Part.4
如果想把这轮更新放进更长的产业、治理与图书馆转型脉络中,下面三篇文章分别提供了应用、合规和服务重构三个入口。
1 《中关村》2026年第02期
本刊推荐文章:《中国大模型:从技术突围到全球竞逐“降本增效”之路》。文章把国产大模型从实验室走向千行百业的过程放进产业竞争中观察,适合补足产品发布之外的应用视角。
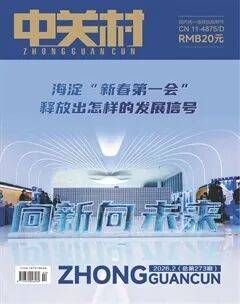
扫码阅读
2 《人民论坛》2026年第06期
本刊推荐文章:《开源人工智能训练数据的合规治理》。文章辨析算法开源与数据开放的不同法律边界,提醒读者不要把“开源”误解为数据可以任意获取和使用。
扫码阅读
3 《农业图书情报学报》2026年第04期
本刊推荐文章:《智能体时代的图书馆转型:基于OpenClaw架构的服务重构与治理框架研究》。文章从任务规划、工具调用与治理责任出发,讨论图书馆怎样面对从对话生成走向自主执行的智能体。
扫码阅读











