

把视频里的歌声保存成音频,是很多用户在听现场返场、翻唱片段、MV 或直播回放时的共同需求:有人想存一段副歌当手机铃声,有人要把音轨丢进剪辑软件再做卡点,也有人只想留一份纯音频反复听。搜索「歌声提取成音频」时,结果里往往混着「视频转 MP3」「AI 去伴奏」「人声分离」几套说法,容易让人误以为它们是同一件事。本文按「先判断需求、再选对工具」的顺序,讲清整轨抽取与干声分离的区别、各自的操作步骤,以及每种工具真实的能力边界,帮你少走弯路、避免在错误的导出参数上反复尝试。
先分清需求:要整首歌的音频,还是要纯人声与伴奏
动手之前,请先用半分钟确认目标,这一步决定了后面该走哪条路线。歌声提取在技术上分成两个完全不同的层级,混为一谈是新手最常见的误区。
整轨类:要整首歌的音频(整轨 mp3)。你想要的是「和视频里听到的一模一样」的声音——歌声、伴奏、掌声、混响原样保留,只是把它从视频容器里单独拿出来存成 mp3 或 wav。存铃声、做听稿、把音轨导进编曲软件继续处理,都属于这一类。这类需求用抽轨工具即可完成,剪映导出音频、提词匠小程序的「视频转 MP3」都能做到。
分离类:只要人声或只要伴奏(干声分离)。比如一段翻唱里人声和背景音乐已经混成一条音轨,你想单独拿到干净的人声去做二次创作,或者只要伴奏做卡拉 OK。这类需求属于「人声分离」范畴,普通的转 mp3 去不掉伴奏,必须交给专门的分离工具用模型去拆分音轨。
判断口径很简单:能接受背景音乐、环境声都在,就走整轨抽取;一定要把人声和伴奏拆开,才需要分离工具。如果你只是要整首歌的音频,直接看下面两个整轨方案就够,不必在分离工具上折腾。
方案一:剪映时间线导出整轨音频
当素材还要裁片头、掐副歌起止,或者你本来就在剪映里剪片子,直接在时间线上导出音频最顺手。剪映导出的是整轨音频,不会去伴奏,适合「要裁一段再导出」的场景。如果不需要裁剪、人也不在电脑前,同样的整轨导出用下面的提词匠会更快落地。
步骤 1:新建项目并导入视频。打开剪映,点「开始创作」,把本地录屏或 MV 片段拖进媒体库,再拖到主时间线。若只要某一段副歌,先用分割工具裁掉入点和出点,避免导出文件带着多余的前后空白。
步骤 2:分离音视频(按需)。选中片段后使用「分离音频」,时间线会出现独立的音频轨,方便你单独裁剪、静音或删除某一段。若只是整轨导出、不动画面,这一步可以跳过。
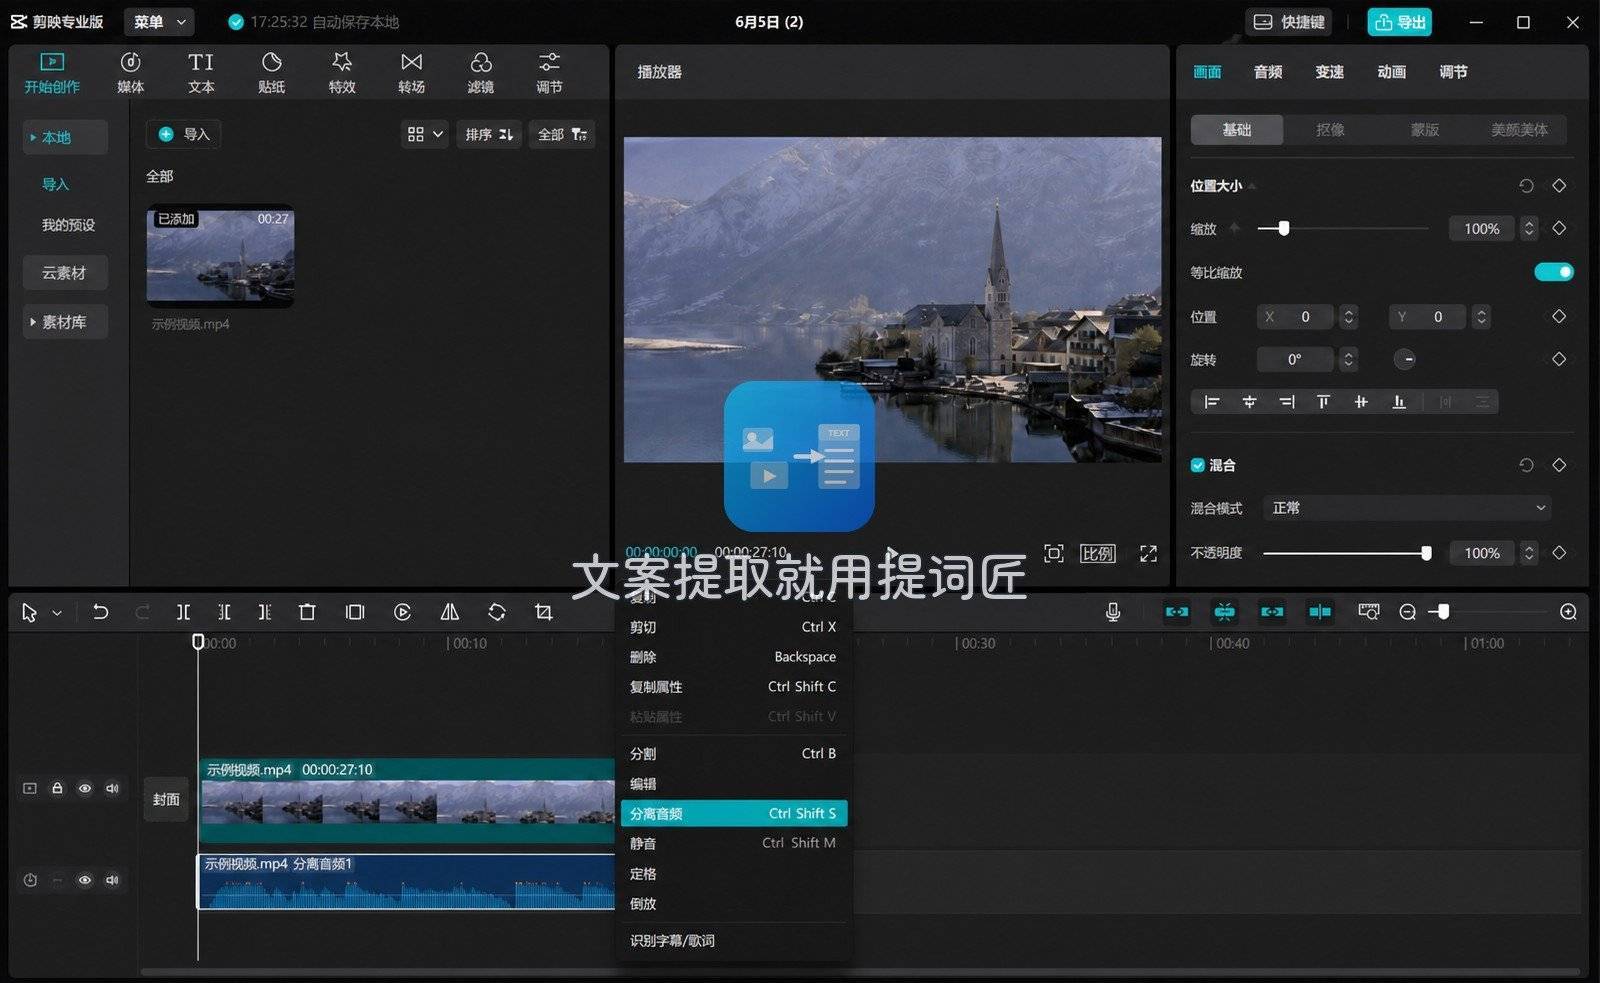
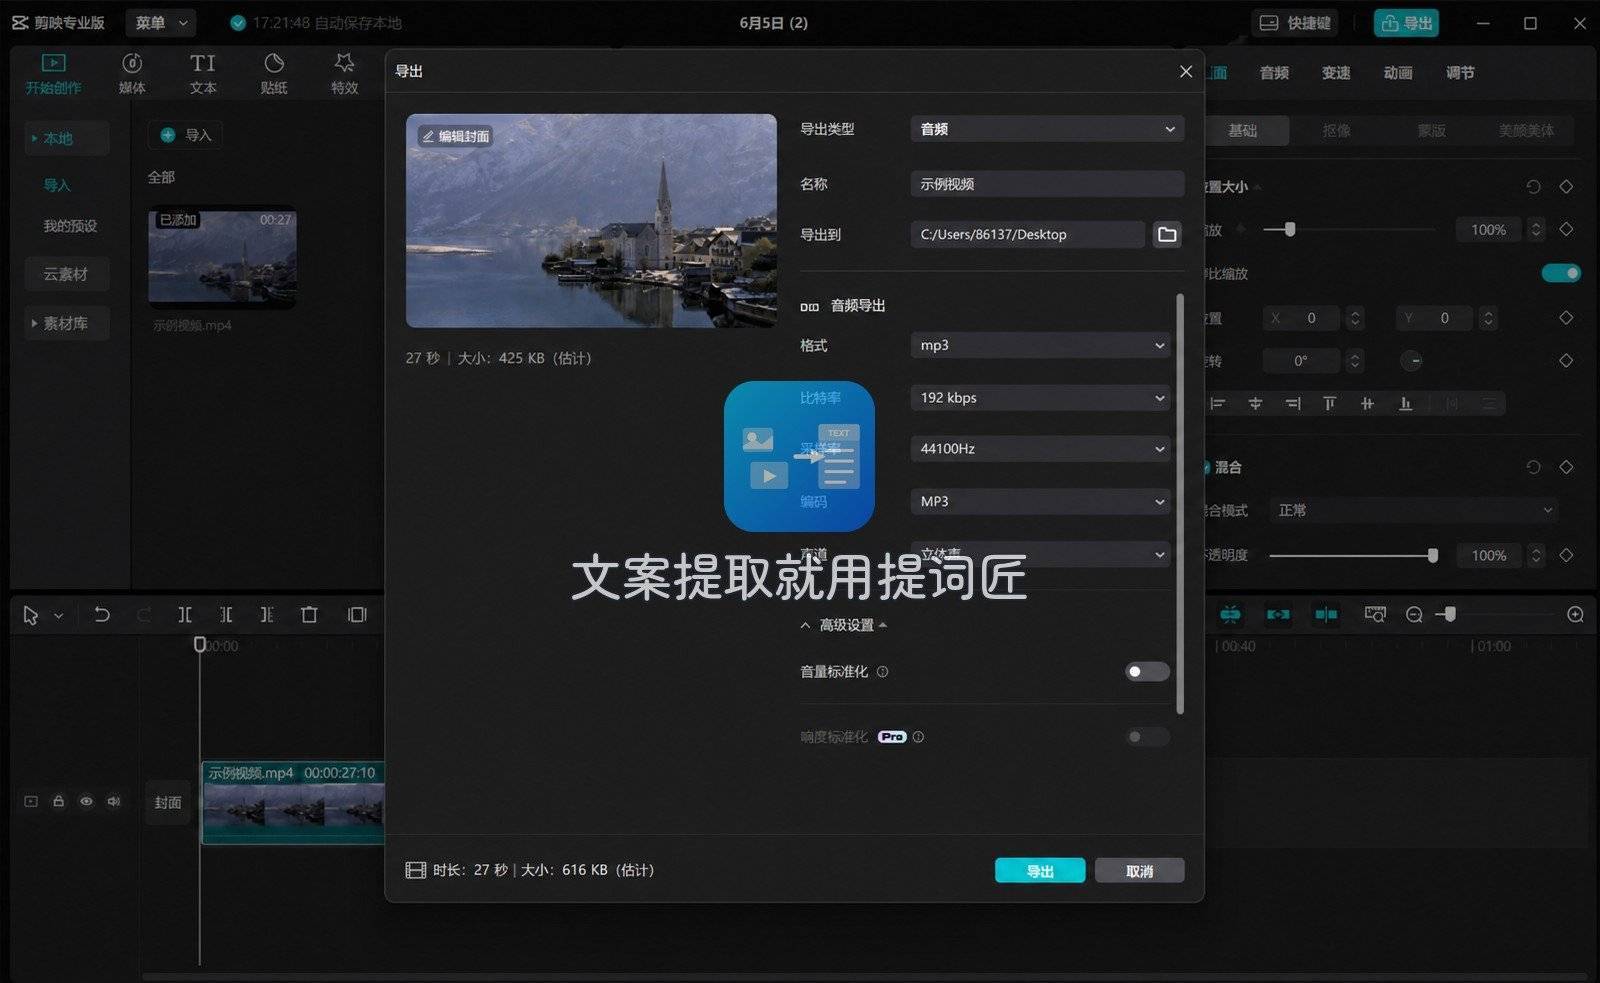
步骤 3:导出为音频格式。点右上角「导出」,在格式里选「音频」而不是默认的视频。比特率按用途调整:铃声、听稿选 128kbps 通常够用;要进编曲软件再处理,可选 192kbps 或更高。确认保存路径后执行导出。
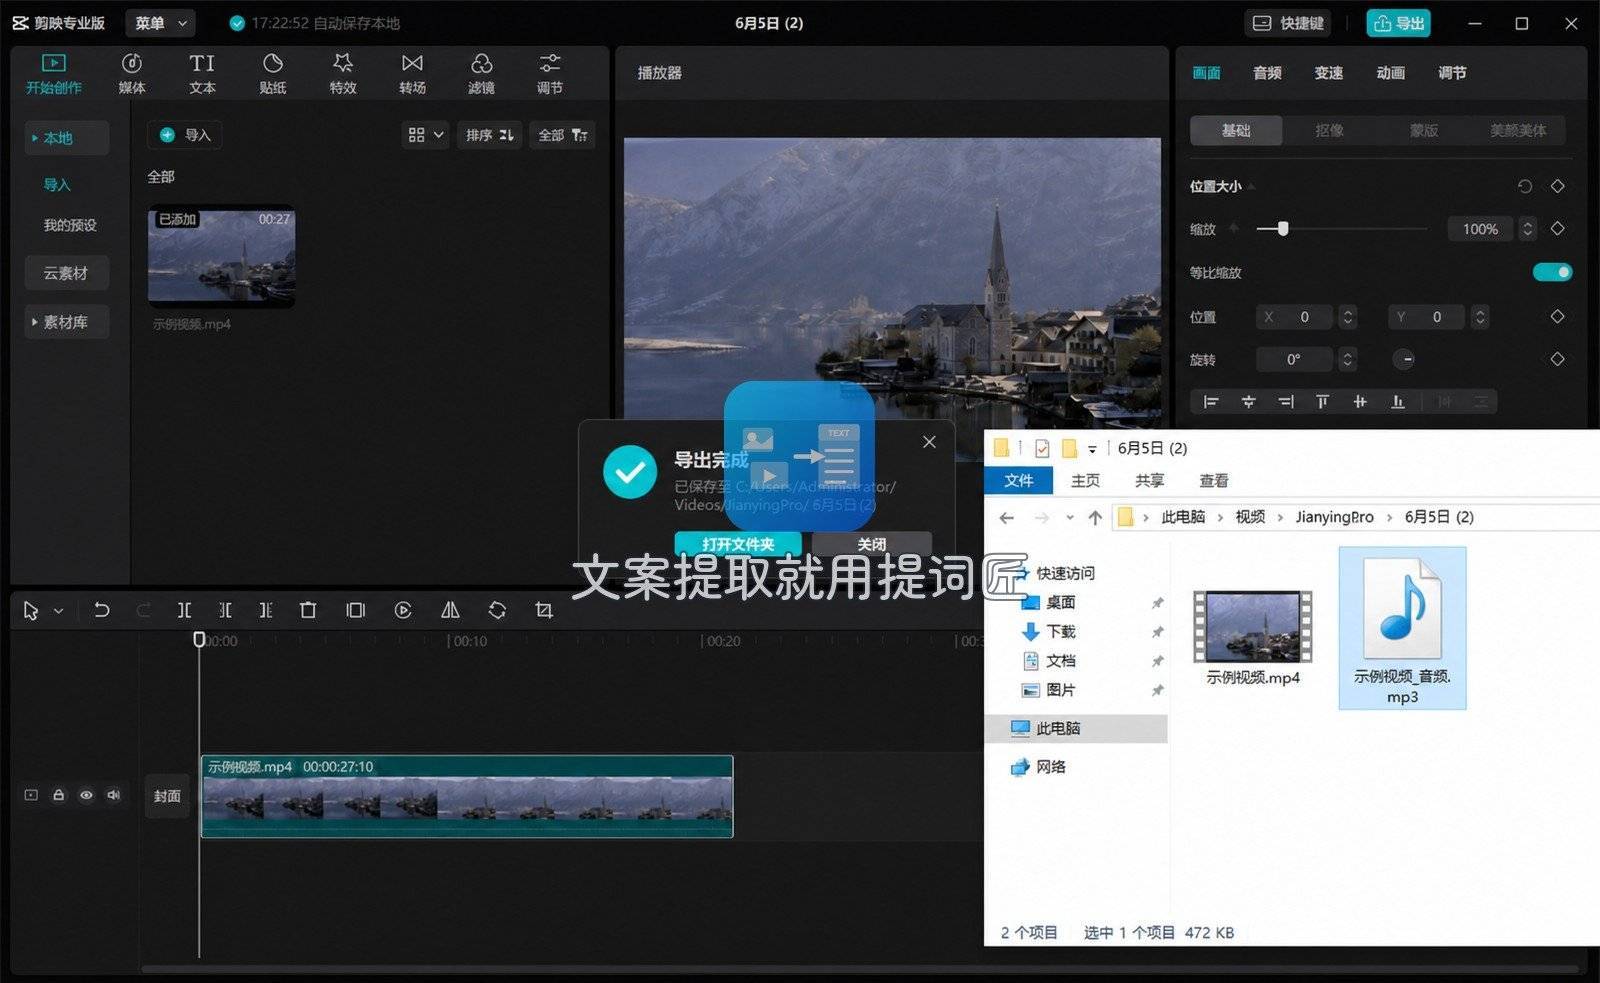
步骤 4:试听检查。导出完成后用系统播放器听一遍首尾,确认没有截断、没有误选静音段。请记住这一步得到的是整轨音频,歌声和伴奏仍在同一条轨里。
方案二:提词匠小程序整轨转 MP3
如果人不在电脑前,或只有一两段素材、不值得专门开剪映,可以用提词匠小程序里的「视频转 MP3」做整轨转码。它的定位是手机端的旁路工具:上传本地视频,云端转码,导出 mp3,全程不用装客户端。
使用前请先了解它真实的能力边界,避免预期错位:需要联网;按次计费(约 2 积分一次,实际以页面显示为准);只支持上传本地视频,不是粘贴链接解析;产出为整轨 mp3,不做 AI 人声分离,也不提取伴奏。把演唱会录屏传进去,得到的音频里歌声和现场伴奏仍在同一条轨上——这是它的设计定位,不是功能缺陷。需要干声时,请先用它或剪映拿到整轨,再交给下文的分离工具。
步骤 1:从首页进入功能入口。在小程序首页的「常用工具」里找到「视频转 MP3」,点进去先查看支持的格式与文件大小限制。
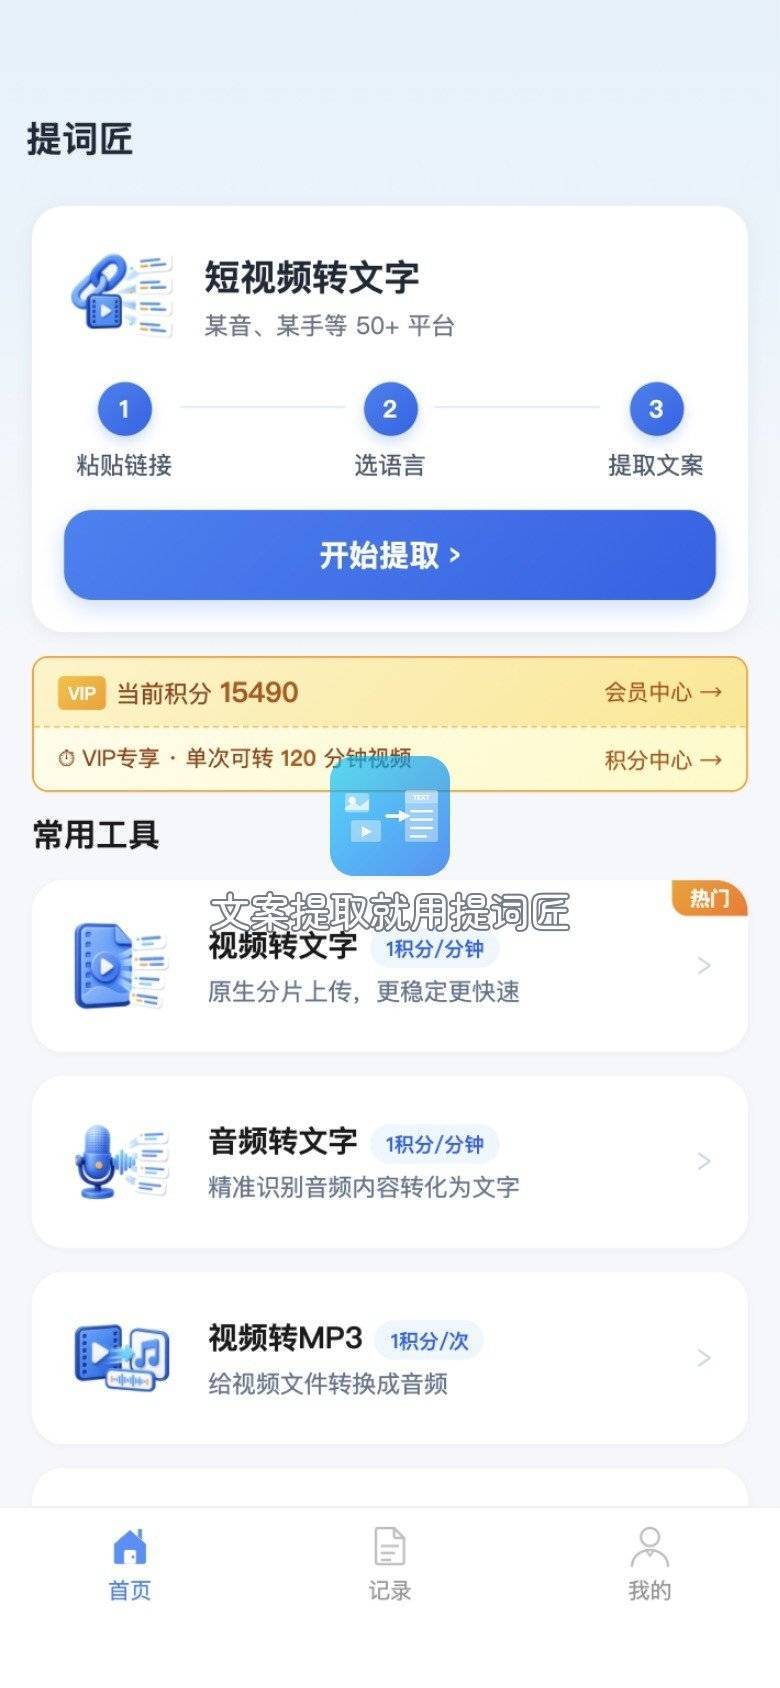
步骤 2:选择本地视频。点上传,从相册或文件管理器里选中 mp4 等文件。这一步是选文件,不是处理界面;如果找不到文件,检查一下相册或存储权限。
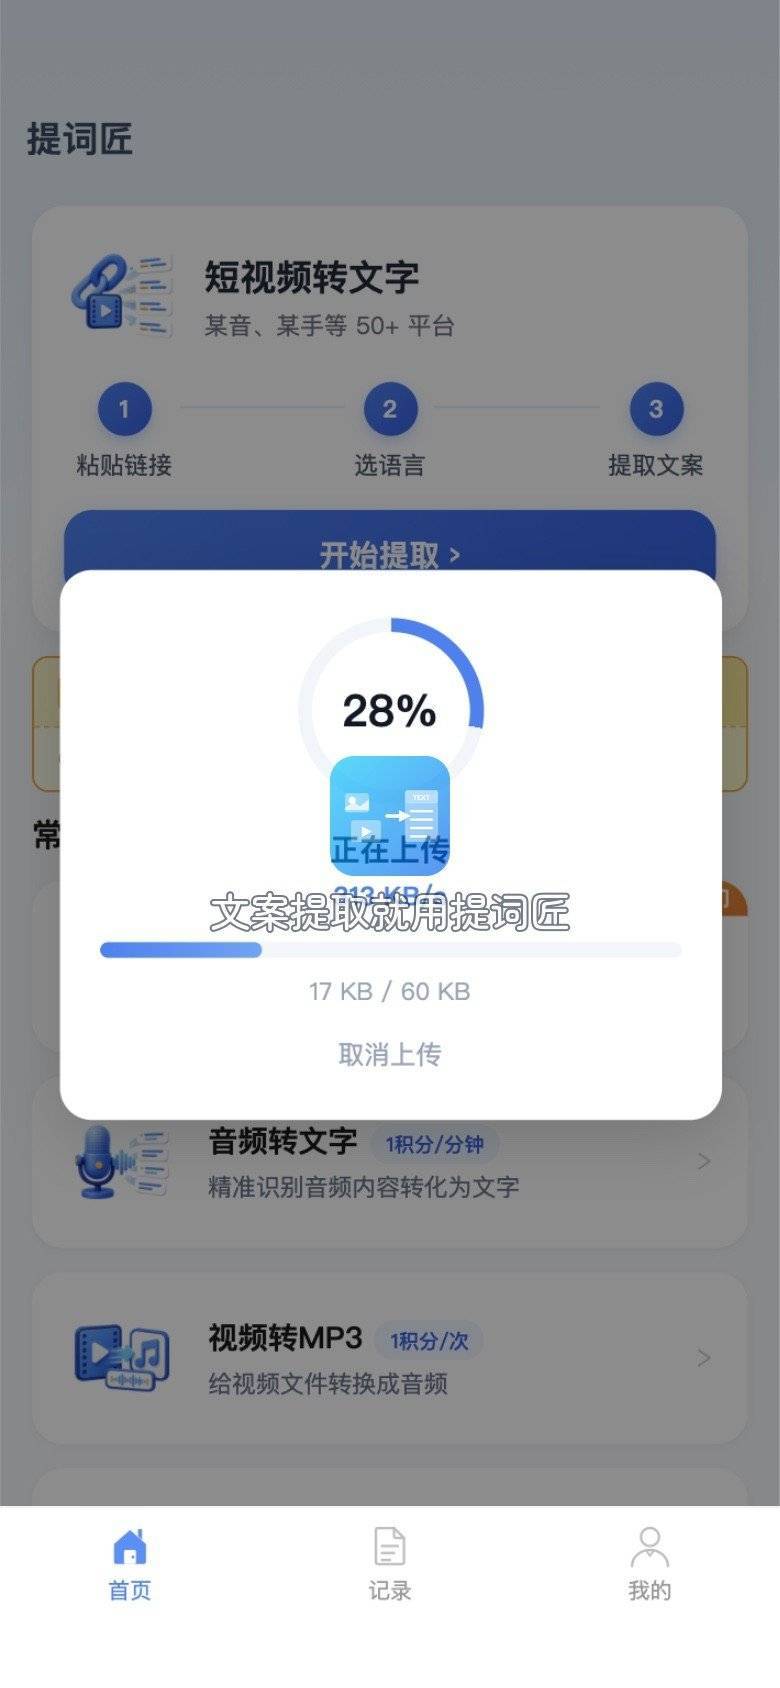
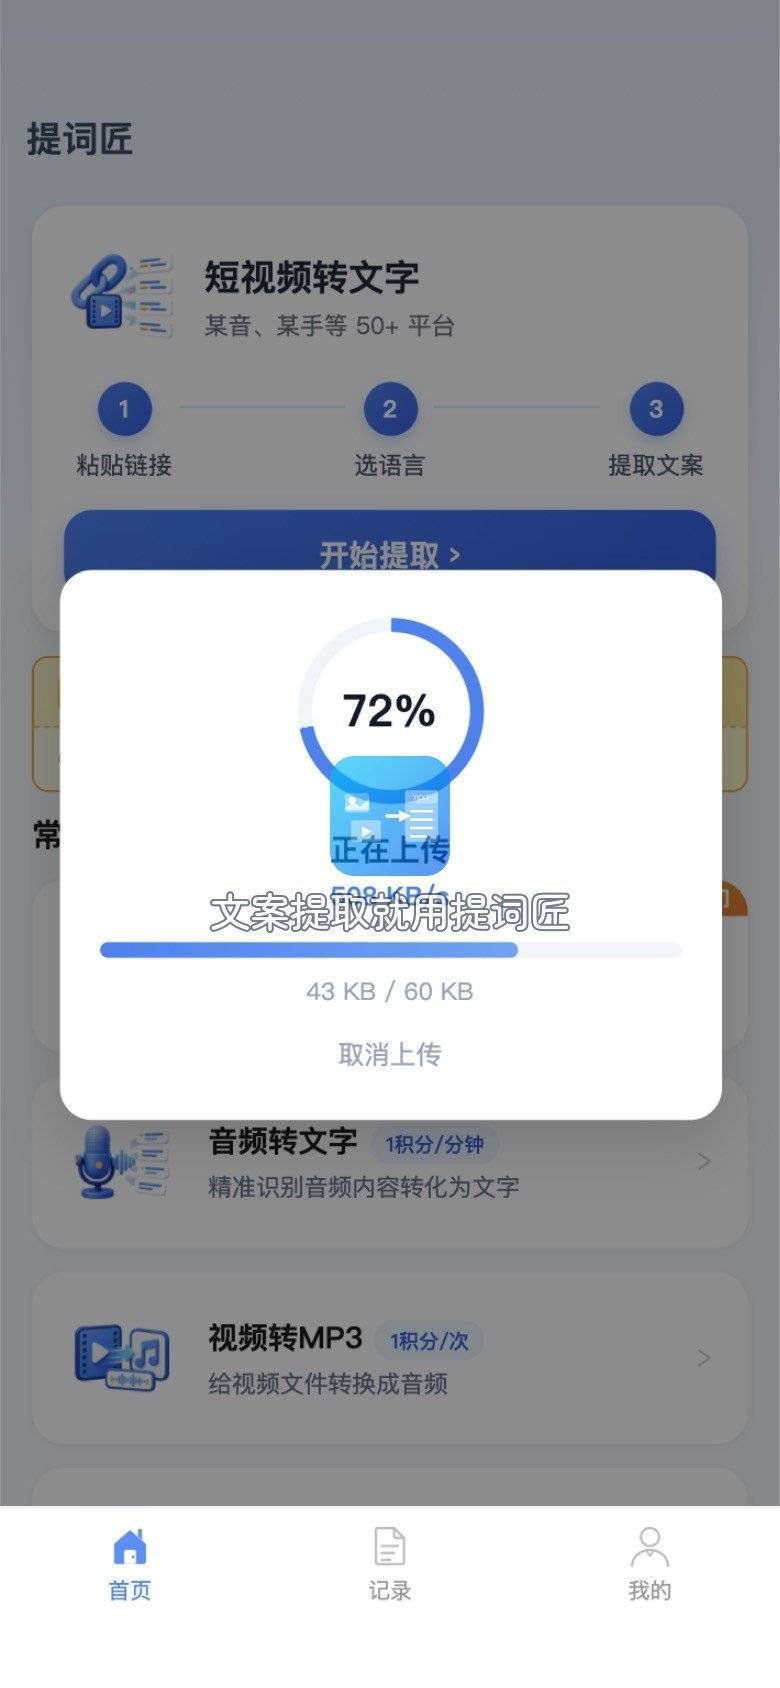
步骤 3:等待转换进度。上传完成后会显示进度条,文件越大等待越久。建议保持网络稳定,避免长时间切后台导致中断。
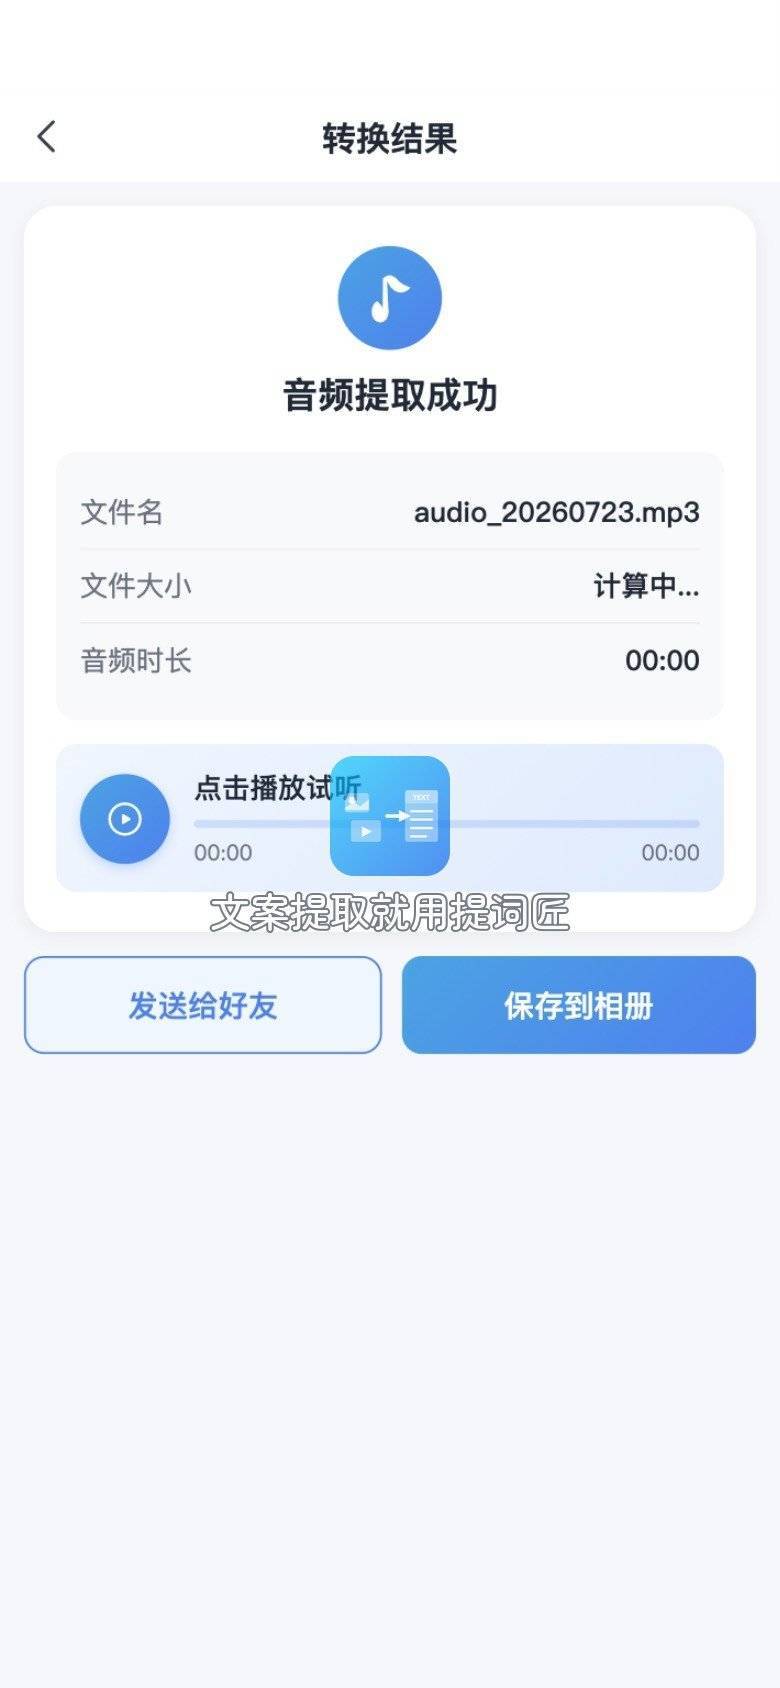
步骤 4:在结果页保存 mp3。转换完成后进入结果页,可以先试听,再导出到手机本地,随后通过隔空投送或网盘传到电脑。建议转完顺手另存一份,别只留在小程序缓存里。
需要干声或伴奏分离时:第三方专项工具的通用流程
如果整轨 mp3 里仍混着伴奏,而你只要歌声或只要器乐,就得换用专门的 AI 人声分离工具。这类工具的输入通常是已经混好的音频(可以是上面剪映或提词匠导出的 mp3),由模型估计人声轨和伴奏轨再分别输出。下面以开源桌面工具 Ultimate Vocal Remover(UVR)为例说明通用流程,仅作客观示范,不代表推荐、也不是只能用它;在线分离服务、编曲软件插件的逻辑大同小异,都是「导入混音 → 选分离模型 → 导出多轨」。
通用流程大致是:
1. 准备输入:优先用高质量 mp3 或 wav,避免多次有损转码
2. 选择分离模型:多数工具提供「人声 / 伴奏」两轨模型
3. 执行分离:等待运算,输出 vocals(人声)与 instrumental(伴奏)
4. 试听微调:现场录音常有残留,必要时再降噪处理
需要说明的是,分离效果取决于模型、源素材录音质量和混音复杂度。现场大混响、观众喊声的素材,分离后常有残留或相位感,属于正常现象,不要指望「一键得到录音棚级干声」。这类工具处理的是已有混音,不吃「视频容器直出」,因此它替代不了上面的整轨抽取,两者是接力关系而非二选一。
三种路线对照
使用边界与版权提醒
从视频里提取歌声涉及著作权与邻接权。个人学习、私人备份、练耳在合理范围内风险通常较低,但把提取出的音频公开传播、商用或二次发行(上传平台、做铃声售卖、未授权二次创作发布等)可能构成侵权。演唱会官方录播、MV、他人翻唱作品,即使是你自己录屏得到,也不当然等于你拥有可自由使用的权利。建议只处理自有版权或已获授权的素材,并在发布前查清目标平台对「纯音频搬运」的规则。还要提醒一句,无论音频是用剪映还是提词匠抽出来的,版权归属都不会因为「抽取」这个动作而改变,可用范围仍以原素材授权为准。
结论与推荐组合
把整篇的判断收成一句:先问自己要整轨还是要干声。要整轨且需要裁剪,用剪映在时间线里导出;人在手机上、只要快速拿一段 mp3,用提词匠整轨转码;确实要把人声和伴奏拆开,再单开一个分离工具处理导出的音频。日常我们更常用的组合是提词匠负责手机端整轨抽取、剪映负责需要裁切时的导出,两者都不做人声分离——分清边界再动手,比反复更换导出格式高效得多。











