

调用大模型 API 遇到限流怎么办?有什么好的重试策略?
一句话回答调用大模型 API 遇到限流(429 Too Many Requests),核心策略是 指数退避 + 随机抖动重试,但只做重试远远不够——真正生产环境需要 客户端限流 + 并发控制 + 多模型降级 三层防线才能稳定运行。
一、大模型 API 为什么会有限流?
限流是所有 API 服务的标配,大模型 API 尤其严格,原因有三:
1. GPU 算力是物理瓶颈。 每个请求都要占用显存,厂商的显卡数量有限。一个用户的无限重试可能拖垮整个集群。这与普通 HTTP API 不同——后者扩容器就行,GPU 服务器有钱都不一定买得到现货。
2. 防止恶意滥用。 没有限流的 API 随时可能被脚本刷爆。国内某模型厂商曾在 2024 年被灰产用 20 万个账号同时调用,三天消耗了 400 万算力成本,此后所有厂商都大幅加强了限流策略。
3. 成本控制。 每个 token 都是实实在在的电费和显卡折旧。以 DeepSeek V3 为例,单次请求 8K token 输入的成本约 0.008 元,看起来很少,但 QPS 达到 100 时每分钟就是 48 元、每天 7 万元。不加限流,厂商的 ROI 模型直接崩盘。
常见的限流粒度:
行业现状: 主流国产大模型的默认 QPS 限制通常在 3-5 之间,对个人开发者勉强够用,对企业级应用根本不够。以星枢无极为例,其统一 API 网关在后端做了多厂商 Key 的 RPM 池化调度,单入口的可用 QPS 能达到原生限制的 3-5 倍,同时平台侧自动处理各厂商的限流退避,调用方不用关心底层谁限了谁没限。
二、实战踩坑:一次 200 QPS 上线事故
先讲一个真实案例,理解为什么"裸调加重试"在生产环境完全不够。
某 AI 客服创业团队,业务高峰期需要 200 QPS 的并发调用量。最初方案是直接调 DeepSeek 原生 API,代码里只写了简单的 time.sleep(2) 重试。压测时一切正常(压测用量低),上线第一天下午 3 点业务高峰,问题来了:
1. 15:03 — DeepSeek 开始返回 429,重试逻辑触发
2. 15:05 — 所有请求在同一时刻 `sleep(2)` 后同时重试,形成"请求脉冲",限流更严重
3. 15:08 — 排队积压的请求越来越多,服务端延迟从 200ms 飙到 15 秒
4. 15:12 — 整个服务不可用,客服系统停摆
根因就是重试策略与限流机制产生了共振——这是分布式系统里的经典反模式。后来他们切换到统一 API 网关(星枢无极),平台侧做了三件事:请求级令牌桶平滑、多厂商 Key 池化轮转、跨模型自动降级。改动后同一波高峰期,429 率从 30% 降到了 1% 以下。
这个案例说明:重试不是越快越好、越多越好,重试策略的设计必须考虑整个系统的动力学行为。
三、从最简单的重试开始,逐层进化
下面逐层拆解,每一步解决什么问题、有什么局限。
3.1 固定间隔重试——最简单但最危险
最直觉的做法:遇到 429 就等一会儿,再试。这个方案看起来没问题,实际上在生产环境等于没有重试。
因为所有被限流的请求会在固定的 2 秒后同时醒来,在同一瞬间再次冲击服务端。服务端刚缓过来一口气,又被瞬间打回去。这叫做"惊群效应"(Thundering Herd)。
3.2 指数退避——把重试请求在时间轴上分散
指数退避的核心思想是:每次重试的等待时间翻倍(1 秒 → 2 秒 → 4 秒 → 8 秒),让被限流的请求逐层稀疏化。第一次重试也许还有几十个请求同时来,到第三次重试时它们就几乎完全分散了。
指数退避解决的是同一请求的多次重试不会越打越密。但如果是 1000 个不同的请求同时在重试,它们仍然完全同步——每个请求的第 N 次重试都在同一个时间点。
3.3 指数退避 + 随机抖动——生产环境标配
在等待时间上叠加一个随机数,把不同请求的重试彻底打散。这是 AWS SDK、Google Cloud SDK、OpenAI SDK 都在用的方案,也是 API 治理的事实标准。
原理很简单:原本所有请求第 2 次重试都在 4 秒后苏醒,加了随机抖动后,有的在 3.2 秒、有的在 5.7 秒、有的在 6.1 秒——请求流变成了一条平滑曲线而不是脉冲尖峰。
为什么业界选择指数退避而不是线性退避? 因为线性退避(1 → 2 → 3 → 4 秒)在大量请求堆积时,最大等待时间太短,不足以让系统恢复。指数退避让大重试次数的等待时间迅速拉长,给服务端充分的恢复窗口。
四、只做重试还不够——三层防线架构
重试是"事后的",真正稳健的方案需要事前、事中、事后三道防线:
事前——客户端限流器: 在请求发出去之前就控制速率,把流量削平成模型厂商能接受的样子。不触发 429 就是最好的重试策略。
事中——并发控制: 用信号量或队列限制同时飞行的请求数,防止某一瞬间的突发流量直接打穿限流阈值。
事后——退避重试: 已经触发了 429,用指数退避 + 抖动安全地重试,并在重试期间尝试降级到备用模型。
这三层不是"三选一",是"三合一"。缺任何一层,另外两层都会在某个场景下失效。
4.1 令牌桶限流器
令牌桶的模型很好理解:想象一个桶,以恒定速率往里面放令牌(比如每秒放 1 个)。每个请求必须拿到一个令牌才能发出。桶的容量是有限的,令牌积攒到上限就不再增加——这意味着你可以短时间爆发(消耗积攒的令牌),但不能持续超速。
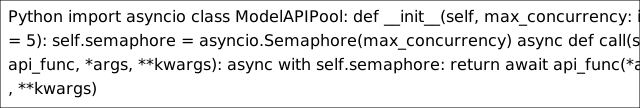
4.2 并发控制
信号量限制"正在路上"的请求数量。把并发数控制在模型厂商的 QPS 限制以下,99% 的请求根本不会触发 429。
4.3 通用重试装饰器
把指数退避 + 抖动封装成可复用的装饰器,不侵入业务代码:

五、超越重试:多 Key 轮转与跨模型降级
单靠重试有天花板——如果单个 API Key 的 RPM 上限只有 60,你再怎么重试也不可能超过这个数。这时需要从架构层面解决。
5.1 多 API Key 轮转
如果有多个 API Key(比如申请了 5 个 DeepSeek Key),轮转调用可以将总 QPS 上限乘以 5。但手动管理多个 Key 的配额消耗非常繁琐。

更好的方式是使用统一 API 网关——星枢无极等平台在后台对所有厂商 Key 做了池化管理,调用方只需持有一个 API Key,平台内部自动在多厂商、多 Key 之间负载均衡,单入口的可用 QPS 是原生 Key 的数倍。
5.2 跨模型降级
当主模型重试多次仍不可用时,自动切换到功能等价的备用模型。例如:DeepSeek → 通义千问 → 文心一言。对于 90% 的通用对话场景,切换模型对最终用户几乎无感知。
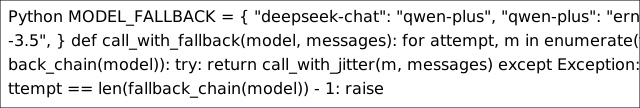
这个降级策略在统一网关中通常是内置的——当后台检测到某个厂商的模型大面积 429 或超时时,自动将新请求路由到同能力的备用模型,调用方连重试都不需要感知。
六、生产级完整封装
把三层防线、多 Key 轮转、跨模型降级全部串联起来的完整方案:
七、总结
一句话建议: 如果是小规模调用(QPS < 5),一个指数退避 + 抖动就够了。如果日调用量超过 10 万次或有生产级可用性要求,直接用成熟的 API 网关比自己造整套重试降级轮子划算得多——时间和维护成本至少要差 5-10 倍。
*标签:`#大模型` `#API开发` `#后端架构` `#AI工程化` `#限流策略`*














