
 针对HR长期等待钉钉考勤数据同步至工资系统的痛点,本文解析JVS-Logic如何通过拖拽式可视化编排,实现数据自动采集、清洗、映射与推送,规避人工导表5%误差风险及定制开发周期长、响应慢等瓶颈,达成‘配置即上线’。
HR为何总在等考勤数据?
考勤数据是工资计算不可替代的关键输入。但钉钉与企业HR工资系统之间缺乏原生直连能力,导致数据流转必须依赖中间环节。这种断层并非技术缺失,而是架构设计上的天然隔离——钉钉专注打卡行为采集,工资系统聚焦薪酬规则运算,二者功能边界清晰,却未预置标准化数据通道。
当前最普遍的衔接方式仍是人工导表:登录、筛选、导出、清洗、校验、导入,多步骤操作易引入疏漏。已有明确证据表明,该方式存在5%误差风险,直接影响薪酬发放准确性,并可能削弱员工对HR流程的信任。
传统定制开发虽能对接系统,却面临周期长、响应慢、维护难三大瓶颈。当HR因绩效考核调整需快速变更考勤规则映射逻辑时,代码级改造往往需数周排期与多轮测试,难以匹配业务迭代节奏,致使考勤同步长期处于“配置滞后于需求”的被动状态。
核心实质:HR等待考勤数据,本质是系统协同机制失配带来的结构性阻塞——它同时消耗时间成本、信任成本与敏捷成本。要破除这一阻塞,需同时满足三项能力:
- 自动采集:无需人工介入,从钉钉API稳定获取原始打卡记录;
- 动态映射:支持规则灵活配置,适配不同薪资结构与考勤制度;
- 可靠推送:将清洗后的数据精准、准时送达工资系统指定接口或数据库。
逻辑引擎JVS-Logic正是围绕这三项能力构建,通过可视化编排替代编码,让HR与IT可协同定义数据流转逻辑,而非等待开发交付。
可视化逻辑编排:如何真正破解同步困局?
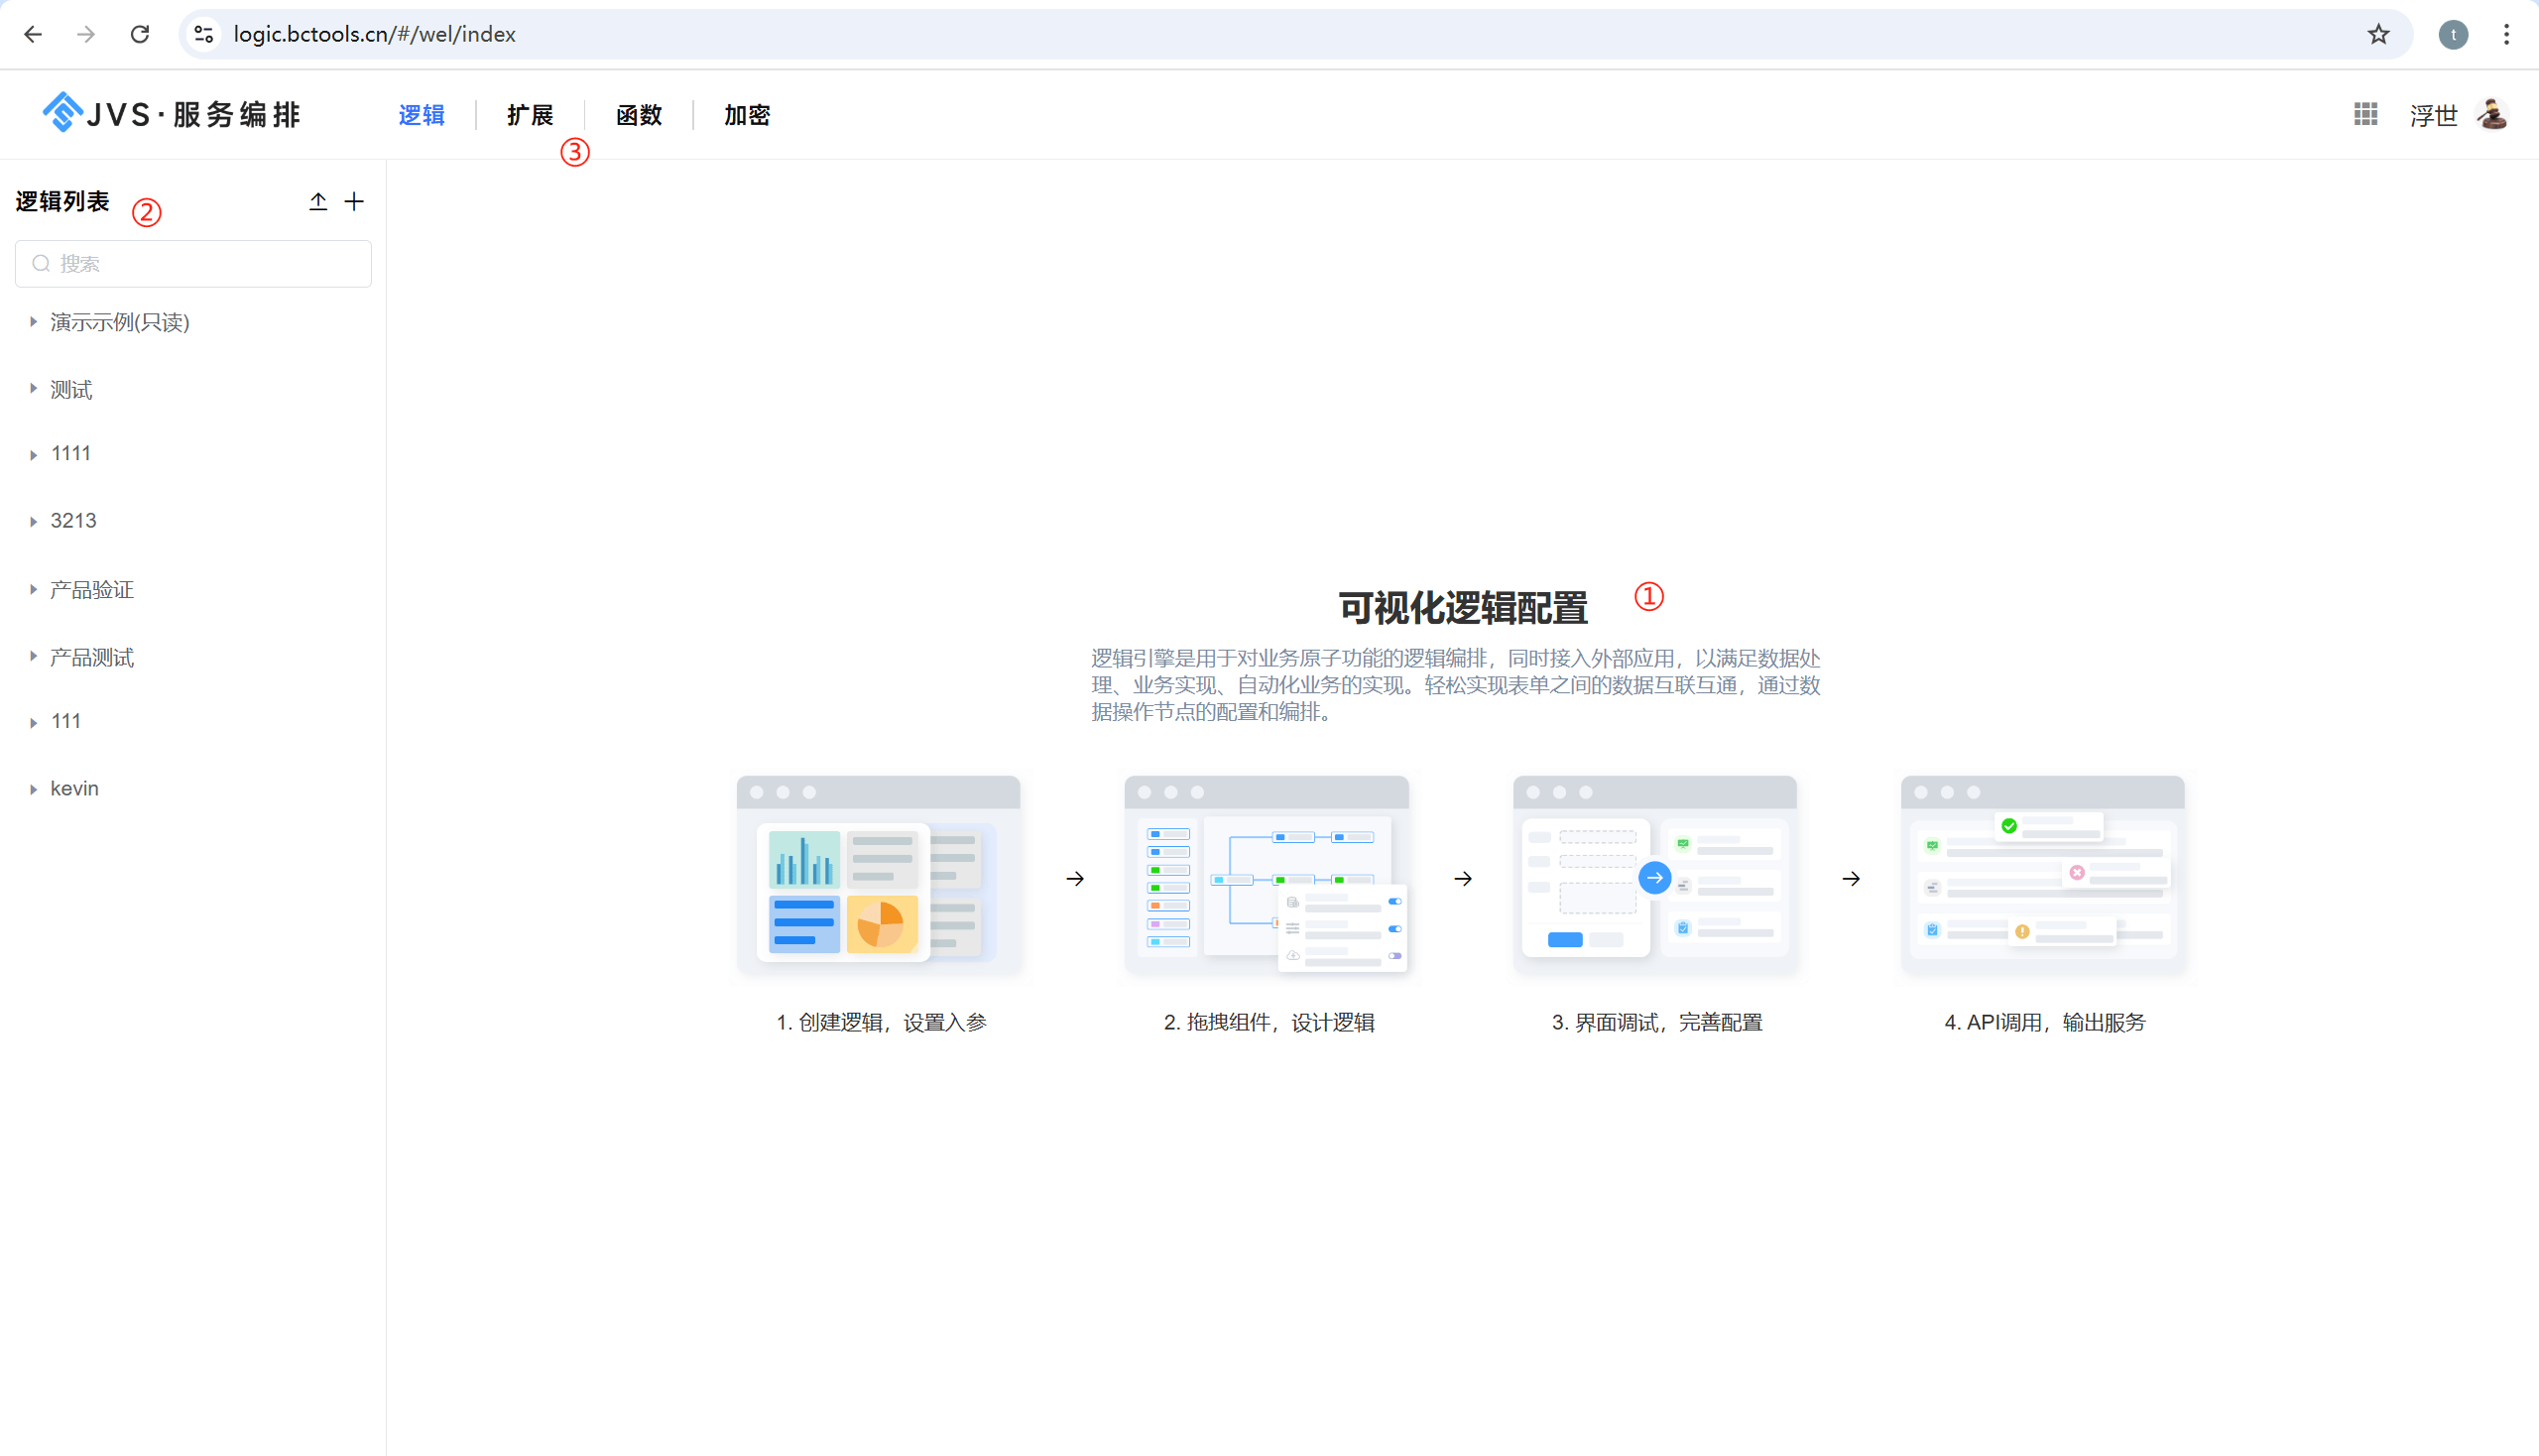
传统代码开发需编写、测试、部署多个环节,周期长、修改成本高;AI驱动的编排工具侧重模糊推理,难以满足企业对5%误差零容忍的刚性要求。JVS-Logic定位为面向企业级场景的精准执行型逻辑引擎,核心在于柔性化配置、高并发处理、基于既定规则的确定性输出与跨业务复用能力。
其可视化画布以流程图替代代码,使HR、IT、业务方能在同一界面协同理解数据流向与判断逻辑。例如同步钉钉考勤时,token刷新、员工列表获取、打卡详情拉取等步骤均以图形节点呈现——流程图始终比代码更易理解与协同,显著降低跨角色沟通成本。
逻辑引擎支持完整私有化部署,所有考勤数据流转均在企业内网完成,不经过第三方云服务。这一设计直接响应企业对考勤等敏感数据的信息安全强管控要求,避免API密钥外泄、原始打卡记录云端留存等合规风险。
其能力体系围绕企业实际需求构建:
- 拖拽式组件拼装:数据库操作、网络请求、变量赋值、条件分支等原子服务开箱即用;
- 多模式触发集成:支持定时执行(如每日凌晨同步)、API调用、消息监听,适配工资计算等固定节奏场景;
- 即时调试与发布:配置即生效,无需编译打包,从设计到上线压缩至小时级。
三步完成钉钉考勤自动同步
逻辑引擎将原本需编码开发的钉钉考勤同步流程,压缩为可配置、可复用、可监控的三个标准步骤。整个过程无需编写一行代码,HR或IT人员均可在界面中完成配置与上线。
第一步:智能获取并复用钉钉Token 系统通过【查询数据库token】节点检查本地MySQL中是否存在未过期的token;若不存在或已失效(钉钉token有效期为2小时),则自动触发【网络请求】节点调用钉钉开放接口重新获取;成功后立即将新token写入数据库并绑定至【token变量】节点供后续复用。
第二步:精准获取在职员工userid列表 系统调用钉钉接口获取在职员工列表,并通过【固定变量】节点配合公式提取返回数据中的userid数组。该数组成为批量拉取打卡记录的关键输入,确保仅同步当前在职人员数据,避免无效请求与冗余处理。
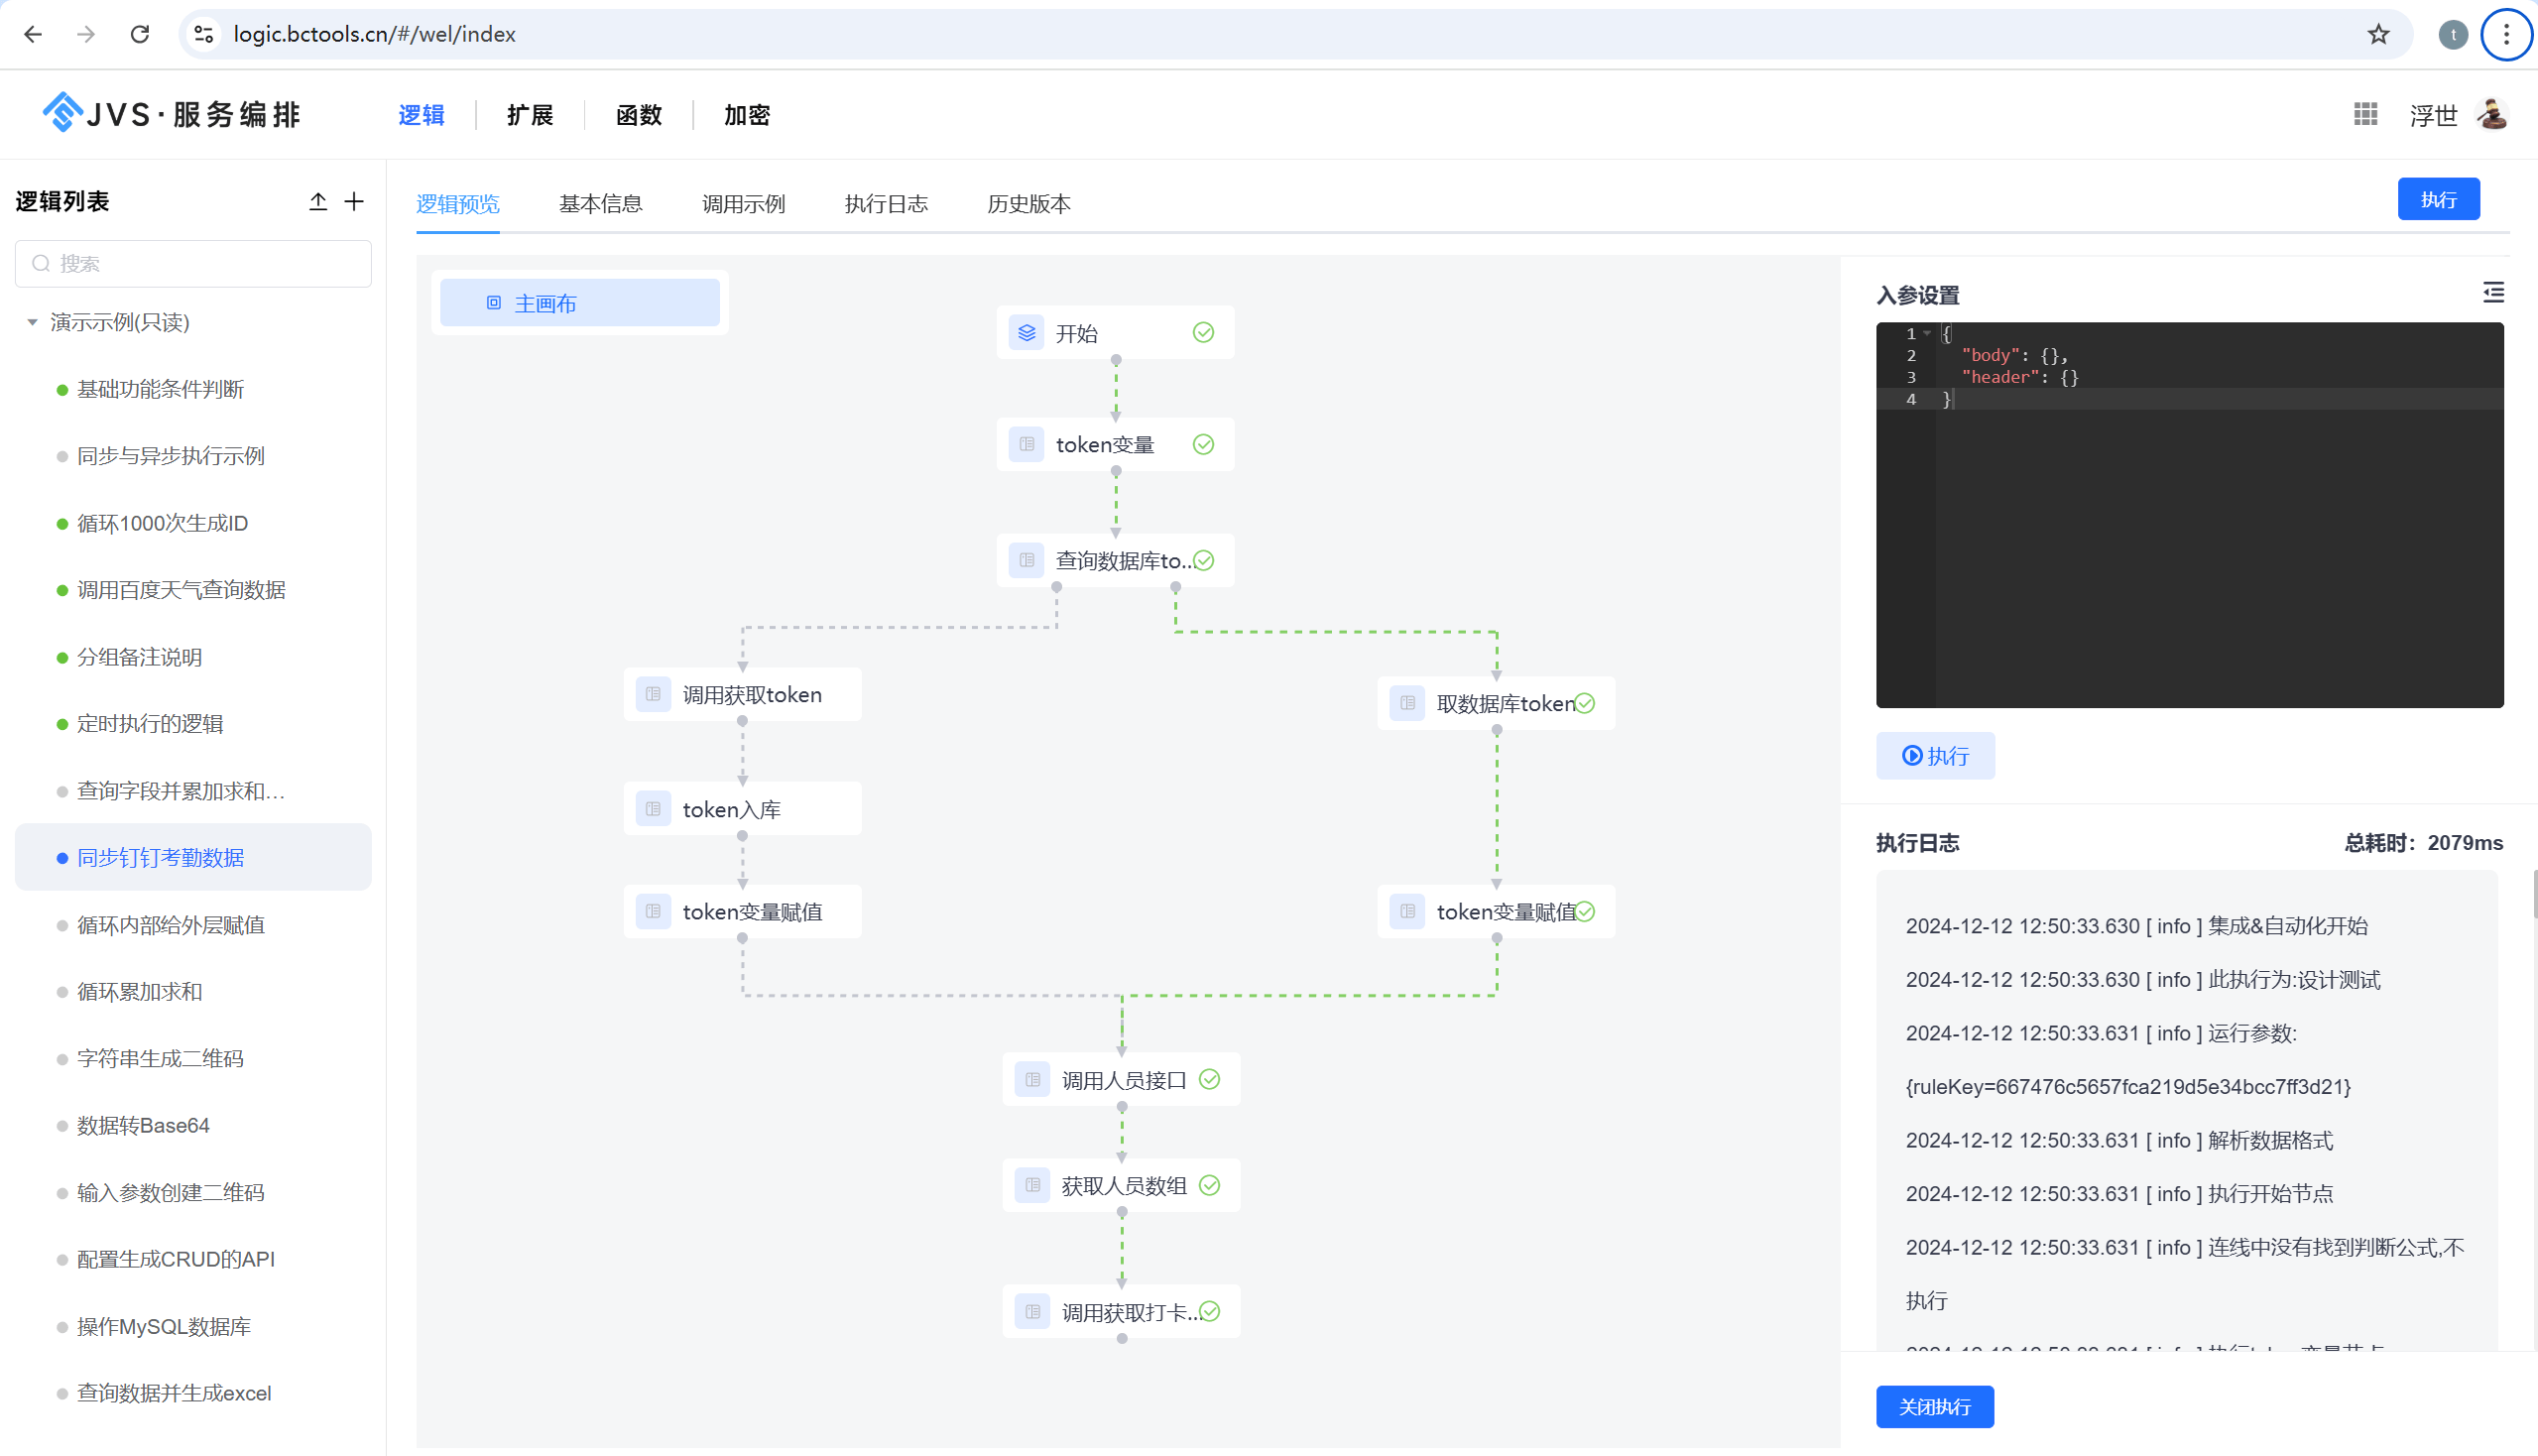
第三步:批量拉取、清洗、映射并推送至工资系统 系统基于userid列表循环调用钉钉打卡接口;返回原始数据后,利用内置数据转换能力进行清洗(如过滤异常打卡、补全缺失字段)和字段映射(如将钉钉的checkInTime映射为工资系统的workStartTime),最终通过标准输出节点推送至目标工资系统数据库或API端点。
执行保障:整个流程采用串行执行+分支判断混合控制模式——token复用判断走分支逻辑,员工查询与打卡拉取为严格串行,保障数据获取的准确性与时序可靠性;所有节点均支持定时触发,实现“配置即上线”的自动化闭环。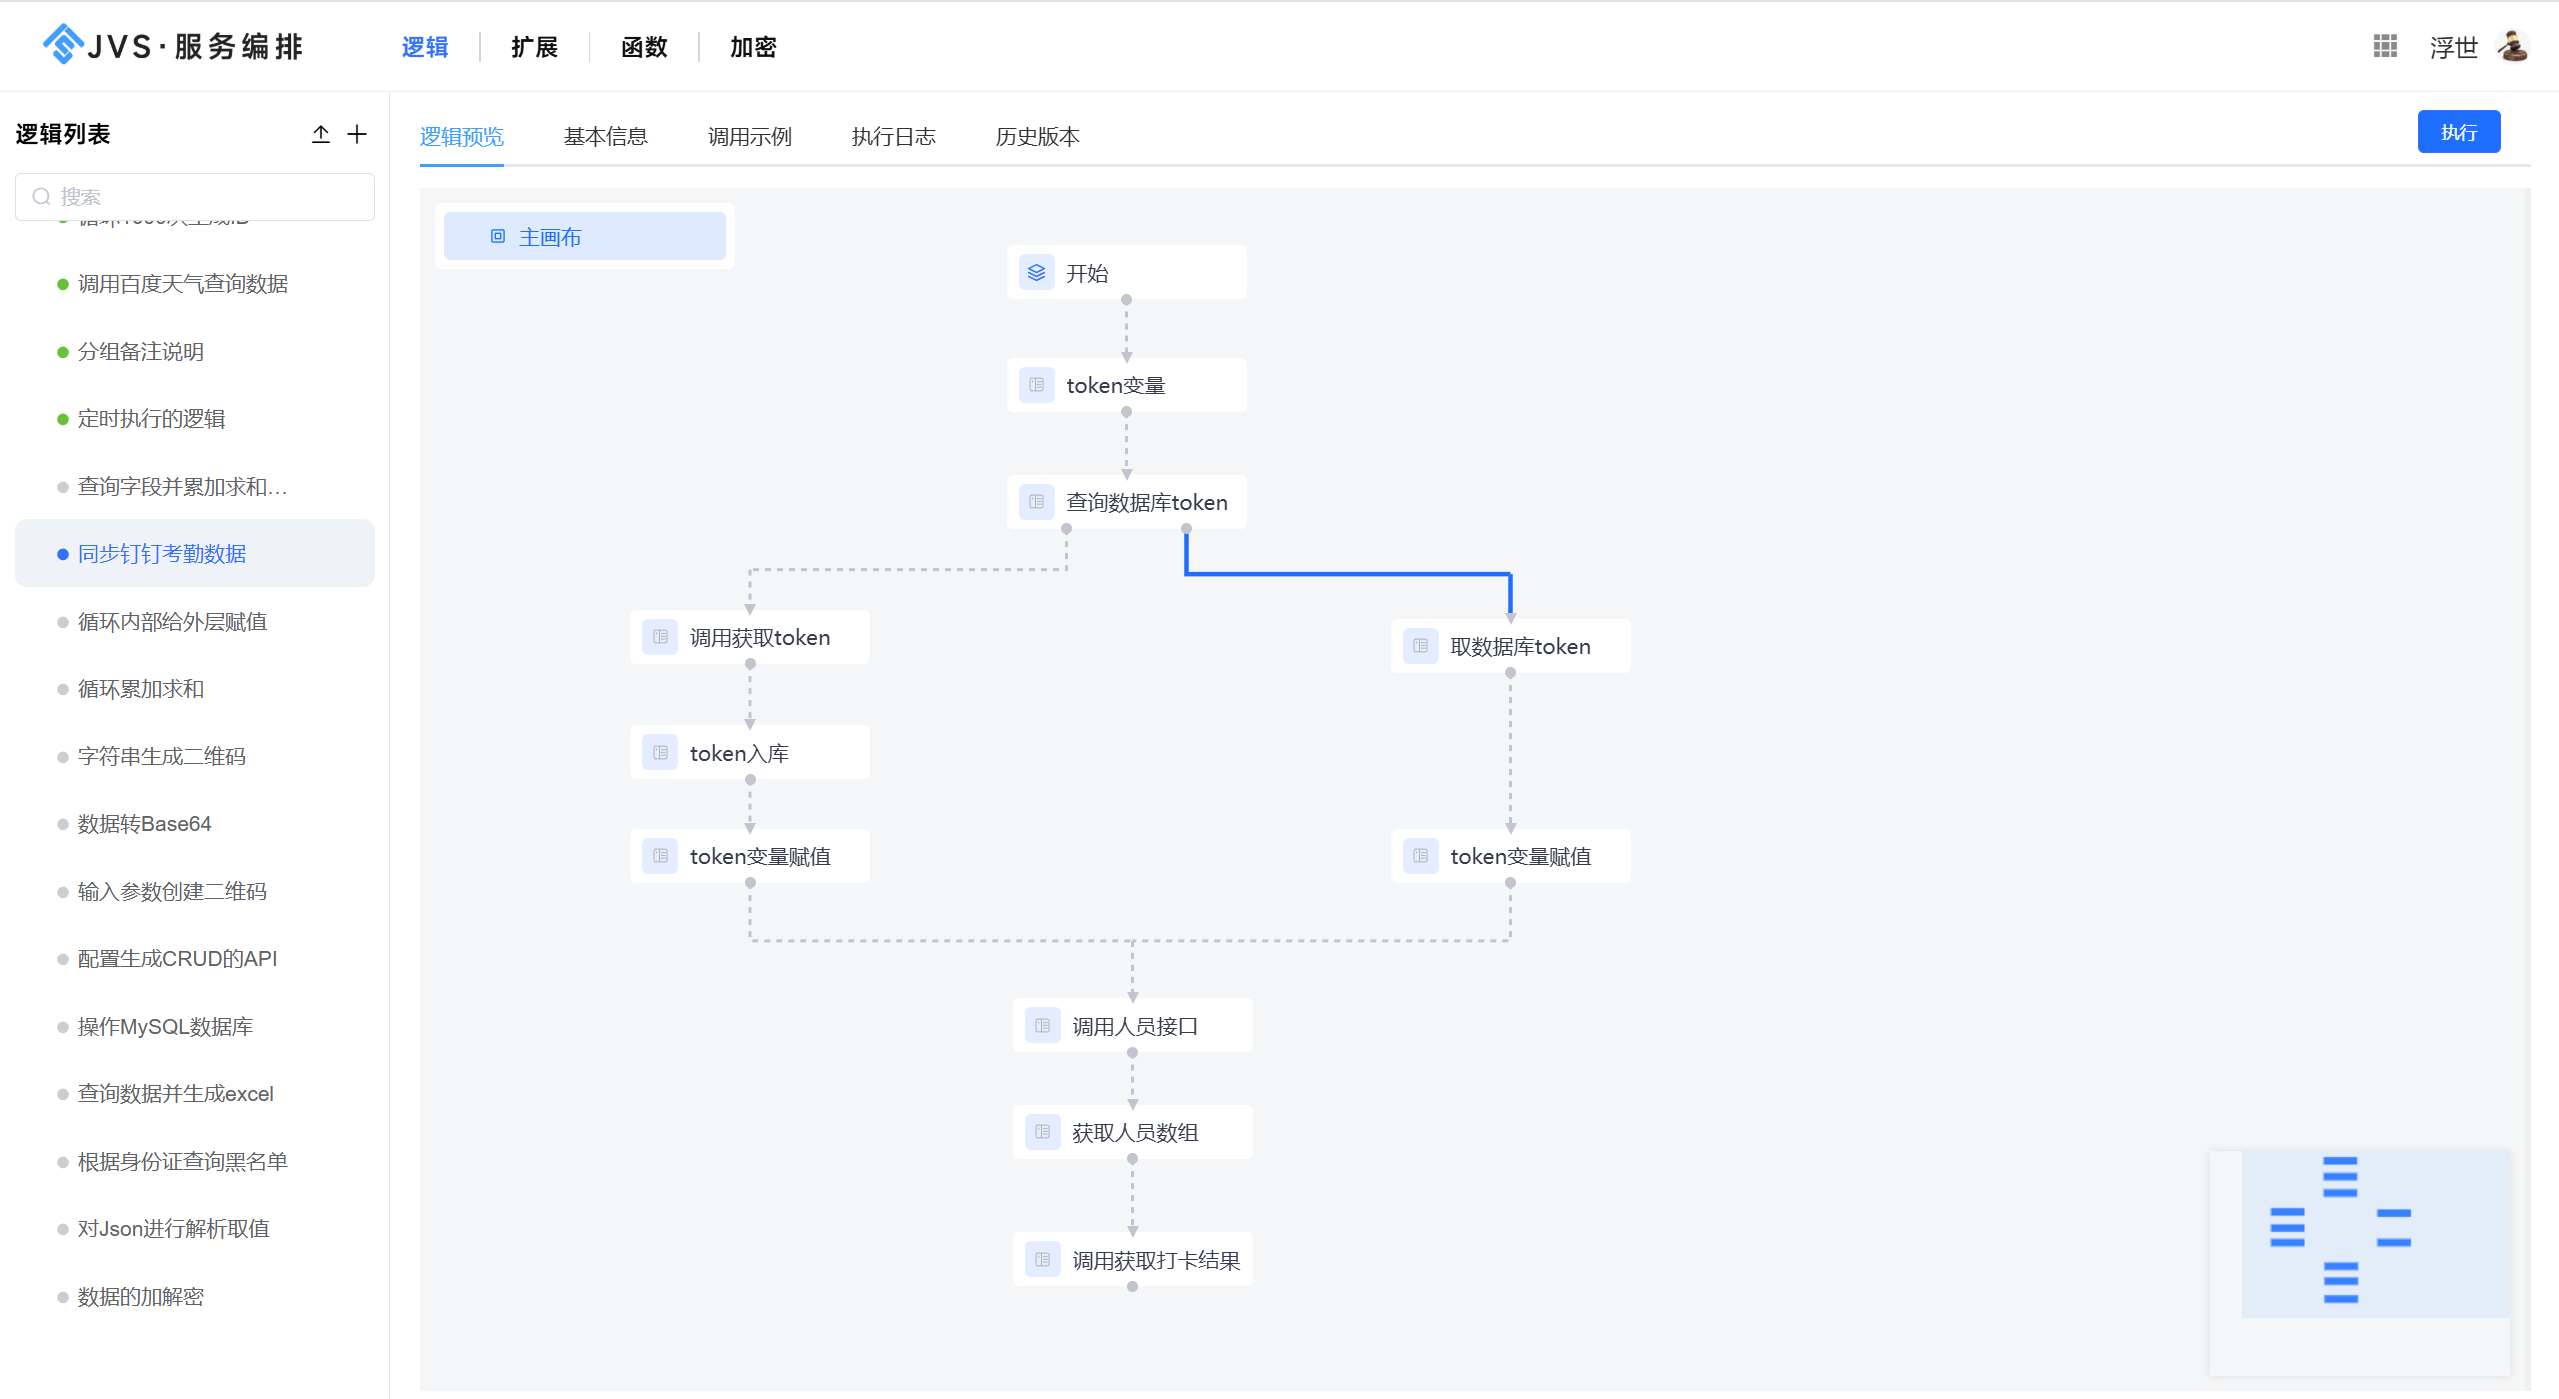
该路径充分体现了JVS-Logic的核心能力:
- 可视化拖拽编排:通过【网络请求】【固定变量】【MySQL操作】等原子节点组合即可构建完整流程;
- 状态感知与智能决策:自动识别token时效性,避免高频无效调用;
- 数据驱动闭环:从身份标识(userid)到行为数据(打卡记录)再到业务系统(工资系统),形成端到端可追踪的数据链路。
不止于考勤:逻辑引擎的通用集成能力
JVS-Logic 不仅解决钉钉考勤与工资系统的单点对接,其底层是一套面向企业级业务闭环的通用集成能力体系。该体系不依赖特定场景预设,而是通过标准化、可组合的原子服务,支撑跨系统、跨节奏、跨协议的多样化集成需求。
引擎提供多方式触发入口:支持界面事件触发(如按钮点击)、API主动调用、定时任务轮询(如每小时同步数据)、以及消息监听(如Kafka或MQ事件响应),适配实时联动与批量同步等不同业务节奏。
内置10+数据库操作节点,覆盖 MySQL、PostgreSQL、SQL Server、Oracle(KingBase)、MongoDB、Doris 等主流存储;同时提供开箱即用的网络请求、变量赋值、数据校验、循环控制、条件判断等原子服务。这些节点无需编码即可拖拽组合,构成稳定可靠的数据处理流水线。
能力根基:集成能力不取决于预置连接器数量,而在于可复用的原子服务 + 标准化扩展机制——这正是逻辑引擎能从考勤场景快速延伸至审批、报销、招聘、CRM同步等业务闭环的根本原因。对于尚未覆盖的第三方系统,逻辑引擎支持自定义HTTP/Webservice组件:用户只需配置目标地址、认证方式与参数映射规则,即可在画布中调用任意标准接口。该能力已在实际项目中用于对接用友U8、金蝶云星空、企业微信及私有化部署的ERP系统。
具体扩展路径包括:
- 通过「扩展组件」界面配置HTTP请求模板;
- 绑定凭证管理(如Token自动刷新);
- 利用「固定变量」与「公式函数」完成动态参数组装。
这种设计实现了业务功能与系统能力解耦:HR团队可自主配置考勤同步逻辑,IT团队则专注维护底层连接安全与性能,双方协作效率显著提升。
如您所在企业正面临类似系统协同难题,建议进一步了解JVS-Logic在实际环境中的部署与配置方案。













