

- 论文标题:Personalize Before Retrieve: LLM-based Personalized Query Expansion for User-Centric Retrieval(检索之前先个性化:面向用户中心检索的 LLM 个性化查询扩展)
- 论文链接:https://zhuanlan.zhihu.com/p/2073080341095621846
- 论文作者:Yingyi Zhang、Pengyue Jia、Derong Xu、Yi Wen、Xianneng Li、Yichao Wang、Wenlin Zhang、Xiaopeng Li、Weinan Gan、Huifeng Guo、Yong Liu、Xiangyu Zhao(大连理工大学、香港城市大学、中国科学技术大学、华为)
- 一句话总结:在检索发生之前先把查询"个性化"——用 P-PRF 模拟用户的表达风格与推理逻辑、用 P-Anchor 通过图结构锚定用户语料的语义中心,再融合成个性化查询向量 ,从而显著提升面向用户私有语料的 RAG 检索效果(PersonaBench 上最高提升约 10%)。
背景与动机
检索增强生成(RAG)的效果高度依赖查询扩展(Query Expansion, QE):先把用户原始查询扩写得更丰富,再去检索相关内容。现有方法(如 HyDE 生成假设性答案、Query2Doc 生成伪文档)都采用统一的、与用户无关的扩展策略,只调用 LLM 的世界知识,却忽略了用户个体的表达风格、偏好和历史上下文。
问题在于:同一句文字查询,在不同用户那里意图可能完全不同。 论文用一个例子说明(见下图):两个用户都问"How would you describe my dietary preferences?"。通用扩展给出完全一样的扩写,结果只有"注重健康"的 User 1 能检中"有机食材"相关内容,而"喜欢尝鲜换花样"的 User 2 检索失败。
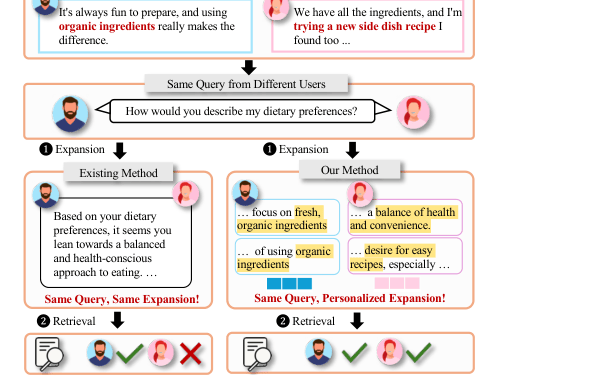
作者将个性化查询扩展的难点归纳为两个核心挑战:
- 用户表达风格天然多样:有人简短直给,有人长篇推理;风格隐式且难迁移,标准扩展难以保留用户特有的语义。
- 用户语料诱导出异质的语义结构:每个用户的私有语料在主题覆盖、内容组织、语言粒度上差异巨大,缺乏"用户专属语义锚点"时,扩展出来的查询容易漂移到不相关区域。
整体架构
论文提出 PBR(Personalize Before Retrieve) 框架,在检索前把用户专属信号注入查询表示。整体由三个模块组成:

端到端数据流:
- 输入用户查询 与用户历史语料 (编码为向量集合 )。
- P-PRF(风格对齐的伪相关反馈):基于与 相关的历史子集,让 LLM 生成两类伪反馈——"粗略"的伪话语(模拟表达风格)和"逻辑"的伪推理(模拟意图推理),分别编码为 与 。
- P-Anchor(结构对齐的语义锚定):把用户语料构造成语义图,用 Personalized PageRank 找出结构上的中心节点,聚合成"用户锚点" 。
- PBR Fusion(融合):用个性化、查询自适应的动态权重 把上述信号与原查询融合成最终个性化查询向量
- 用 在用户语料 上做最近邻检索(faiss),返回个性化结果。
整个框架是推理期、免训练的:所有"个性化"都来自 LLM 生成 + 图结构计算 + 向量融合,不需要额外训练参数。
问题定义
给定查询 和用户历史语料 ,用固定编码器 把它们都映射到向量空间:
变量说明:
- :用户原始查询文本;:其编码向量, 为编码维度。
- :用户历史中第 条文本片段(如以往对话);:其编码向量。
- :用户历史片段数量;:用户语料向量集合。
目标是构造一个个性化查询表示 ,使检索既基于词面语义相似,又对齐用户潜在意图:
变量说明:
- :相似度函数(论文用余弦相似度);:取相似度最高的 项。
- :把可观测查询 与潜在用户上下文 变换为个性化查询的函数。
- :个性化偏移量,编码用户表达风格、意图与语料结构,是全文要建模的核心对象。
模块拆解
1. P-PRF:风格对齐的伪相关反馈
模块作用:在检索前模拟出"这个用户会怎么说、怎么想",把风格与意图注入查询。
P-PRF 不直接用完整历史 ,而是先按语义相似度检索一个与当前查询相关的子集 ,避免无关历史引入噪声:
变量说明:
- 、:查询与第 条历史的编码向量。
- :保留的相关历史条数(论文设 )。
- :与查询相关的用户历史子集,承载该用户的上下文特征。
随后从两个互补角度生成伪反馈。
(a) 伪话语生成(Roughly,粗略地模拟表达风格):用 LLM 基于查询 和相关历史 生成 条"用户可能会这样说"的候选话语,再取其嵌入均值:
变量说明:
- :生成伪话语的 LLM 流水线(提示词为"生成 10 条用户可能自然说出的候选话语…")。
- :第 条伪话语,刻画语气、冗长度、措辞等风格;:其嵌入。
- :伪话语条数(论文设 );:所有伪话语的平均表示,代表用户表达风格信号。
(b) 伪推理生成(Logically,逻辑地模拟意图推理):用并行的 LLM 生成一条逐步推理 (提示词为"参考用户对话,分步解题…"),补充表层查询中缺失的逻辑线索:
变量说明:
- :生成逐步推理的 LLM 流水线。
- :分步推理文本(如"1. 烹饪兴趣:你表现出对烹饪的浓厚兴趣…");:其嵌入,代表用户意图推理信号。
2. P-Anchor:结构对齐的语义锚定
模块作用:捕捉用户语料的结构级偏好,找出语料里语义最"中心"的区域,作为锚点把查询拉向用户语义空间。
Step 1 · 构图:把用户语料表示为语义图 ,节点是历史片段向量 ,边由节点间余弦相似度决定:
变量说明:
- :节点 间的余弦相似度; 为内积, 为模长。
为控制图的稀疏度,只保留相似度超过阈值 且属于 的 top- 邻居的边,得到稀疏邻接矩阵 :
变量说明:
- :语义阈值(论文设 );:每个节点保留的邻居数(PersonaBench/LongMemEval-s 设 ,历史更密的 LongMemEval-m 设 )。
- :稀疏邻接矩阵,刻画用户语料内部结构连接。
Step 2 · PageRank 求锚点:在图上跑 PageRank,得到反映节点中心性的平稳分布 :
变量说明:
- :按行归一化得到的转移矩阵。
- :阻尼系数(控制随机游走与随机跳转的比例);:全 1 向量;:节点数。
- :节点中心性分布,值越大表示该片段在用户语料中越"中心"。
最后按中心性加权聚合所有节点向量,得到用户锚点:
变量说明:
- :第 个节点的中心性权重;:编码用户语料结构中心语义的锚点向量,把查询锚定在用户专属的、上下文感知的语义空间。
3. PBR Fusion:动态加权融合
模块作用:把 P-PRF 的风格/推理信号、P-Anchor 的结构锚点,与原查询融合成最终个性化查询。
作者认为伪反馈的价值因用户和查询而异,于是引入个性化、查询自适应的动态权重 ,按伪反馈与"查询+锚点"中点的语义贴合度来加权:
变量说明:
- :原查询与用户锚点的中点,作为衡量"是否贴合用户语义"的参考向量。
- :伪话语 的权重;:伪推理 的权重。
- 加性常数 保证权重为正、插值平滑(避免负相似度把信号反向)。
由此定义个性化偏移并构造最终查询向量:
变量说明:
- :个性化偏移,融合结构锚点 + 加权风格 + 加权推理。
- :最终个性化查询向量,既含原查询表层语义,又含用户隐式风格、目标导向推理与语料中心信号。
查询融合与最终检索(免训练)
PBR 没有损失函数、不需要训练。它是一个推理期查询扩展框架:个性化完全来自 LLM 生成(P-PRF)、图上的 PageRank 计算(P-Anchor)与基于相似度的动态加权融合(PBR Fusion)。最终检索:用融合后的查询向量 ,在用户语料 上用 faiss 做最近邻搜索,召回与用户相关的内容:
由于扩展发生在检索之前,PBR 可作为即插即用模块,搭配任意稠密检索器使用。
实验分析
数据集:两个面向个性化检索的基准。
- PersonaBench:6 个用户、每人约 50 条查询,意图模糊、语言高度个性化,覆盖偏好/社交等"软个性化"。
- LongMemEval:500 条事实型查询,每条配一段记忆语料;分 LongMemEval-s(稀疏历史)与 LongMemEval-m(密集历史),考察长期记忆下的"硬事实"检索。
指标:Recall@K(R@K)、NDCG@K(N@K)。基线:Base、HyDE、Query2Term、MILL、CoT、ThinkQE。检索骨干:multi-qa-MiniLM-L6-cos-v1、all-MiniLM-L6-v2、bge-base-en-v1.5(每个方法跑 5 次)。
RQ1 · 整体性能
在 PersonaBench 上,PBR 在三种检索器上整体均为最优,平均 R@5/N@5 达 0.4527 / 0.3819,显著超过最强基线 ThinkQE(0.4098 / 0.3484):
在 LongMemEval 上,PBR 在所有基线之上,尤其提升 top-1 精度。以 bge-base-en 为例,LongMemEval-s 的 R@1 达 0.2315、LongMemEval-m 达 0.1408,均高于最强基线(0.2267 / 0.1384):
结论:PBR 既能在 PersonaBench 上通过用户风格伪反馈化解语义模糊,又能在 LongMemEval 上把正确记忆精确提到 top-1。
RQ2 · 消融实验
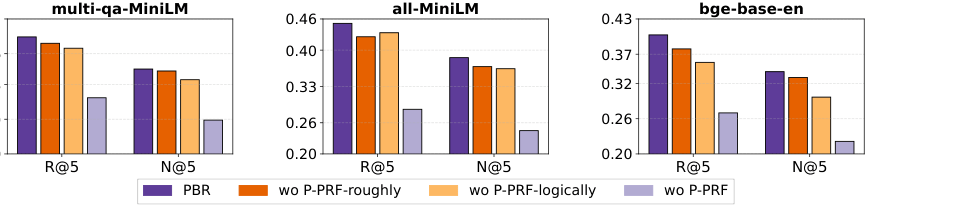
按模块消融(PersonaBench,三检索器平均):去掉任一模块都掉点,其中 P-PRF 贡献最大。
- P-PRF 是主要增益来源:去掉后大幅下降(如 all-MiniLM 上 R@5 从 0.4516 跌到 0.2860),个性化越强的子集跌得越狠。
- P-Anchor 促进结构化语料对齐:去掉后 N@5 从 0.3819 降到 0.3695,在结构清晰的 Basic Information、Social 子集上影响更明显;而在非聚类的 Preference (hard) 上增益有限、甚至可能过拟合——P-Anchor 在用户上下文语义连贯时最有效。
进一步拆 P-PRF 的两个子部件(下图):去掉"粗略伪话语"或"逻辑伪推理"都会一致掉点——前者损害词面覆盖,后者削弱目标导向推理。
RQ3 · 参数敏感性
对 P-Anchor 的两个结构超参(阈值、邻居数)做敏感性分析:
- 适度传播提升对齐:当且时,R@5/N@5 在各数据集上达到稳定峰值。
- 过度传播导致语义漂移:、继续增大(如)时性能饱和甚至略降,说明扩散过头会引入噪声、削弱语义特异性。
可视化案例
用 t-SNE 可视化 Figure 1 中查询、真值(GT)与各方法生成查询的分布:
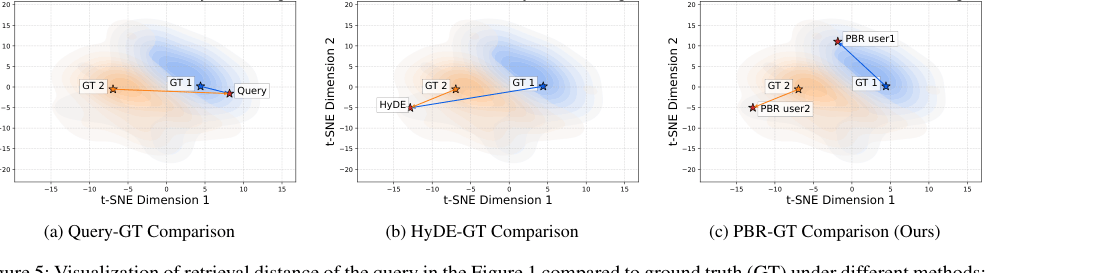
- 原始查询、HyDE 都产生与不同用户错位的通用结果。
- 以余弦相似度衡量与用户专属 GT 的贴合,PBR 在两个用户间的区分度更高(0.31 vs. 0.27),明显优于 HyDE(0.04 vs. −0.01)和原始查询(0.05 vs. 0.10)。
- PBR 为不同用户生成不同扩展(PBR user1 / PBR user2),更好覆盖各自的用户语义空间,从而把检索结果拉近各自 GT。
优势与局限
优势:
- 首个面向 RAG 的个性化查询扩展框架:把个性化前置到检索之前,同时建模用户的表达风格(P-PRF)与语料结构(P-Anchor)。
- 免训练、即插即用:纯推理期方法,可搭配任意稠密检索器;在 PersonaBench 与 LongMemEval 上对多种检索骨干均稳定超越强基线。
- 动态加权可解释:按伪反馈与"查询+锚点"中点的贴合度自适应加权,使不同用户/查询获得不同程度的个性化。
局限(基于论文 Conclusion 与实验观察):
- P-Anchor 依赖语料结构:在语义不聚类的任务(如 Preference (hard))上增益有限,甚至可能过拟合。
- 对传播超参敏感:、过大会引发语义漂移,需要按数据集调参(如 LongMemEval-m 需更大的)。
- 适用范围:当前聚焦基于查询的检索;作者将"推广到更广泛的信息检索任务"列为未来工作。














