

论文信息
- 论文标题:TokenMinds: Pretrained User Tokens and Embeddings for User Understanding in Large Recommender Systems
- 论文链接:https://zhuanlan.zhihu.com/p/2074747471914451088
- 论文作者:Qingyun Liu、Bo Yan、Yang Liu、Yuji Roh、Ekansh Sharma、Likang Yin、Emma Olowo、Min-hsuan Tsai、Yuxuan Li、Diego Uribe、Saksham Aggarwal、Siqi Wu、Yuan Hao、Vikas Kedigehalli、Lukasz Heldt、Lichan Hong、Li Wei、Xinyang Yi
- 一句话总结:TokenMinds 将 PLUM 的 SID 语义离散化能力从 item retrieval 扩展到 YouTube 工业级用户建模,用同一个 encoder-decoder 预训练模型同时产出 SID 用户 Token 与 稠密用户 Embedding,并通过异步服务架构支撑亿级用户全流量上线。
背景与动机
工业推荐系统长期依赖 Large Embedding Models,用巨大 embedding table 记忆 user-item 交互。它们在高频 ID 记忆上有效,但固定维度向量会压缩用户兴趣的细粒度结构,并且面对海量视频 ID、长尾内容与持续增长的语料时存在泛化、词表 churn 与表达上限问题。
LLM 给推荐带来新的建模路径,但直接用自然语言 user profile 也有三类缺口:第一,文本画像更多捕获 topic co-occurrence,不一定刻画深层序列行为动态;第二,自然语言输出难以稳定 grounding 到目标视频语料的 item attribute;第三,非文本排序系统接入文本 profile 会产生模态鸿沟。
TokenMinds 的 insight 是:既然 Semantic ID 已能把视频内容映射成层级离散 codeword,并在 PLUM 中验证了 item retrieval 的可行性,那么用户也可以被表示为一组“未来兴趣 SID token”。这些 token 与视频语义空间共词表、可解释、可离散索引,同时 encoder 仍输出 dense embedding 以兼容现有下游模型。
整体架构
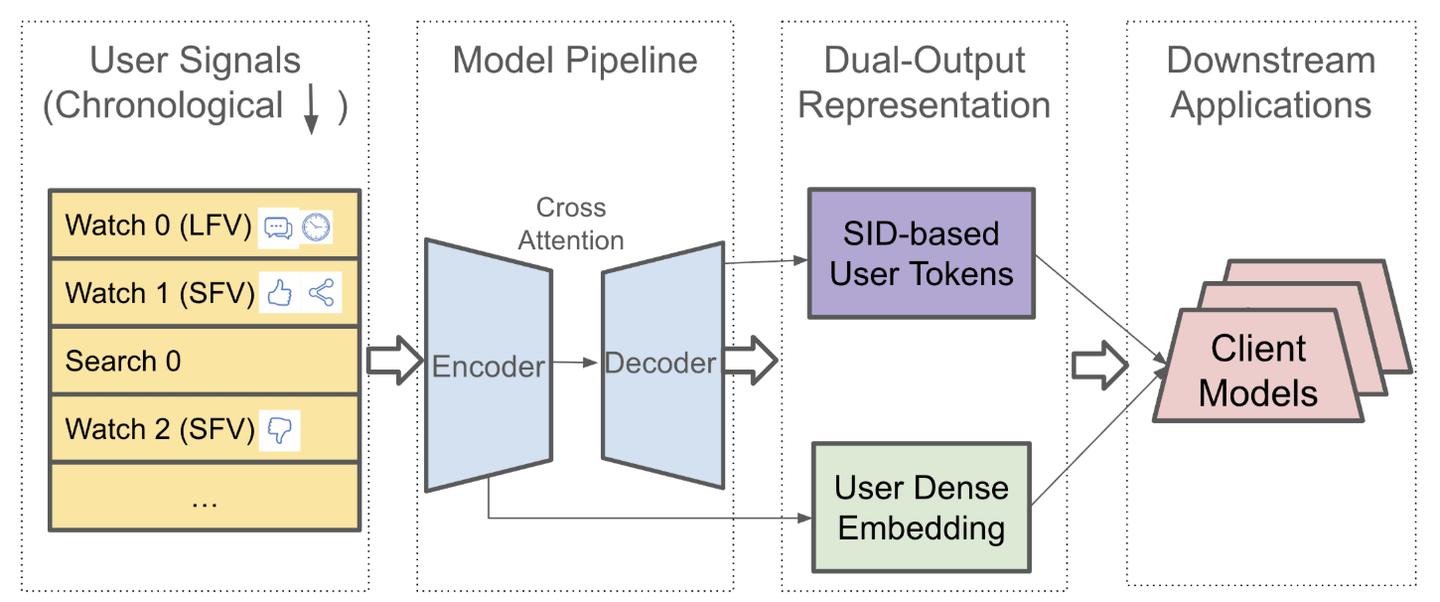
端到端流程:用户历史行为被转成包含 LFV/SFV watch、search query 与 engagement feature 的序列;每个视频使用 RQ-VAE 生成的 SID prefix 表示;encoder 读取完整历史并产出 dense user embedding;decoder 通过 cross-attention 读取 encoder hidden states,自回归生成多条 SID 序列;最终 dense embedding 与 SID user tokens 被异步生成、缓存,并供下游排序模型读取。
TokenMinds 的架构选择可以拆成三层:
- 输入层:把 watch history、search query、场景条件 token 与非 SID 特征统一成 token 序列。
- 表征层:encoder 负责长历史压缩与 dense embedding,decoder 负责生成离散 SID token。
- 服务层:离线或准实时刷新用户表征,线上 ranking 只读取缓存,避免把重模型放入实时打分链路。
模块拆解
3.1 SID 视频表征与输入 Tokenization
模块作用:把原始视频 ID 与用户行为特征转成可被预训练 encoder-decoder 模型处理的序列,并让视频 token 与内容语义对齐。
输入:用户 watch 序列 W = [W_1, ..., W_n],每个 watch 带视频内容 embedding、时间、互动、设备、场景等特征;输出:模型输入 token 序列 X ∈ R^{B×T×D}。
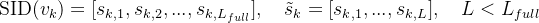
变量说明:
- v_k:第 k 次 watch 对应的视频。
- SID(v_k):由 RQ-VAE 根据视频内容 embedding 生成的层级 Semantic ID 序列。
- s_{k,l}:第 k 个视频在第 l 个 codebook level 上的离散 codeword。
- L_full = 8:论文实验中的完整 SID codebook 层数。
- L:实际输入与预测使用的 SID prefix 长度,论文主实验使用 L = 4。
- \tilde{s}_k:截断后的粗粒度 SID prefix,用于鼓励语义泛化并降低逐视频记忆。
每个 watch 的输入由三部分拼接:场景条件 token、SID prefix hard tokens、非 SID feature tokens。
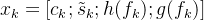
变量说明:
- x_k:第 k 次 watch 展开后的 token 片段。
- c_k ∈ {<LFV>, <SFV>}:场景条件 token,用来区分长视频与短视频。
- \tilde{s}_k:长度为 L 的 SID hard token 序列。
- f_k:非 SID 特征集合,例如 watch time ratio、device platform、like/dislike、timestamp。
- h(f_k):把离散或分桶后的特征映射为 hard tokens。
- g(f_k) ∈ R^{M×D}:soft token 生成函数;论文中把多个 feature embedding 拼接后经 MLP 投影成 M 个 embedding,主实验使用 M = 1。
- D:模型隐藏维度。
3.2 Encoder-Decoder 双输出用户建模
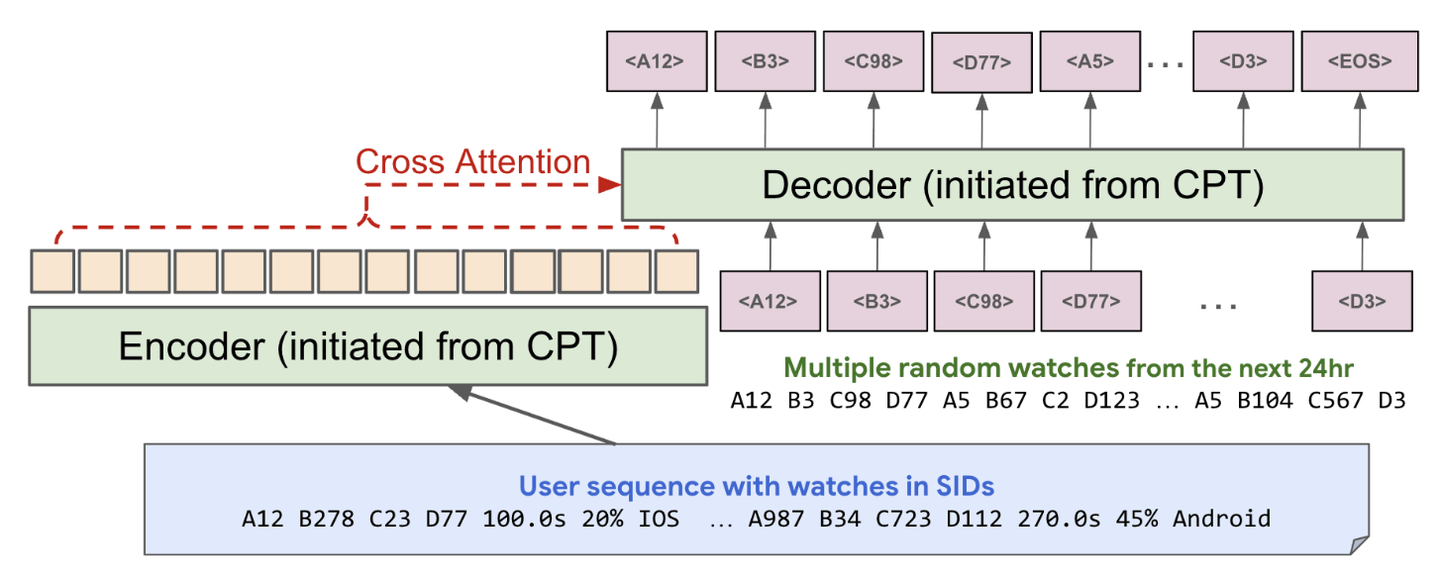
模块作用:encoder 学到可直接服务下游模型的 dense user embedding,decoder 生成代表用户未来兴趣的 SID user tokens。
输入:用户历史序列 X_{hist} ∈ R^{B×T×D};输出:dense embedding e_u ∈ R^{B×1152} 与 beam search 得到的 B_{beam} 条 SID 序列。
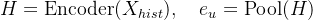
变量说明:
- X_{hist}:由历史 watch、search query 与特征 token 组成的输入序列。
- B:batch size。
- T:最大输入 token 长度,论文主实验为 1024。
- D:模型 hidden size。
- H ∈ R^{B×T×D}:encoder 输出的上下文化 hidden states。
- Pool(·):对 encoder hidden states 的池化函数,可用 last-token pooling 或 mean pooling。
- e_u:dense user embedding;论文线上服务抽取 1152 维 embedding。
Decoder 通过 cross-attention 读取完整 encoder 输出,并自回归生成未来目标 watch 的 SID prefix:
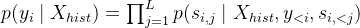
变量说明:
- y_i = [s_{i,1}, ..., s_{i,L}]:第 i 个目标 watch 的 SID prefix。
- s_{i,j}:第 i 个目标 SID 在第 j 个 prefix 位置上的 codeword。
- y_{<i}:同一训练样本中前面已生成的目标 SID 序列。
- s_{i,<j}:当前 SID prefix 中已生成的前缀 codewords。
- L:预测 SID prefix 的长度,主实验为 4。
3.3 Look-ahead 多目标训练
模块作用:避免模型只拟合“下一个 watch”,让用户 token 表征覆盖未来 24 小时内更宽的兴趣区域。
训练时用 cutoff timestamp T_c 把用户序列拆成历史窗口与未来窗口,从未来 24 小时内最多采样 N 个目标 watch。
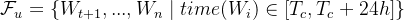
变量说明:
- u:用户。
- W_1, ..., W_n:用户按时间排序的 watch 序列。
- T_c:训练样本的 cutoff timestamp。
- W_1, ..., W_t:cutoff 之前的历史行为。
- \mathcal{F}_u:cutoff 后 24 小时 look-ahead future window 内的候选目标集合。
论文的 decoder loss 为 prefix SID 的带 reward 负对数似然:
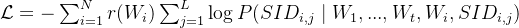
变量说明:
- N:每个用户样本采样的未来目标数,论文主实验最多 15。
- r(W_i):第 i 个目标 watch 的 engagement reward,由多种用户信号组合而成;实际训练中论文更倾向按 reward 比例采样样本并等权训练,以提升计算效率。
- SID_{i,j}:第 i 个目标 watch 的第 j 个 SID prefix token。
- W_{<i}:多目标自回归生成中先前目标 watch 的信息。
- SID_{i,<j}:当前目标 SID 已生成的 prefix。
- L:loss 只计算到 prefix 长度,不预测完整 L_full SID。
3.4 跨场景建模与 Multi-Context Decoding
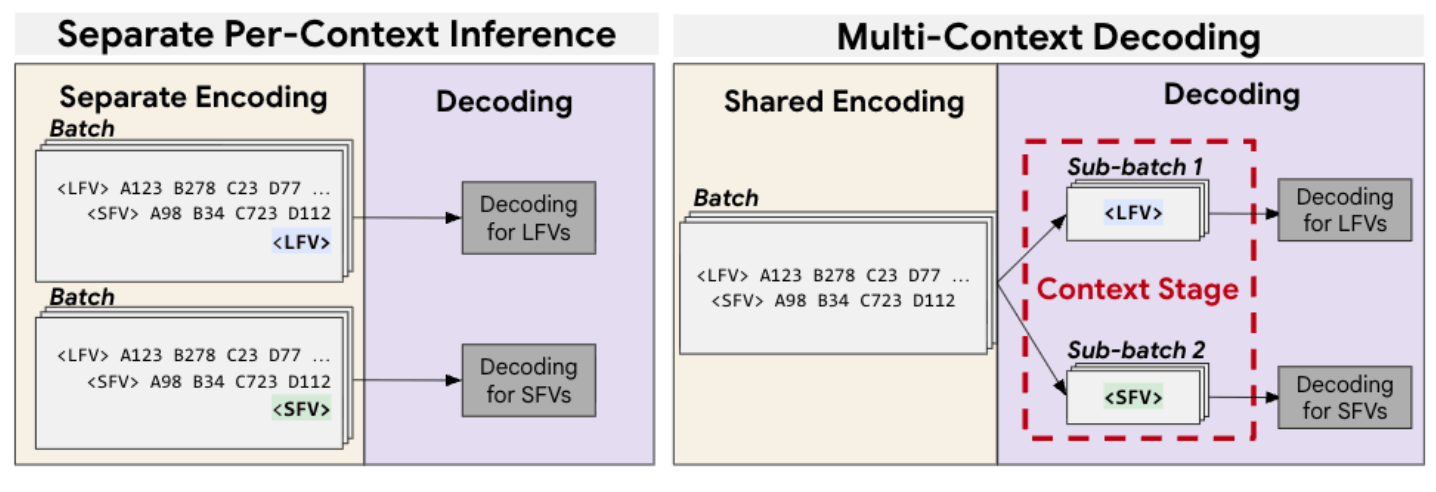
模块作用:用一个统一模型同时服务 LFV 与 SFV,减少训练和上游服务成本,并保留场景特异的用户 token 输出。
统一训练时,每条 watch 前加场景 token,最近 S 条 search query 前加 <Search> token,并按时间插入行为序列:
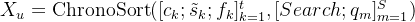
变量说明:
- X_u:统一跨场景输入序列。
- c_k:第 k 个 watch 的场景 token,取 <LFV> 或 <SFV>。
- \tilde{s}_k:视频 SID prefix。
- f_k:非 SID 行为特征。
- q_m:第 m 条 search query 文本 token。
- S:插入的最近 search query 数量,论文主实验为 10。
- ChronoSort(·):按真实发生时间把 watch 与 search query 混排。
Multi-context decoding 避免分别为 LFV/SFV 重复跑 encoder:
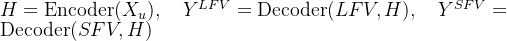
变量说明:
- H:共享 encoder hidden states,只计算一次。
- Y^{LFV}:以 <LFV> 作为 decoding prefix 生成的长视频场景用户 tokens。
- Y^{SFV}:以 <SFV> 作为 decoding prefix 生成的短视频场景用户 tokens。
- Decoder(c, H):以场景条件 token c 初始化 decoder,并通过 beam search 生成该场景下的多条 SID 序列。
论文报告统一模型相对两套独立模型减少 50% upstream training compute 与 31% upstream serving compute,同时 Fresh Engagement 在 SFV/LFV 分别提升 +0.33%/+0.19%。
3.5 下游 Token Adaptation
模块作用:把离散 SID user tokens 转成下游 LEM 排序模型可消费的连续向量,并与 dense embedding 共同接入。
论文比较三类 token-to-embedding 方法:
对 beam search 生成的多条 SID 序列,聚合得到一个 token-derived user vector:
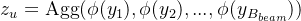
变量说明:
- B_{beam}:每个用户生成的 SID 序列数;论文线上服务为 40,其中 20 条 LFV、20 条 SFV。
- y_b:第 b 条 beam 生成的 SID prefix 序列。
- \phi(y_b):token adaptation 函数,可为 prefix mapping、N-gram embedding 或 SPM embedding。
- Agg(·):聚合函数,可为 attention-weighted pooling、mean、max 或 top-k concat;论文称不同聚合方式表现接近,主要收益来自 token 信息本身。
- z_u:由 SID user tokens 得到的连续用户向量,可作为 ranking feature 或 cross-attention 的 key-value。
3.6 异步 Serving System
模块作用:把重型生成模型从实时打分链路中移出,使 TokenMinds 可以服务 full user traffic。
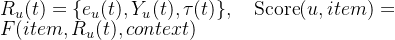
变量说明:
- R_u(t):用户 u 在时间 t 可被线上系统读取的缓存表征。
- e_u(t):encoder 生成的 dense embedding。
- Y_u(t):decoder 生成的 SID user tokens。
- \tau(t):缓存生成或刷新时间戳,用于判断过期。
- F(·):下游 ranking model。
- context:请求上下文、候选 item 特征与其它线上特征。
服务流程是:client 在实时 scoring 时读取 KV cache;若表征存在且未过期,则直接使用;若缺失或过期,则触发后台 Refresh Service 从最新历史中重新运行 TokenMinds 并写回缓存。论文线上设置 24 小时刷新 cadence,单用户联合生成 token 与 embedding 约 339ms,但该成本完全由后台处理吸收。
训练目标
TokenMinds 的主要训练目标是 decoder 侧的 SID prefix 生成。encoder 没有单独的显式 embedding loss,而是通过 decoder cross-attention 的梯度被隐式监督。
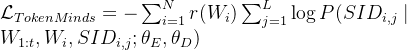
变量说明:
- \theta_E:encoder 参数,初始化自 Continued Pre-Training checkpoint。
- \theta_D:decoder 参数,同样初始化自 CPT checkpoint。
- W_{1:t}:cutoff 前历史 watch 序列。
- N:从 24 小时 future window 中采样的目标数,主实验最多 15。
- L:预测 SID prefix 长度,主实验为 4。
- r(W_i):目标 watch 的 engagement reward;论文说明实际可按 reward 比例采样训练样本并在 loss 中等权。
- P(SID_{i,j} | ·):decoder 在给定历史、已生成目标与当前 SID prefix 条件下预测第 j 个 SID token 的概率。
- \theta_E, \theta_D 的梯度路径:loss 直接作用于 decoder output logits,encoder 通过 decoder cross-attention 接收梯度。
跨场景训练时,condition tokens 不进入 loss:
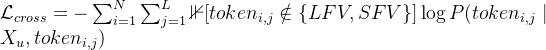
变量说明:
- token_{i,j}:第 i 个目标序列的第 j 个待预测 token。
- <LFV>, <SFV>:场景条件 token,只作为条件输入,不计入训练 loss。
- \mathbb{1}[·]:指示函数,若 token 不是场景条件 token 则取 1。
- X_u:跨场景混排后的用户历史输入。
实验分析
4.1 实验设置
模型基于 Gemini V1.5 的 encoder-decoder:encoder 为 370M 参数 MoE,decoder 为 370M 参数 dense decoder,均从 PLUM 风格 CPT checkpoint 初始化。训练数据来自 YouTube LFV 与 SFV watch histories,并混入 textual search queries;每个用户样本使用最近 1,200 次 watch、最多 S = 10 条 search query,最大输入长度 1,024 tokens。
线上服务每 24 小时刷新一次;每个用户产出 1,152 维 dense embedding,并通过 beam search 解码 40 条 SID 序列,其中 LFV/SFV 各 20 条。
4.2 训练目标消融
结论:多目标、look-ahead 与 SID truncation 不是工程细节,而是 SID user token 泛化能力的核心来源。特别是 cold-start recall 对 look-ahead 和 prefix-level coarse representation 最敏感,说明只拟合 immediate next watch 或完整 SID 都会让模型更偏向短期记忆。
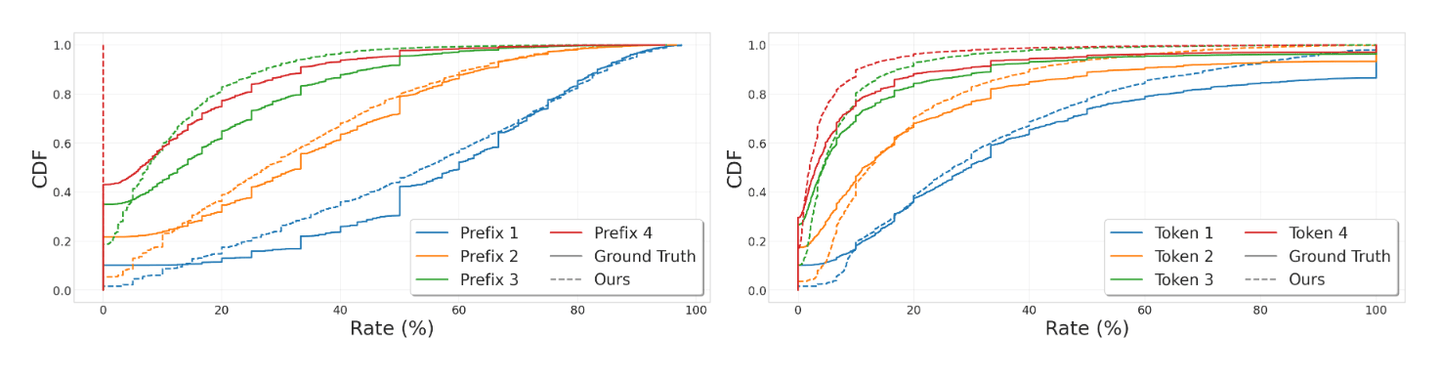
4.3 初始化与 Search Query
结论:CPT 对 SID grounding 有明确收益,search query 作为显式意图信号也有稳定增益;二者组合收益最大,说明对齐过 SID 语义空间的 LLM backbone 更能吸收文本搜索意图。
4.4 在线效果:Token 与 Embedding 互补
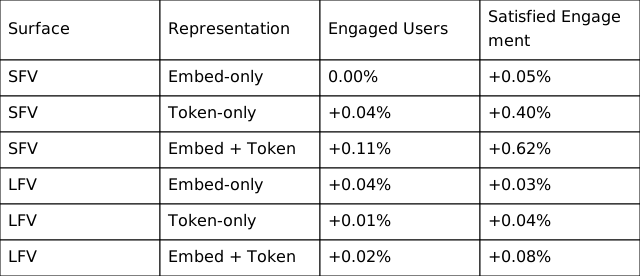
结论:SID user token 单独接入已能带来增益;dense embedding 与 token 同时接入时收益放大,证明二者不是互相替代,而是捕获互补信号。论文还报告 token-only 在另外两个 LFV surface 上取得 +0.04%/+0.16% Engaged Users 与 +0.07%/+0.11% Satisfied Engagement。
4.5 下游接入成本与缓存收益
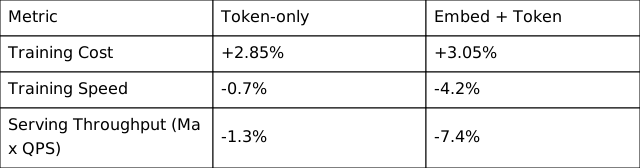
关键系统数字:每用户联合生成耗时约 339ms,但在后台完成;离散 token 表征只需 1,280 bytes,而 dense embedding 为 4,608 bytes,存储下降 72%;线上 cache hit rate 为 96.4%,覆盖每秒 1.44M 读请求。
4.6 跨场景模型质量与效率
结论:统一 LFV/SFV 后,核心 engagement 没有下降,freshness 明显提升;即使固定输入长度导致 LFV 历史容量几乎减半,SFV 行为仍能补充 LFV 用户理解,支撑跨场景迁移。
4.7 Scaling Study
论文用 7 天训练、顺序第 8 天评估的 accelerated offline protocol 做扩展性分析。结论有三点:
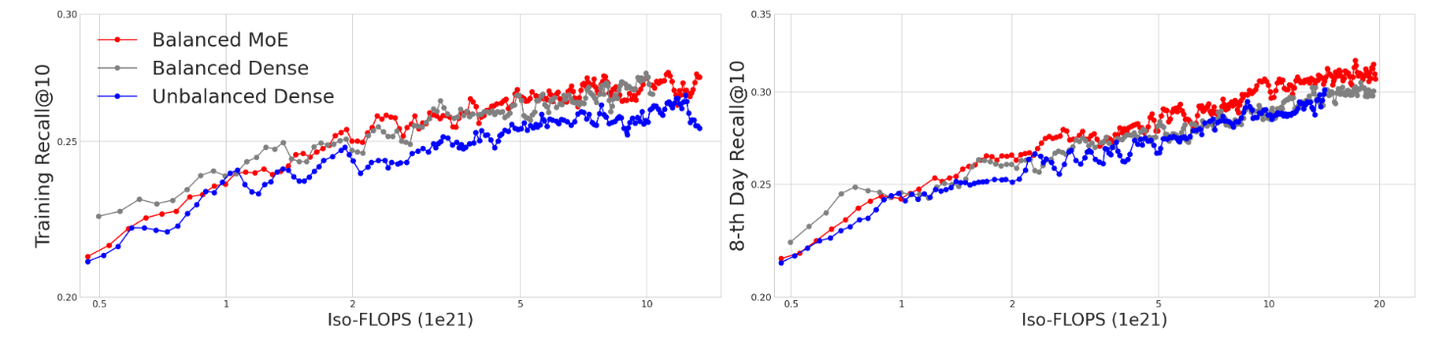
- 容量分配:不平衡模型 420M Enc / 110M Dec 训练 recall 较低,但第 8 天 recall 接近 balanced dense,提示可以用重 encoder 低频刷新、轻 decoder 高频刷新的异步架构。
- MoE decoder:在 matched FLOPS 下,Balanced MoE decoder 的第 8 天 Recall 优于 Dense decoder,说明 sparse expert routing 有助于未来行为泛化。
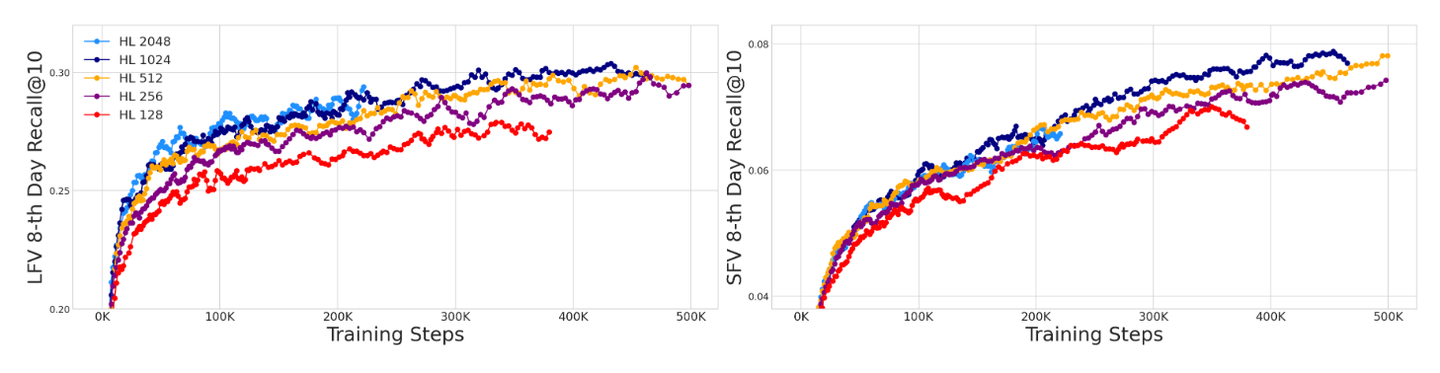
- 历史长度:LFV/SFV 的 8th-Day Recall@10 在约 1K watches 后开始饱和,扩到 2K 对 SFV 不一定更好。
- Batch size:相对 4K batch,8K 的 SFV/LFV 8th-Day Recall@10 提升 +2.5%/+5.5%,16K 提升 +7.6%/+13.7%。
优势与局限
优势
- 离散与连续双表征互补:SID user tokens 捕获语义化、多兴趣、可 grounding 的离散未来兴趣;dense embedding 保持对现有下游模型的兼容性。
- 真正面向工业规模:论文验证了 full user traffic、billions of users、多个 YouTube surface 的上线,而不是只停留在离线 benchmark。
- 跨场景成本优势明确:共享 SID vocabulary 与 multi-context decoding 让 LFV/SFV 可以共用一次 encoder pass,训练与上游服务 compute 分别下降 50% 与 31%。
- 接入路径务实:通过异步 UBS/KV 缓存,重模型生成成本不进入实时 ranking latency;下游只需要消费预计算 token/embedding。
- 训练设计有充分消融:多目标、look-ahead、SID truncation、CPT、search query 都有对应 offline 或 online 证据。
局限
- 主要实证集中在 YouTube 内部系统:指标、数据、模型细节和业务场景都是工业私有环境,外部系统迁移效果需要重新验证。
- 论文重点是 ranking integration:虽然提到已用于 retrieval 与 LLM-based production systems,但公开实验主要围绕 ranking,其他任务的收益边界没有展开。
- SID 体系依赖前置内容表征与 RQ-VAE:TokenMinds 的用户 token 质量高度依赖视频 SID 的语义稳定性、层级粒度和 CPT 对齐质量。
- 异步刷新存在时效性取舍:24 小时 refresh cadence 与 cache 机制适合吸收重模型成本,但对极短期兴趣漂移的响应需要依赖刷新策略与下游实时特征补足。
- 公式层面的 encoder embedding 监督较间接:dense embedding 主要通过 decoder cross-attention loss 学到,论文未给出独立 embedding loss 或更细粒度的 embedding 目标消融。














