

- 论文标题:MMRM: A Multiplex Multimodal Representation Model for Product Ranking in E-commerce Search
- 论文链接:https://zhuanlan.zhihu.com/p/2077823873244993251
- 论文作者:Zhen-Lin Chen, Maosen Sheng, Peng Lin, Jianmin Chen, Zhuojian Xiao, Dongyue Wang, Xiwei Zhao
- 一句话总结:MMRM 用共享 MLLM 骨干 + 任务专用 token,一次前向生成多路解耦的 item 表示,并通过任务专用软检索构造用户表示,大幅提升电商搜索 CTR/ACR/CVR 排序效果。
背景与动机
电商搜索排序要同时优化点击率(CTR)、加购率(ACR)、转化率(CVR),传统纯 ID 排序模型受数据稀疏与缺乏商品语义两点制约。近期兴起的做法是用多模态大语言模型(MLLM)吃商品标题、图片和属性,通过协同信号微调后产出 item 表示,再作为特征喂给排序模型。
作者指出现有方案存在两大结构性问题:
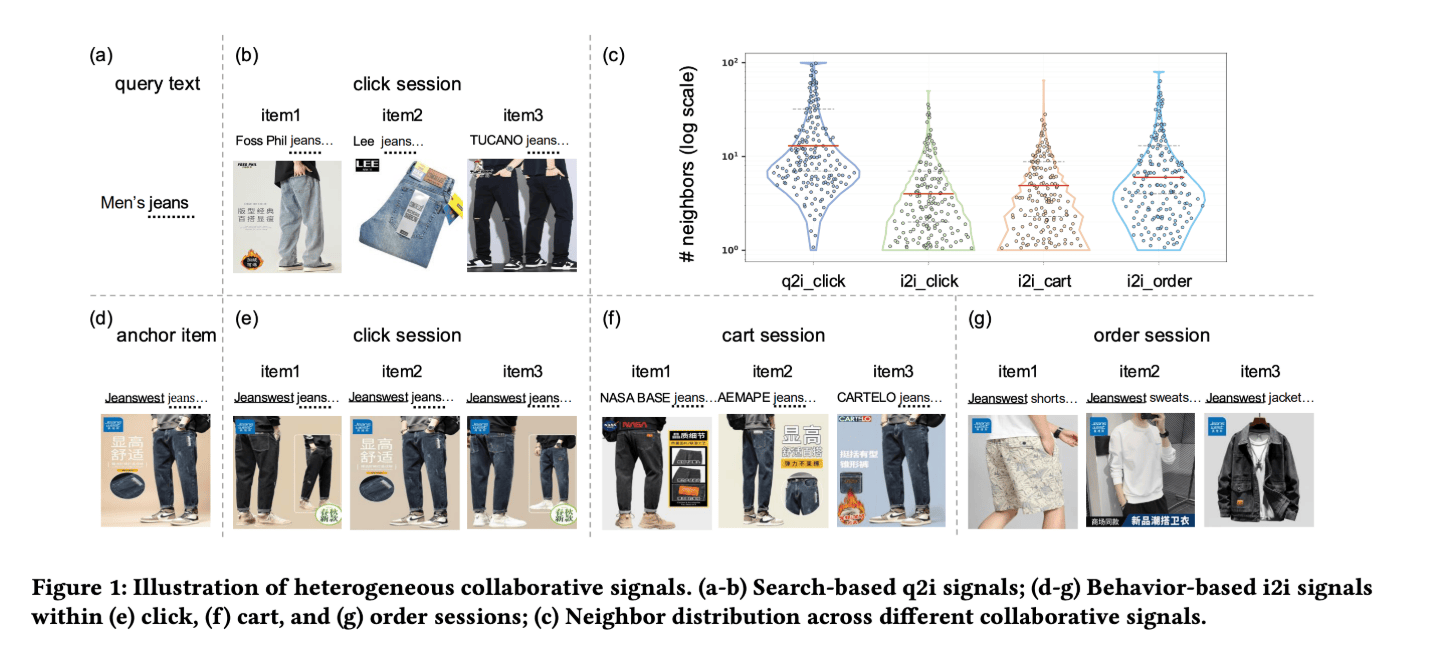
- 单一协同信号微调:只用 q2i_click(基于搜索的 query→item 点击)或 i2i_click(基于行为的 item→item 点击)对齐 MLLM,忽略了加购 cart、下单 order 等更细粒度、语义更强的协同信号,导致表示在多任务排序中覆盖不全。
- 多模态表示仅当普通特征使用:下游排序模型通常只有一张多模态 embedding 表,用来做手工特征交互或简单行为分组,忽视了“用多路表示做用户行为建模”的潜力,容易产生 embedding 纠缠。
论文的核心动机是:在共享 MLLM 骨干上显式对齐多路异质协同信号,并将多模态表示升级为多任务用户建模的检索键,解决多任务排序中的信号纠缠和信息损耗问题。
整体架构
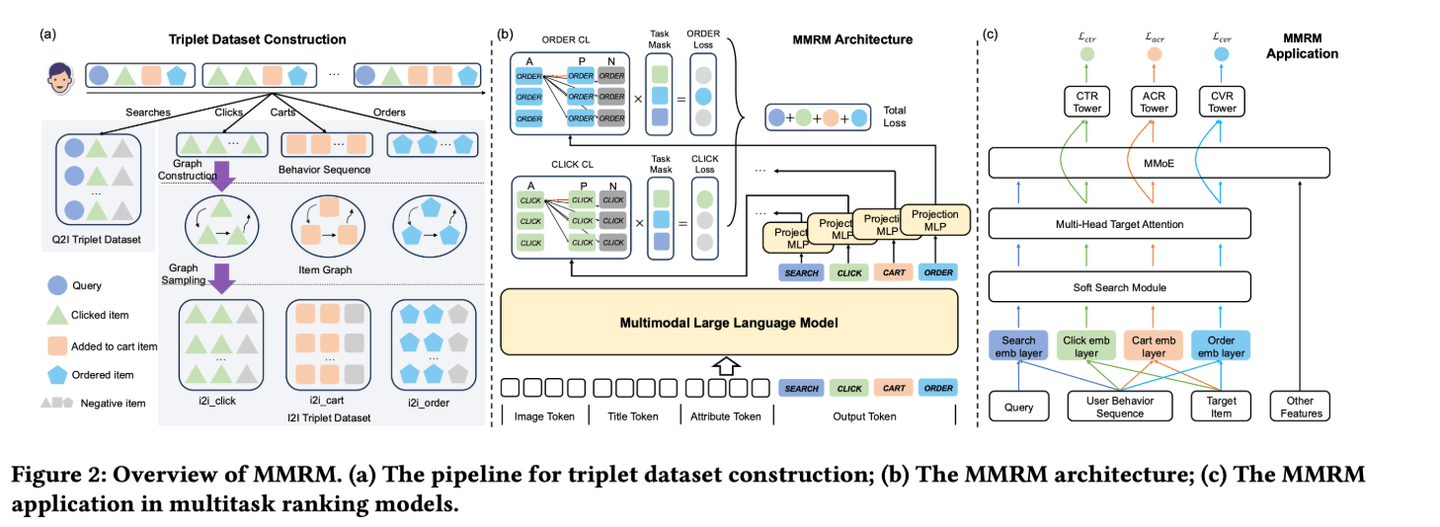
端到端流程分为三层:
- Triplet 数据构造(Fig. 2a):
- 从用户会话中抽取 q2i_click 与三路 i2i(click, cart, order),构造四个 triplet 数据集(query/item 图像/标题/属性)。
- 利用图构造(Graph Construction)与图采样(Graph Sampling)从 i2i 行为序列中挖掘高频邻居与 hard negative,形成丰富的对比学习样本。
- 多路复用多模态表示模型 MMRM(Fig. 2b):
- 统一使用一个多模态大语言模型(Multimodal Large Language Model)作为骨干,输入包含图像 token、标题 token、属性 token 与四个任务专用 token:[SEARCH]、[CLICK]、[CART]、[ORDER]。
- 对每个任务 token 的最后隐层状态分别通过任务专用投影 MLP,得到四路 item 表示 r_i^{SEARCH}, r_i^{CLICK}, r_i^{CART}, r_i^{ORDER}。
- 多任务排序模型应用(Fig. 2c):
- 为每个排序目标(CTR, ACR, CVR)构造任务专用用户表示:利用对应路的 item 表示对用户行为序列做 Soft Search,得到检索子序列,再用 Multi-Head Target Attention(MHTA)聚合成任务专用用户向量。
- 把所有任务的用户表示与目标特征送入多任务塔 MMoE(Multi-gate Mixture-of-Experts),经任务塔输出 CTR/ACR/CVR 预测。
模块拆解
多路复用多模态表示模型
模块作用:在共享 MLLM 骨干中显式为每路协同信号分配任务专用 token 和投影头,一次前向生成解耦的多路 item 表示。
输入输出张量
- 输入多模态序列:X ∈ R^{B×L×D},其中 B 为 batch size,L 为 token 序列长度(包含图像 patch、文本 token、属性 token 以及任务专用 token),D 为隐藏维度。
- 对每个任务 t ∈ {SEARCH, CLICK, CART, ORDER},输出 item 表示向量:r_i^t ∈ R^{B×D}。
公式

变量说明:
- \mathbf{h}^t_i ∈ R^{B×D}:多模态大语言模型骨干中,对任务专用 token t 的最后隐层表示,聚合了当前商品图像、标题和属性的语义信息。
- \mathrm{MLP}^t:任务 t 专用的投影多层感知机,将隐层表示映射到任务特定的 item 表示空间。
- \mathbf{r}^t_i ∈ R^{B×D}:任务 t 下商品 i 的多模态表示,用于对齐协同信号和驱动下游排序。
通过为每个任务提供独立的 token 与投影头,MMRM 避免了“共享一个 [EMB] token”导致的表示纠缠,使得在相同骨干参数下,四路表示可以各自对齐自己的协同信号。
多任务排序模型与任务专用用户建模
模块作用:利用 MMRM 的多路 item 表示,对用户行为序列进行任务专用软检索和多头注意力聚合,得到任务专用用户表示,再送入多任务塔完成排序。
输入输出张量
- 用户行为序列:S ∈ R^{B×T×D},T 为行为序列长度,每条行为包含商品多模态标识与其他特征。
- 多路 item 表示:r_i^t ∈ R^{B×D},来自 MMRM 表示模型。
- Soft-Search 检索子序列:S'_t ∈ R^{B×K×D},K 为任务 t 下选出的相关行为个数(Top-K)。
- 任务专用用户表示:U_t ∈ R^{B×D}。
核心公式(排序模型部分)
论文给出了多任务对比损失与排序损失的统一表达式,其中对比损失为:
其中:
- r^t_{ia}:任务 t 中第 i 个样本的 anchor 表示(query 或 anchor item)。
- r^t_{ip}:正样本表示,例如点击或同一会话中的正向邻居。
- r^t_{in}:负样本表示,来自采样的 hard negative 邻居。
- \tau^t:任务 t 的温度系数,控制对比损失的软硬程度。
- \mathbb{1}_t(i):指示函数,样本 i 是否属于任务 t。
用词向量点积作为相似度,分母汇总所有正负候选,使得 MMRM 在对比学习中既拉近正样本,又显式压远 hard negative,从而对齐多路协同信号。
排序模型的多任务损失则通过对各任务交叉熵损失加权求和:
变量说明:
- \gamma^t:任务 t 的损失权重,反映不同协同信号在整体训练中的重要性。
在实际排序塔中,作者采用多头目标注意力(MHTA)和 MMoE:
并用 MLP-based 排序塔输出预测:
变量说明:
- I/Q:当前请求的目标 item 或 query。
- S'_t:在任务 t 下,从行为序列中软检索出的相关子序列。
- U_t:任务 t 专用用户表示,由多头目标注意力聚合得到。
- O_t:任务 t 的附加特征,如场景或业务配置。
- X_t:经过 MMoE 处理后的任务专用特征表示。
- \hat{y}_t:任务 t 的最终预测(如 CTR、ACR 或 CVR)。
数据集构造细节
论文构造了四个数据集,其统计如 Table 1 所示:
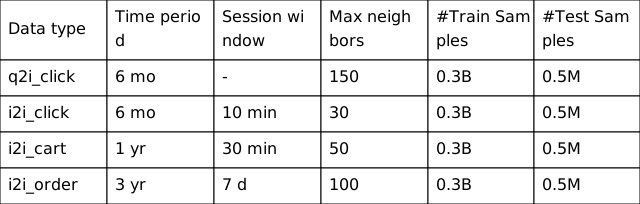
这些数据集共同支撑了 MMRM 在对比学习阶段对齐多路协同信号,在排序阶段为多任务塔提供丰富的行为与商品语义信息。
实验分析
论文在京东内部数据集上进行了表示模型评估和排序模型评估。表示评估的核心结论包括:
- 单任务模型只在各自任务上强:如 Single(q2i_click) 在 q2i 上 F1@5=0.1985,但在 i2i_order 上只有 0.0675,说明单任务表示无法统一对齐所有信号。
- 共享 [EMB] token 的 Vanilla-Multi 全面不如单任务模型:任务解耦不足,更加剧了 embedding 纠缠。
- MMRM 在四路任务上全面胜出:在 F1@5 和 NDCG@5 指标上均超越所有 baseline,验证了“任务 token 解耦 + 多路复用”的设计优势。
排序模型评估中,作者对比了 SIMhard(category)、SIMsoft(iteme2c) 与基于 MMRM 的多种变体,最终多路复用方案 SIMsoft(itemMMRM[ALL]) 在 GAUC 上取得最优结果,并在真实线上 A/B 中将 UCTR/UACR/UCVR 分别提升 +0.42%/+0.37%/+0.35%。
优势与局限
优势:
- 任务 token 解耦 + 一次前向多路输出:在保持推理成本近似不变的前提下,同时生成四路解耦表示,避免多模型重复前向。
- 多模态表示升级为用户建模检索键:通过 Soft-Search 与 MHTA,用各自任务对齐的表示重组用户行为序列,提升多任务排序表现。
- 工业落地扎实:在JD电商搜索引擎全量部署,服务千万级日活用户,线上指标显著提升。
局限:
- 短文体量导致方法细节展开有限:对 Soft-Search/MHTA 的具体实现信息有限,对任务权重、hard negative 策略等消融不够系统。
- 表示与排序两阶段解耦可能影响端到端最优性:MMRM 的多模态表示在预训练阶段冻结后注入排序模型,理论上仍存在“表示目标与排序目标不完全一致”的上限问题。












