

(来源:电脑报少年派)
当英伟达CEO黄仁勋正式揭晓备受瞩目的Vera Rubin下一代AI平台时,其中最引人注目的全新底牌,莫过于首次亮相的专用AI推理加速芯片——英伟达LPU(语言处理单元)。
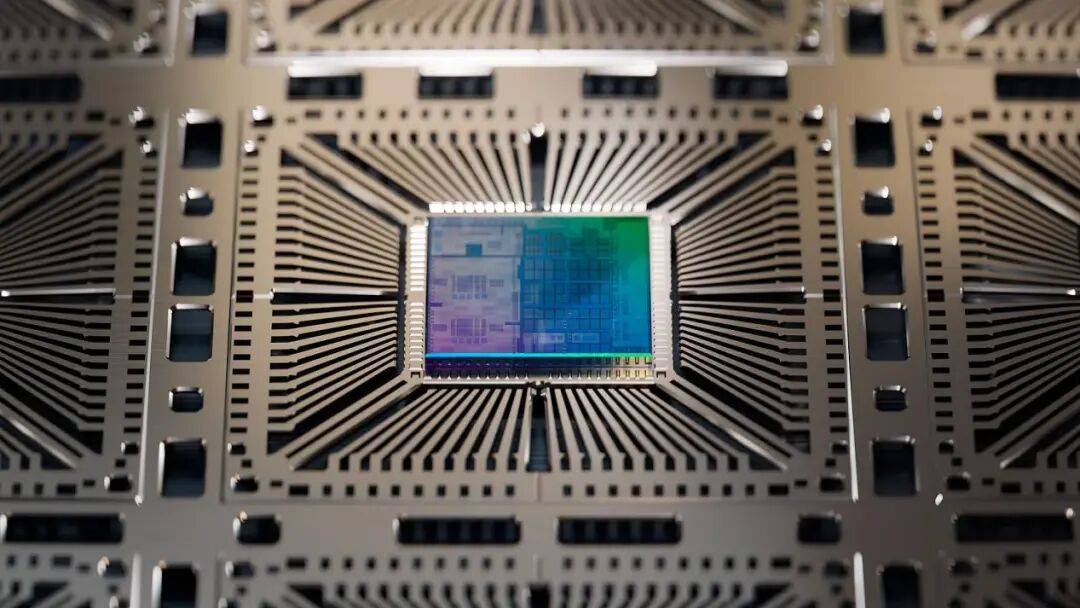
这颗让全行业瞩目的芯片新贵,正是英伟达在完成了那笔轰动一时的200亿美元巨额技术资产收购后,交出的最新成果。最近几年,英伟达凭借强大的GPU几乎垄断了人工智能“训练”阶段的江山;然而,随着大语言模型和智能体的全面爆发,AI战场正悄然从“模型训练”的竞技场转向“应用推理”。这颗被寄予厚望的LPU到底有多强?它与谷歌大名鼎鼎的TPU又有着怎样的本质区别,真的可以颠覆GPU吗?
01
算力界“单项冠军”
要介绍LPU就得先说说芯片初创公司Groq。Groq的创始人Jonathan Ross毕业于纽约大学,师从Meta首席AI科学家杨立昆,曾在谷歌参与TPU(张量处理单元)的早期研发,负责设计并实现第一代TPU芯片的核心架构与关键模块。
Groq的创始人Jonathan Ross
曾担任谷歌TPU研发主要技术人员
2016年这家公司刚成立的时候,创始人团队推出了一款名为TSP的流处理器架构,出发点就是想在GPU之外,专门做一个更专一、更高效的推理硬件。虽然当时世界上还没有如今意义上的大语言模型,但在生成式AI爆发之后,他们突然发现这种架构在推理端相较于GPU乃至TPU,都展现出了极大的优势,随即便将它以LPU的概念重新推出了。
2024年,Groq推出推理专用芯片LPU,运行在Groq平台上的Meta Llama 2模型,实现了240token/秒的传输速度,而微软云输出速度仅为20token/秒。所谓推理专用芯片是针对AI大模型训练所需芯片而言的,AI应用进入爆发期后,用于模型推理的芯片需求暴增。
按照Jonathan Ross的说法,GPU的计算流程像是在一条远小于实际需求规模的装配线上反复拆装、重建;而LPU则是让计算在大量芯片之间一次性按顺序完成,其单位token能耗约为GPU的三分之一。
而面对众多公司开始自研推理芯片的竞争压力,黄仁勋带领的英伟达选择低调而迅速收编了Groq的技术成果。
02
LPU的极速密码
要理解LPU为什么快,我们不妨举个例子。
GPU像是一个根据产量不断调整的现代化汽车产线,它虽然拥有极强的并发计算能力,但并不擅长独立思考。在运行大模型时,它高度依赖外部中央处理器的频繁调度,这就带来了巨大的“开销”。更致命的是,GPU内部数据需要在复杂的“仓库”和“柜台”之间来回搬运,一旦发生零件没接上的情况,计算单元就必须停下来原地等待,导致整体吐字速度忽快忽慢,产生不可避免的延迟。
相比之下,LPU的运行逻辑则是精确到毫秒级、没有任何临时变动的高铁时刻表。
为了彻底打破这种芯片内部的交通堵塞,它在设计之初就直接舍弃了传统的缓存概念,而是把速度极快但成本高昂的专用存储介质直接铺满了整颗芯片。这种直接当成主内存的做法,让单片LPU的内部读写带宽达到了惊人的每秒150TB,比英伟达顶级的GPU还要高出近7倍,主要是数据在芯片内部传输变得飞快。
不仅硬件带宽高得惊人,LPU的内部布局也极其精妙,它就像一个两边完美对称的工厂。芯片内部平行排列着20条流水线轨道,数据在左侧加工完,可以顺着单向指令直接流向右侧进行下一步计算,根本不需要折返跑,甚至还能在不同的轨道之间上下自如切换、重组,直接把流动效率拉满。
而LPU最核心的秘密,在于它“软件预知一切”的底层设定。
在AI模型运行之前,它的智能编译器就已经把所有的计算路径和任务,全部固定成了一张绝对静止的固定路线图。它精确地预知了每一条指令、每一个数据流会在哪一微秒到达哪一个开关。
这种默契让它在运行过程中完全不需要外界的实时指挥,更没有资源争抢——因为运行过程百分之百可预测,根本没有复杂的层级搬运和调度争用,因此LPU输出文字的速度不仅快到人肉眼无法分辨,更是稳如磐石,彻底消除了传统芯片那种卡顿的波动感。
03
GPU 当大脑,LPU 当“嘴巴”
既然LPU这么强,它是否会彻底终结GPU的时代?答案是:不会,它目前仍是GPU的补充,而不是替代者。甚至在大模型推理任务中,它们实际上在互相配合。
GPU的优势在于高度的并行计算能力和庞大的HBM显存,因此它在推理时率先负责前期的预处理以及注意力计算。而LPU的优势在于极小的延迟和变态的带宽,它重点负责的是前向传播过程。
换句话说,LPU主要用来存储模型的权重,然后发挥低延迟特性,源源不断地向外“蹦”出字来,整个过程循环往复直到全部生成完毕。
当前市场正演进出两条截然不同的路线。英伟达走的是非对称的方案,即保留GPU核心,用LPU来接管一部分任务。而谷歌、微软、Meta、亚马逊等云服务厂商,以及大模型巨头OpenAI,他们走的是“平台替代策略”。
这些厂商希望直接用自研的专用芯片来替代英伟达,而且这类芯片在推理端的绝对技术门槛其实并没有想象中那么高,OpenAI在AI服务下甚至只用了9个月就完成了流片。
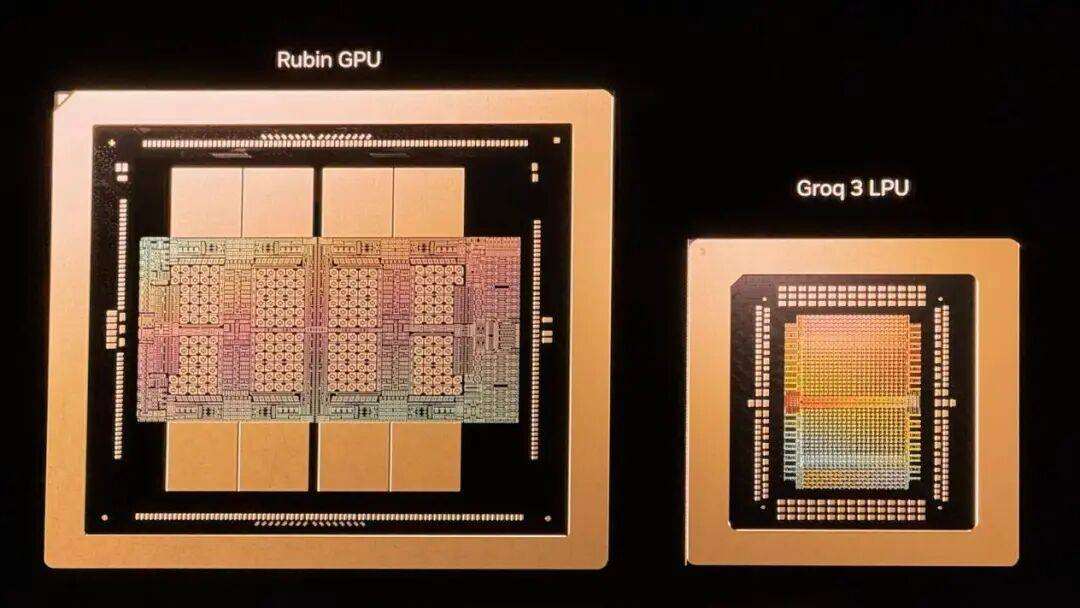
英伟达
选择收购Groq核心技术和人员以补足自身的短板
可以看到,GPU方案长期主导AI芯片市场,但技术路线正出现分化。黄仁勋正是因为感受到压力,才选择收购Groq核心技术和人员,这样既能补足自身技术能力短板,也能达到一些瓦解对手的效果。
对于未来的算力分配,黄仁勋曾在发布会上做出一个极具预言色彩的判断,他认为,未来的现代数据中心将彻底转型为“AI 词元(token)工厂”,随着智能体生态的重构,每次查询产生的token数量正呈指数级增长,“我预计,未来数据中心里至少有25%专门用于编码应用的算力空间将被划归给LPU,剩下的则由多芯协同的通用系统接管”。













