

- 论文标题:xHC: Expanded Hyper-Connections
- 论文链接:https://zhuanlan.zhihu.com/p/2077822600084992467
- 论文作者: Xiangdong Zhang, Xiaohan Qin, Sunan Zou, Tuo Dai, Xiaoming Shi, Huaijin Wu, Yebin Yang, Zhuo Xia, Shaofeng Zhang, Lin Yao, Yuliang Liu, Yu Cheng, Junchi Yan
- 一句话总结: xHC 把 Transformer 的单路残差流扩成 16 路记忆流,并用“时序特征增强 + 稀疏写回”同时解决信息不够和计算太贵两个瓶颈,让大规模残差流扩展第一次在 18B/28B MoE 预训练里既有效又划算。
背景与动机
Hyper-Connections(HC)把 Transformer 里原本只有一条的残差流,扩成 N 条并行残差流。直觉上,这相当于给每一层都准备了一组“可学习的跨层记忆槽位”,模型不只靠加宽、加深、加数据来扩容,还能沿着“残差记忆容量”这个新轴继续扩展。已有工作表明,从 N=1 扩到 N=4 收益很明显,但再往上基本停在 N=4。
这篇论文的核心不是“再堆更多 stream”,而是先解释为什么 mHC 扩不动。作者把问题拆成两个瓶颈。第一个是信息供给不够:虽然有 N 条 stream,但每层只写回一个 out ∈ R^C,不同 stream 只是给同一个 out 乘不同权重,N 大了以后这些 stream 很容易学成相似历史。第二个是计算代价过高:mHC 需要从 NC 维状态预测 N×N 的残差混合矩阵 H^{res},主成本是 O(N^3 C),N 一大,FLOPs 很快失控。
作者的目标很明确:想把“残差流扩展率 N”从一个只在小范围有效的小技巧,变成真正可用的 scaling axis。xHC 就是围绕这个目标设计的:一边给写回信号补充更多信息,一边只让少数 stream 真正参与昂贵更新。
整体架构
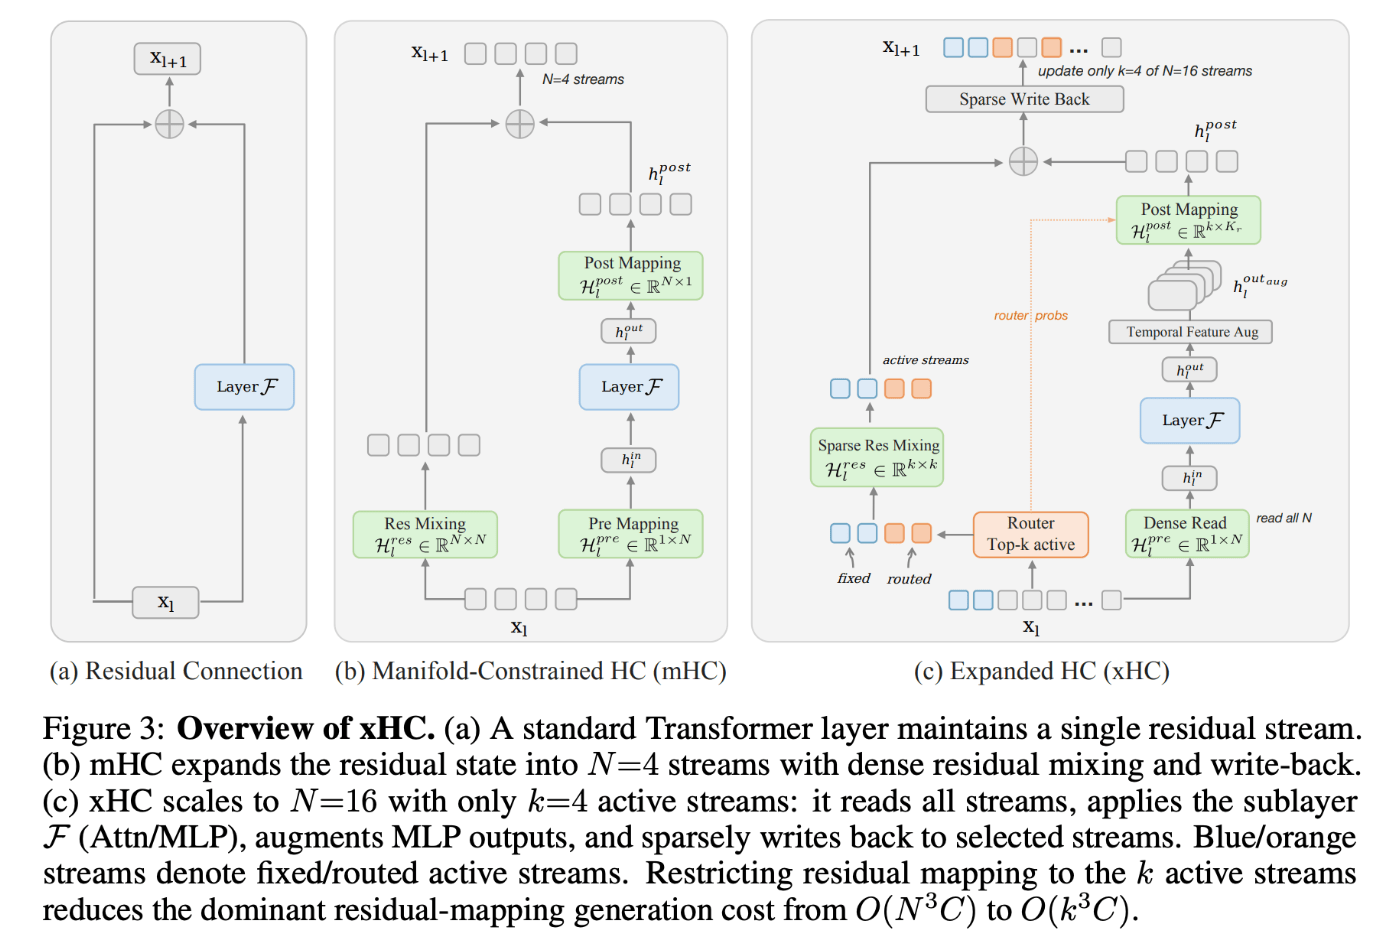
标准 Transformer 每层只维护一个残差向量;mHC 把它扩成 N 条流,并在每层做“聚合读入 → 子层计算 → 写回 + 流间混合”;xHC 进一步把总流数扩大到 N=16,但每个子层只更新 k=4 条 active streams。它的端到端数据流可以概括为:多流状态 X_l 先经过 router 选出 active streams;所有 N 条流仍被密集读出形成子层输入;子层 F(Attention 或 MLP)产生输出;如果当前是 MLP 子层,再做时序特征增强得到多分量写回基;最后只对 active streams 做稀疏残差混合和写回,其余 stream 原样向后传递。
这个结构里最关键的设计取舍有两个。第一,读是 dense 的,写是 sparse 的,因为如果连读也稀疏,上一层写进某个 stream 的信息,下一层可能根本读不到。第二,时序增强只放在 MLP 后面,不放在 Attention 后面;论文明确说在 Attention 后做这件事会让训练变得不稳定。
- 一句话看懂 xHC: 用 N=16 提供更大的残差记忆池,用 k=4 把昂贵更新压回小常数规模,再用多尺度因果卷积把“每层只写一个向量”的窄写回,扩成“每层写多个互补分量”。
模块拆解
3.1 HC / mHC 基线:多流残差状态怎么更新
模块作用:把原本单路残差连接,改成 N 条可学习混合的残差流。
输入是多流状态 X_l = (x_{l,1}, ..., x_{l,N})^\top ∈ R^{N×C},其中 N 是 stream 数,C 是 hidden size。输出是下一层状态 X_{l+1} ∈ R^{N×C}。
HC 的单层更新写成:
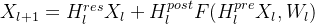
变量说明:
- X_l ∈ R^{N×C}:第 l 层输入的多流残差状态;每一行是一条 stream 的表示。
- H_l^{pre} ∈ R^{1×N}:pre-mapping,把 N 条流加权聚合成一个送入子层 F 的输入。
- F(·, W_l):当前子层函数,可能是 Attention,也可能是 MLP;输出 shape 是 R^C。
- H_l^{post} ∈ R^{N×1}:post-mapping,把子层输出重新分发回 N 条流。
- H_l^{res} ∈ R^{N×N}:残差流之间的混合矩阵。
- X_{l+1} ∈ R^{N×C}:更新后的多流状态。
这套写法的问题在于,如果 H_l^{res} 完全自由,随着层数加深,残差路径不再像普通残差连接那样天然保留 identity 路径,训练容易发散。mHC 的修复方式,是把 H_l^{res} 约束到双随机矩阵流形上:
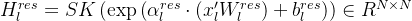
变量说明:
- x'_l ∈ R^{NC}:把 X_l flatten 再归一化后的向量。
- W_l^{res} ∈ R^{NC×N^2}:从当前多流状态预测残差混合矩阵 logits 的投影矩阵。
- \alpha_l^{res}、b_l^{res}:可学习缩放和偏置。
- SK(·):Sinkhorn-Knopp 归一化,把矩阵投影成行和列都约束为 1 的双随机矩阵。
- H_l^{res} ∈ R^{N×N}:稳定训练所需的残差混合矩阵。
mHC 解决了稳定性,但也把主成本锁定在 W_l^{res}: R^{NC} → R^{N^2} 这一步。N 从 4 增加到 16 时,收益没有跟上成本增长。
3.2 信息瓶颈:为什么 N 变大后 stream 会越来越像
模块作用:解释 mHC 为什么在大 N 下收益饱和。
在 mHC 里,第 i 条 stream 的写回是:
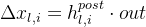
变量说明:
- \Delta x_{l,i} ∈ R^C:第 l 层对第 i 条 stream 的新增写回。
- h_{l,i}^{post} ∈ R:第 i 条 stream 对当前层输出的标量写回权重。
- out ∈ R^C:当前子层唯一的输出向量。
这说明所有 stream 共享同一个写回基底 out,差别只是乘的系数不同。N 小时问题不大;N 大时,额外 stream 并没有拿到新的“可写入内容”,只能反复重组同一个 out,最终越来越冗余。论文后面的 Figure 5 就是在验证这个诊断:随着 N 变大,单独补充 temporal augmentation 的收益越来越大,说明大 N 时信息供给确实更缺。
3.3 时序特征增强:把一个写回向量扩成多个互补分量
模块作用:给每层写回提供更丰富的 basis,让更多 stream 真正学到不同历史。
作者把 MLP 子层输出从单个向量,扩成多尺度的局部上下文特征。临时恢复序列维后,记 out ∈ R^{S×C},其中 S 是序列长度。对它做 r 个因果 depthwise 1D convolution,并与原始输出拼接:
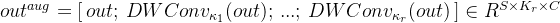
变量说明:
- out ∈ R^{S×C}:MLP 子层输出;S 为 sequence length,C 为 hidden size。
- DWConv_{\kappa_j}(out) ∈ R^{S×C}:第 j 个因果深度卷积分支,卷积核大小为 \kappa_j。
- r:卷积分支数。论文主设定里 r=3。
- K_r = r+1:增强后分量总数;主设定是 K_r=4。
- out^{aug} ∈ R^{S×K_r×C}:用于后续写回的多分量表示。
论文主设定使用 \{4, 8, 12\} 三个 kernel size,所以每个 token 最终有 4 个候选写回分量:原始输出 + 3 个不同感受野的局部上下文特征。这样不同 stream 不需要再从同一个 out 上抢信息,而是可以组合不同尺度的写回成分。
但卷积分支和原始输出可能高度相关,直接拼起来会让写回放大同一个方向。作者因此加了 modified Gram-Schmidt 正交化:

变量说明:
- g_j ∈ R^{S×C}:第 j 个卷积分支输出。
- v_1 = out ∈ R^{S×C}:正交化的初始基向量就是原始输出。
- v_{j+1} ∈ R^{S×C}:把 g_j 在已有基 \{v_i\} 上的投影去掉后的新基向量。
- \langle \cdot, \cdot \rangle:沿 hidden 维 C 的内积。
正交化后,out^{aug} 不再是“4 份很像的特征”,而是 4 个更互补的写回分量。论文还专门指出:这一步在 AdamW 下有稳定作用,但在 Muon 优化器下可以去掉。
3.4 稀疏 residual-stream 架构:只更新 k 条 active streams
模块作用:把 O(N^3 C) 的主成本改成 O(k^3 C),同时不破坏跨层信息流。
3.4.1 Router:先决定哪几条 stream 本层需要更新
路由器先看完整多流状态 \tilde{x}_l ∈ R^{NC},再输出每条 stream 的重要性分数:
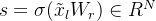
变量说明:
- \tilde{x}_l ∈ R^{NC}:LayerNorm 后 flatten 的全流状态。
- W_r ∈ R^{NC×N}:router 投影矩阵。
- \sigma(·):sigmoid,逐 stream 输出 (0,1) 范围内的分数。
- s ∈ R^N:每条 stream 的路由分数。
作者不用 softmax,而用 sigmoid,原因很实在:softmax 太 winner-take-all,容易让少数 stream 长期霸占写回机会,其余 stream 越学越死。表 2 里也验证了这一点,sigmoid router 的验证损失好于 softmax router。
然后用“fixed + routed”选 active streams:
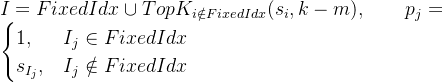
变量说明:
- FixedIdx:始终激活的固定 stream 集合。
- m:固定 active streams 数量;主设定里 m=2。
- k:每层总 active streams 数量;主设定里 k=4。
- I = (I_1, ..., I_k):本层被选中的 active stream 索引。
- p_j:第 j 条 active stream 的路由权重;固定流直接取 1,动态流取路由分数。
固定流的作用,是给跨层信息传播留出稳定通路,避免每层路由都完全漂移。
3.4.2 Dense Read:所有 N 条流都参与读
xHC 的核心不是“全稀疏”,而是“写稀疏、读稠密”。子层输入仍从全部 N 条流聚合:

变量说明:
- x_{l,i} ∈ R^C:第 i 条 stream 的表示。
- h_{l,i}^{pre} ∈ R:第 i 条 stream 的读权重。
- input_l ∈ R^C:送入当前子层 F 的聚合输入。
- f_{pre}(·):根据完整多流状态生成 pre-mapping 的映射器。
这一步保证:即使某条 stream 本层没被选中更新,它里面积累的信息依然能被下一层看到。论文的 ablation 说明,去掉 Dense Read 会恶化验证损失。
3.4.3 Sparse Write:只对 active streams 生成 H^{res} 和 H^{post}
xHC 不再从完整 N 条流生成 N×N 的 H^{res},而是只在 active state X_{active} ∈ R^{k×C} 上做:
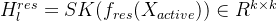
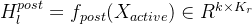
变量说明:
- X_{active} ∈ R^{k×C}:Gather 之后的 active stream 子集。
- f_{res}(·):从 active streams 生成残差混合矩阵的函数。
- H_l^{res} ∈ R^{k×k}:只在 active streams 内部做残差混合。
- f_{post}(·):从 active streams 生成写回权重的函数。
- H_l^{post} ∈ R^{k×K_r}:每条 active stream 对 K_r 个增强分量的组合系数。
对应的具体参数化是:
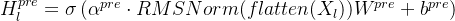
变量说明:
- flatten(X_l) ∈ R^{NC}:全流状态展开。
- W^{pre} ∈ R^{NC×N}:pre-mapping 参数矩阵。
- \alpha^{pre}, b^{pre}:门控缩放与偏置。
- H_l^{pre} ∈ R^{1×N}:dense read 所需的聚合权重。
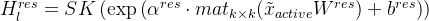
变量说明:
- \tilde{x}_{active} = RMSNorm(flatten(X_{active})) ∈ R^{kC}:active state 归一化后向量。
- W^{res} ∈ R^{kC×k^2}:从 active state 预测 k×k residual mixing 的参数矩阵。
- mat_{k×k}(·):把长度 k^2 的向量 reshape 成矩阵。
- 其余符号与上文一致。
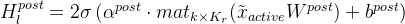
变量说明:
- W^{post} ∈ R^{kC×kK_r}:从 active state 预测写回组合系数。
- mat_{k×K_r}(·):reshape 成 k×K_r 矩阵。
- 2\sigma(·):把系数限制在 [0,2],允许衰减,也允许适度放大。
- H_l^{post} ∈ R^{k×K_r}:每条 active stream 对不同增强分量的线性组合系数。
实际写回是:
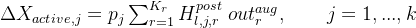
变量说明:
- \Delta X_{active,j} ∈ R^{S×C}:第 j 条 active stream 的新增写回。
- p_j ∈ R:路由权重;固定流取 1,动态流取 sigmoid score。
- H_{l,j,r}^{post}:第 j 条 active stream 对第 r 个增强分量的权重。
- out_r^{aug} ∈ R^{S×C}:第 r 个增强写回分量。
最后 active streams 更新为:
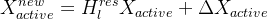
变量说明:
- X_{active} ∈ R^{k×C}:更新前 active state。
- H_l^{res} X_{active} ∈ R^{k×C}:active streams 内部的残差混合结果。
- \Delta X_{active} ∈ R^{k×C}:写回增量。
- X_{active}^{new} ∈ R^{k×C}:更新后的 active streams。
然后再 scatter 回完整 N 条流,其余 inactive streams 保持不变。这样就把原来最贵的 N×N 动态混合,压缩成了 k×k 动态混合。论文主设定是 N=16, k=4,所以“存储容量”按 16 条流扩张,而“昂贵动态更新”只按 4 条流计费。
3.5 xHC-Flash:把内存流量再压下去
模块作用:xHC 已经把 FLOPs 控住了,但大 N 下内存 I/O 还是高,所以作者继续优化工程实现。
xHC 的问题是每个子层要反复读整份 NC 状态,内存 traffic 达到每个 sublayer 73.5C。xHC-Flash 的思路是把一些 full-state 操作在相邻子层之间共享:共享 routing、联合生成 attention/MLP 的 pre-mapping,并用轻量修正替代第二次 full-state dense read。
它在一个 Transformer block 里的关键修正是:先在 block 入口一次性得到 inp_A 和 inp_M,Attention 写回后,不再重新读取全部 N 条流,而是用一个标量修正项更新 MLP 输入:
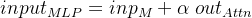
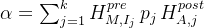
变量说明:
- inp_M ∈ R^C:在 block 入口由 dense read 预先得到的 MLP 基础输入。
- out_{Attn} ∈ R^C:Attention 子层输出。
- \alpha ∈ R:由 active streams 上已有量拼出来的修正系数。
- H^{pre}_{M, I_j}:MLP pre-mapping 在第 I_j 条 active stream 上的权重。
- p_j:第 j 条 active stream 的路由权重。
- H^{post}_{A,j}:Attention 子层对第 j 条 active stream 的写回权重。
这个近似并不是“瞎省一次读”,而是利用 attention 侧写回形式的特殊结构,做出的精确 dense-read correction。最终 xHC-Flash-4sub 可以把每 sublayer 的 I/O 从 73.5C 降到 40C,已经接近 mHC(N=4) 的 34C。
训练目标 / 损失函数
这篇论文没有引入新的训练目标,改的是残差流结构,不是预训练目标本身。训练场景仍然是标准语言模型预训练,因此主目标仍可写成自回归 next-token cross-entropy:
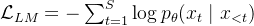
变量说明:
- S:序列长度。
- x_t:位置 t 的真实 token。
- x_{<t}:位置 t 之前的上下文。
- p_\theta(x_t \mid x_{<t}):模型对下一个 token 的条件概率。
- \mathcal{L}_{LM}:语言模型预训练损失。
论文没有额外的 auxiliary loss,也没有路由 load balancing 项;xHC 的收益完全来自结构改造。文中另外出现的
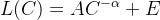
不是训练损失,而是第 4.3 节做 scaling law 拟合时使用的经验曲线。
变量说明:
- C:训练 FLOPs。
- A, \alpha:拟合参数。
- E=0.72:论文设定的不可约 loss 偏置项。
- L(C):用于比较不同方法 compute efficiency 的拟合损失曲线。
实验与分析
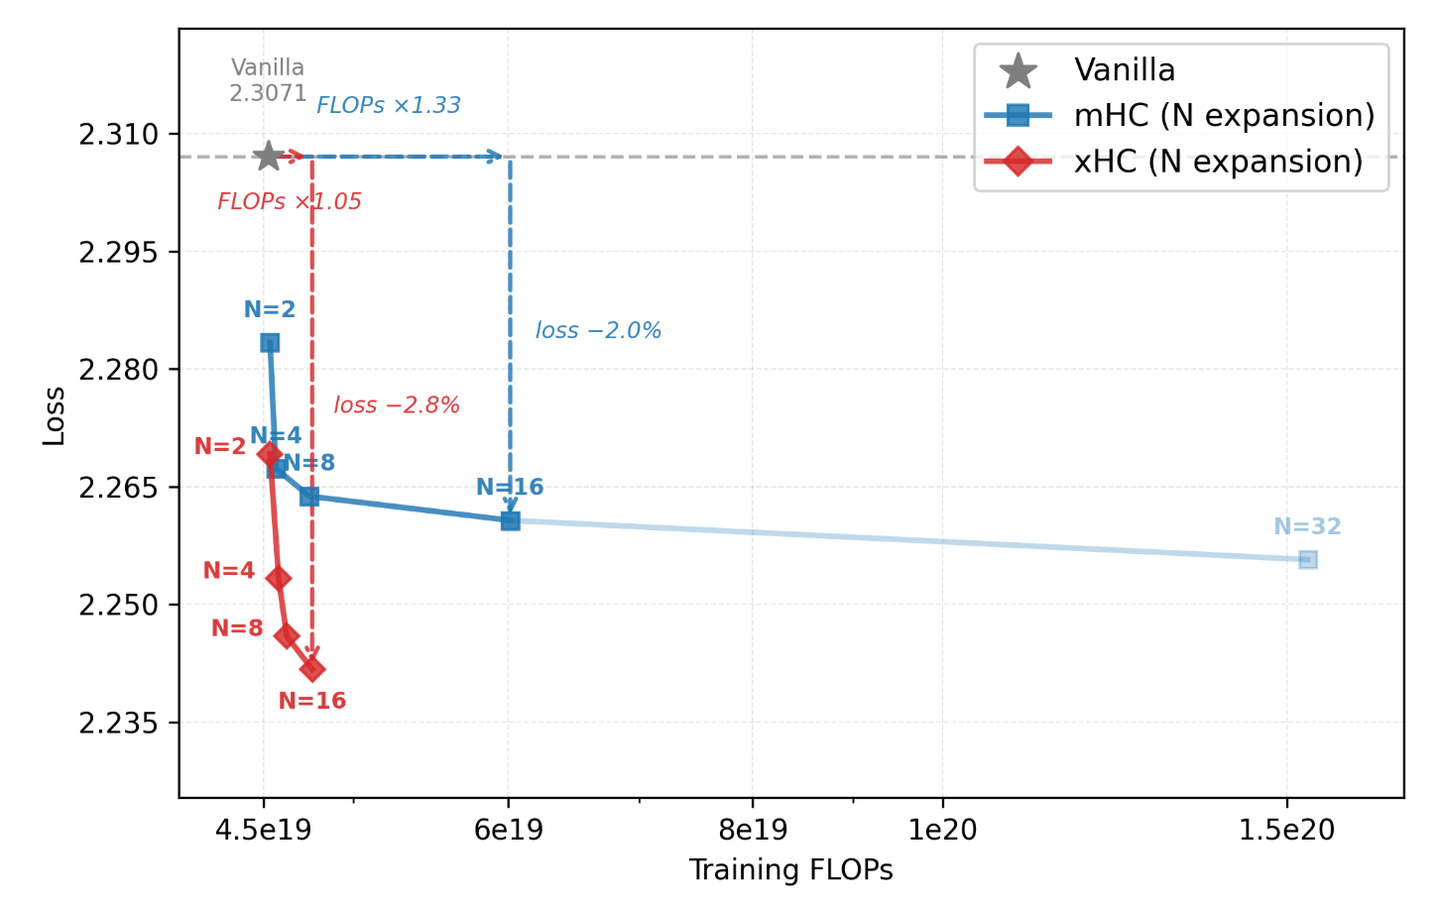
Figure 1 直接回答了这篇论文最核心的问题:把 N 从 4 扩到 16,到底值不值。mHC 的答案是否定的:loss 只下降 0.006,训练 FLOPs 却多了 32%;xHC 的答案是肯定的:loss 下降 0.012,额外 FLOPs 只有 4%。这说明 xHC 不是“把大 N 训练起来了”,而是把大 N 的收益成本比真正改写了。
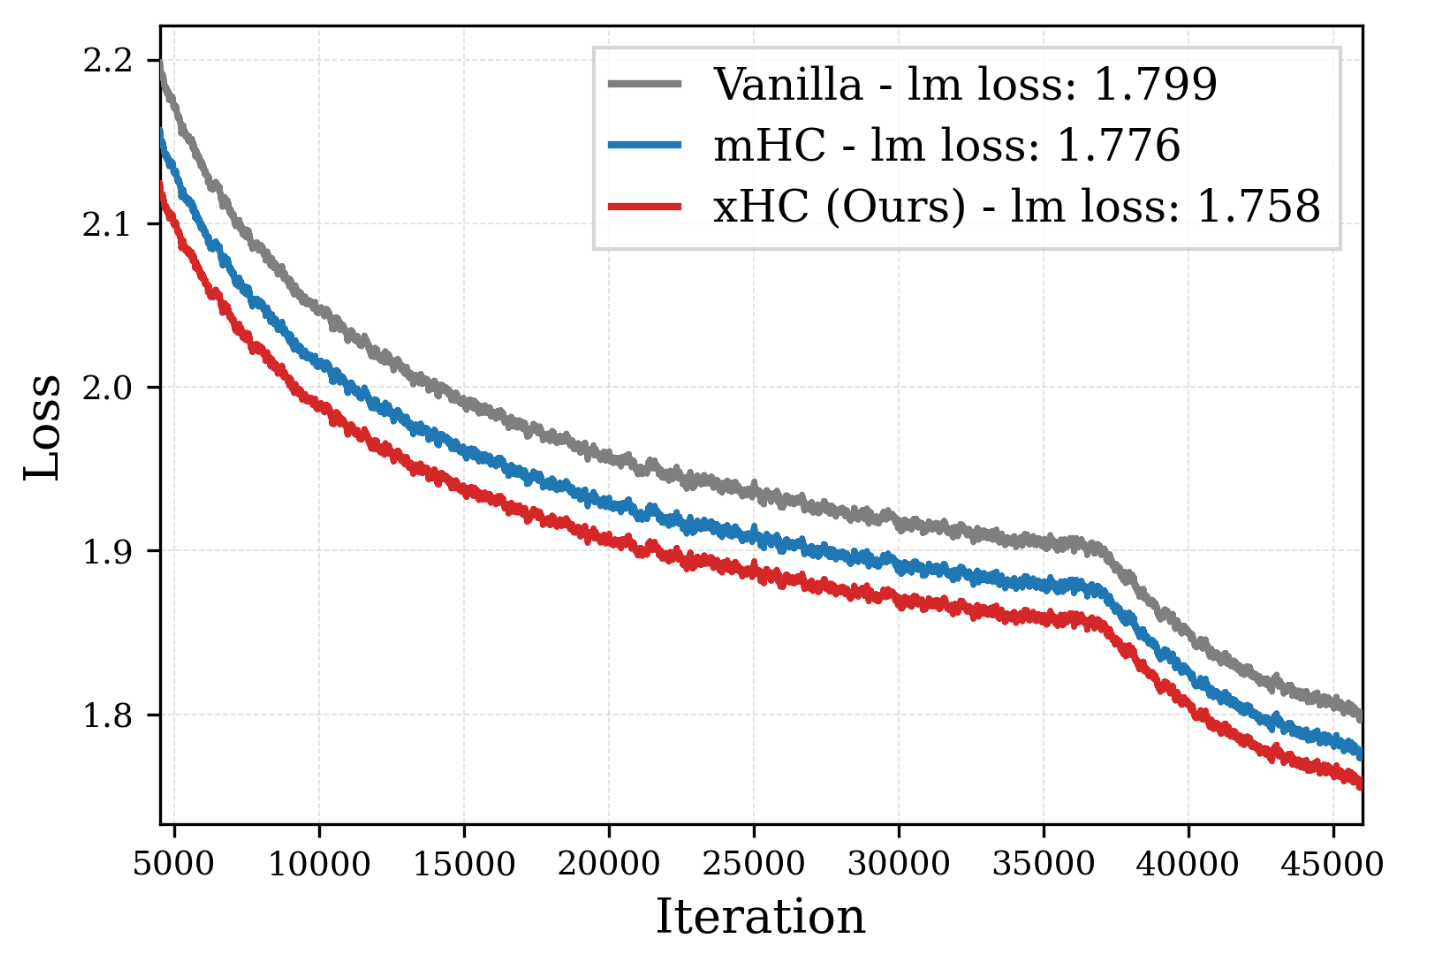

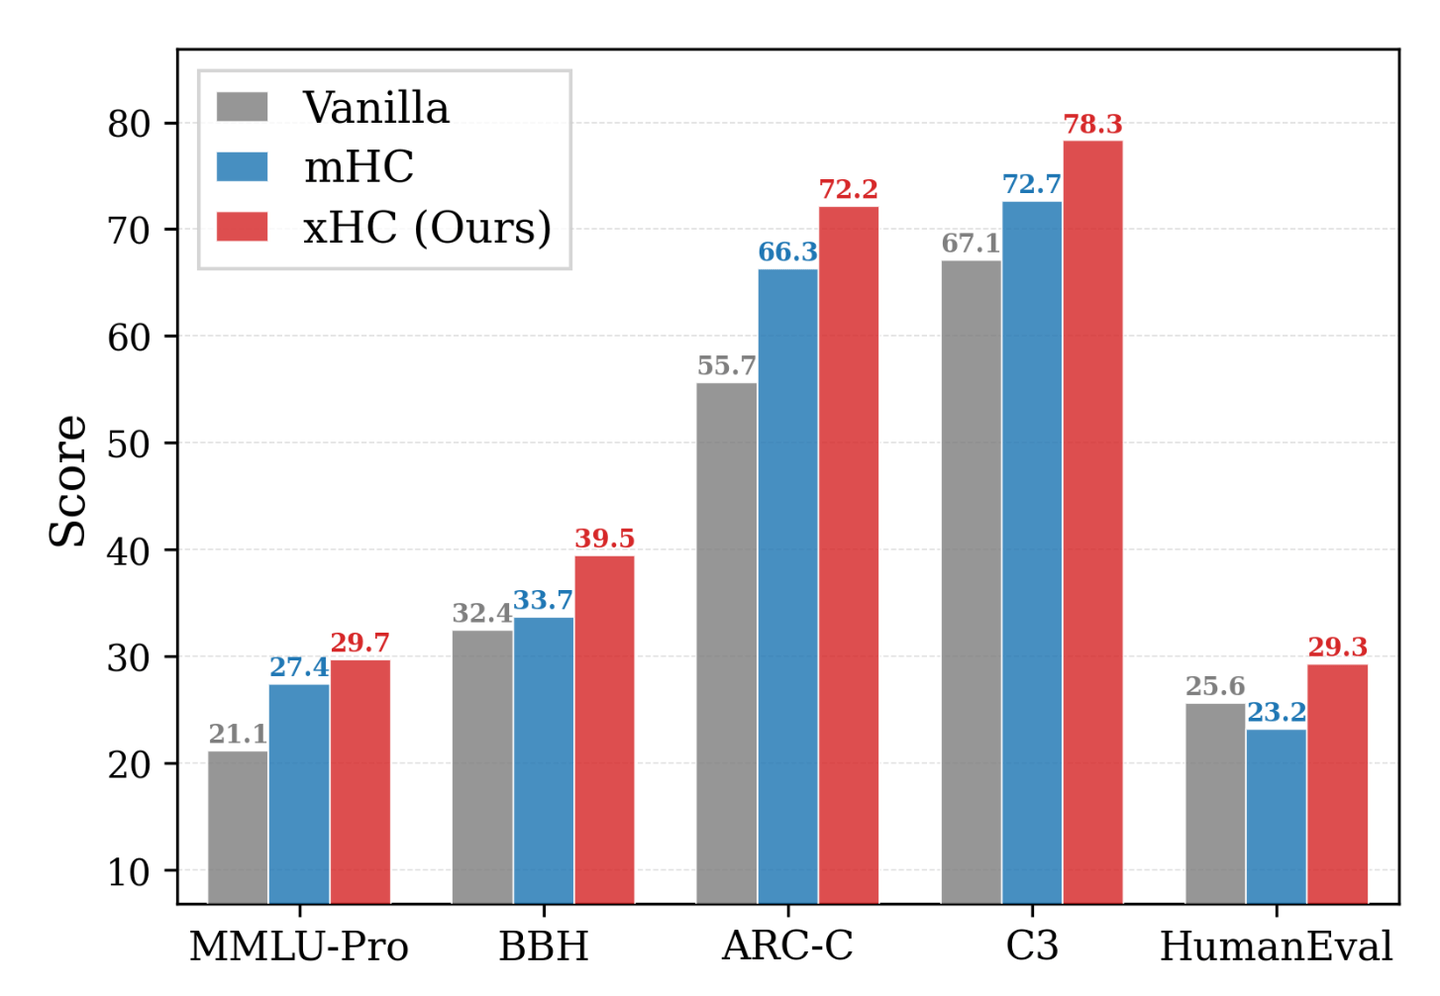
18B 主实验的结论非常直接:xHC 在训练 loss、平均下游分数、代表性 benchmark 上都领先。尤其值得注意的是,xHC 不是只在知识题或者只在推理题上抬一两个点,而是在 reasoning、knowledge、Chinese、code 这几块都有提升,说明 residual-stream expansion 确实给模型带来了更通用的容量。
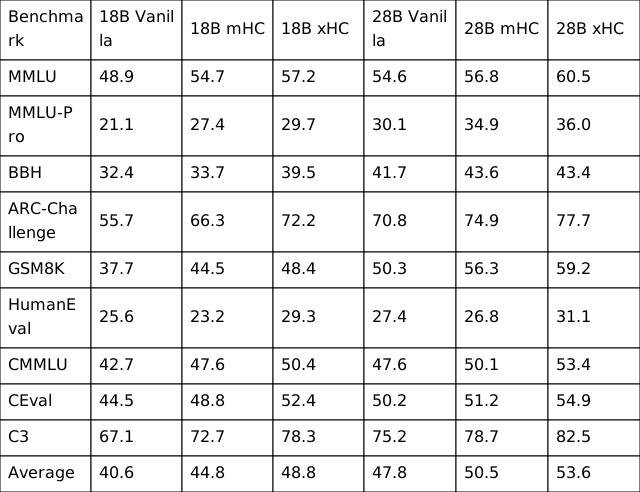
从这张主结果表能看到两个重点。第一,18B 上 xHC 相比 mHC 平均分提升 +4.0,28B 上提升 +3.1,不是只在小模型上有效。第二,28B 上 xHC 只比 vanilla 多 3.0% 训练 FLOPs,却在多项推理和中文 benchmark 上拉开明显差距,说明“扩残差记忆”这条路在大模型里确实有真实增益。
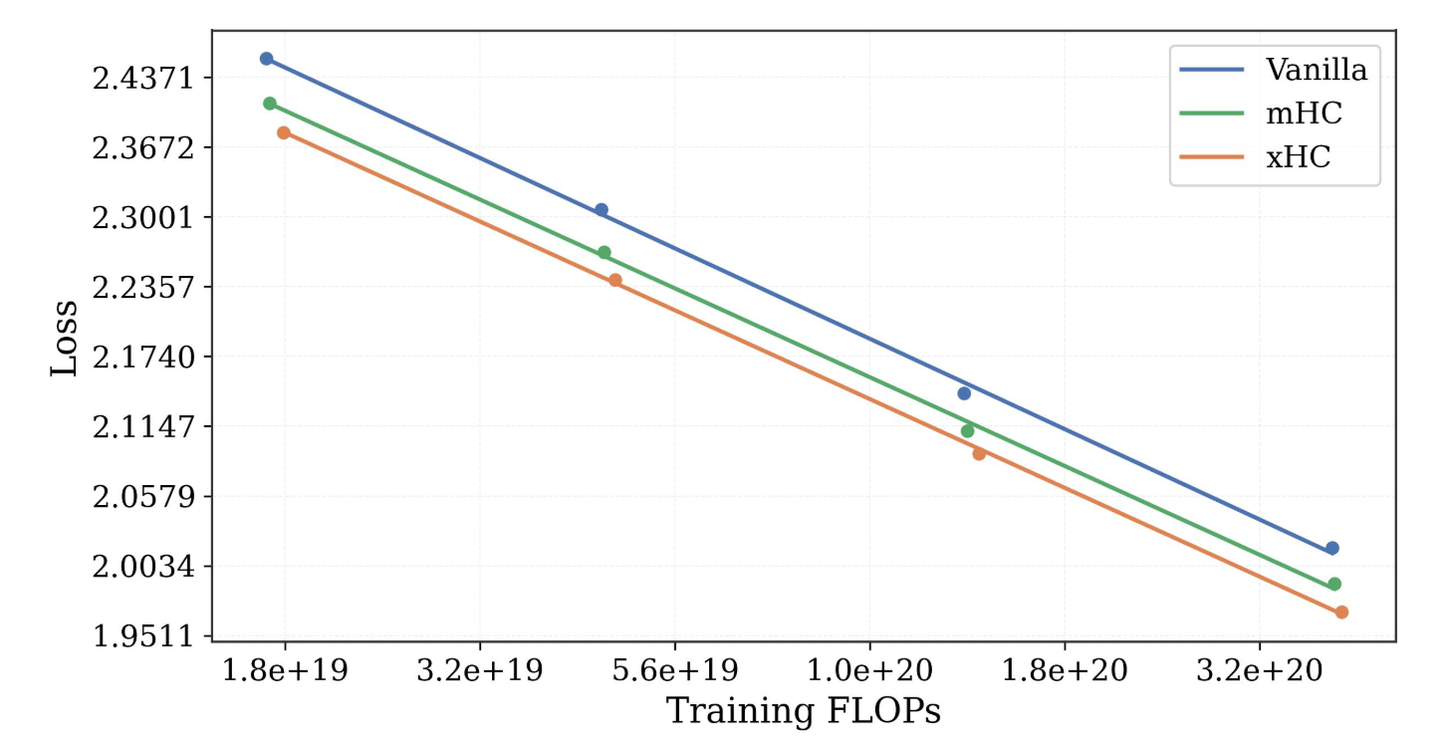
Figure 4 把这个收益从“单点结果”推进到“整个计算区间”。拟合后,为达到同等 loss,vanilla 需要 1.50× xHC 的训练计算量,mHC 需要 1.19×。这意味着 xHC 的优势不是某个评测点凑巧更好,而是在相同 compute 下整条 loss 曲线都更低。
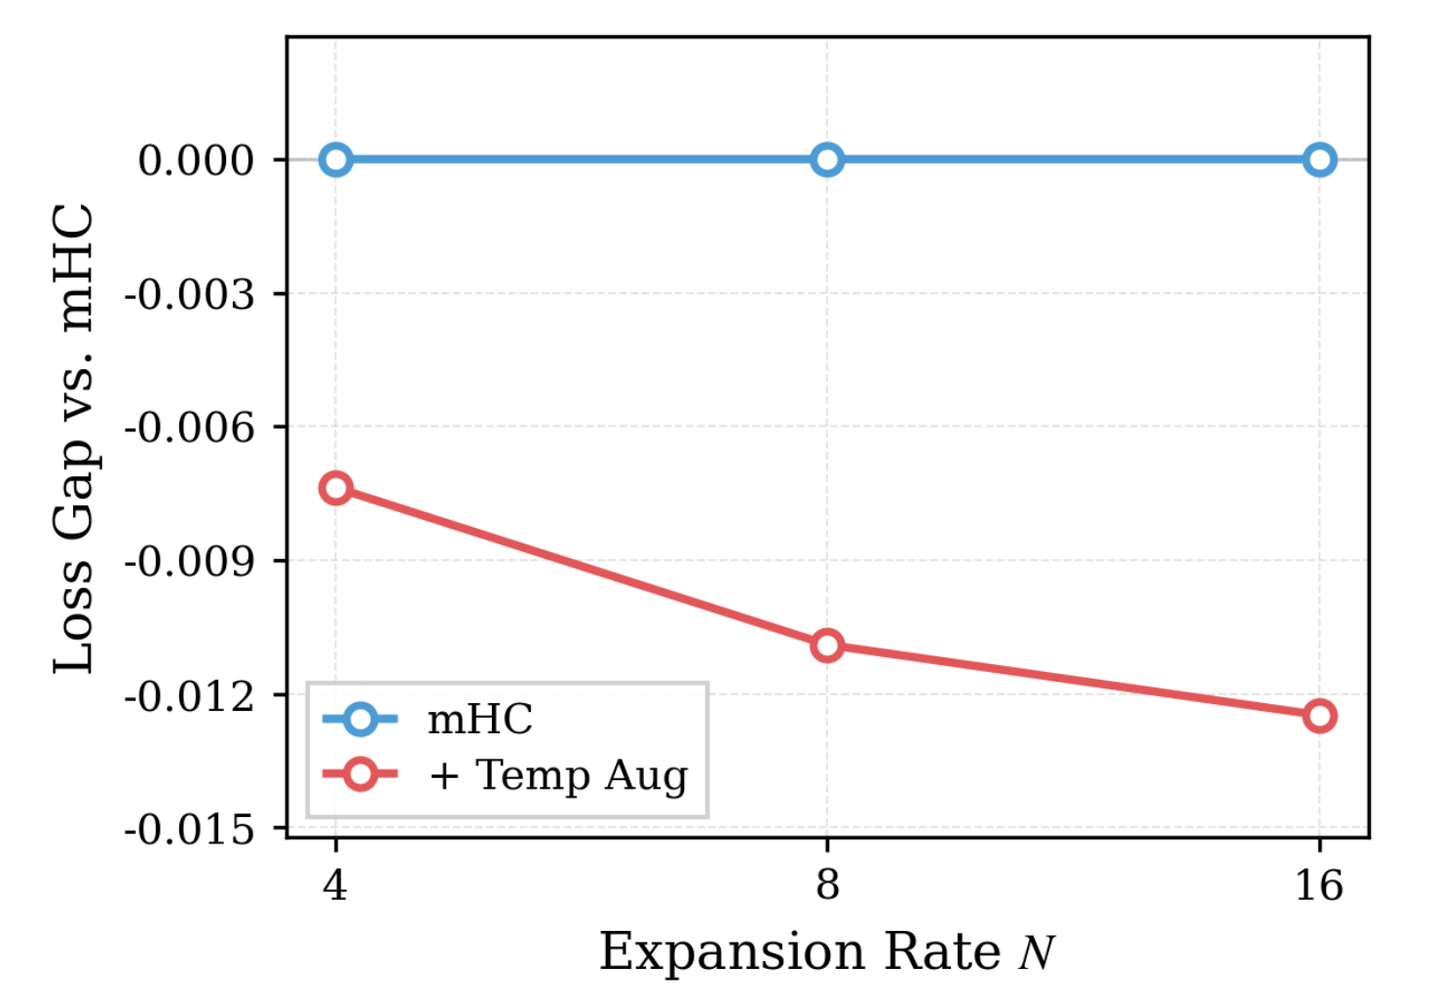
Figure 5 说明 temporal augmentation 的收益会随着 N 变大而变强,这正好对应作者对信息瓶颈的诊断:stream 越多,越需要更丰富的写回基底。
这组消融有三条最重要的结论。第一,只加 temporal augmentation 就能把 16 路 mHC 从 1.998 拉到 1.984,信息瓶颈确实存在。第二,再把 dense update 改成 sparse update,loss 几乎不变,但额外 FLOPs 从 20.1% 掉到 3.3%,说明稀疏更新确实切中了成本主项。第三,Dense Read、Fixed Streams、Sigmoid Router 都不是装饰件,少了它们,稀疏架构就会显著掉点。
最后看部署效率:xHC 每个 sublayer 的内存 I/O 是 73.5C,明显高于 mHC(N=4) 的 34C;xHC-Flash 降到 51C,xHC-Flash-4sub 进一步降到 40C,几乎把工程可用性补齐了。
优势与局限
这篇论文的优势很集中。第一,它不是盲目把 N 扩大,而是先把 mHC 大 N 失效的原因拆清楚,再分别给出结构解法,所以每个模块都能被消融实证支撑。第二,它把“残差流扩展”从 N=4 推到 N=16,而且在 18B、28B MoE 上都能稳定涨点,这说明它不是只适合小实验。第三,它对工程落地是认真的:不仅给出算法改进,还把 memory traffic 和 kernel fusion 单独展开,最终给出 xHC-Flash 这种更接近可部署形态的版本。
局限也写得很清楚。第一,xHC 的主验证都建立在 MoE Transformer 上,论文没有证明同样的收益一定能原样迁移到 dense Transformer 或其他 backbone。第二,大 N 虽然被做成了可用 scaling axis,但 full xHC 的内存 I/O 仍然高于 mHC(N=4),所以必须继续依赖 xHC-Flash 一类工程优化。第三,temporal augmentation 只在 MLP 后使用,论文明确说放到 Attention 后会 destabilize training,这说明它还不是一个可以无脑插到所有子层的通用插件。第四,论文主设定固定在 N=16, k=4,虽然已经证明比 N=4 更优,但更大 N、不同 k/m 配置在更多模型规模上的规律,文中还没有完全展开。













