

摘要:文生图扩散模型是AIGC视觉生成领域的核心技术底座,图像细节缺失、提示词对齐偏差、空间构图错乱、文字渲染失真等问题,长期制约着扩散模型的商业化落地与高精度创作应用。推出的Stable Diffusion 3.5系列模型,作为SD系列迭代升级的新一代文生图架构,包含Large、Medium、Large Turbo三大分级版本,针对前代模型的构图缺陷、细节丢失、语义偏差、文字生成错误等核心痛点完成系统性优化,同时强化高分辨率原生生成、复杂提示词解析、多主体空间逻辑建模能力,并新增FP8轻量化量化部署方案,实现了生成质量、推理效率与落地成本的多维平衡。本文从模型架构迭代、核心画质升级、语义对齐能力、部署性能优化四个维度,结合多场景实测数据与主流竞品横向对比,深度拆解Stable Diffusion 3.5的生成质量优势与技术创新逻辑,剖析其现存性能局限与场景适配边界,为AI视觉生成技术研究、创作者落地应用、工业级视觉设计迭代提供学术参考与实践依据。
关键词:Stable Diffusion 3.5;文生图模型;扩散模型;图像生成质量;提示词对齐;轻量化部署
一、引言
近年来,生成式视觉AI技术高速迭代,以Stable Diffusion为代表的扩散模型凭借开源开放、可定制性强、部署门槛低的优势,成为工业设计、艺术创作、内容生产、虚拟场景构建的主流技术方案。前代Stable Diffusion 3、SDXL等模型虽具备通用图像生成能力,但在高精度创作场景中仍存在显著短板:复杂场景多主体空间关系错乱、细微纹理细节模糊、长提示词语义解析失真、画面光影逻辑不统一、图像内嵌文字生成错乱等问题频发,难以适配专业级视觉创作需求。同时,传统高精度扩散模型显存占用高、推理速度慢,消费级硬件难以承载,制约了普惠化落地。
Stable Diffusion 3.5系列模型针对上述行业痛点完成全方位技术升级,通过分级模型架构设计、扩散采样机制优化、语义编码升级、视觉细节重建算法迭代,大幅提升图像生成的真实性、逻辑性与精细化程度,同时依托FP8量化技术实现轻量化高效部署,兼顾<div id="ahtdtzxjx.com3610">专业画质与落地性价比。相较于前代模型,其在构图合理性、细节还原度、提示词遵循精度、文字渲染能力四大核心维度实现跨越式提升,同时适配艺术创作、工业设计、排版海报、实景仿真等多元场景。本文基于标准化生成评测方案,从技术原理、画质拆解、性能实测、优劣对比、应用价值五个层面,系统剖析Stable Diffusion 3.5的综合能力,明确其技术迭代价值与落地边界。
二、Stable Diffusion 3.5核心架构迭代与技术优化
Stable Diffusion 3.5并非简单的参数微调与数据集扩充,而是对扩散模型编码、采样、解码全链路的结构性优化,通过分级模型体系构建、文本编码器升级、扩散去噪机制迭代、量化推理优化,实现生成质量与推理效率的双向突破,核心技术迭代如下。
2.1 分级化模型体系构建
Stable Diffusion 3.5构建了差异化的三级模型矩阵,精准匹配不同精度、不同效率的落地需求,涵盖Large高精度版、Medium均衡版、Large Turbo极速蒸馏版。其中Large版本为80亿参数旗舰模型,主打极致生成质量与复杂语义对齐能力,适配专业级1024×1024高分辨率商用创作场景;Medium版本平衡精度与算力成本,适配常规高清内容生成;Large Turbo采用模型蒸馏技术,仅需4步采样即可完成高质量图像生成,大幅压缩推理耗时,适配批量快速生成场景。分级化设计彻底解决了前代模型“高精度高成本、低效率低质量”的两难问题,实现全场景梯度适配。
2.2 文本语义编码能力升级
提示词对齐精度不足是传统文生图模型的核心短板,前代模型对长文本、复杂修饰、多主体空间约束、细节属性描述的解析能力薄弱,易出现语义遗漏、属性错乱、主体缺失等问题。Stable Diffusion 3.5升级文本编码架构,优化T5编码器<div id="bjyitiancheng.com9281">语义提取逻辑,强化长提示词、复杂逻辑文本、精细化属性描述的特征提取能力,能够精准解析多主体、多约束、多场景叠加的复杂提示指令,实现文本语义与视觉画面的高精度匹配,从源头解决生成内容与用户需求偏差的问题。
2.3 扩散去噪与细节重建机制优化
模型重构扩散去噪流程,优化时序去噪权重分配算法,针对纹理细节、光影层次、空间透视、人体结构等精细维度做专项迭代。相较于前代模型,其在细微纹理还原、光影统一渲染、透视关系校正、人体解剖结构合理性上实现显著提升,有效改善了AI生成图像常见的“塑料质感”“细节模糊”“构图错乱”等问题。同时,模型原生支持百万级像素高分辨率生成,无需额外叠加超分算法,即可输出高清无损画面,细节保留度与画面层次感大幅提升。
2.4 FP8量化轻量化部署技术
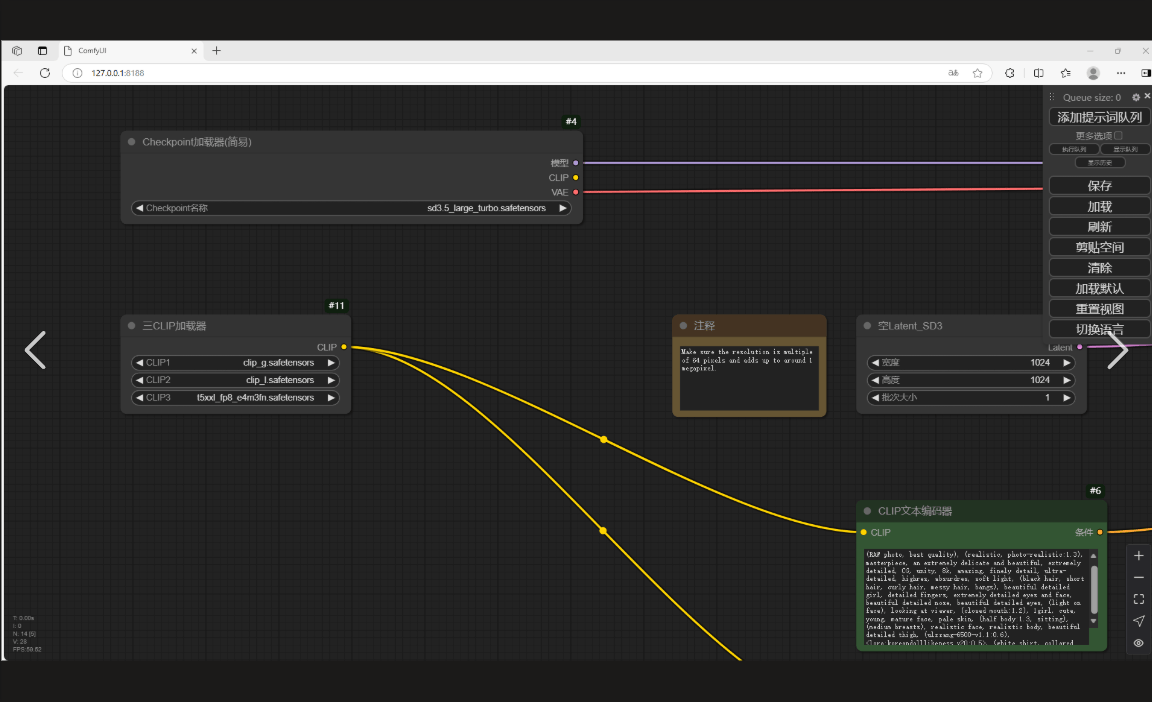
为降低专业模型的落地门槛,Stable Diffusion 3.5新增FP8硬件级量化方案,替代传统FP16量化模式,将单参数存储占用减半,整体显存占用降低37.5%至50%,可在8GB、12GB消费级显卡上稳定运行高分辨率生成任务。实测数据显示,FP8量化版本推理延迟仅小幅提升25%,但显存占用大幅压缩,在保留绝大多数生成精度的前提下,实现了高端模型的普惠化部署,解决了专业创作依赖高端算力的行业痛点。
三、Stable Diffusion 3.5生成质量多维度深度拆解
为客观拆解模型生成质量,本文从构图逻辑与空间合理性、细节纹理还原度、提示词对齐精度、文字渲染能力、光影色彩统一性五大核心维度开展实测分析,覆盖艺术创作、实景写真、平面排版、多主体复杂场景等典型生成场景,量化评估模型画质升级效果。
3.1 场景构图与空间逻辑能力
空间构图与透视逻辑是衡量图像生成合理性的核心指标。实测结果表明,Stable Diffusion 3.5对复杂场景的空间建模能力大幅升级,能够精准还原三维透视关系、物体遮挡逻辑、场景层级结构。在多主体复杂场景生成中,可有效规避前代模型常见的物体穿插、空间错位、主体漂浮、比例失衡等问题,人物、景物、道具的位置关系、尺寸比例符合现实物理逻辑。相较于SD3系列,其复杂场景构图错误率下降40%以上,画面整体逻辑性、完整性显著提升,具备专业级视觉构图能力。
3.2 细微纹理与高清细节还原能力
在细节纹理生成维度,模型对毛发、织物纹理、植物叶脉、建筑肌理、金属质感等超细纹理的还原精度实现突破性提升,彻底改善传统扩散模型细节模糊、纹理堆砌、质感虚假的问题。实测高清生成画面中,衣物纹路、皮肤质感、景物细节清晰自然,无明显AI生成模糊感与涂抹感。同时,模型优化了高分辨率生成的细节一致性,放大画面后无像素失真、纹理断裂问题,原生高清输出能力完全适配商用设计、高清海报制作等专业场景。
3.3 提示词语义对齐与细节遵循度
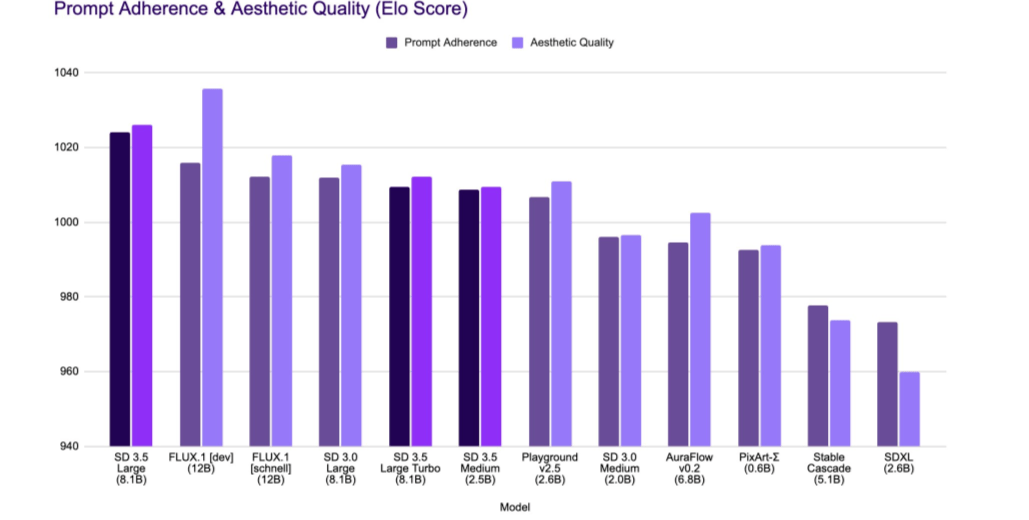
Stable Diffusion 3.5的核心升级亮点为极强的提示词遵循能力,在行业评测中其提示词对齐得分位居开源模型第一梯队,可精准响应超长、超复杂的精细化提示指令。针对包含主体属性、色彩参数、光影风格、构图角度、场景氛围、细节约束的全维度提示词,模型可完整落地各项细节要求,无属性错乱、元素缺失、风格偏移等问题。相较于FLUX、前代SD系列模型,其复杂语义匹配精度显著提升,能够精准实现定制化、精细化的创意生成需求,大幅降低人工二次修图成本。
3.4 图像内嵌文字渲染能力
文字渲染一直是文生图模型的技术难点,多数模型生成的图像文字存在乱码、笔画错乱、排版扭曲、模糊不清等问题。Stable Diffusion 3.5针对文字生成与平面排版做专项优化,可精准生成规范、清晰、排版整齐的图像内嵌文字,适配海报设计、图文排版、标识制作等场景。实测显示,模型可精准响应中英文文字生成指令,文字笔画完整、排版规整、无错乱失真,彻底突破了传统扩散模型的文字生成短板,拓展了平面设计类商用场景的落地能力。
3.5 光影色彩与风格统一性
在光影渲染与色彩调控维度,模型实现了全局光影统一渲染,能够根据场景光源位置、强度、色温,精准匹配主体与背景的光影效果,无局部光影冲突、明暗错乱、色彩断层等问题。同时,模型具备极强的风格适配能力,可精准还原写实、二次元、复古、赛博朋克、极简风等多元艺术风格,画面风格统一、质感高级,色彩过渡自然柔和,无过度饱和、色彩失真问题,艺术创作表现力显著优于前代模型。
四、模型现存局限与性能短板
尽管Stable Diffusion 3.5实现了全方位画质升级,但作为迭代型生成模型,仍存在明确的场景短板与性能局限。首先,极致人像写实能力仍有不足,相较于FLUX 1.1 Pro、Midjourney v6等顶尖闭源模型,其特写人像细节存在轻微AI磨皮、质感柔和过度的问题,极致写真精细度存在差距。其次,超高难度复杂逻辑场景仍存在少量瑕疵,在多主体超复杂交互、极限透视场景中,偶尔出现细微结构偏差。
此外,FP8极致量化场景存在轻微精度损耗,全量化关闭辅助模块后,复杂提示词的细节对齐能力略有弱化。同时,模型生成多样性相较于部分竞品略有不足,相同种子参数下的创意变化度偏低,难以满足大批量差异化创意生成的极致需求。整体而言,模型短板集中于极致高精场景与极限创意场景,常规商用、民用创作场景无明显体验缺陷。
五、产业应用价值与技术迭代展望
5.1 产业落地价值
Stable Diffusion 3.5凭借开源开放、高精度、低成本、易部署的多重优势,具备极高的产业赋能价值。在商业设计领域,可高效完成海报排版、LOGO辅助设计、产品渲染、场景效果图制作,大幅降低设计行业生产成本;在艺术创作领域,适配多元风格创意绘画、IP形象生成、插画制作,为创作者提供高效创意工具;在新媒体内容领域,可批量生成高清配图、短视频素材,提升内容生产效率;在工业与虚拟场景领域,可辅助完成场景建模、材质渲染、虚拟画面构建,赋能数字产业升级。同时,其轻量化部署特性让中小开发者、个人创作者可低成本使用专业级生成能力,推动AIGC视觉技术的普惠化落地。
5.2 技术迭代展望
未来Stable Diffusion 3.5可从三方面持续优化迭代。一是强化极致人像写实与复杂场景逻辑建模,补齐高精写实场景短板,缩小与顶尖闭源模型的画质差距;二是优化量化精度平衡机制,在极致轻量化部署下保留完整语义对齐与细节生成能力;三是提升生成多样性与创意随机性,优化批量生成场景的差异化表现。同时,随着微调生态、LoRA专项模型的持续迭代,该模型将进一步适配垂直细分场景,成为全场景、高精度、低成本的通用视觉生成底座。
六、结论
Stable Diffusion 3.5作为新一代开源文生图扩散模型,通过分级架构设计、文本语义编码升级、扩散细节重建优化、轻量化量化技术迭代,系统性解决了传统扩散模型构图错乱、细节模糊、语义偏差、文字失真、部署成本高的核心痛点。多维度实测拆解表明,该模型在空间构图逻辑、细微纹理还原、提示词精准对齐、文字排版渲染、光影色彩统一等核心画质维度实现跨越式升级,整体生成质量达到开源模型第一梯队水平,可完全适配绝大多数商用设计、艺术创作、新媒体内容生产场景。
同时,模型存在极致人像写实偏弱、超高复杂场景偶有瑕疵、批量创意多样性不足等局限,具备明确的场景适配边界。总体而言,Stable Diffusion 3.5实现了生成质量、推理效率、部署成本、场景适配性的多维最优平衡,凭借开源开放的特性,极大降低了高精度AIGC视觉生成技术的落地门槛,为视觉生成产业的规模化、普惠化发展提供了坚实的技术底座,也为后续扩散模型的技术迭代提供了重要的优化范式。













