

目前国内规模最大的搜索业务。这里向大家介绍我的团队在个性化大模型领域的最新工作HyFormer,它在保证性能的前提下,有效解决了序列和非序列特征深度交互融合的问题,欢迎大家批评指正。
近年来,大模型技术与传统搜推广领域加速融合,新工作层出不穷。搜索场景因为有用户query作为桥梁,与大模型结合尤为紧密。当前大模型技术落地主要有两条主流技术路线:
- 传统链路升级:输入侧借助大模型能力对信息进行加工处理(如用多模态大模型处理视觉文本信息)、引入端到端超长序列(Long Context)建模;模型侧借鉴Transformer结构,进行Scaling Law探索等。
- 端到端生成:直接采用大模型范式,生成一路结果以召回形式补充传统链路或者完全取代传统链路。
我们团队在这两个方向均有深入探索,取得了不少突破。这里想先介绍我们在传统链路升级路线中,和序列交互相关的一个工作:传统范式长期采用“先序列建模、再特征交互”的晚融合设计,虽有效,但序列信息是压缩后才和其他特征信息交互,导致表达能力和扩展性受限。随着端到端超长序列引入,这一短板更显突出。
为此,我们在业界首次提出序列建模与特征交互统一的混合Transformer框架——HyFormer。它将推荐任务构建为特征交互与序列建模交替优化的过程,在保持计算效率的同时,大幅提升模型表达力和Scaling效率。该工作已在抖音搜索生产环境落地,实现业务指标与用户体验双赢。
会议:SIGIR 2026
论文:HyFormer: Revisiting the Roles of Sequence Modeling and Feature Interaction in CTR Prediction
作者:Yunwen Huang, Shiyong Hong, Xijun Xiao, Jinqiu Jin, Xuanyuan Luo, Zhe Wang, Zheng Chai, Shikang Wu, Yuchao Zheng, Jingjian Lin
论文链接:https://zhuanlan.zhihu.com/p/2079675692787167830
关键词:排序模型 / 序列建模 / 特征交叉
一、研究背景
传统的推荐系统排序模型通常采用如下“两阶段”的建模范式:
- 序列建模:用DIN/LONGER等结构把用户行为序列提取压缩成若干个表征。
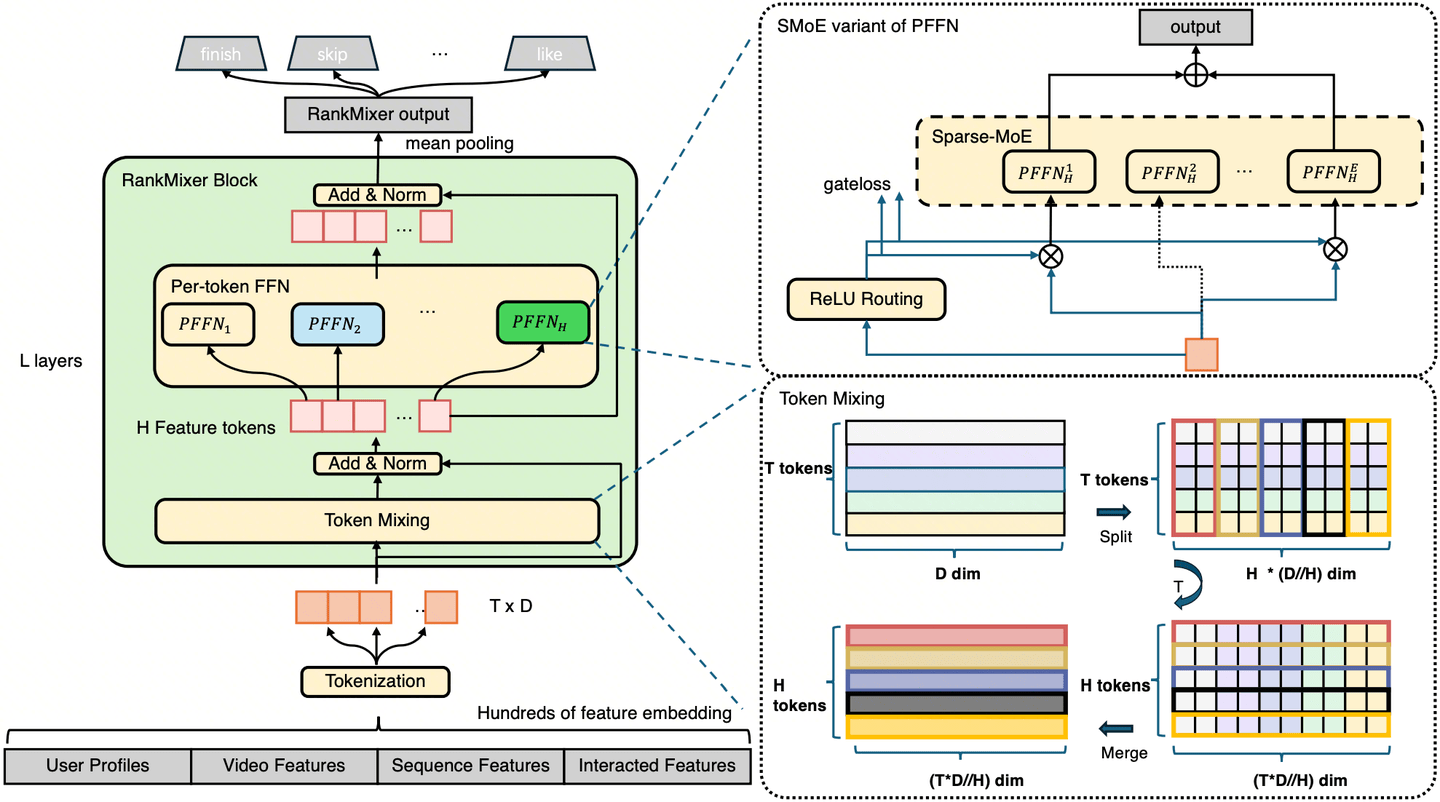
- 特征交叉:将上一步提取的序列表征与其它特征用DCN/RankMixer等结构进行交叉。
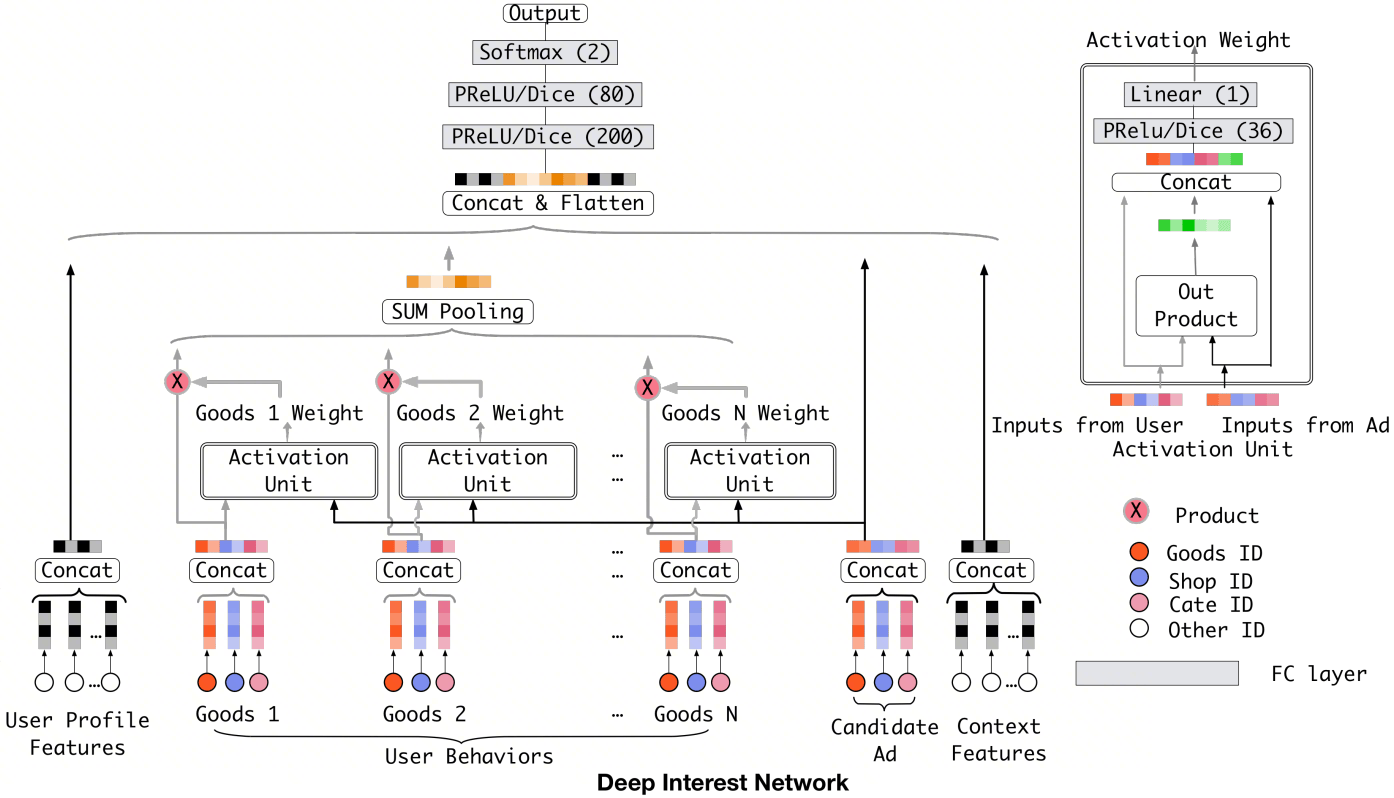
虽然该范式在业界的推荐模型得以广泛应用,但也带来了明显的局限性:
- 序列建模时,Query侧往往只包含少部分信息(通常只是Target Item关联特征),而大量其它输入特征直到序列被压缩完才参与交互,从而无法使序列模块提取全面准确的信息。
- 由于特征交叉模块仅对压缩后的序列表征进行建模,以加深或加宽的方式增加参数量难以直接受益于序列建模模块,从而导致模型Scaling效率较低。
业界已经开始意识到这个问题,并且开始进行统一范式的相关探索。以 HSTU为代表的分层生成架构,通过基于上下文信号与候选信号执行序列转换,构建出一套统一的推荐范式。InterFormer 则引入可学习交互令牌以实现双向信号交互,从而弥合了序列编码器与交互网络之间的鸿沟。MTGR 进一步推动了统一建模:将用户、行为、实时及候选特征重组为异构令牌,并通过共享的 Transformer 风格主干进行编码,实现对序列信息与交叉特征的连贯建模。OneTrans 沿用 MTGR 的思路,采用单一 Transformer 联合捕获序列依赖关系与高阶特征交互,同时以金字塔压缩结构简化 Transformer 结构,可看作是 MTGR 的简化版本。
但是这类方法,在实际部署中很容易出现性能显著下降的问题,随着序列长度增加,性能劣化问题会更加明显,主要原因是这类方法把大量算力用在了序列内部交互的建模上,但是对搜推领域来说,更重要的交叉信息往往是序列和非序列之间的交叉,而序列行为内部顺序建模的算力投入是可以降低的。用户历史行为有2个性质是可以利用的:
- 重要性随时间衰减:行为发生时间越久,重要性越低。大部分情况下给序列引入timediff特征(行为发生距离当前的时间),让模型有能力学习不同时间的重要性,就可以解决大部分问题。
- 随机性:用户点击了A和B,这个点击行为比较重要,但是先点A还是先点B,一般没那么重要了。而NLP则不一样,一个句子的词语调换顺序,有可能意思完全相反。因此往往不需要在顺序建模上投入太多算力。
因此可以基于用户行为的两个性质,更合理的对算力进行分配。搜推场景的算力是非常宝贵的,能不能把算力投入到ROI更高的地方,直接关系到最终的业务效果。
针对上述问题,我们有以下思考:
- 不应该把“序列建模”和“特征交叉”割裂开来,而应该让二者“互帮互助”——不仅需要“序列信息”来增强“特征表达”,更需要“全局上下文特征”来指导“序列信息的提取”。
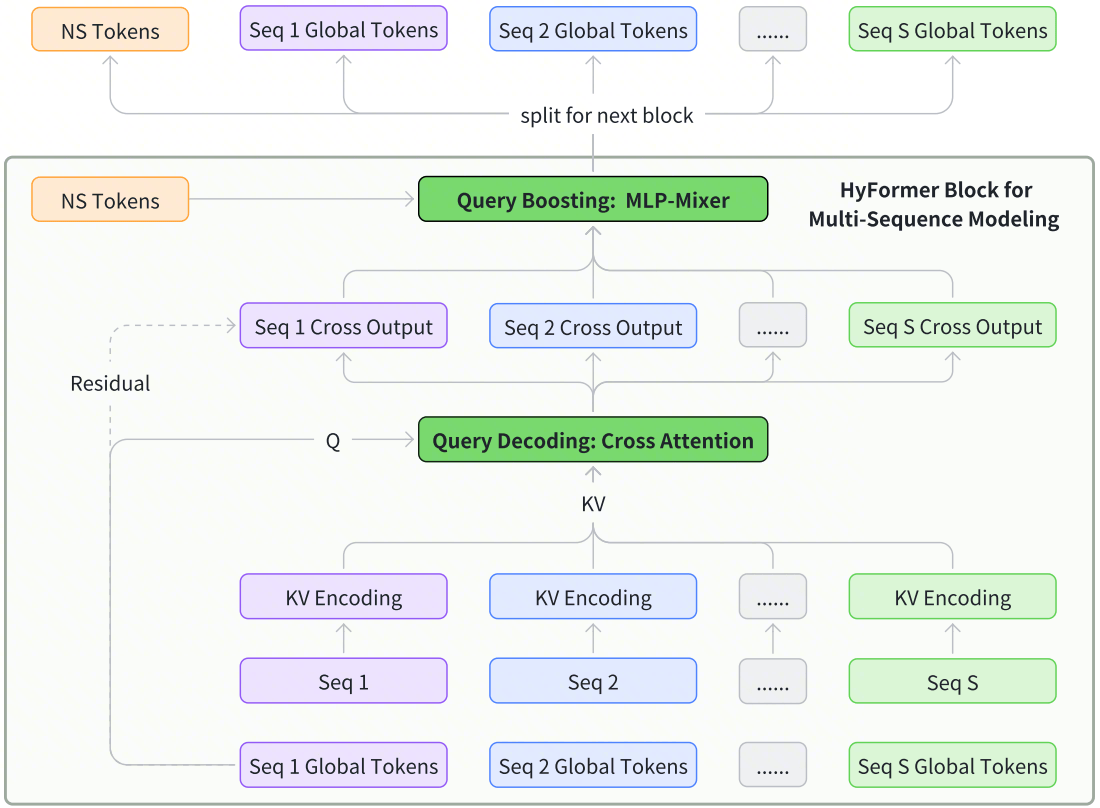
- 此外,在业界实际应用的模型中,往往会有多条不同序列输入(例如本场景序列,其他场景序列,短期序列,GSU长期序列等),强行合并进行统一建模(如OneTrans的做法)会干扰模型,独立建模不仅效果更好,适配修改难度也更低。
用类似Transformer的架构统一搜推模型的交互范式,结构上确实非常的简单优雅,但是对大规模搜推系统来说,这种结构对交互关系的建模不一定足够高效。我们已经验证了搜推领域和NLP大模型方向类似,也存在合适的结构可以支撑Scaling Law,但是这个结构不一定是Transformer,考虑到搜推本身的业务特点和场景规模,以及大规模请求下严格的算力限制,有可能存在比transformer更高效更合适的结构。因此我们针对上述问题,提出了HyFormer模型。我们在离线和线上都和Transformer这类统一架构做过严格对比,实验来看Hyformer无论是效果还是性能都有更显著的优势。
二、方法简介
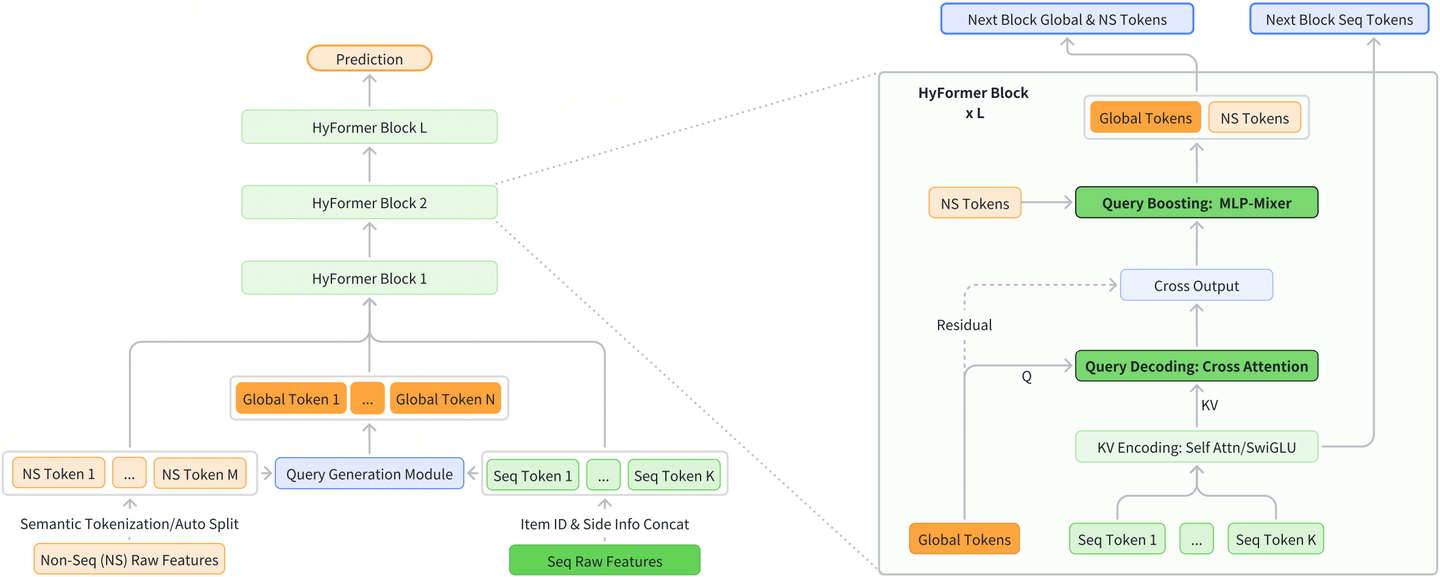
我们提出的HyFormer模型,整体架构如下图所示,主要包括Query Generation, Query Decoding和Query Boosting等三个部分,并通过支持多序列建模的HyFormer模块结合起来。
2.1 Query Generation模块
该模块的输入由 1️⃣ 按照语义分组的全部非序列特征 (NS Token),以及 2️⃣ 带side info的序列特征 (Seq Token) 两部分组成。其中,我们将NS Token与不同序列的Seq Token的pooling进行拼接,并通过轻量的MLP网络映射成包含全面context信息的初始query表征。
值得注意的是,以上生成的是最底层初次序列建模用到的query,而更深层的HyFormer结构涉及到的query不会通过上述方式产生——相反,每一层都会复用前一层的query,并将更深层的交叉注意力输出作为更新后的query,用以检索长序列。随着层级加深,query能够携带逐步丰富的语义信息。
2.2 Query Decoding模块
除了在模型底层获取初始query表征Q后,我们也需要将序列里的各个元素映射成后续序列建模所需的K/V. 这里我们给出了三种可选方案:
- Full Transformer Encoding:对序列先进行self-attention编码,使所有元素综合容纳互相的信息。
- LONGER-style Efficient Encoding:在序列前面拼接多个 (通常远小于序列长度) 的additional token作为query,通过cross attention来抽取序列特征信息。
- Decoder-style Lightweight Encoding:直接对序列所有元素映射 (例如使用SwiGLU) 成最终的K/V.
- 在得到包含target item在内丰富信息的query表征和序列所有元素的key/value表征后,我们会在HyFormer的每一层通过Cross-Attention的方式进行query decoding. 该步骤能够进一步将上下文信号注入到具备序列感知能力的query表征中;随后,解码得到的query (对应为每条序列分配的Token) 会供后续的交互模块与增强模块使用。
2.3 Query Boosting模块
经过上一步query decoding后,对应的token已包含了序列信息,但其与其它大量非序列特征的交叉仍未被充分挖掘(虽然最初我们将所有NS Token拼进了初始query里,但这远远不够)。query boosting模块则解决了这一局限。
具体来说,我们可以把所有非序列Token (例如对所有特征embedding拼接后进行切分得到) 和序列Token (每条不同序列对应不同的Token,其初始值即query generation+decoding后输出) 拼接成一个 (B,TNS+TSeq,D)(B,T_{NS}+T_{Seq},D)(B,T_{NS}+T_{Seq},D) 的张量作为该模块输入,利用基于MLP-Mixer的结构将其进行mixup+pffn/smoe交互。由于残差机制的存在,我们得以在充分融合解码出来的序列信息和原始的非序列特征同时,保留交互前的较原始语义,使得query boosting成为一个重要且高效的“增量模块”,通过多层堆叠不断在前序表征基础上更新更多信息。
2.4 HyFormer模块
HyFormer 模块由多层网络堆叠而成,每一层均包含一个Query Decoding模块,其后衔接一个Query Boosting模块。在每一层中,语义查询向量通过交叉注意力机制与长行为序列进行交互,得到的序列感知表征会被进一步优化,作为后续更深层网络的输入。
通过堆叠多层该结构,HyFormer 逐步优化语义query向量,使得深层网络能够借助表达能力不断增强的表征,对长序列进行抽象建模。HyFormer 最顶层的输出会被输入至下游的MLP,以完成最终预测。该设计能够在长序列表示建模任务中,高效、灵活地将异构非时序特征与长行为序列相融合。
三、实验结果
3.1 效果对比
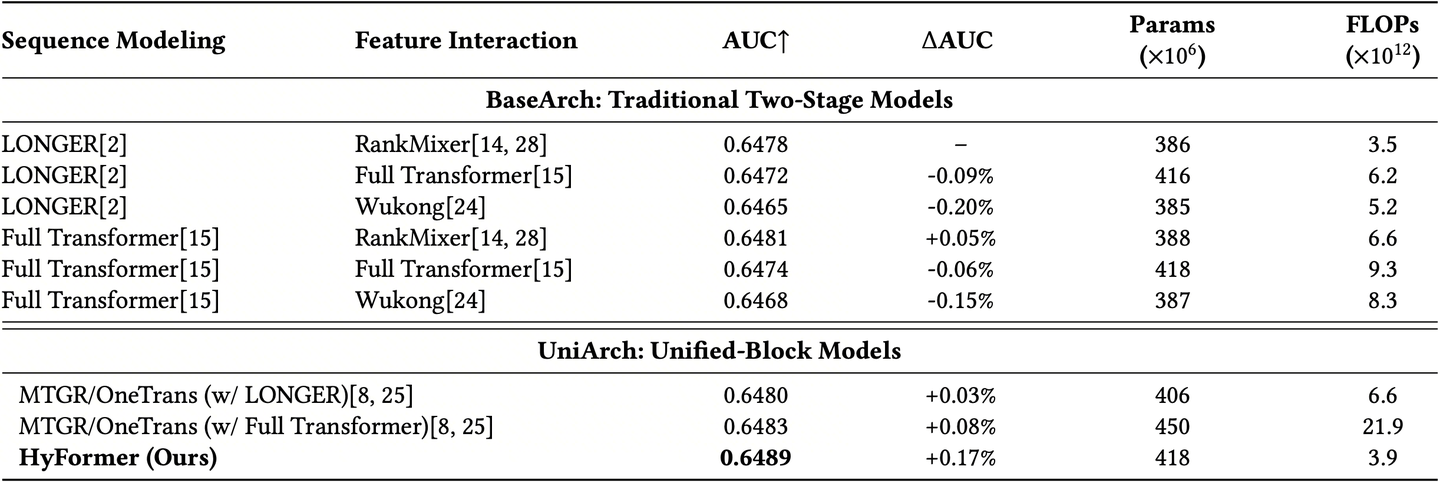
在抖音搜索业务上进行验证,有三条序列,包括最长3000的长序列、top 50的搜索序列和top 50的feed序列,global token包括非序列token是13个+三个序列mean pool的token,在64卡GPU训练。我们比较了两阶段 (先序列建模后再和非序列token交叉) 和统一建模(序列和非序列统一建模) 两类模型,其中本工作提出的HyFormer模型取得最好的结果,且计算量不大。
3.2 消融实验
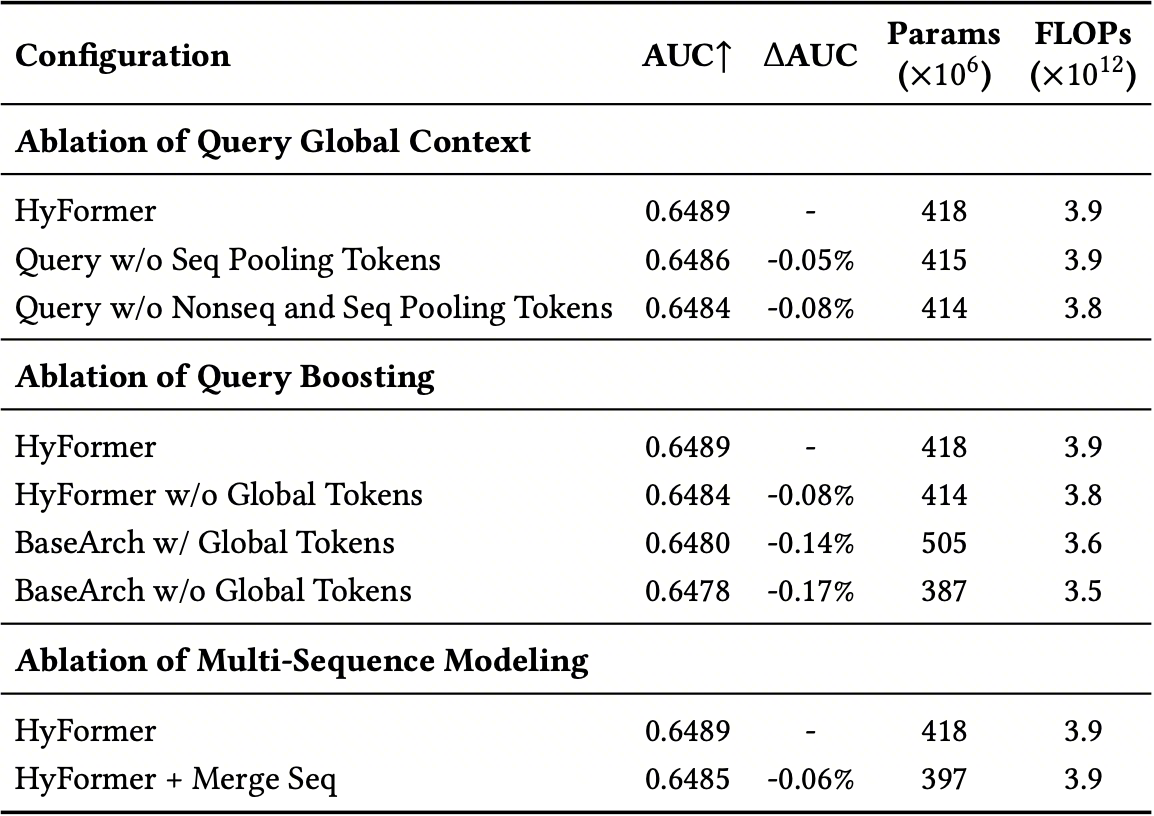
如下表所示,1️⃣ query包含三部分:全局非序列特征、序列pool token、target item信息,移除全局非序列特征或者序列pool token都有损;2️⃣ Query boost模块去掉global token也有损,下面BaseArch是Longer+RankMixer结构,整个改了结构;3️⃣ 多序列merge效果也有损。
3.3 Scaling分析
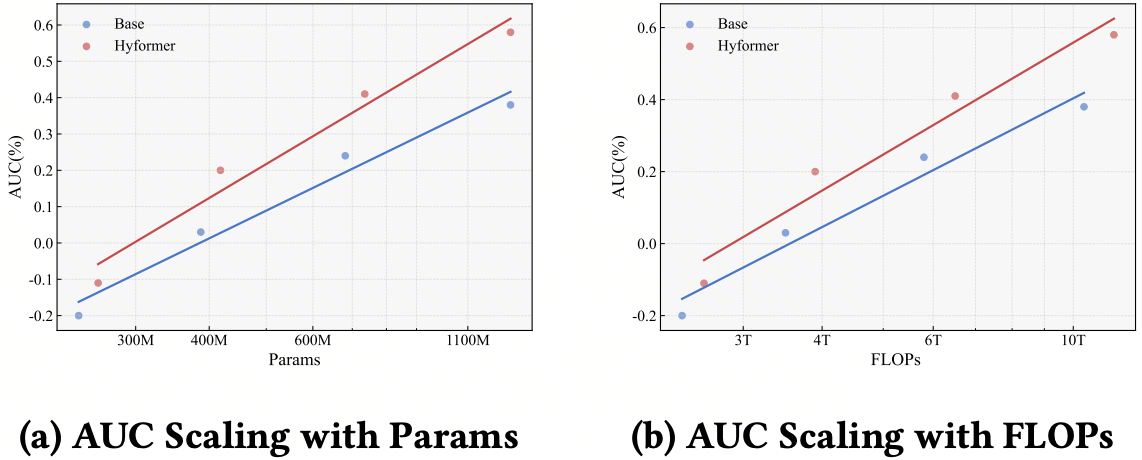
我们选取的base是LONGER+RankMixer.
- 随参数量和计算量的scale up,HyFormer更优。
- 随序列长度变化,HyFormer更优。
3.4 A/B指标
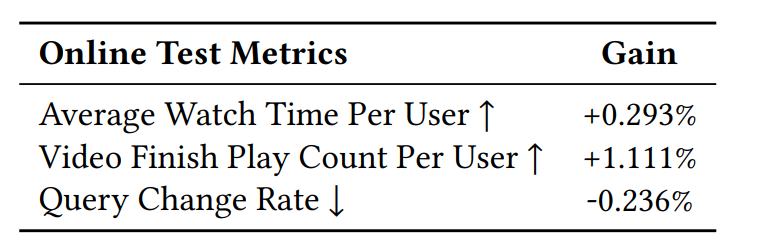
在抖音搜索场景中,人均观看时长、完播率、换query率均有显著收益。这里对换query率做个简单解释,换query表明用户对搜索结果不满意,更换了query来明确需求,这个指标越低,说明体验越好,这个是和搜索留存LT最相关的过程指标。换query率-0.236%是线上系统一个很大的优化。
四、总结与展望
本工作提出的本文提出HyFormer架构是业内首个提出“序列建模”与“特征交互”统一联合交替建模的框架。从序列建模的角度来看,该过程对应一种迭代优化流程:基于全局标记对长序列进行解码,再通过跨特征交互强化全局标记,二者交替迭代。这一设计为更全面的序列建模与特征交互提供了新颖且高效的框架,同时也为多序列建模提供了灵活的范式。大量离线与在线实验验证了将单向信息流升级为双向协同进化范式的优越性,也为未来工业界长序列表示建模任务提升了扩展上限。
【我们是谁】
我们是抖音搜索算法团队,是国内当前最领先的搜索业务,深度服务抖音短视频、图文、直播等核心体裁,以用户体验为核心持续迭代。每一次算法升级,都直接影响数亿用户的内容消费体验;每一项技术突破,都在重塑短视频生态下的搜索范式。
我们正在寻找一批热爱技术、敢想敢拼、渴望用算法创造价值的同学,依托 AI 大模型浪潮,共同打造下一代 AI 搜索引擎。
招聘对象:正在热招 社招 / 校招 / 实习 的同学,base地:北京/杭州/上海
我们的技术方向
- 排序大模型:探索个性化大模型、多模态大模型、生成式大模型、百万超长序列等前沿技术,不断突破技术边界,重新定义下一代搜索大模型范式,让排序更精准、更贴合用户需求。
- 机制策略:深耕LTR等排序策略、多业务重混排、流量分发机制等,优化搜索全链路效率,平衡多场景业务需求与用户体验,实现业务价值与用户价值的双赢。
- 召回技术:多模态召回、向量召回、语义召回等
- 相关性技术:Query 理解、多模态相关性大模型等
- 生态优化:图文、UGC等 内容分发与生态建设等













