

- 论文标题:Uncertainty as Remedy: Mitigating Satisfaction Label Bias in Short Video Multi-Objective Ensemble Ranking
- 论文链接:https://zhuanlan.zhihu.com/p/2079995996285690422
- 论文作者:Xiaoxiao Xu, Jinfang Gu, Zonghe Shao, Jiaqi Yu, Yongqi Liu, Tiantian He, Minzhi Xie, Kaiqiao Zhan, Kun Gai(Kuaishou Technology 等)
- 一句话总结:把多目标行为标签之间的冲突显式建模为“预测不确定性”,并用它做 pair-wise 样本加权,让训练更关注“高冲突、最容易出现满意度标签偏差”的样本对,从而在 EMER / EASQ 两类端到端集成排序框架上带来稳定线上收益。
背景与动机
短视频推荐的“终极目标”不是点击或时长本身,而是用户对推荐结果的真实满意度(latent true satisfaction)。工业界主流会先用多任务/多目标模型预测一组 pxtr(点击、观看时长、点赞、关注等),再把这些 pxtr 融合成最终排序分数。
端到端的 multi-objective ensemble ranking(例如 EMER、Pantheon、HarmonRank)把“手工公式融合”升级成“可学习的融合网络”,确实提升了线上效果,但论文指出仍有两个核心问题:第一,多维 pxtr 只是“碎片化满意度代理”,彼此常互相矛盾,和真实满意度存在系统性偏差(satisfaction label bias);第二,传统确定性打分把每个样本都当成同等可信,面对冲突目标时容易收敛到折中解,且训练过程会更偏向“各目标一致的简单样本”,把最关键的“高冲突样本”学得不够。
作者的核心洞察是:多目标冲突会让模型在这些样本上的预测天然更“不确定”,而这种不确定性与“满意度标签偏差”在样本级是强相关的。既然如此,就可以把“不确定性”变成训练管道里的主要信号,用来缓解 label bias。
整体架构
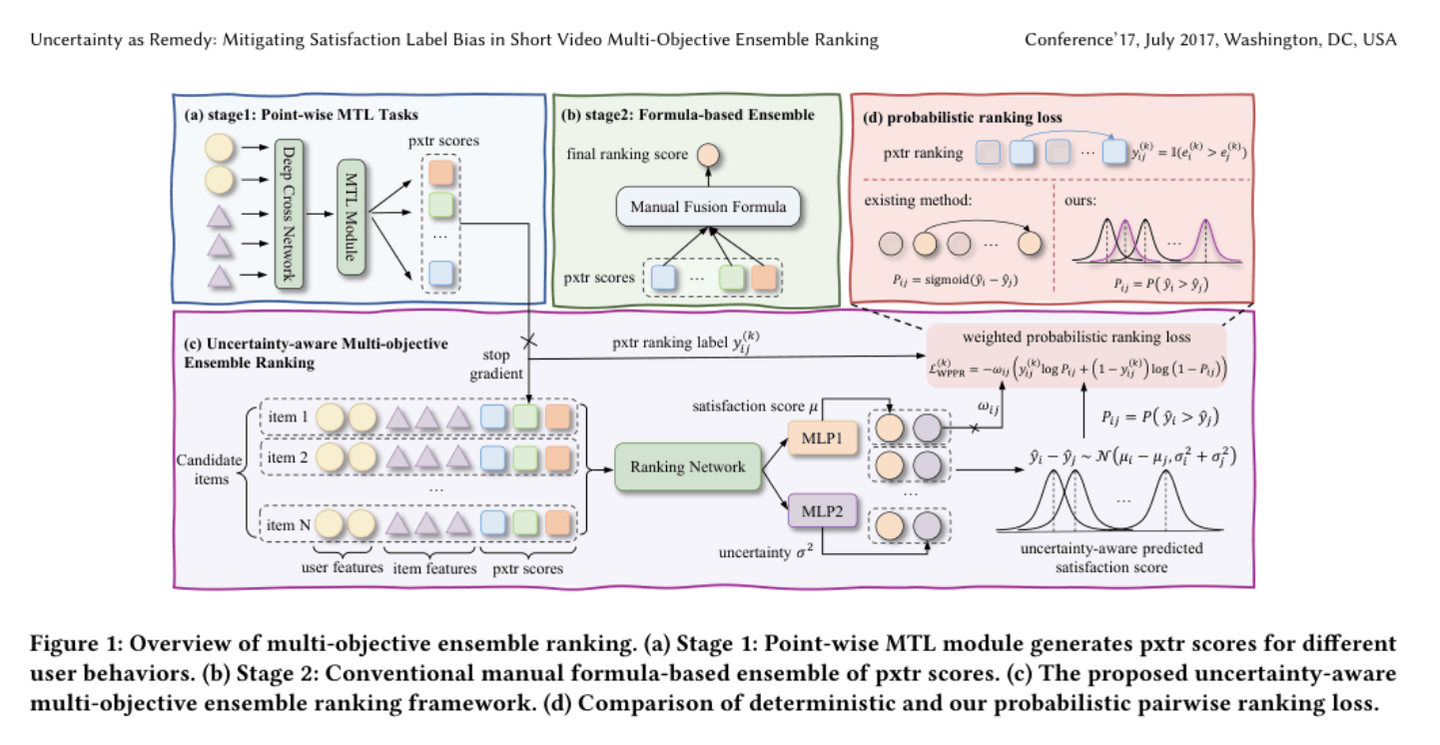
端到端数据流可以理解为:
候选 item 及其特征(user/item/context)先进入 Backbone Ranking Network(例如 EMER 或 EASQ 的主干网络)得到共享表示,再接两个轻量输出头:一个输出满意度分数的均值(mean),另一个输出不确定性(variance)。随后在训练时用“概率化的 pair-wise 排序损失”来同时学习 mean 与 variance,并用 variance 构造样本对的自适应权重,让高冲突样本对在梯度里占更大比重。
模块拆解
3.1 任务定义与符号
模块作用:把“最终满意度排序”写成可训练的 pair-wise 排序问题,同时明确 pxtr 标签带来的偏差。
输入:
- 用户集合 U、短视频集合 V、上下文特征 C
- 对于某个用户 u∈U 与上下文 c∈C,候选集合记为 Cand(u,c)
- 每个候选 item v_i 有 K 维 pxtr 分数(多目标行为代理信号),记为 {p_i^{(k)}}_{k=1..K}
输出:
- 每个候选 item 的“满意度打分变量” ŷ_i(随机变量)
- 以及任意 item 对 (i,j) 的“i 排在 j 前”的概率 P_{i,j}
关键标签:
- 理想(不可观测)的真实满意度 pair-wise 标签:
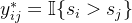
- 第 k 个 pxtr 派生出来的 pair-wise 标签:
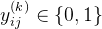
变量说明:
- s_i:真实满意度(latent,训练不可直接用)
- y_{ij}^{(k)}:来自第 k 维行为信号的偏置标签(可能互相冲突)
3.2 满意度-不确定性建模(Gaussian scoring variable)
模块作用:用一个高斯随机变量表示 item 的“满意度打分”,均值负责“打分”,方差负责“冲突/不确定性”。
输入张量(训练时按 batch):
- Backbone 输出的共享表示 h ∈ R^{B×D}
输出张量:
- 满意度均值μ ∈ R^{B×1}
- 不确定性方差 σ^2 ∈ R^{B×1}(非负)
- 以及随机打分变量 ŷ ∈ R^{B×1}
核心公式:
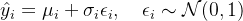
变量说明:
- i:候选 item index
- μ_i:预测的满意度分数(mean)
- σ_i^2:预测不确定性(variance),论文用它刻画多目标冲突导致的 aleatoric uncertainty
- ε_i:标准高斯噪声
实现细节(落地视角):
- 两个轻量 MLP head:MLP_score(h)→μ,MLP_uncert(h)→σ^2
- 为保证 σ^2≥0,工程上通常会用 softplus 或 exp 把网络输出映射到正数(论文正文只强调“方差非负”,不限定具体函数)
3.3 概率化 pair-wise 排序(Probabilistic Pairwise Loss)
模块作用:把“i 是否排在 j 前”从确定性 sigmoid,升级为基于高斯差分的概率,并构造可训练的 pair-wise ranking loss。
输入:
- 两个 item 的随机打分变量 ŷ_i, ŷ_j
输出:
- pair-wise 概率 P_{i,j}
核心推导(论文给出解析形式):
先定义差分随机变量:

在条件独立假设下(论文为 tractability 做的假设):
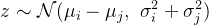
因此:
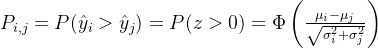
变量说明:
- Φ(·):标准高斯分布的 CDF
- σ_i^2+σ_j^2:两端不确定性的合成,分母越大表示越“没把握”,概率更接近 0.5
基于某个 pxtr 的 PPR loss(论文写成交叉熵形式):
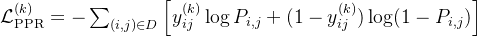
变量说明:
- D:一个 batch 内可用的 item pair 集合
- y_{ij}^{(k)}:第 k 个 pxtr 派生的 pair-wise 标签
不确定性正则(防止模型走“把 σ^2 全变大来逃避学习”的捷径):
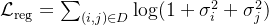
3.4 不确定性感知的样本对加权(Uncertainty-aware Adaptive Weighting)
模块作用:把“哪些 pair 更重要”显式写进 loss:高冲突 pair 更重要,训练时应该更重。
输入:
- item 的预测方差 \sigma^2
输出:
- pair-wise 权重 \omega_{ij}
论文先定义 pair-wise 综合不确定性(comprehensive uncertainty):
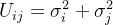
然后做 batch 内的 min-max 归一化,并用缩放因子 \gamma 放大差异:

变量说明:
- U_{ij}:pair 的综合不确定性
- \gamma:权重缩放因子(论文在超参分析中讨论)
- \min(U), \max(U):当前 batch 内所有 pair 的极值
最终加权的 WPPR:

直观解释(对训练动态非常关键):
- 当某个样本在多个 pxtr 之间“排序冲突很大”时,它的 σ^2 会更大(论文后续给出理论 + 实证相关性),从而让相关 pair 的 \omega_{ij} 变大
- 训练会更集中地优化这些“最可能有满意度标签偏差”的 pair,而不是被“简单一致样本”主导
3.5 辅助约束损失(让 uncertainty 更贴近 pxtr 冲突)
模块作用:仅靠 PPR,uncertainty 只被“隐式监督”。作者额外构造一个显式约束,让 σ^2 更像“pxtr 冲突度”的刻画。
做法:作者先用“多个 pxtr 下的排序位置标准差”来定义 item 的冲突度,再构造一个 pair 集合 B_conf+:其中 item i 的冲突显著大于 item j。对这些 pair 施加 logistic 约束:
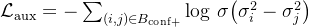
变量说明:
- B_{conf+}:高冲突 item 应该对应更大不确定性的训练对
- \sigma(·):sigmoid 函数
3.6 最终训练目标
论文的最终 loss(跨 K 个 pxtr 累加):
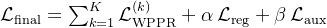
变量说明:
- K:pxtr 目标数量
- \alpha:不确定性正则系数
- \beta:辅助约束系数
训练与推理:落地时需要关心的细节
训练阶段(核心点):
- 训练样本不是单个 item,而是 batch 内构造的 item pairs
- 每个 pair 会被 K 个 pxtr 生成 K 份 y_{ij}^{(k)},并分别计算一份 WPPR,然后再求和
- 权重 \omega_{ij} 是“样本对级别”的,并且来自模型当前的 σ^2,因此它会随着训练动态变化
推理阶段(核心点):
- 线上排序通常只需要一个最终分数。论文框架里 mean μ 就是可用的 satisfaction score
- σ^2 主要用于训练中的加权与(可选的)分析诊断;论文对比了一些“推理阶段用 uncertainty 做后处理”的方法(RankDist/EBRank),说明只做后处理不如把它写进训练目标
实验与分析
6.1 Offline:两种 backbone 上的 pxtr 指标(Table 1)
作者对 baseline 的解读也很值得记下来:
- RankDist / EBRank 这类“推理阶段用不确定性做后处理”的方法,只在少数指标上有部分收益,说明 uncertainty 的价值不只是后处理
- ANSL 按 loss magnitude 做 sample hardness 加权,反而在多目标场景会掉指标,说明“难样本”并不等价于“有满意度标签偏差的关键样本”
6.2 Online:7 天 A/B(Table 2)

这张表给出的信号是:收益不止体现在短期消费 proxy(时长/播放等),在长留与互动类指标上也较一致。
6.3 满意度对齐:问卷满意度作为近似真值(Table 3)
论文还做了一个“uncertainty 是否真的在刻画 label bias”的实证:在 300 万样本上,不确定性与构造的 label bias 指标呈显著正相关(Pearson 0.65 / Spearman 0.67)。这点是 UAME 逻辑闭环的关键一环。
优势与局限
优势(论文明确想解决的点):
- 把“不确定性”从推理阶段的后处理信号,推进到训练目标里,直接影响梯度分配
- 重点缓解的是多目标场景里最棘手的“样本级 label bias”:哪些样本 pair 的 pxtr 信号互相打架、最需要被认真学
- 工程侵入相对低:在已有 backbone 上加一个 uncertainty head + 损失改造即可,论文也给出已在生产系统持续带来稳定收益
局限(从论文设定可直接读到的约束):
- 核心建模假设之一是 pair-wise 里两端打分变量条件独立,这让概率形式可解析,但会忽略 item 之间通过共享特征带来的相关性
- 权重采用 batch 内 min-max 归一化,会引入“batch 统计”对训练稳定性的影响,且需要调 \gamma 控制权重分布
- uncertainty 的语义主要绑定在“pxtr 冲突导致的 aleatoric uncertainty”。如果线上还有其它强噪声源(例如系统性曝光偏置、反馈延迟、非平稳),这些不一定会被 σ^2 干净地分离出来














