

伴随信创国产化持续纵深推进,文档智能识别已经成为政务、档案、涉外办公数字化转型的核心底座。近期,TH‑OCR SDK15 完成版本迭代,在多语种识别、图像畸变矫正、表格处理、导出格式等多个维度完成能力跃升,面向政企、涉外业务、档案数字化场景输出一套自研可控的国产化 OCR 解决方案。
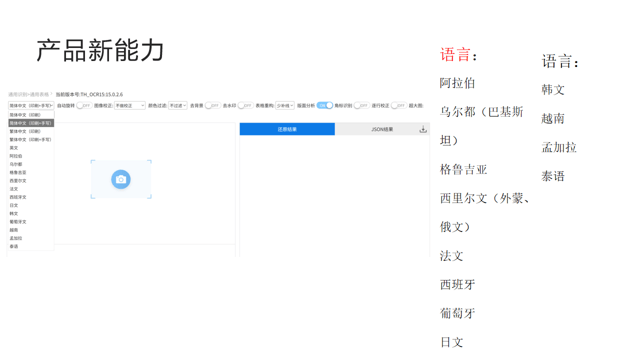
在多语言识别能力上,SDK15 实现大规模语种扩容,新增阿拉伯语、乌尔都语、格鲁吉亚、西里尔文、法文、西班牙文、葡萄牙文、日文、韩文、越南语、孟加拉语、泰语等多语种支持,覆盖中东、东南亚、中亚、欧洲多国语言体系,很好适配跨境业务、涉外档案、外文合同翻译归档等业务需求。以往很多国产 OCR 产品中文识别表现优异,但小语种识别能力薄弱,项目中往往需要引入多套第三方组件,增加部署成本与运维风险。SDK15 将多语种能力原生集成在 SDK 内部,无需额外接入第三方接口,私有化部署环境下即可完成多语种文档解析,契合数据安全政策要求,保障业务数据不出内网。
针对拍摄文档普遍存在的画面变形问题,新版本上线透视畸变矫正、弯曲畸变矫正两大图像矫正能力。日常工作中手机拍摄纸质文件、卷曲档案卷宗、倾斜扫描件,会出现页面扭曲、边角变形,直接造成识别漏字、错行。透视畸变矫正可以修复拍摄角度带来梯形变形,弯曲畸变矫正解决书本、卷曲纸张的曲面形变,经过矫正预处理之后,再执行文字识别,大幅提升低质量拍摄文档的识别效果,解决档案扫描、现场单据采集场景的高频痛点。
表格处理同样迎来重要更新,提供少补线、不补线、多补线、全补线四种表格线条重构模式。不同纸质文件表格线条深浅不一,有的打印缺线、有的复印线条浓重,单一模式很容易出现表格错乱。四种模式可以根据原稿质量灵活切换,还原真实表格结构;同时新增角标识别功能,针对文档注释角标、参考文献标记进行精准捕获,解决长期以来脚注、上角标识别丢失的行业难题。
输出格式层面,SDK15 支持 HTML、JSON、PDF、OFD、TXT、Excel、Word、MD 多种格式导出,Word 区分文字流、文本框两种模式,文字流去除多余格式方便二次编辑,文本框完整还原原始版式,满足归档、编辑、二次开发多样化输出诉求。
作为深耕 OCR 技术三十余年的国产自研产品,SDK15 全部算法自主可控,不依赖开源模型二次封装,既能够在 GPU 环境高效运行,也支持纯 CPU 部署,降低硬件投入门槛。在信创政策加速落地的当下,SDK15 持续打磨产品能力,为档案、OA、合同智慧办公等行业提供稳定可靠的底层识别能力,助力各行业数字化、国产化落地。














