

AI for Science下科研知识碎片化困境:Agent智能检索如何打通科研知识孤岛
香山科学会议相关研讨指出,我国 AI for Science 建设正在快速推进,多个科研平台、智能实验室项目落地,但行业正面临 “数量繁荣、体系脆弱” 的现实风险。大量科研平台分头建设,不同系统之间数据结构、元数据、知识库互不打通,形成一座座 “数字烟囱”。科研数据、实验文档、项目资料散落在不同系统、不同设备之中,即便拥有海量科研资料,却很难实现跨项目、跨机构的流转复用,这也正是院士提出 AI for Science 要实现“书同文、车同轨”的现实背景 ——“书同文”的核心诉求之一,就是实现科研知识的统一语义与可检索流转。
科学研究已经迈入AI驱动的第五范式,AI辅助假设生成、材料配方筛选、药物研发、仿真模拟已经大量落地。但科研人员依然要面对一个普遍现实:大量时间消耗在信息查找、资料整合工作上。同一机构内部,实验记录、项目报告、教研文档、仿真资料分散存储;不同科研平台知识库标准不统一,传统关键词检索、普通 RAG 检索很难处理复杂科研问题,容易出现信息遗漏、答非所问,出现 “输入垃圾、输出垃圾” 的现象,即便拥有高质量科研素材,也难以把零散文档转变为体系化的科研资产。
传统检索依赖人工构造关键词,用户需要把复杂科研问题拆解成多条简短检索指令,反复调整关键词,再人工对海量结果筛选甄别;普通 RAG 检索可以做到语义匹配,但缺少复杂问题拆解、多轮迭代检索的能力,面对跨文档、多逻辑链条的科研课题,依然有明显短板。
科研场景常常遇到复合型问题:比如梳理一类催化剂的多组实验对比、整合仿真模拟与实验实测数据、汇总多个项目的历史研究记录。这类任务不是单条语义查询就可以完成,需要 AI 自主拆解子任务,多次调用多源知识库,动态调整检索策略,再对多份文档做融合、重排序、归纳整理,输出逻辑完整的结论,Agentic Search(智能体驱动检索)正是顺应这一科研需求而诞生的新一代检索模式。
它把检索从 “人规划路径,工具返回片段”,升级为 “人提出研究需求,AI智能体自主规划检索路径,完成多步闭环调研”。
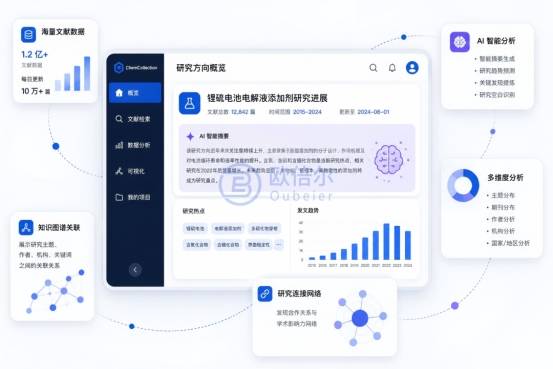
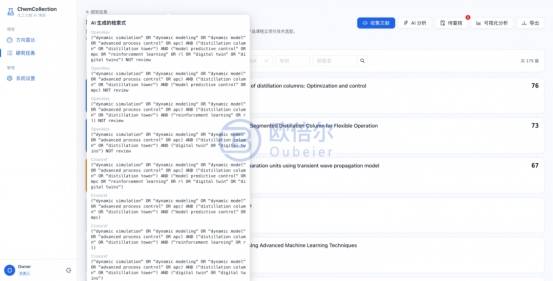
当下国内多家面向科研、智慧实验室赛道的厂商,已经开始将 Agentic 检索能力融入智慧科研平台,尝试解决科研知识孤岛痛点。以北京欧倍尔推出的 Agentic Search 功能为例,该能力集成于AI大模型平台,区别传统关键词检索与普通RAG,可自主完成任务拆解、多工具协同调用,组合BM25精确检索、向量语义检索、重排序多重策略;同时支持对接私有科研知识库,兼容文档、音视频等多元科研素材,把分散的内部实验资料、教研素材、仿真项目文档纳入统一检索体系,输出结构化调研结果,并且提供 OpenAPI 开放接口,可嵌入现有科研系统,不需要全盘替换原有业务系统即可增强知识检索能力。
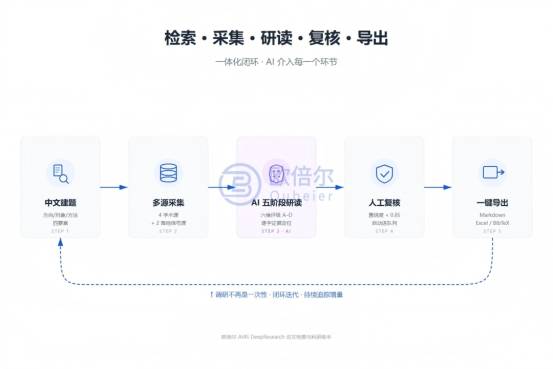
从产品定位来看,该能力并不直接替代实验仿真、机器人工作站,而是聚焦知识层的 “书同文”,解决存量科研资料分散、查询繁琐的痛点,帮助科研人员把散落在各处的项目资料变成可复用、可查询的科研知识资产。除网页端之外,该检索能力还适配企微等协作终端,适配团队协同科研调研的场景,为科研团队提供人机协同信息调研工具。
当然 Agentic Search 只是行业众多探索中的一例。放眼产业,不少科研智能平台都在强化智能知识检索模块,目标都是降低科研人员信息获取成本,减少在资料搜集筛选上的无效消耗,把精力留给科学假设、实验设计等高价值科研工作。需要客观看到,Agentic智能检索只是实现 AI for Science “书同文” 的其中一环。
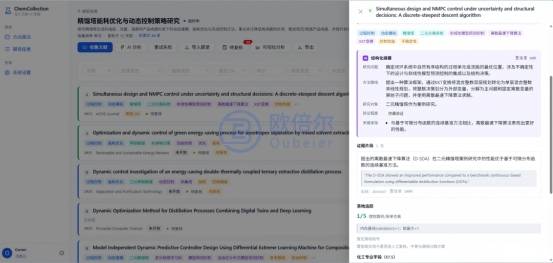
统一科研知识体系是一个系统性工程,不单单依靠检索工具,还需要源头的数据采集规范、统一元数据标准、科研模型校验机制,以及异构实验设备接口协同(也就是 “车同轨”)的配合,检索系统负责把已经标准化、结构化的知识高效挖掘调用,但无法完全弥补源头数据标准缺失带来的缺陷。
行业共识已经十分清晰:AI for Science 想要从单点示范走向规模化创新,不只是建设更多独立平台,更要打通数据知识模型实验设施的全链路。智能检索的普及,代表产业已经开始关注科研知识层的互联互通。未来,工具能力的迭代,叠加科研数据、模型、基础设施标准体系逐步完善,才能够真正破解 “数字烟囱” 困境,释放第五科研范式的全部潜力。
参考资料:
国家科技创新体系建设官网《AI for Science 需要 “书同文、车同轨”》
北京欧倍尔产品介绍页














