
 论文标题:Beyond Dense Connectivity: Explicit Sparsity for Scalable Recommendation(超越稠密连接:面向可扩展推荐的显式稀疏) 论文作者:Yantao Yu、Sen Qiao、Lei Shen、Bing Wang、Xiaoyi Zeng(阿里巴巴国际数字商业集团 AIDC,杭州) 论文链接:https://zhuanlan.zhihu.com/p/2081076354834026905 一句话总结:针对推荐数据"高维极稀疏"的本质,本文提出 SSR 框架,用"先过滤、再融合"(filter-then-fuse)的多视图显式稀疏替代稠密全连接,配套静态随机过滤(SSR-S)与动态迭代竞争稀疏(ICS)两种实现,成功打破稠密 MLP 的规模化天花板——工业数据 Click AUC 达 0.6667,线上 A/B GMV +3.5%。
背景与动机
大模型 Scaling Law 的成功,让推荐系统也想通过"加深、加宽稠密 MLP"来吃下海量行为数据。但作者发现:推荐输入是高维且极度稀疏的,简单堆叠稠密 backbone 常常收益递减、甚至掉点。
作者对一个线上工业 CTR 模型的全连接层权重做了可视化分析(下图),得到一个关键现象——隐式连接稀疏(implicit connection sparsity):
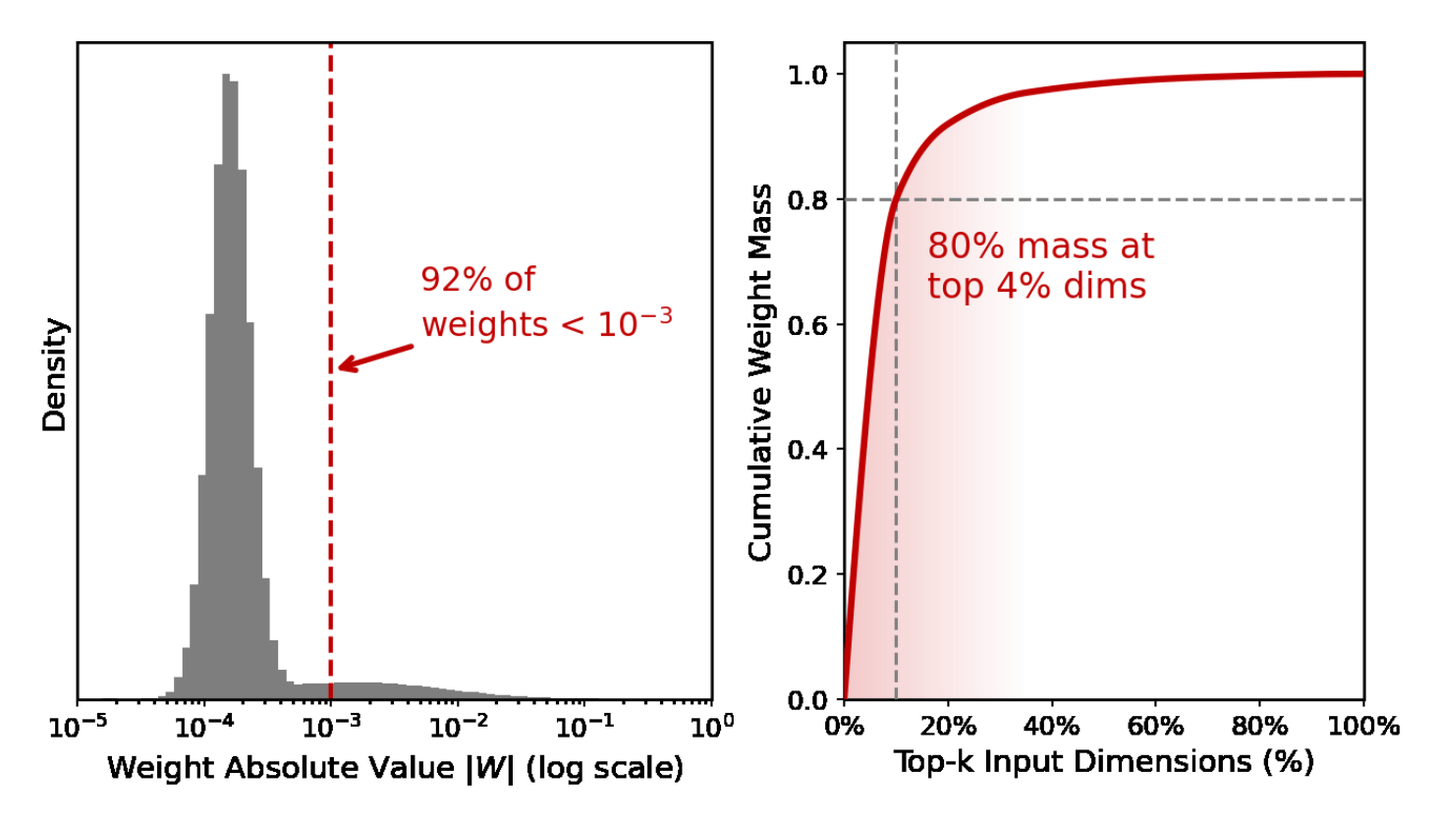
- 左图:即使没有加任何稀疏约束(如 L2 正则),超过 92% 的连接权重都被隐式压到近零(< 10⁻³)。
- 右图:80% 的权重能量只集中在 top 4% 的输入维度上。
这说明稠密连接与稀疏数据之间存在结构性错配:模型被迫花大量算力去处理海量"低价值连接",而不是真正有效的信号,稠密结构本身反而成了模型建模能力的主要瓶颈。
核心 insight:这种隐式稀疏是低效的——权重只是被"驱近零",既没真正切断噪声干扰,也没有原则化的信号过滤机制。本文主张把稀疏显式化(explicit sparsity):从训练副产物变成可控的架构设计,在源头阻断噪声传播。又因为"什么是噪声"因用户而异,静态稀疏结构不够,还需要样本自适应(sample-conditional)的动态稀疏。整体架构
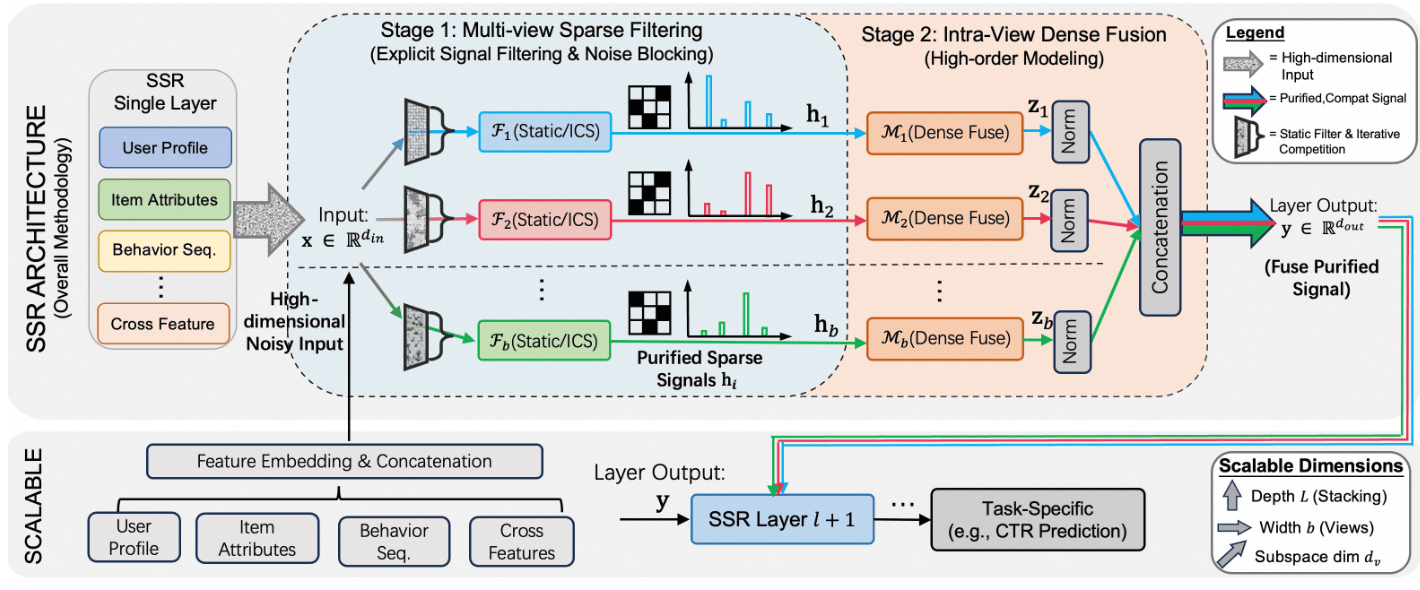
SSR(Explicit Sparsity for Scalable Recommendation)的核心是把一个标准稠密层,替换成先过滤、再融合的两级级联结构。单个 SSR Layer 包含两个阶段:
- Multi-view Sparse Filtering(多视图稀疏过滤):把输入分解成 b 个并行"纯化视图(purification views)",每个视图内部做维度级的显式过滤,隔离噪声维度。
- Intra-view Dense Fusion(视图内稠密融合):只在过滤后的"干净子空间"里做稠密非线性变换,避免噪声被重新聚合稀释。
端到端数据流:原始特征(用户画像 + 候选商品属性 + 交叉统计 + 行为序列)→ Embedding 拼接成初始向量 x ∈ R^{d_in} → 拆成 b 个视图 → 每个视图先 Filter (Fᵢ) 再 Fuse (Mᵢ) → 各视图输出 LayerNorm 后拼接得到 y。
整体映射用一个 concat 算子表达:
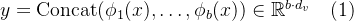
变量说明:
- x ∈ R^{d_in}:所有特征 embedding 拼接后的初始输入向量,d_in 为总输入维度。
- φᵢ:第 i 个视图的映射,内部 = 稀疏过滤 Fᵢ + 稠密融合 Mᵢ 的严格两阶段。
- b:视图数(并行分支数)。
- d_v:单个视图输出的子空间维度。
- y ∈ R^{b·d_v}:一层 SSR 的最终输出,由 b 个视图结果拼接而成。
模块拆解
3.1 Multi-view Sparse Filtering(稀疏过滤阶段)
模块作用:对每个视图从高维输入 x 中抽取"纯化表示",做维度级的信号过滤。
输入:x ∈ R^{d_in};输出:b 个纯化向量 hᵢ。
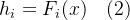
这本质是 b 个并行的过滤操作。作者给出两种Fᵢ 的实现,分别侧重"高效结构稀疏"和"上下文自适应稀疏"。
SSR-S:静态随机过滤(Static Random Filter)
把 Fᵢ 当作一个与样本无关的算子,用一个固定的二值选择矩阵实现硬性降维:

变量说明:
- Mᵢ ∈ {0,1}^{d_in × d_v}:二值选择矩阵,每一列都是严格的 one-hot 向量,初始化后固定不变。
- 构造方式:从输入维度 {1,…,d_in} 中无放回均匀采样d_v 个特征索引;视图内不重复,但不同视图间独立采样(允许特征重叠)。
- 这种独立性带来 “Feature Bagging” 效应,促进各视图的结构多样性与鲁棒性。
- hᵢ ∈ R^{d_v}:过滤后的视图表示。
SSR-D:迭代竞争稀疏(Iterative Competitive Sparse, ICS)
为了捕捉上下文相关的稀疏,用可微的动态机制 ICS(详见第 4 节)根据样本语义动态置零弱响应维度:
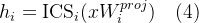
变量说明:
- W_i^proj ∈ R^{d_in × d_v*}:第 i 个视图的可学习投影矩阵。
- hᵢ ∈ R^{d_v*}:动态过滤后的稀疏表示;视图维度通常被扩张(d_v* > d_v)以给自适应稀疏留出容量空间。
- 输出 hᵢ 中大部分非关键元素被严格截断为真零(hard zero),而非小概率值。
3.2 Intra-view Dense Fusion(稠密融合阶段)
模块作用:在过滤后的干净子空间里做高阶非线性建模。因为噪声已在上一阶段被切断,这里的稠密融合只作用于"信息密集子空间",避免全局稠密结构的信号稀释。
数学上,它等价于对拼接输入施加一个块对角权重矩阵W_block = diag(V₁,…,V_b)——强制各视图之间严格语义隔离。第 i 个视图的输出:
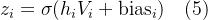
所有视图输出再经 LayerNorm 并拼接:
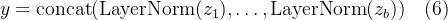
变量说明:
- Vᵢ:第 i 个视图的融合权重矩阵,静态时 Vᵢ ∈ R^{d_v × d_v},动态时 Vᵢ ∈ R^{d_v* × d_v}。
- σ:激活函数(如 GELU)。
- biasᵢ:视图偏置。
- zᵢ:第 i 个视图融合后的输出;y ∈ R^{b·d_v} 为该层最终输出。
- 实现上用 b 个并行投影完成,不存储零值的非对角块。
3.3 可扩展架构:三个正交的 Scaling 维度
SSR 支持沿三个正交维度扩展:深度 L(堆叠层数)、视图宽度 b(视图数)、子空间维度 d_v。纵向堆叠促进层次化特征演化;横向增加 b 拓宽"逻辑视野"以捕捉多样交互;扩大 d_v 增强局部变换的表达力。(实验结论:b 是最可靠的扩展维度,见下文 RQ2。)
Iterative Competitive Sparse(ICS)机制详解
ICS 是 SSR-D 的核心,它把稀疏化从"离散 Top-k 排序"重新表述为一个可微的离散时间非线性动力系统,从而支持端到端梯度优化。
生物学类比:把输入 p ∈ R^{d_v} 看作生态系统中的"种群",特征强度代表"生命力(vitality)“。系统施加一个"全局抑制场”,遵循适者生存——只有显著强于抑制场的特征才能存活,其余收敛到真零。整个过程分三步:初始化 → 迭代竞争 → 信号恢复。4.1 初始化与竞争动力学
先把投影特征整流为非负(保证"强度"有物理意义):
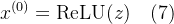
随后进入 T 轮迭代(t = 0,…,T-1)。每一步先计算全局抑制场μ^(t)(当前所有特征的均值):
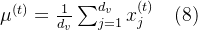
再执行"适者生存"的状态更新:

变量说明:
- z ∈ R^{d_v}:ICS 的投影输入(即 x W_i^proj)。
- x^(t) ∈ R^{d_v}:第 t 轮的系统状态(特征强度向量)。
- μ^(t) ∈ R:第 t 轮的全局抑制场,等于当前特征均值。
- α_t ∈ R:第 t 轮的可学习灭绝率(extinction rate),α = {α₀,…,α_{T-1}},不同迭代用不同的 α_t。
- T:迭代轮数(默认 T=5)。
由于 α_t > 0 且 μ^(t) ≥ 0,更新规则保证任何特征强度都不会增大,系统能量单调非增:
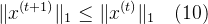
每轮只做加减法和求均值,均为 O(N) 操作,T 轮总复杂度 O(T·N)(严格线性)。
4.2 Signal Recovery(信号恢复)
上式的能量单调衰减虽能过滤噪声,但也会过度衰减有用信号。为此引入可学习缩放参数 γ 做恢复:
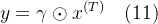
变量说明:
- γ ∈ R^{d_v}:可学习的重缩放向量(逐维度独立权重),⊙ 为逐元素乘。
- 虽然理论上后续线性层能吸收一个标量缩放,但作者特意用 γ 把"恢复"与"变换"解耦,让 γ 充当方差稳定器,保证数值稳定与最优动态范围。
- y ∈ R^{d_v}:ICS 最终输出的稀疏特征。
4.3 相比其他 Top-k 机制的优势
训练目标
SSR 不引入任何额外的辅助损失或显式多样性正则项。所有视图输出被拼接后,统一在标准 CTR 任务损失(二元交叉熵 / LogLoss) 下端到端优化。ICS 前向过程完全可微,可直接嵌入梯度优化。
作者特别指出:视图多样性是"自然涌现"的——由于所有视图共享同一个 loss,训练会自动抑制冗余视图、偏好捕捉互补模式的视图(Figure 6 的余弦相似度热图验证了各视图近似正交),因此无需显式的多样性正则。关键超参(实验设置):embedding 维度统一为 16;优化器 Adam,batch size 1024,early stopping;ICS 迭代 T=5,灭绝率 α_t 初始化为 0.1,缩放 γ 初始化为全 1 向量。
实验分析
数据集:三个公开集(Criteo、Avazu、Alibaba)+ 一个来自 AliExpress 的十亿级工业数据集(10 亿+ 生产日志、300+ 特征字段,按时间切分模拟线上)。指标:AUC、LogLoss,工业集额外用 GAUC 缓解用户活跃度偏置。
6.1 效果与效率(RQ1)
工业数据集上,SSR 全面超越经典交互模型、AutoML/注意力模型与 SOTA 可扩展架构(Wukong、RankMixer):
关键结论:
- SSR-S 用 56% 参数、44% FLOPs 就反超 RankMixer,且优于同参数量的 Dense MLP——说明增益来自稀疏架构本身,而非单纯堆参数。
- SSR-D 取得全场最佳,Click AUC 0.6667、Pay AUC 0.8194(均对最强 baseline 显著性 p<0.05)。
公开集上同样稳定领先:SSR-D 相对 RankMixer 的 AUC 提升为 Avazu +0.63%、Criteo +0.03%、Alibaba +0.43%;SSR-S 在 Avazu 上以约一半参数/FLOPs 反超 RankMixer(0.7827 vs 0.7772)。
6.2 可扩展性分析(RQ2)
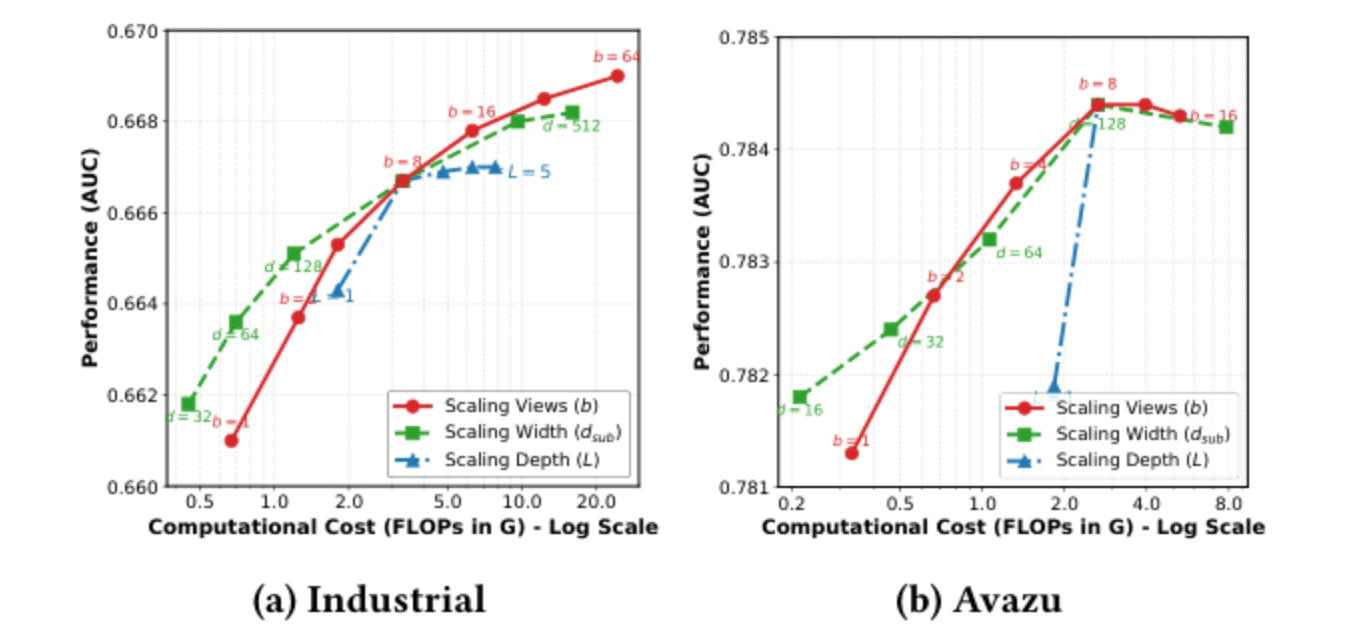
三个维度的对比表明:增加视图数 b 是最可靠的扩展维度。在十亿级工业数据上(瓶颈是欠拟合),视图扩展的曲线一路稳步上升到 b=64 无饱和;宽度 d_v 在中低资源区间是有效的次选,但高复杂度时收益递减;深度 L 的每 FLOP 收益最低,很早就饱和。而在小数据集 Avazu 上各维度普遍饱和,d_v 超过 128 甚至掉点。
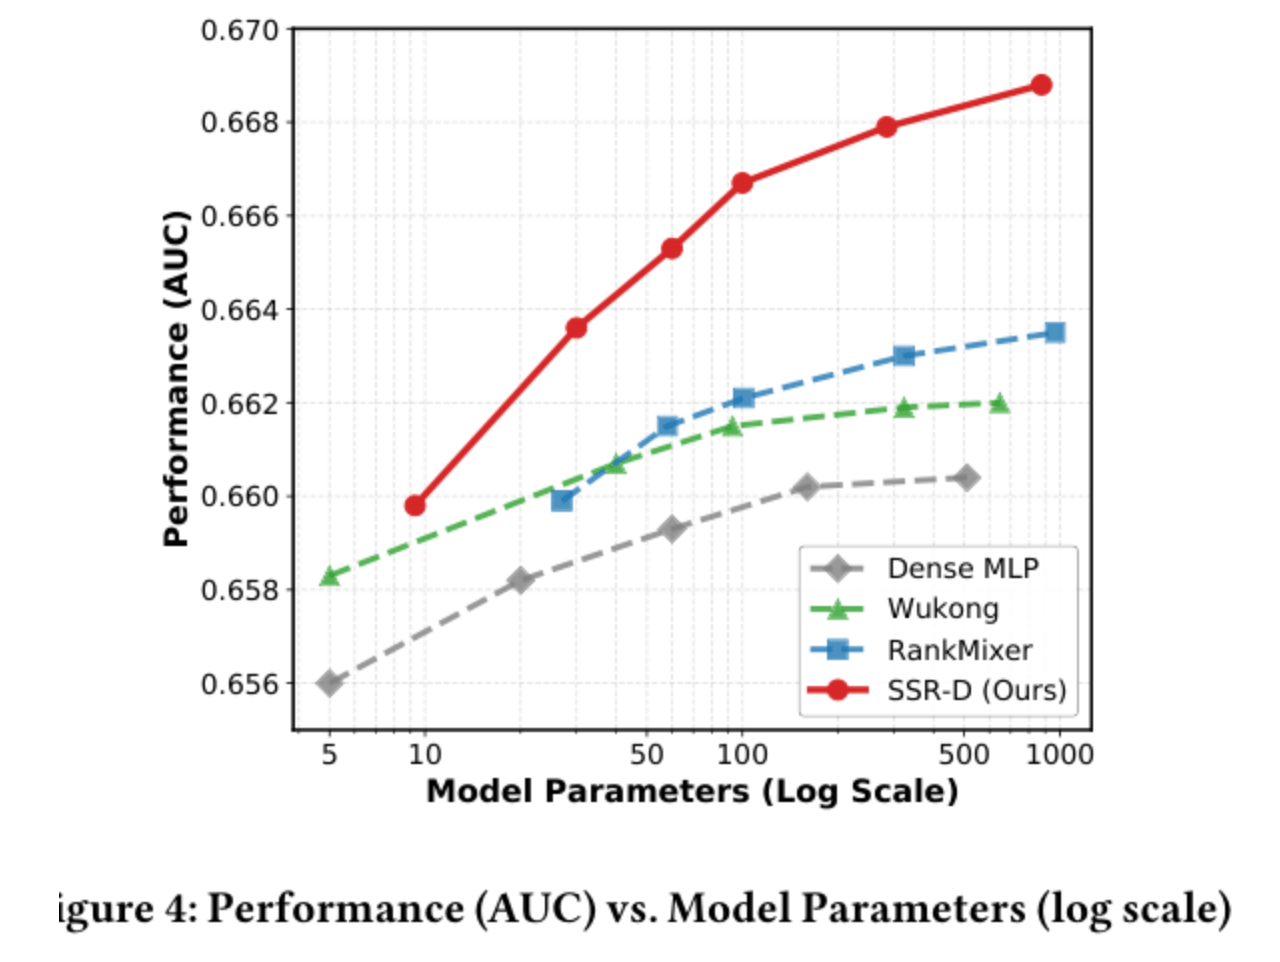
从 5M 到近 900M 参数的 scaling 轨迹显示:SSR 不仅精度更高,斜率也更陡。Dense MLP 早早过早饱和(翻倍参数收益递减),而 SSR 全程保持稳步上升——证实显式稀疏过滤是打破规模化天花板的关键。
6.3 消融与机制分析(RQ3)
各组件的贡献(ΔAUC,×10⁻²,即 pt):
稀疏过滤是最关键组件(去掉掉点最多),验证了"全局稠密对推荐输入次优"的核心假设;Dropout 替换的大幅掉点证明增益并非来自正则化,而是学到了有意义的稀疏。
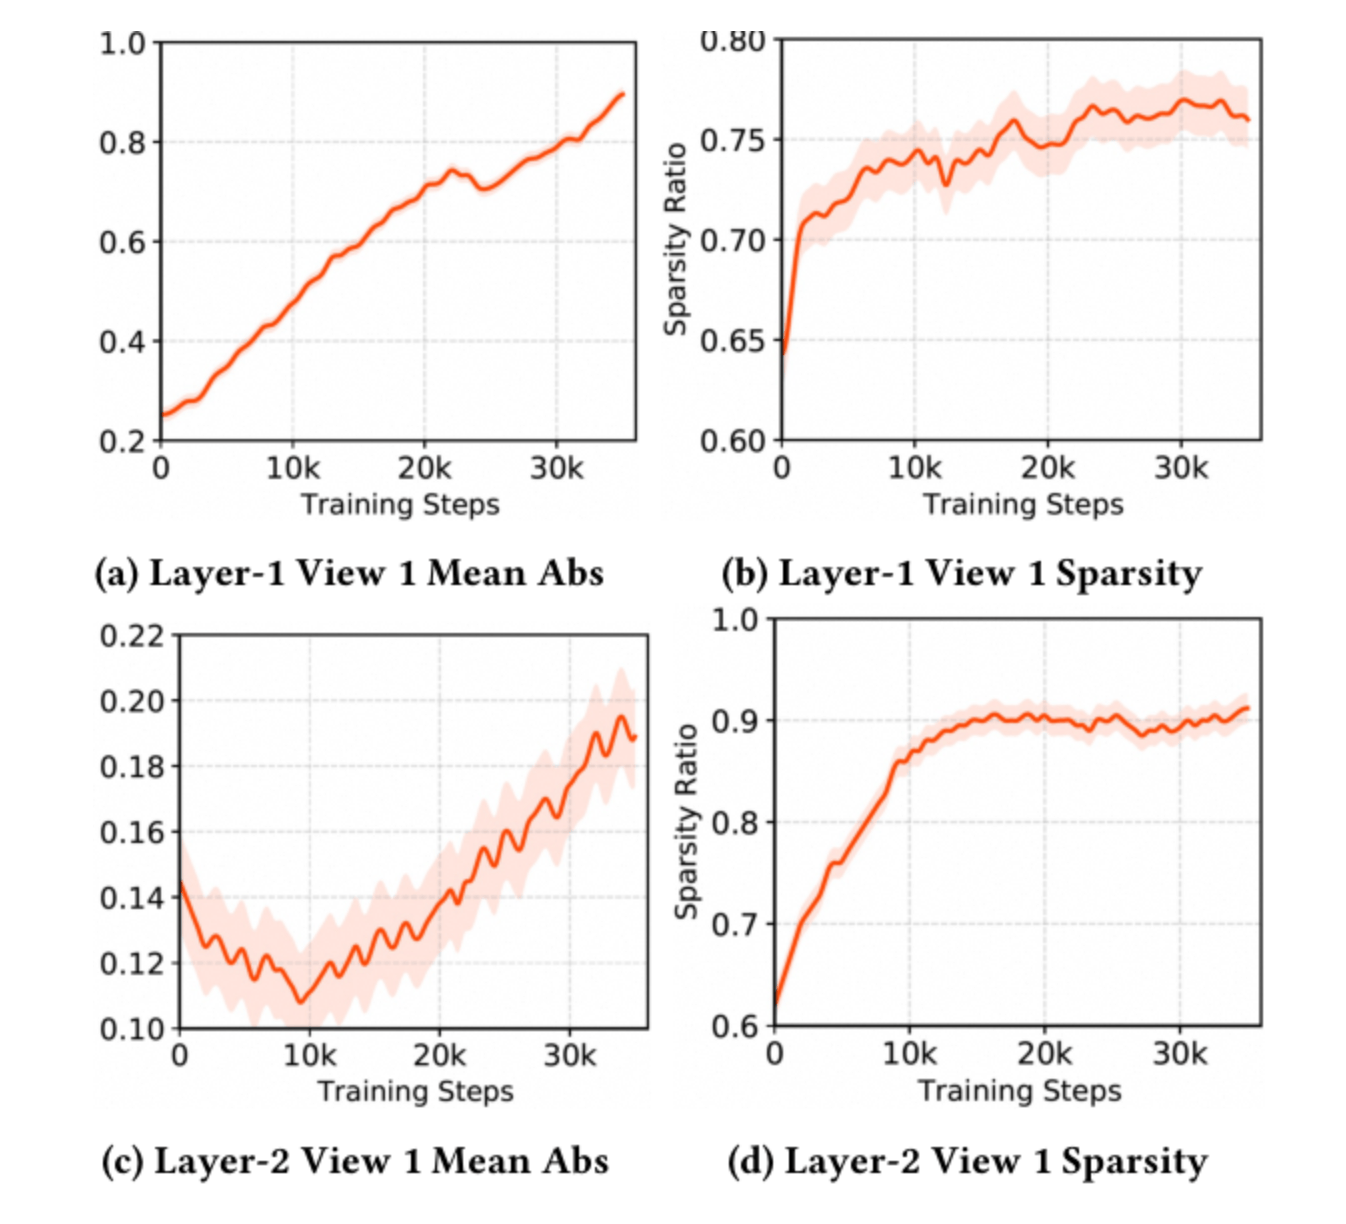
ICS 训练动态显示稀疏度在训练早期快速上升并稳定;Layer 1 特征幅值随训练增大,Layer 2 则先在前 1 万步短暂下降(抑制弱/冗余特征)再回升(强化保留特征)。
ICS 超参敏感性(Avazu,Table 5):
- 迭代 T:T=1 → 76.4% 稀疏 / 0.7821;T=2 → 88.6% / 0.7826;T=5(默认)→ 91.0% / 0.7835(最佳)。
- 灭绝率 α_t:在 [0.01, 0.5] 区间稀疏度从 80.4% 平滑升到 94.0%,AUC 保持稳定(0.7828~0.7835),α₀ 是有效的稀疏调节旋钮,机制鲁棒不脆弱。
- 缩放 γ:去掉后 AUC 降至 0.7832(vs 0.7835),验证幅值恢复对抵消信号衰减的必要性。
6.4 线上 A/B 测试(RQ4)
在核心推荐场景以生产标准 RankMixer(同参数量)为基线,SSR-D 做两周线上实验:

CTR +2.1%、人均订单 +3.2%、GMV +3.5%,且几乎不增加系统延迟(+1ms)——说明收益来自结构设计的表征质量提升,而非牺牲推理耗时。
优势与局限
优势:
- 范式创新:把推荐数据的隐式稀疏"显式化",用"先过滤、再融合"在源头阻断噪声传播,理论清晰、动机扎实。
- 两种互补实现:SSR-S 零 FLOP 硬降维、极致高效;SSR-D 的 ICS 是可微、线性复杂度 O(T·N)、驱动噪声到真零的动态稀疏,避免了 Top-k 的梯度失配与排序的超线性开销。
- 规模化更优:块对角结构把复杂度降低 1/b,scaling 曲线更陡、天花板更高,打破 Dense MLP 的早饱和。
- 落地验证充分:十亿级工业数据 + 三个公开集 + 两周线上 A/B(GMV +3.5%,延迟近乎持平)。
局限(基于论文讨论客观陈述):
- 视图数 b 是最优扩展维度,但在小数据集(如 Avazu)上各维度普遍早饱和,d_v 过大甚至掉点——方法的规模化红利更依赖大数据体量。
- ICS 引入迭代轮数 T、灭绝率 α_t、缩放 γ 等额外超参;虽然论文显示鲁棒,但仍需针对数据集做一定调参(如 T=5 为经验最优)。
- 论文聚焦 CTR/CVR 排序场景,未涉及召回、序列建模等其它推荐链路环节的适配性。












