

临床医生不进实验室能发 SCI 吗?能,而且已成主流:Meta 分析、CHARLS / GBD / NHANES / MIMIC / SEER 公共数据库挖掘、TCGA / GEO 生信分析,三条路都不需要自家样本。医嘉研专注这三条路径的一对一辅导,适合临床忙、没时间做实验的医生和医学生。
本文是对2026年发表于《Foods》的一项比较预测建模研究的解读,属科研资讯分享,不构成任何诊疗建议。这活儿挺有意思——用七种机器学习模型去预测土耳其的食品生产指数,结果最复杂的深度学习反而翻车,倒是贝叶斯岭回归这种老派线性模型稳得一批。小样本、强共线性的真实数据面前,算法复杂度真不一定管用。值得一读。
期刊:Foods(IF: 6.0,Q1)
发表时间:2026年8月12日
原文标题:Food Production Index Forecasting for Sustainable Food Systems in Türkiye: A Machine Learning-Based Approach.
翻译标题:IF 6.0:测试集R²=0.968!土耳其粮食生产指数“小样本尺”这样做到简单胜复杂
研究设计:比较预测建模研究,回顾性时间序列数据样本量:62个年度观测(1962-2023),训练-测试约43:18主要结局:粮食生产指数(FPI)预测性能(R²、RMSE、MAE)最佳模型:贝叶斯岭回归:测试集R²=0.968,RMSE=2.695,MAE=2.294
全文技术路线图
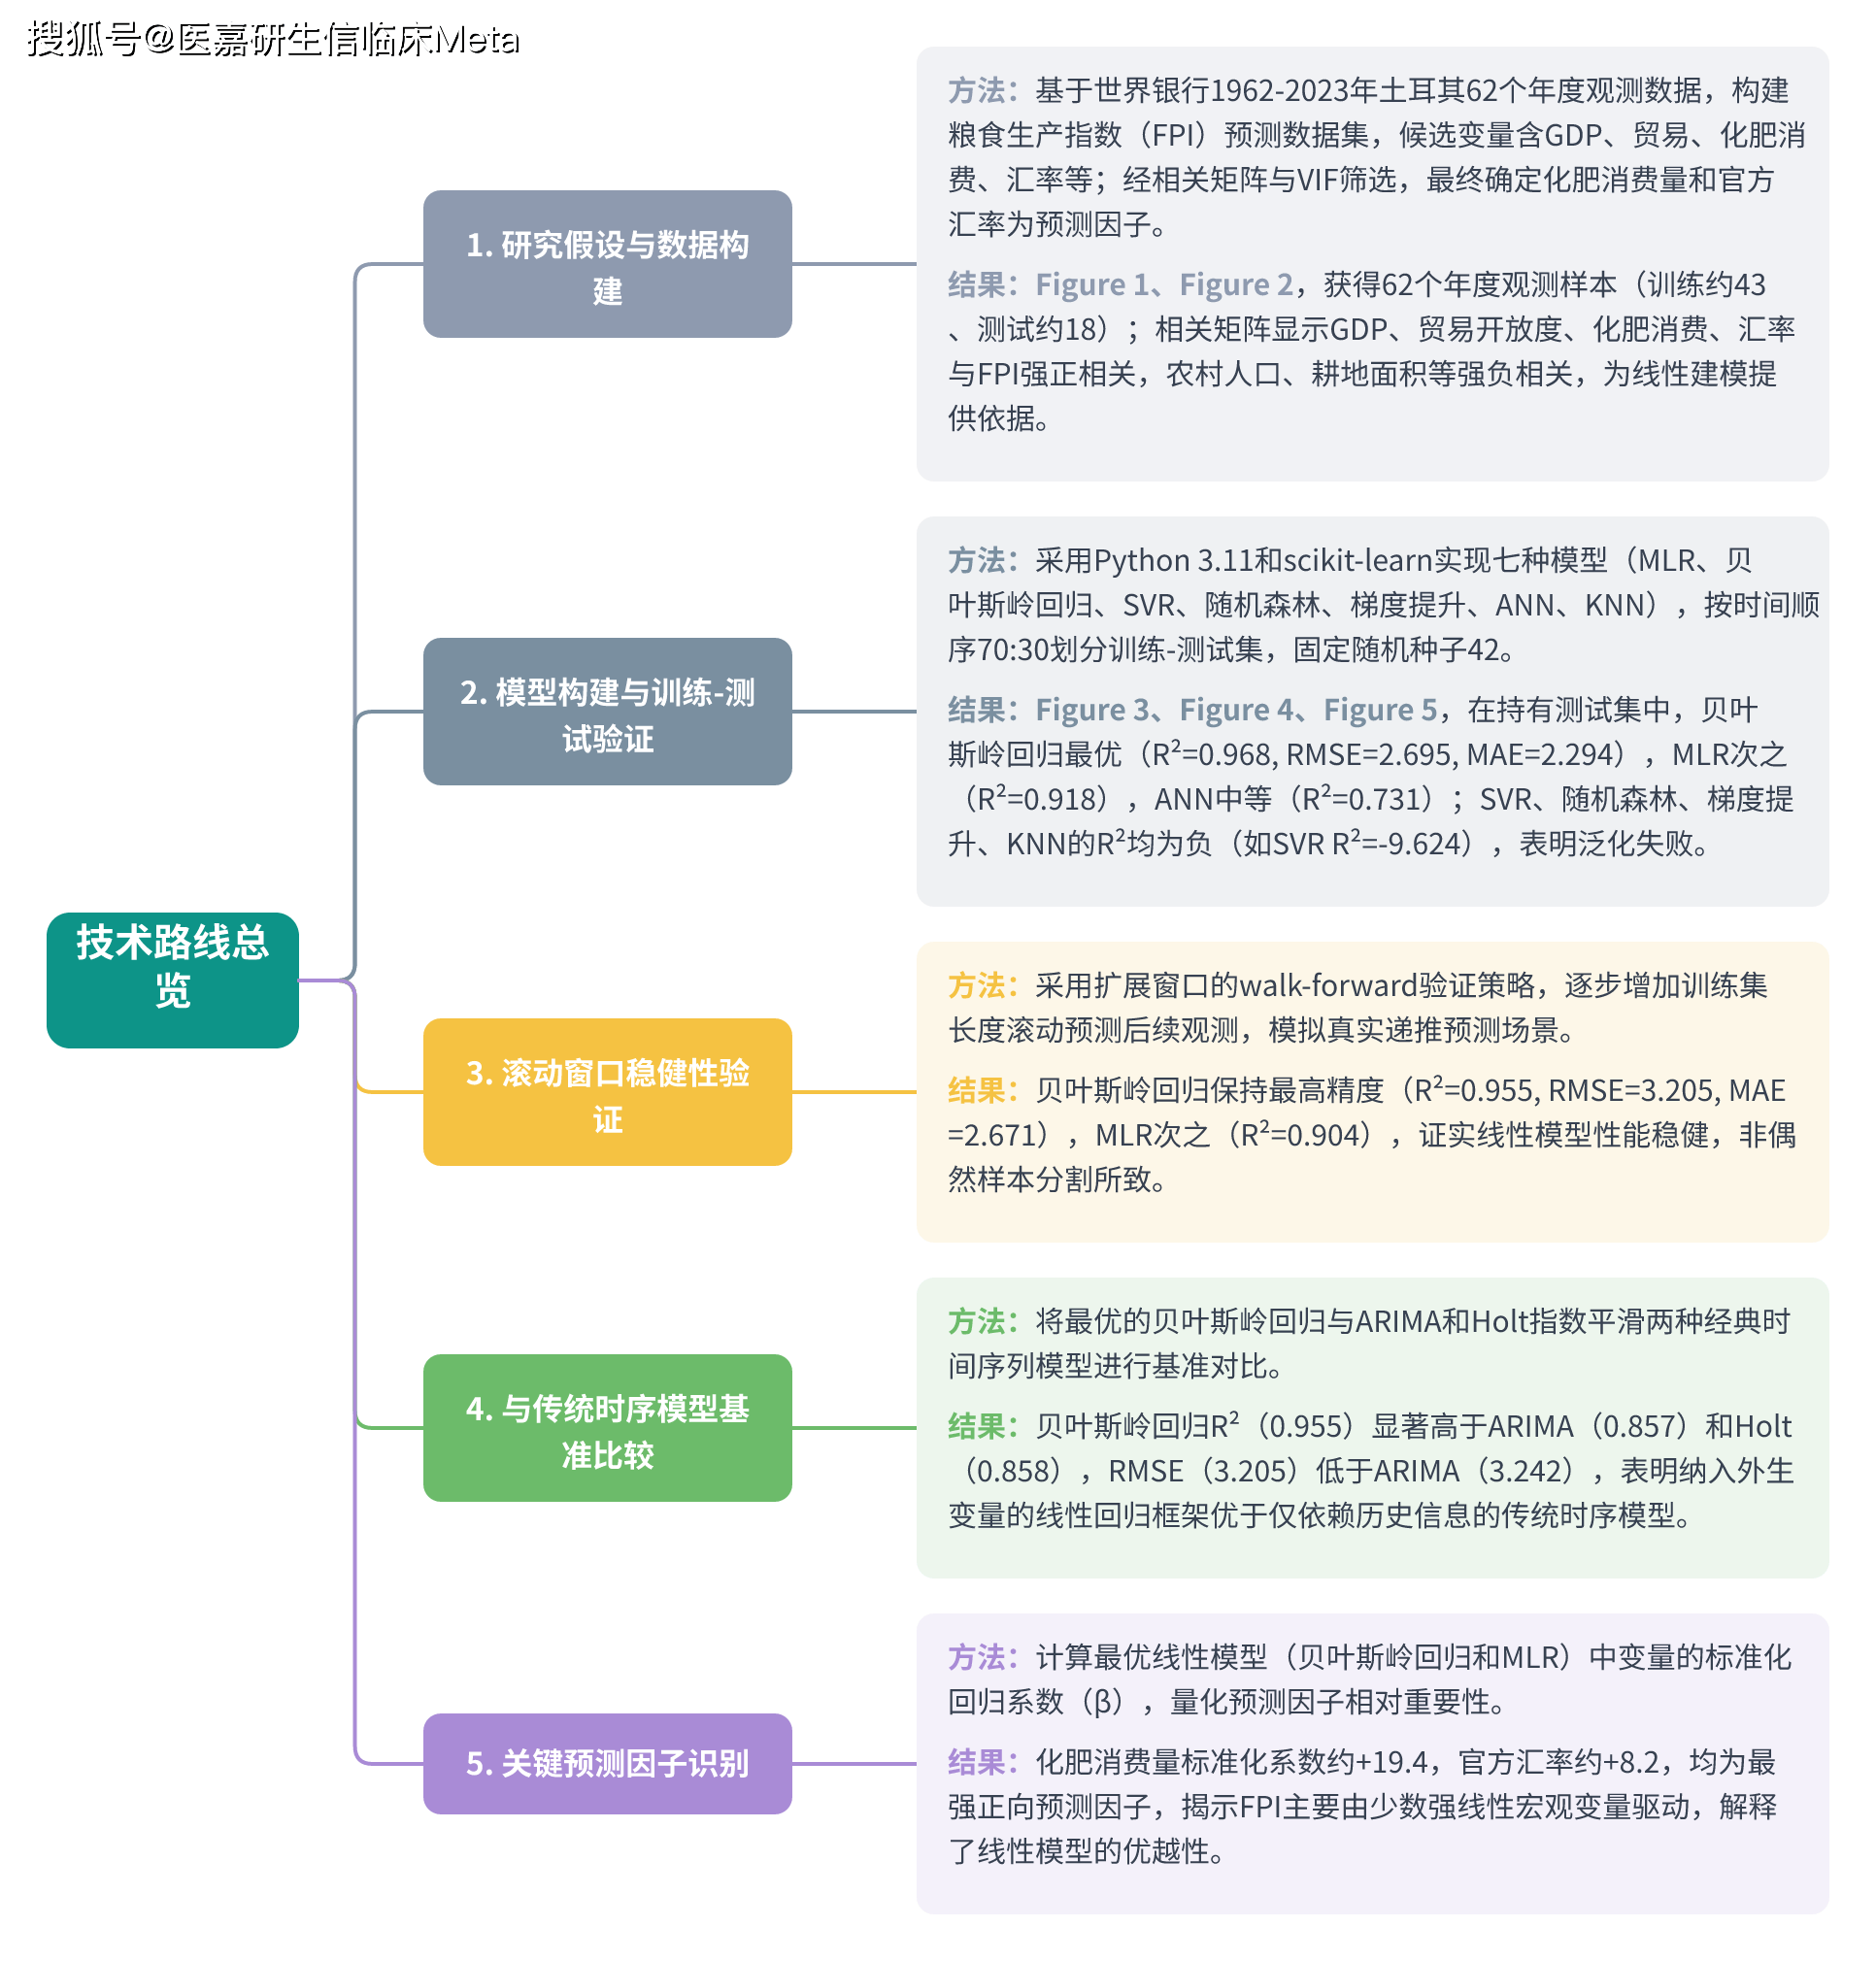
01 研究背景与科学问题
粮食生产指数(FPI)是衡量一个国家粮食安全与农业可持续性的核心指标。然而,粮食生产受到气候、经济、贸易、人口等多维因素交织影响,传统计量模型与新兴机器学习方法在预测能力上孰优孰劣,至今缺乏针对国家层面的系统比较。该研究聚焦土耳其——一个农业占重要地位的新兴经济体,利用世界银行1962-2023年的62年年度数据,首次系统评估七种机器学习算法在FPI长期预测中的表现 [Introduction]。作者指出,尽管机器学习在诸多领域展现强大拟合能力,但在小样本、强共线性的宏观经济数据中,复杂模型可能过拟合,而简单线性模型反而更稳健。这一科学问题直击预测建模的“模型-数据匹配”核心矛盾,也为粮食安全决策支持提供了方法学参考。
02 数据来源与方法
研究数据全部来自世界银行公开数据库,涵盖1962-2023年土耳其年度指标,包括FPI、GDP、贸易开放度、化肥消费量、汇率、农村人口、耕地面积等候选变量。作者采用系统化的变量筛选流程:首先通过相关矩阵观察与FPI的线性关系,再结合方差膨胀因子(VIF)剔除高度共线变量,最终确定以化肥消费量和官方汇率为预测因子 [Methods]。所有变量均经过ADF平稳性检验,虽多数非平稳,但作者选择保留趋势信息以服务长期预测。模型构建涵盖七种算法:多元线性回归(MLR)、贝叶斯岭回归、支持向量回归(SVR)、随机森林、梯度提升、人工神经网络(ANN)和K近邻(KNN)。验证策略采用按时间顺序的70:30训练-测试划分,并辅以扩展窗口的walk-forward验证,以模拟真实预测场景 [Methods]。所有实现基于Python 3.11和scikit-learn,固定随机种子42确保可复现性。
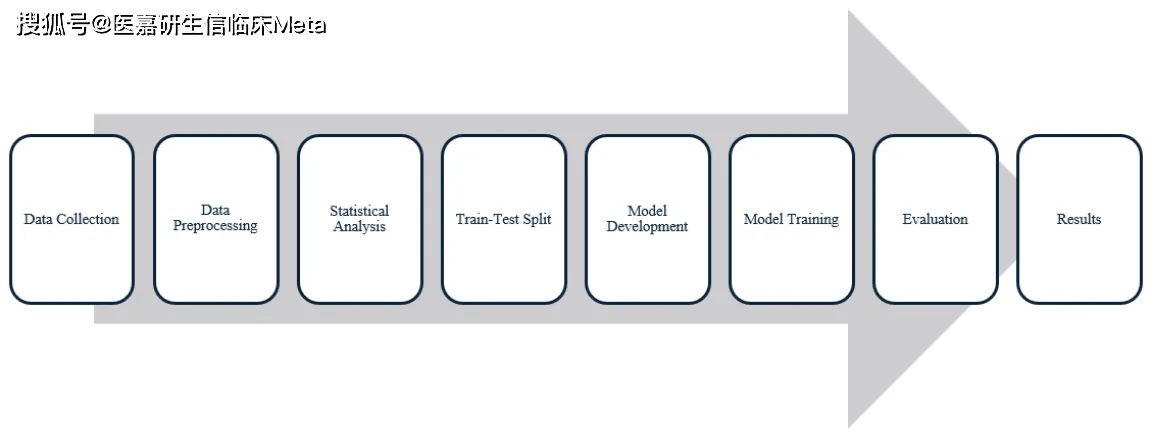
Figure 1 该图为研究设计流程图,从数据收集、预处理、变量筛选、模型构建到验证评估,完整展示了本研究的分析流程。读者可自上而下跟随箭头理解每一步骤,它明确了研究遵循结构化流程,保证了建模过程的系统性和可复现性,为后续结果的可信度提供了方法学支撑。
03 研究结果:从模型对比到稳健性验证
该研究通过严格的训练-测试划分与walk-forward验证,系统比较了七种机器学习模型在土耳其粮食生产指数预测中的表现,揭示了模型复杂度与实际数据特征之间的深刻矛盾。
板块1|持有测试集上线性模型优于非线性模型
结果1|贝叶斯岭回归在持有测试集中取得最高预测精度(R²=0.968, RMSE=2.695, MAE=2.294)。
论文在土耳其1962–2023年共62个年度观测值构建的持有测试集中(约18个测试样本),对七种预测模型进行了对比评估。作者发现,贝叶斯岭回归以R²=0.968、RMSE=2.695、MAE=2.294的成绩位居所有模型之首,意味着该模型能够解释约96.8%的食品生产指数(FPI)方差。这一结果是在最终预测变量集(当期化肥消费量与官方汇率)下取得的,体现了贝叶斯岭回归在处理小样本、多重共线性数据时的正则化优势。该模型的出色表现也为后续结果2–4的对比提供了参照基准——它确立了线性模型在此数据集上的性能上限。
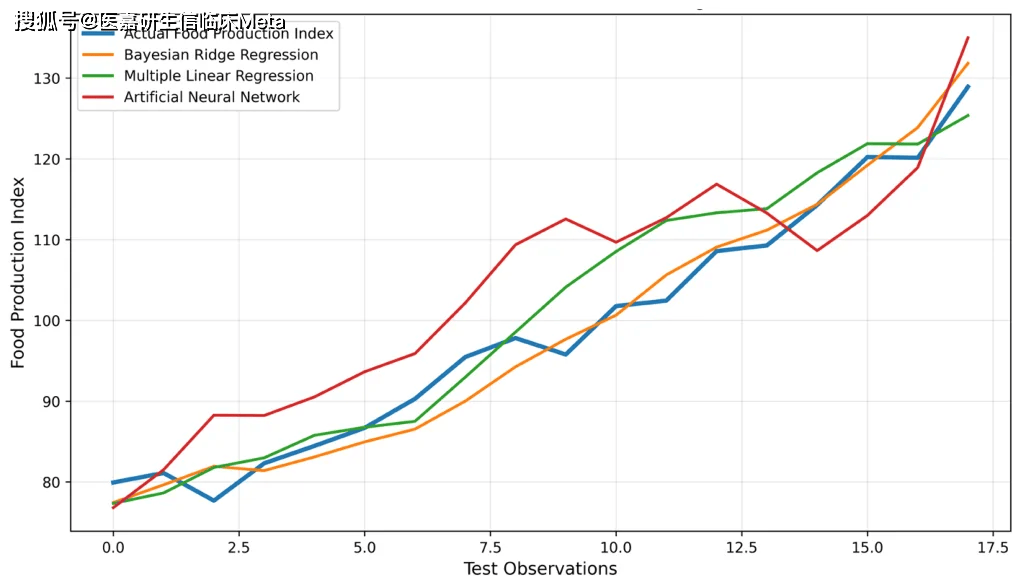
Figure 3 该图为时间序列预测误差图,展示贝叶斯岭回归、多元线性回归和ANN三种模型对实际FPI值的跟踪情况。图中可见贝叶斯岭回归和MLR的预测线紧密贴合实际值,而ANN在某些时期出现明显高估,直观印证了线性模型在捕捉趋势上的优势,为结果1-3提供了视觉证据。
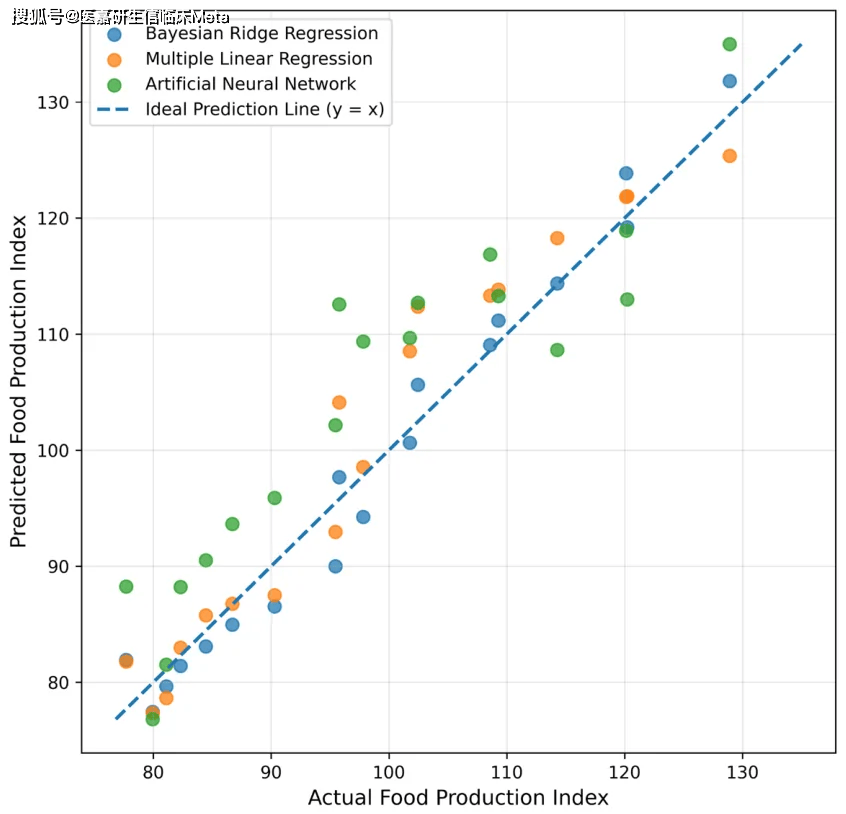
Figure 4 该散点图以45度虚线为理想预测线,展示三种模型的预测值与实际值的对应关系。贝叶斯岭回归和MLR的点紧密聚集在参考线附近,而ANN的点较为分散,说明线性模型的预测误差更小、更稳定,进一步支持了线性模型优于ANN的结论。
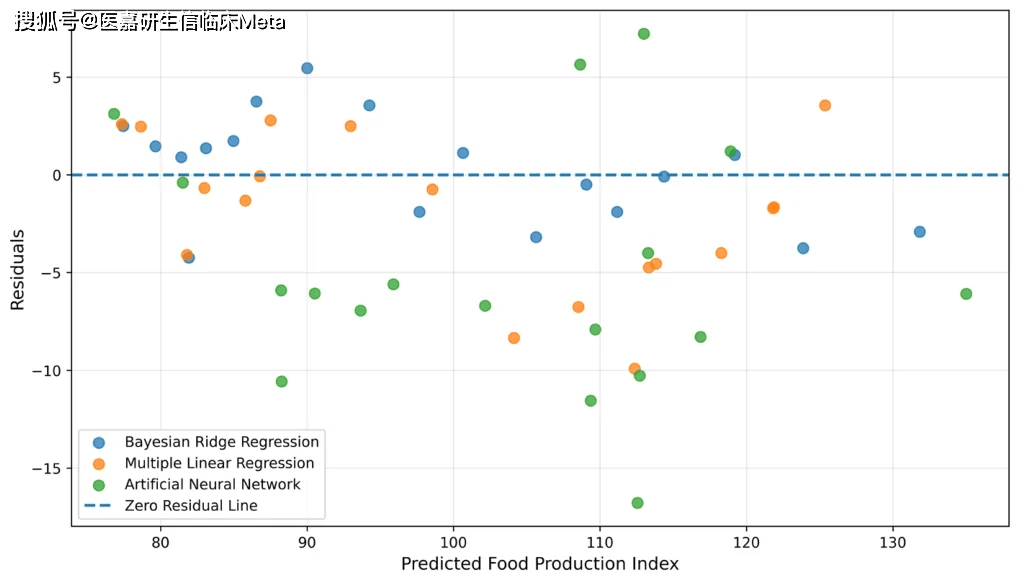
Figure 5 该残差图展示三种模型的预测误差分布,横轴为观测序号,纵轴为残差值。贝叶斯岭回归和MLR的残差围绕零线随机分布,而ANN的残差波动范围更大且存在系统性偏差,表明线性模型的误差结构更稳定,为模型稳健性提供了诊断性证据。
结果2|多元线性回归表现次优(R²=0.918, RMSE=4.329, MAE=3.469),证实了数据主要呈线性关系。
紧随其后的是多元线性回归(MLR),其R²=0.918、RMSE=4.329、MAE=3.469,虽略逊于贝叶斯岭回归,但仍保持了很高的预测精度。作者指出,MLR的强劲表现印证了FPI与所选预测变量之间的关系主要是线性的——这一判断与此前相关性矩阵和VIF分析所揭示的强线性关联相一致。MLR与贝叶斯岭回归之间的差距(R²相差0.05)可归因于后者通过贝叶斯先验对参数施加了收缩,从而在小样本下更有效地控制了过拟合。这一结果承上启下:既然最简单的线性模型都能达到0.9以上的R²,那么数据的内在结构显然更契合线性假设。
结果3|人工神经网络(ANN)表现中等(R²=0.731, RMSE=7.845, MAE=6.903),但逊于线性模型。
人工神经网络(ANN)在持有测试集中取得了R²=0.731、RMSE=7.845、MAE=6.903的成绩,虽优于后面将提到的四个负R²模型,但明显落后于两个线性模型(R²差距超过0.18)。作者认为,ANN的中等表现在意料之中——在仅约43个训练样本的条件下,ANN这类高容量非线性模型难以充分学习数据中的复杂模式,容易出现过拟合或欠拟合。这一结果与结果2形成鲜明对比:当数据本质呈线性且样本量有限时,复杂的非线性架构反而无法发挥其优势。这也为结果4中其他非线性模型的集体失效埋下了伏笔——非线性方法在此数据集上普遍难以泛化。
结果4|SVR、随机森林、梯度提升和KNN在持有测试集中R²为负,表明泛化能力差。
论文报告,支持向量回归(SVR)、随机森林、梯度提升和K近邻(KNN)四种模型在持有测试集中的R²均为负值——SVR为−9.624、随机森林为−2.873、梯度提升为−2.658、KNN为−3.075。负的R²意味着这些模型的预测误差大于简单采用实际值均值作为预测的基准模型,即它们完全未能捕捉FPI的变化规律。作者分析指出,这四种模型或因对高维稀疏特征敏感(SVR)、或因在极小样本下无法有效构建集成结构(随机森林、梯度提升)、或因距离度量在年度数据上失效(KNN),导致严重的过拟合和泛化失败。这一结果与结果1–3共同勾勒出完整的性能梯度:线性模型(贝叶斯岭回归≈MLR)>ANN>非线性集成/距离模型,清晰表明在此数据特征下,模型与数据的匹配度远比算法复杂性更重要。
板块2|滚动窗口验证和基准比较确认线性模型的稳健性与优越性
结果5|滚动窗口验证确认贝叶斯岭回归(R²=0.955)和MLR(R²=0.905)的稳健性。 为检验模型在时间序列数据上的泛化能力,作者采用扩展窗口(expanding-window)的walk-forward验证策略,即逐步增加训练集长度、滚动预测后续观测,以模拟真实的递推预测场景。在该验证框架下,贝叶斯岭回归仍保持最高精度(R²=0.955,RMSE=3.205,MAE=2.671),多元线性回归(MLR)紧随其后(R²=0.905,RMSE=4.672,MAE=3.672)。与前述留出测试集的结果(贝叶斯岭R²=0.968、MLR R²=0.918)相比,两个线性模型的性能仅出现轻微下降,说明其预测能力并非偶然的样本分割所致,而是对数据内在线性趋势的稳定捕捉。这一结果从验证策略层面强化了论文的核心判断:在土耳其食品生产指数这一小样本、强趋势、多重共线性的数据情境下,线性模型的结构简洁性与数据特征是高度匹配的。
结果6|贝叶斯岭回归优于传统时间序列基准模型(ARIMA R²=0.857, Holt R²=0.858)。 为确立所提框架的相对优势,作者将表现最佳的贝叶斯岭回归与两类经典时间序列模型——ARIMA和Holt指数平滑——进行基准比较。结果显示,贝叶斯岭回归的R²(0.955)显著高于ARIMA(0.857)和Holt(0.858),RMSE(3.205)也低于ARIMA(3.242),仅略高于Holt(3.180)。这表明,在纳入外生解释变量(化肥消费量、官方汇率)的回归框架中,线性模型比仅依赖目标变量自身历史信息的传统时序模型更能捕捉食品生产指数的变动来源。该结果与结果5形成逻辑闭环:滚动窗口验证确立了线性模型内部的稳健性,基准比较则确立了其相对传统方法的优越性,二者共同支撑了论文"模型与数据特征匹配优于算法复杂性"的核心论点——无论是复杂机器学习模型还是经典时序模型,均未能在该数据集上超越简单线性回归的预测表现。
板块3|标准化系数揭示关键预测因子及其对FPI的正向影响
结果7|标准化系数显示化肥消费量和官方汇率是FPI最强的正向预测因子。论文通过计算最终预测模型中各变量的标准化回归系数(β)来量化预测因子的相对重要性。结果显示,在土耳其62年(1962–2023)的年度观测数据中,化肥消费量的标准化系数约为+19.4,官方汇率的标准化系数约为+8.2,两者均为正值且数值显著高于其他候选变量,表明这两个变量对食品生产指数(FPI)具有最强的正向关联。这一分析是基于贝叶斯岭回归和多元线性回归这两个表现最优的线性模型进行的,通过将各变量标准化后纳入同一尺度比较其贡献大小。该结果从机制层面解释了为何线性模型在此数据集上表现优异——FPI的变动主要由少数几个具有强线性关系的宏观变量驱动,而非复杂的非线性交互。这与前文模型性能对比的结论形成闭环:既然关键预测因子与FPI呈近似线性的正向关系,那么能够有效捕捉这种线性结构的模型(贝叶斯岭回归、MLR)自然优于试图拟合复杂模式的机器学习算法。作者据此强调,在食品生产预测中,识别并理解核心驱动因子比盲目追求算法复杂性更为重要,这为土耳其粮食安全战略中优先调控化肥投入和汇率稳定提供了定量依据。
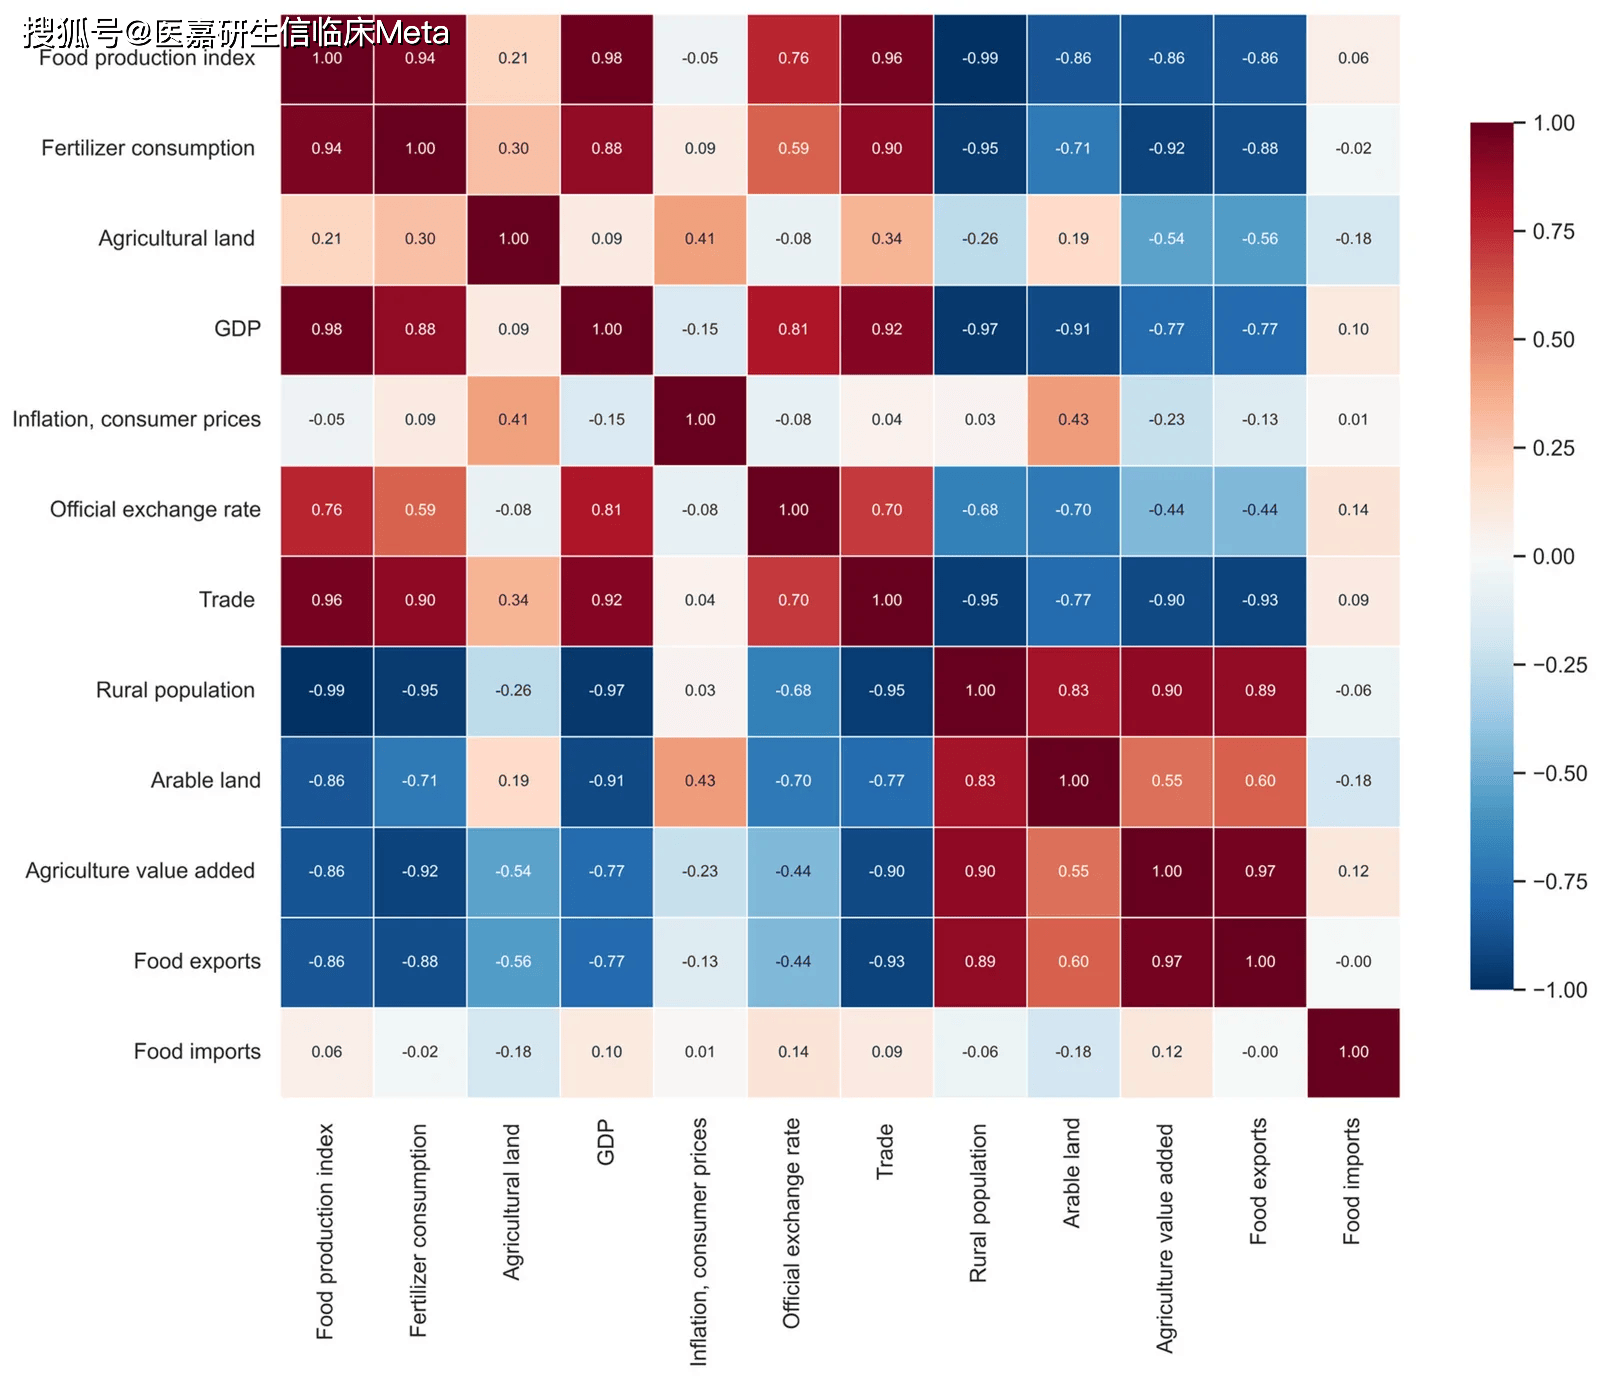
Figure 2 该图以热力图形式展示FPI与各候选变量间的皮尔逊相关系数,红色代表正相关,蓝色代表负相关。可观察到化肥消费量、GDP、贸易开放度等与FPI呈强正相关,而农村人口、耕地面积等呈负相关,这为后续基于VIF的变量筛选提供了直观依据,也初步揭示了数据主要呈线性关系。
04 深度解读与讨论
【解读观点】本研究最引人深思的发现并非某个模型胜出,而是复杂模型在小样本、强趋势、高共线性数据中的系统性失效。SVR、随机森林、梯度提升和KNN在测试集上均出现负R²(如SVR R²=-9.624),表明其泛化能力极差,这并非算法本身缺陷,而是数据规模与维度不匹配所致。62个年度观测点对于树模型和核方法而言过于稀疏,难以捕捉稳定的非线性模式。相反,贝叶斯岭回归与MLR的成功,揭示了FPI与预测因子间确实存在近似线性的长期关系,这与粮食生产受制于化肥投入和汇率等宏观因素的逻辑一致。作者强调“模型-数据兼容性比算法复杂度更关键”,这为预测建模领域提供了重要启示:在数据有限时,应优先考虑可解释、参数少的模型,而非盲目追求复杂算法 [Discussion]。此外,标准化系数显示化肥消费量(β≈+19.4)和官方汇率(β≈+8.2)均与FPI正相关,其中化肥的贡献尤为突出,提示农业投入政策对粮食生产的杠杆作用。
05 局限与展望
作者坦诚列出了多项局限:样本量仅62个年度观测,限制了复杂模型的学习能力;年度分辨率无法捕捉短期波动;未纳入降水、干旱、温度等环境变量,而气候因素对农业影响显著;未正式检验结构性断点和非平稳性;宏观经济预测因子间存在强多重共线性;结论仅适用于土耳其,外推需谨慎。这些局限也指明了未来方向:引入更高频数据、整合环境变量、采用贝叶斯结构时间序列或可解释AI技术(如SHAP)以增强模型透明度。对于临床研究者而言,本研究的方法论框架——从变量筛选、模型对比到多维度验证——同样适用于医疗预测场景,但需注意数据特性差异。
06 科研思路启发
本研究为利用公开数据发表预测模型类论文提供了完整范式,尤其适合医院数据或国家健康数据库的二次分析。可借鉴的套路包括:第一,选题上,选择一个具有政策意义的指标(如FPI、疾病发病率),并强调其多维影响因素,凸显研究价值;第二,方法上,系统比较多种模型(从线性到复杂机器学习),不仅报告最优模型,更分析不同模型的失败原因,这增加了论文的深度和普适性;第三,验证上,采用时间序列特有的walk-forward验证,比单一随机划分更贴近实际预测场景,提升可信度;第四,写作上,将模型性能与政策含义紧密结合,如本研究将化肥系数与农业政策关联,增强了转化意义。此外,本研究公开代码和固定随机种子的做法,也值得借鉴以提高可复现性。对于医院数据,类似思路可应用于患者预后预测、再入院风险建模等,但需注意样本量和事件数对复杂模型的限制。
金句
在62个年度数据点上,贝叶斯岭回归以R²=0.968的预测精度击败了复杂机器学习模型,提示:模型与数据的匹配,远比算法的堆砌更为重要。
医嘉研(河北橙方信息技术有限公司)医嘉研(2019年成立,位于石家庄)专注医学科研,围绕“科研思维培养—技能实训—成果转化”三大维度,已与多家医院及高校建立战略合作,为临床一线提供系统化科研支持。
服务对象
1. 临床医生 / 医学生- 一对一个性化培训,涵盖 SCI 全流程辅导(选题、数据挖掘/清洗/统计、图表绘制、写作指导、翻译润色、查重降重、期刊推荐投稿)
- 覆盖多种研究类型:
- Meta 分析(经典 / 网状 / 伞状 / 含机器学习)
- 临床研究(MIMIC / CHARLS / NHANES / UK Biobank / GBD 等公共数据库,以及机器学习、预测模型等热门方法)
- 生信分析(单细胞测序 / 多组学 / 孟德尔随机化 / 虚拟细胞 / 虚拟敲除等)
- 干湿结合(细胞 / 分子 / 动物实验)
- 累计 1000+ 成功案例,口碑专业,性价比高,被学员誉为最靠谱机构之一。
- 结合 AI 及前沿文献,量化科研指标
- 利用临床数据库及多组学方法,量身定制科研方案,助力成果转化
- 整合跨科室资源,协助申报重点研发计划、自然基金等项目,提供针对性课题申报指导














