

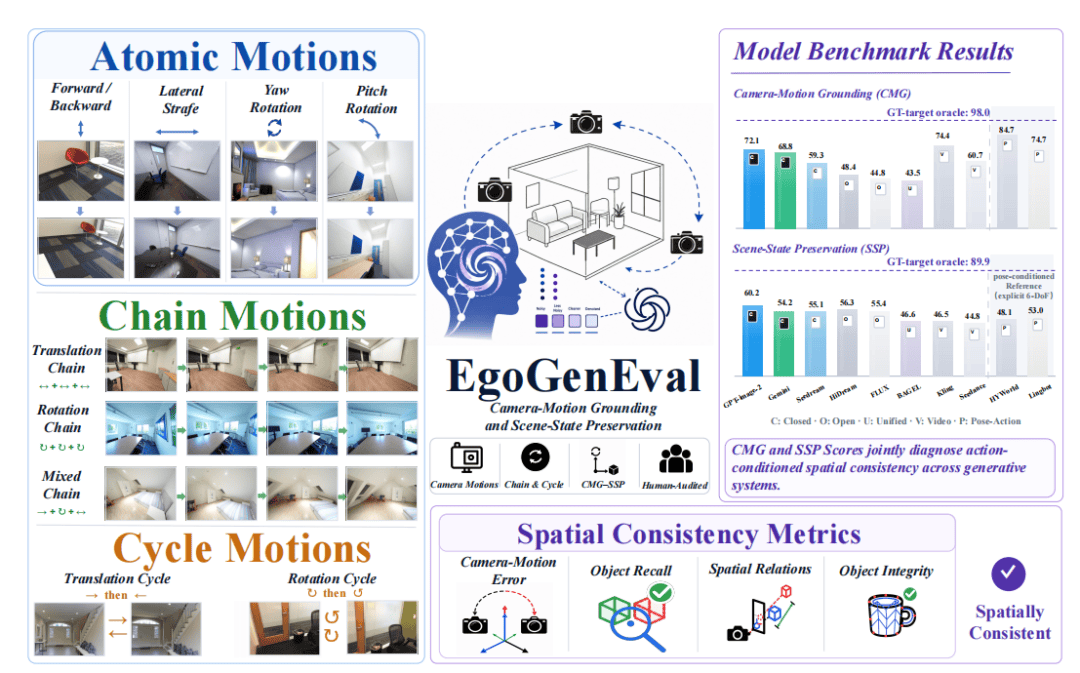
 近期,一支由上海人工智能实验室、复旦大学、香港大学、上海交通大学等机构组成的研究团队提出了一套名为EgoGENEVAL的评估基准,旨在系统评估视觉生成器在自我运动条件下的物理一致性。该研究为视觉生成模型在空间推理和具身规划中的应用提供了重要的评估工具。
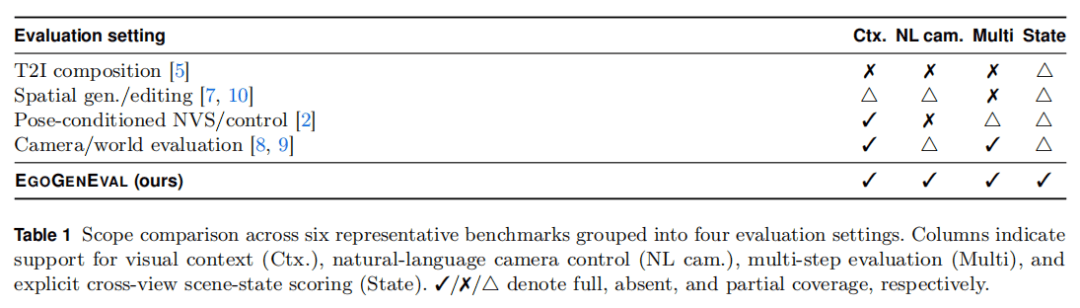
近年来,视觉生成器能够生成越来越逼真的图像,并具备一定的可控性。然而,当要求生成器执行相机运动时,输出图像往往不能保持物理一致性——可能停留在原始视角附近、错误估计运动幅度,或在生成过程中丢失物体。这种物理一致性的不足限制了生成器作为视觉模拟器在空间推理和智能体视觉想象中的应用。现有评估基准大多关注孤立图像的质量或单步编辑效果,没有将相机运动执行与场景状态保持作为两个独立维度进行系统评估。
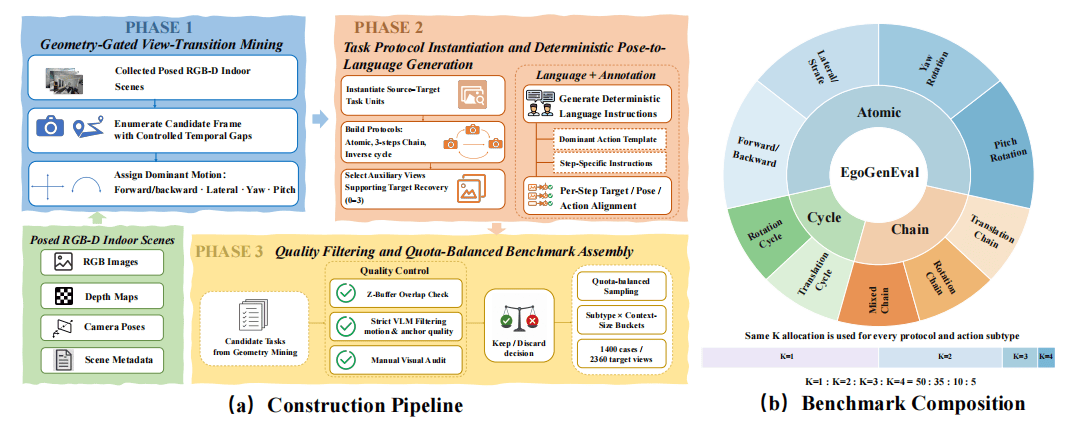
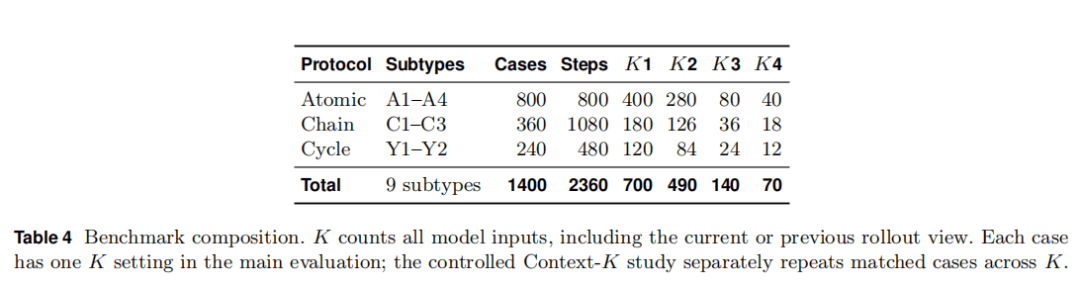
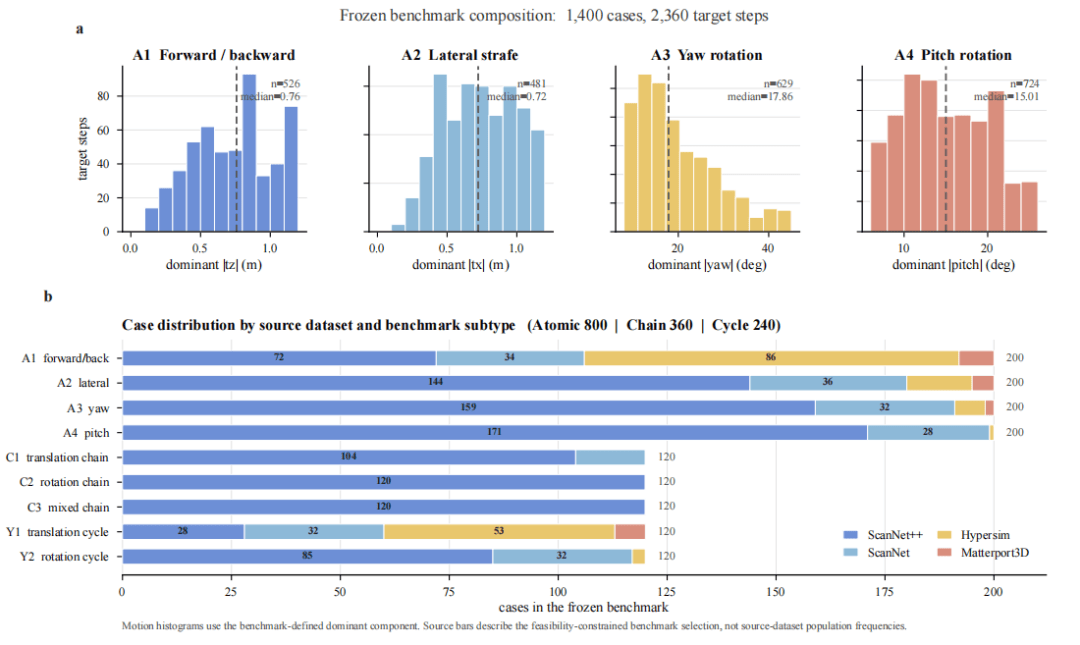

针对这一空白,研究团队构建了EgoGENEVAL基准。该基准包含1400个案例和2360个目标视图,覆盖单步、三步链和反向循环三种协议。数据来自ScanNet++、ScanNet、HyperSim和Matterport3D等室内场景数据集,通过挖掘几何对齐的视图转换,生成包含运动方向和幅度的自然语言指令。评估时,模型只接收图像和语言指令,不提供姿态信息。基准从两个维度测量生成质量:相机运动接地评估生成图像是否实现请求的相机运动,场景状态保持评估目标视图是否保持场景中的物体存在、空间布局和外观。两个指标均经过盲法人工判断验证,与人工排序高度一致。
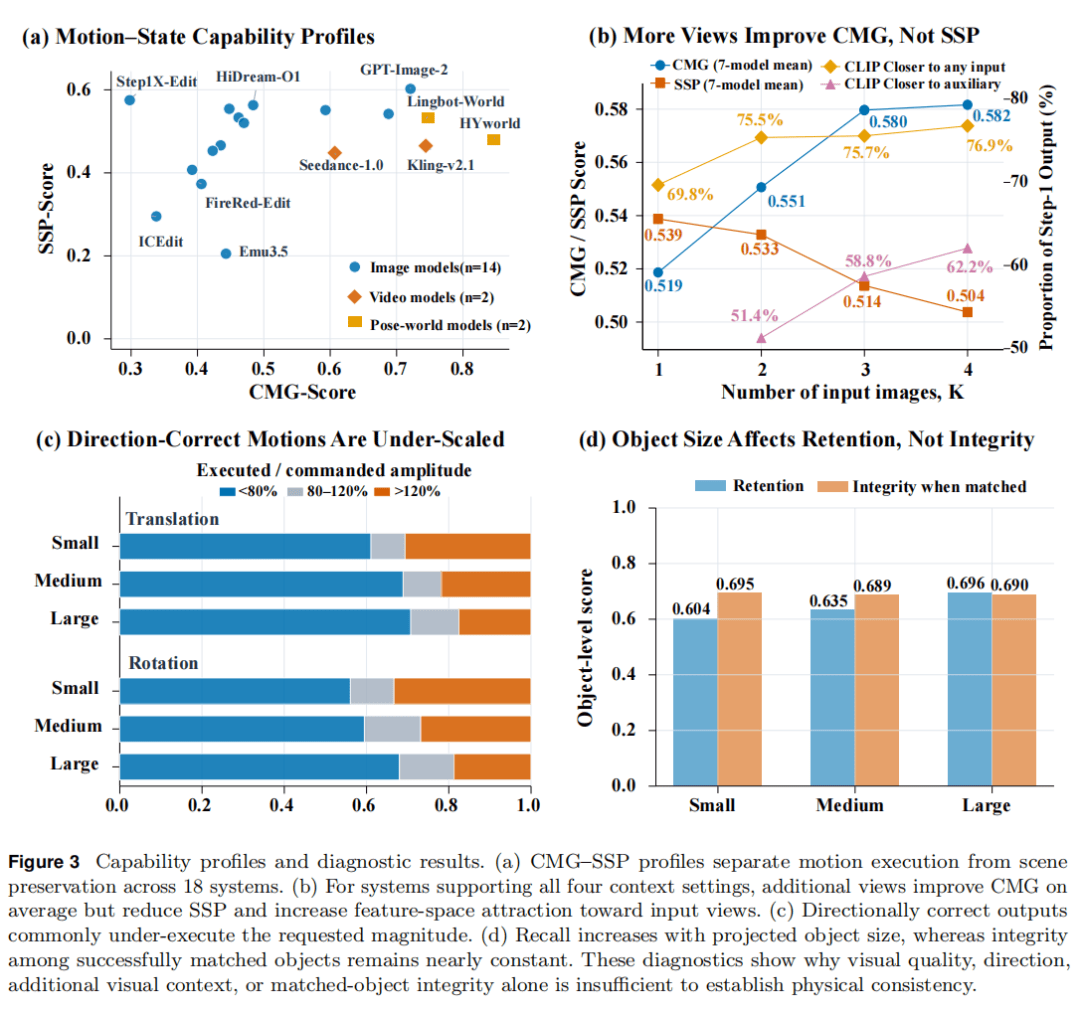
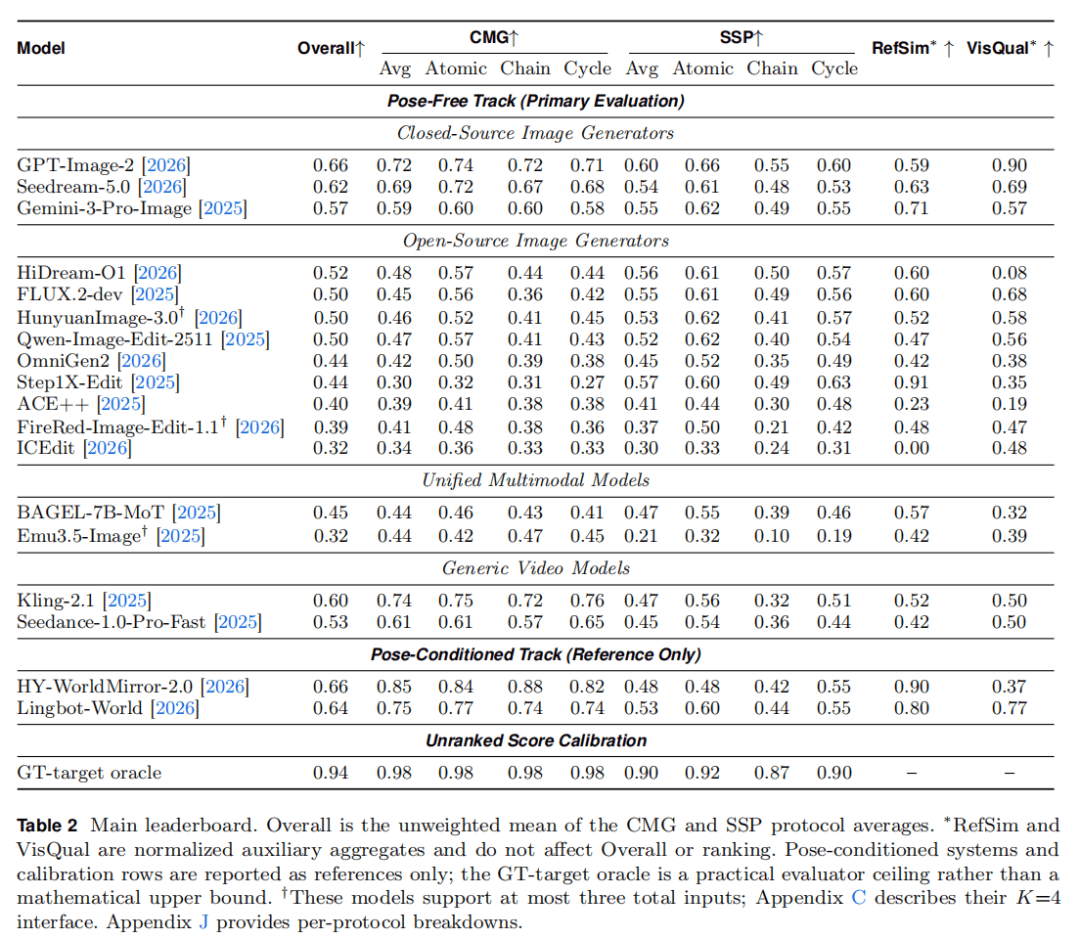
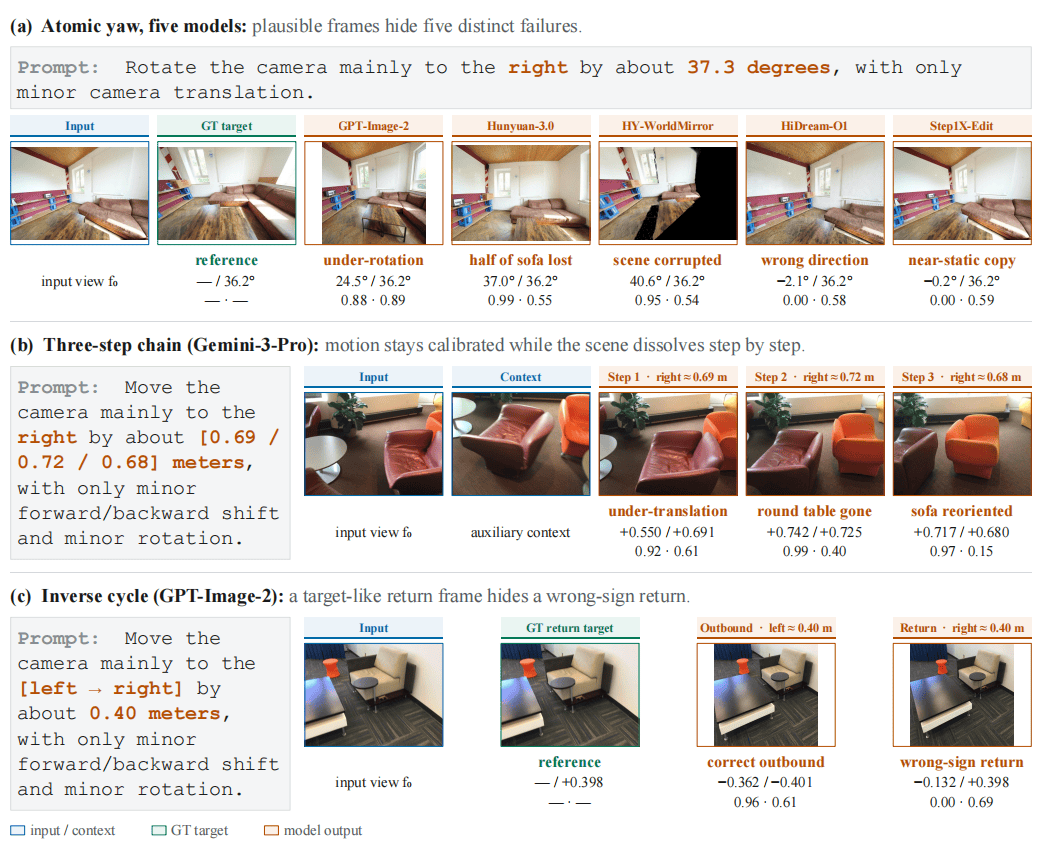
研究团队评估了16个无姿态生成器和2个姿态条件参考模型。结果显示,当前模型普遍难以同时执行相机运动并保持场景状态。运动保真与场景保真是两个不同的维度:高相机运动接地得分并不保证高场景状态保持得分。例如,HYWorldMirror的相机运动接地得分最高,但其场景状态保持得分低于八个无姿态系统;FLUX.2-dev的场景状态保持得分较高,但相机运动接地得分偏低。方向正确相对容易实现,但幅度执行普遍不足:在方向正确的输出中,59.5%至70.7%偏离请求位移超过20%,且这一比例随请求运动幅度的增大而升高。多步一致性也不能从单步执行中自然继承:从原子案例到三步链,所有16个系统的场景状态保持平均下降0.164,反向循环中66.3%的返回步骤近乎静止。增加上下文视图从1张到4张,相机运动接地平均提升,但场景状态保持下降,模型倾向于模仿辅助视图而非将其融合为一致的目标视图。
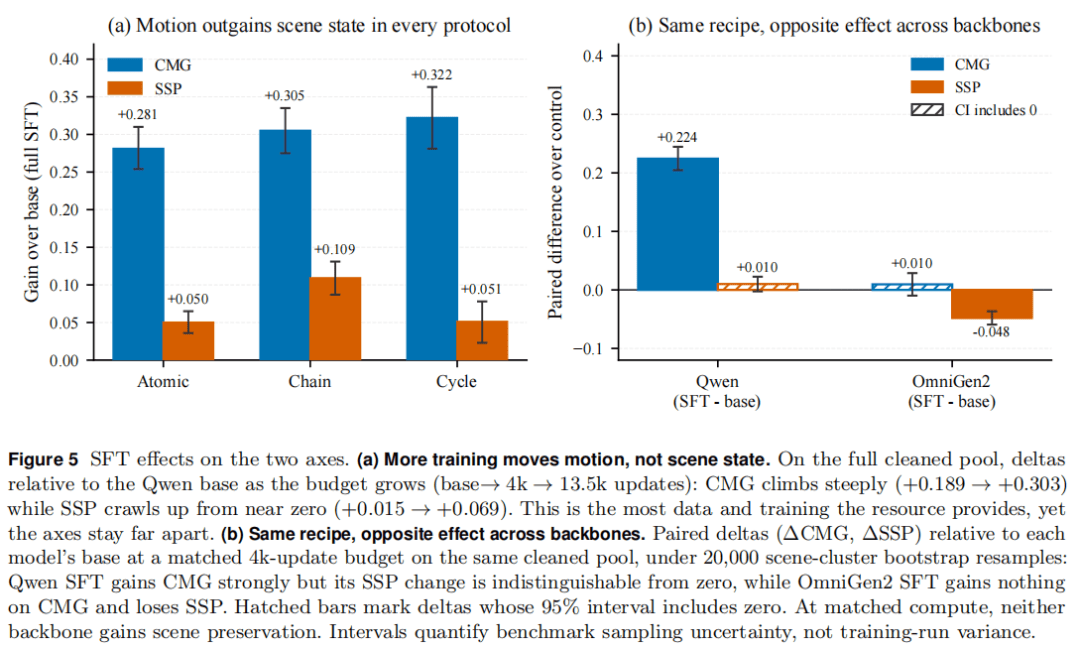
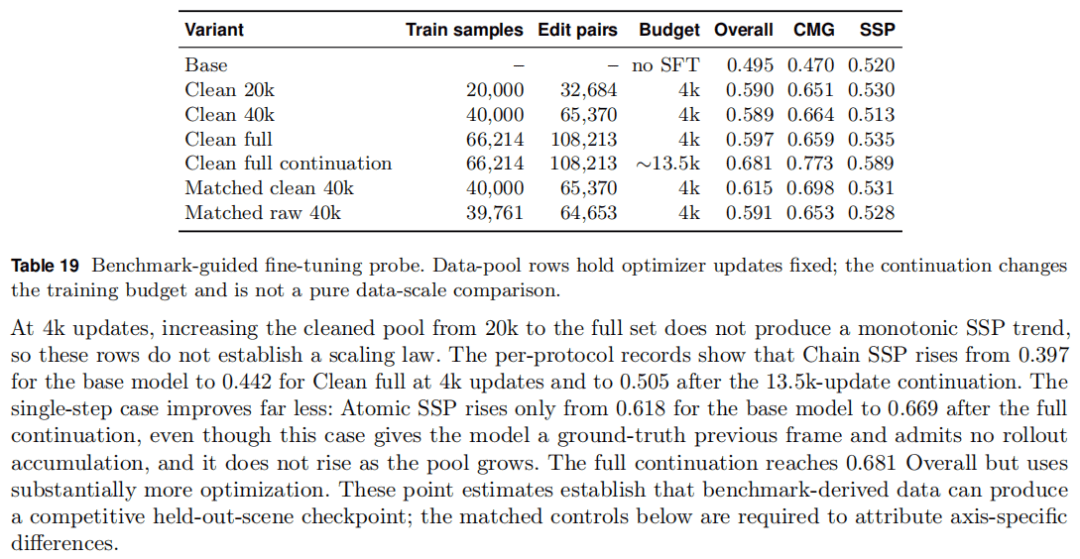
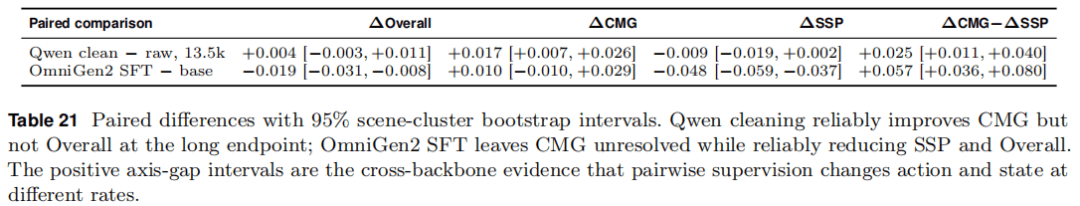
研究还构建了EgoGEN-Train,包含66214条轨迹和108213个教师强制编辑样本,用于监督微调研究。在Qwen-Image-Edit上进行微调后,总体得分从0.495提升至0.681,但相机运动接地提升0.303,场景状态保持仅提升0.069,两者严重不对称。跨骨干测试显示,同一微调方案在Qwen上提升相机运动接地但不提升场景状态保持,在OmniGen2上不提升相机运动接地且降低场景状态保持。即使使用完整训练池和最长训练预算,场景状态保持仍远落后于相机运动接地。这表明成对教师强制目标本身是限制因素,需要转向轨迹中心范式,结合自条件 rollout 和显式姿态与可见性监督。
该研究揭示了当前视觉生成器在自我运动下的物理一致性不足,为改进生成模型提供了明确方向。研究团队已公开代码,供后续研究使用。
参考文献:Long, Y., Zhu, C., Gou, Z., Lin, J., & Wang, T. (2026). Beyond visual quality: Evaluating physical consistency under ego-motion with EgoGENEVAL [Preprint].














