

摘要:随着大语言模型参数规模持续扩容,传统稠密模型面临算力开销激增、边际性能增益递减、训练推理成本居高不下的产业困境,模型规模与计算成本的制衡矛盾日益凸显。混合专家模型(Mixture of Experts, MoE)作为稀疏化大模型的核心架构,彻底颠覆了稠密模型全员激活的运算范式,通过多专家子网络拆分、按需稀疏激活、门控动态调度的核心机制,实现了模型参数规模扩张与实际计算开销解耦,有效破解了大模型“性能提升必增成本”的行业难题。本文系统性拆解MoE大模型的底层架构与运行机理,深入剖析其兼顾高性能与低成本的核心逻辑,对比稠密模型的差异化优势,梳理MoE架构在训练稳定性、推理时延、负载均衡方面的固有瓶颈,并总结技术优化路径与产业应用边界,为高效可扩展大模型的研发、落地与成本优化提供学术支撑与实践参考。
关键词:MoE混合专家模型;大语言模型;稀疏激活;性能增益;算力成本;模型缩放
一、引言
大模型技术的迭代核心依托模型缩放定律,参数规模越大、知识容纳能力越强、通用智能水平越高,但传统稠密大模型存在显著的结构性缺陷。稠密模型在每一轮训练与推理过程中,所有参数均参与计算,模型参数量扩容将直接带来算力、存储、能耗与时间<div id="lqzb4.com5982">成本的线性增长。当模型参数突破千亿、万亿级别后,极致的算力开销与高昂的落地成本,严重制约了大模型的规模化商用与轻量化部署,同时出现性能边际收益递减问题,陷入“堆参数、高消耗、低增益”的发展瓶颈。
在此背景下,MoE混合专家模型凭借稀疏化计算范式成为大模型高效扩容的核心突破口,彻底重构了大模型的缩放逻辑。不同于稠密模型的全量激活模式,MoE模型将整体网络拆分为多个专业化专家子网络,通过门控机制根据输入语义动态激活少量适配专家,实现“多参数储备、少参数运算”的运行模式,在大幅提升模型知识容量与泛化性能的同时,有效控制单次计算的算力成本,完美平衡大模型性能升级与成本管控的核心诉求。当前GPT-4、DeepSeek、Mixtral等主流前沿大模型均采用MoE架构,充分验证了其技术先进性与产业实用性。基于此,本文深度拆解MoE模型的核心机制、优势逻辑与现存短板,厘清其性能与成本双向平衡的底层原理。
二、MoE混合专家模型的核心架构与运行机理
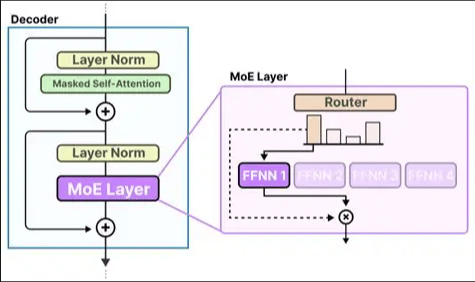
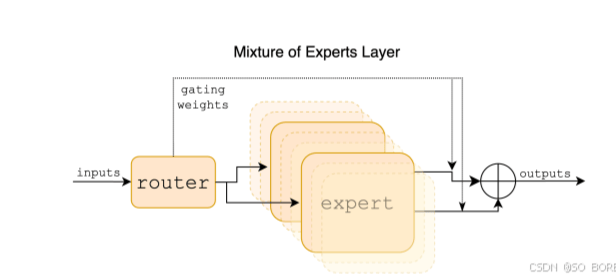
MoE混合专家模型是基于稀疏集成学习的新型大模型架构,核心由专家子网络、门控调度机制、残差连接模块三部分构成,核心设计逻辑是“任务细分、专家专精、按需激活”,从架构层面打破稠密模型的计算桎梏。
首先是专家子网络层,MoE模型将传统Transformer前馈网络拆分为多个结构独立、参数差异化的专家子网络,各专家在预训练过程中自主学习不同领域的知识特征,形成专业化能力分工,部分专家擅长逻辑推理、数理计算,部分专家擅长文本创作、语义理解、知识问答,实现知识体系的精细化拆分与专业化沉淀,大幅提升模型整体知识覆盖度与任务适配能力。
其次是核心门控调度机制,作为MoE模型的调度中枢,门控网络负责对输入文本特征进行实时解析,根据任务语义特征动态筛选匹配度最高的Top-K专家子网络参与计算,其余专家处于休眠状态,不产生任何算力开销。主流MoE架构通常设置8至64个专家,单次推理仅激活2至4个核心专家,激活参数占比不足总参数的10%,形成极致的稀疏计算特性。
最后是集成输出模块,通过残差连接与归一化处理,整合激活专家的计算结果,完成语义输出与特征反馈,既保障多专家协同运算的稳定性,又规避稀疏计算带来的特征缺失、逻辑断裂等问题,实现高性能、低损耗的模型运算闭环。
三、MoE模型兼顾性能与成本的核心优势机制
3.1 参数扩容无算力绑定,突破稠密模型缩放瓶颈
传统稠密模型的参数量与计算量呈严格正相关,参数扩容必然带来算力成本线性攀升,无法实现低成本性能升级。而MoE模型实现了模型容量与计算开销的解耦,海量专家参数作为知识储备存在,仅在匹配对应任务时按需激活,日常训练与推理的实际计算量仅与激活专家数量相关。相关研究数据表明,MoE模型可依托与13亿稠密模型相当的训练算力,实现67亿稠密模型的智能水平,算力利用率提升5倍以上,在不显著增加计算成本的前提下,实现模型性能的跨越式提升。
3.2 专家专业化分工,提升模型精细推理性能
稠密模型采用统一参数处理所有语义任务,通用能力强但细分领域精度不足,易出现逻辑模糊、知识混淆、推理偏差等问题。MoE架构通过多专家分工训练,让不同专家专注适配细分任务场景,形成差异化专业能力,能够精准匹配复杂语义、数理推理、专业知识、创意生成等多元任务需求,有效降低模型幻觉、提升推理精度与响应质量。同时,稀疏激活模式减少了无效参数运算与特征干扰,让模型计算更聚焦、推理更精准,实现性能质量的实质性升级。
3.3 训练高效迭代快,大幅降低边际研发成本
在模型迭代层面,稠密大模型每次升级均需全量参数重新训练,迭代周期长、算力消耗极大。MoE模型具备模块化迭代优势,可针对薄弱领域专项优化对应专家子网络,无需全量参数重训,大幅降低迭代算力成本与研发周期。同时,稀疏激活机制大幅降低冗余计算,在同等算力预算下,MoE模型可承载更大规模的数据集训练、更丰富的知识迭代,持续提升模型泛化能力,形成“低成本迭代、高性能增益”的正向循环。在推理落地阶段,MoE模型单Token生成成本较同性能稠密模型可降低一个数量级,极大缓解了大模型商用的算力成本压力。
四、MoE架构的固有短板与落地瓶颈
4.1 专家负载不均衡,存在拖尾时延效应
门控调度的任务分配偏差极易导致专家负载失衡,高频通用任务集中激活少数热门专家,多数冷门专家长期休眠、能力闲置,造成参数资源浪费。同时,在分布式并行推理场景中,过载专家的计算延迟会拖累整体推理流程,产生显著的拖尾效应,导致MoE模型推理时延波动大于稠密模型,实时交互场景适配性不足。部分研究表明,专家负载失衡会直接降低模型算力利用率,抵消部分稀疏计算的成本优势。
4.2 推理架构复杂,工程落地门槛高
相较于结构简洁的稠密模型,MoE模型包含多专家调度、路由计算、负载均衡、多分支融合等复杂逻辑,推理框架、显存调度、分布式部署难度大幅提升。稀疏激活的动态计算特性导致模型算力消耗动态波动,难以精准预估资源占用,对服务器算力调度、显存优化、编译适配提出更高要求,中小规模企业落地门槛较高,限制了技术的普及应用。
4.3 训练稳定性与专家冗余问题突出
MoE模型训练过程中易出现专家坍缩问题,即部分专家功能趋同、同质化严重,无法形成有效能力互补,导致模型参数冗余、知识重叠,无法充分发挥大容量优势。同时,门控路由的随机性易引发训练震荡,相较于稠密模型,MoE模型的训练稳定性、收敛难度更具挑战,需要专属优化算法与调参策略支撑。
五、MoE模型优化路径与产业发展展望
MoE架构的核心价值在于打破了传统大模型“性能与成本不可兼得”的三角困境,是当前大模型高效缩放的最优范式之一。针对现存短板,行业已形成成熟的优化路径:通过动态负载均衡路由算法、专家容量自适应调度,解决负载失衡与拖尾时延问题;通过专家差异化训练、知识解耦约束,规避专家坍缩与同质化冗余;通过推理引擎专项优化、稀疏计算编译加速,降低工程部署门槛、压缩推理时延。
从产业趋势来看,MoE将成为中高端通用大模型的主流架构,短期内将持续优化稀疏激活策略,平衡激活稀疏度与模型稳定性,实现算力效率最大化;中长期将向精细化专家分工、自适应动态路由、软硬协同优化方向迭代,进一步缩小与稠密模型的时延差距,兼顾高性能、低成本、低时延的综合优势。同时,轻量化MoE架构将逐步下沉至行业垂直场景,实现通用能力与低成本落地的双向兼顾。
六、结语
MoE混合专家模型的核心创新,是通过稀疏化架构重构大模型的计算与缩放逻辑,彻底解决了稠密模型参数扩容与成本失控的核心矛盾。其依托多专家专业化分工实现模型性能跃升,依靠按需稀疏激活严控计算成本,以架构创新实现了高性能与低成本的双向平衡,成为后摩尔时代大模型技术迭代的核心突破口。尽管当前MoE模型存在负载不均衡、工程复杂度高、训练稳定性不足等阶段性瓶颈,但均为可通过算法优化、工程迭代破解的非原理性缺陷。未来,随着路由算法、专家优化、部署引擎的持续完善,MoE架构将进一步释放技术红利,成为大模型规模化、低成本、高质量落地的核心支撑,持续推动通用人工智能产业高效、可持续发展。












