
 ypxx.net")
从三层意图路由到 DAG 编排,从事件溯源到 NAT 穿透,拆开看它的工程取舍
现在做 Agent 框架的人不少,但大多数是"搭微服务":LLM 一个服务、向量库一个服务、工具网关一个服务,再用一堆消息队列串起来。OpenChiip Harness 走了另一条路——把对话、技能、工具、记忆、多智能体、资源监控全部塞进同一个 Python 进程,再配一个开箱即用的 React 后台。这篇文章我把它的核心代码翻了一遍,聊清楚它到底是怎么做到的。
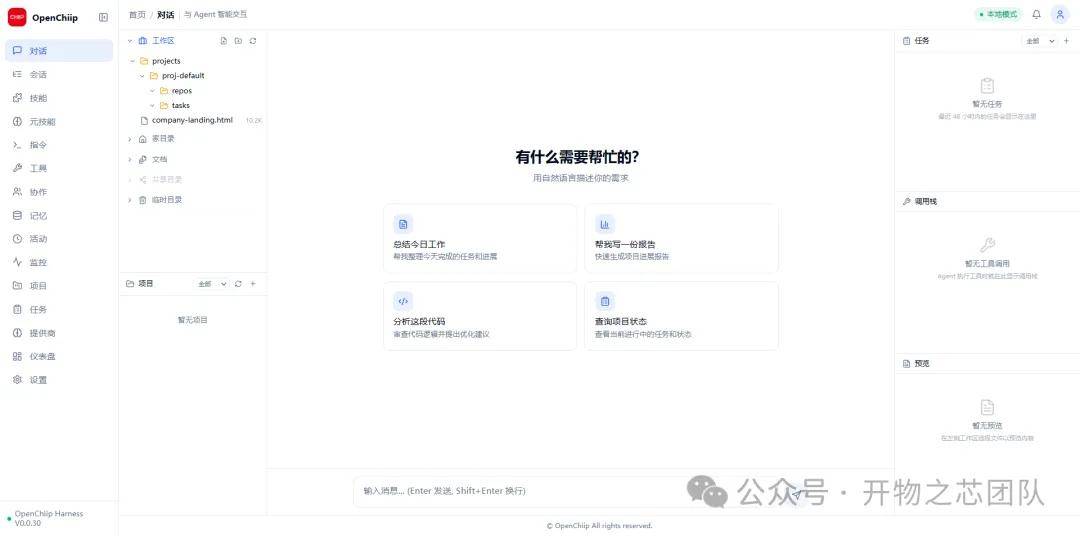
OpenChiip Harness 自带的 Web/桌面管理后台(截图来自仓库 README)
01
先搞清楚:它到底是个什么
README 里一句话定位很准——可自托管的智能体运行与编排框架。它同时提供三种身份:
● 本地 Agent 服务:一条 openchiip-harness serve 起来,FastAPI + Web UI 就有了。
● 平台节点:加个 --platform wss://...,进程主动向外建 WebSocket,穿透 NAT,不需要公网 IP、不需要端口映射,平台就能把任务派下来。
● 桌面应用:Tauri 2.0(Rust)包一层,Windows/macOS/Linux 都有安装包,还有 PyInstaller 单文件 exe。
一句话技术栈
后端 Python 3.10+ / FastAPI / SQLite / WebSocket;前端 React 18 + TypeScript + Vite + Tailwind + Zustand + TanStack Query;桌面壳 Tauri 2.0 (Rust);LLM 兼容百度文心、OpenAI 以及任意 OpenAI 兼容接口。
02
整体架构:六层盒子,从浏览器一路压到 SQLite
整个项目的分层非常克制。我按 agent_runtime/main.py 里 AgentApp.__init__ 的组装顺序画了一张图:
前端层 · React 18 + Vite + Tailwind
ChatViewConversation Node 注册表16 个管理后台页面WebSocket 实时
接口层 · FastAPI
12 个 REST 路由/ws 实时通道SSE 流式对话Swagger /docs
组装层 · AgentApp
CapabilityRegistryPromptAssemblerPluginManagerSubagentManagerCompactionProvider
智能循环 · Agent Loop
IntentRouterSkillManager(DAG)LLM Function CallingOrchestrator 编排
可靠性三件套
SessionLog 事件溯源ToolPipeline 守卫管道Checkpoint 崩溃恢复
持久层 · SQLite
会话/执行日志Session Events记忆(RAG)Token 计量检查点
这里最值得说的不是"用了什么框架",而是它的组装思路:AgentApp 是一个上帝类,启动时把 DB、LLM 客户端、记忆、工具、DAG 执行器、技能管理、元技能、命令、路由器、诊断器、调度器、A2A、能力注册表、插件、提示词组装器、压缩器、子 Agent 管理器、编排器全部 new 一遍——单进程、单实例、靠 lifespan 管理生命周期。代码里还专门留了一段注释吐槽历史教训:早期版本另建了一份 AgentApp,导致平台侧看到模式反复跳变,所以现在强制全进程只能有一个实例。
03
一条消息的旅程:5 道关卡才轮到 LLM
这是我觉得最能体现工程功力的部分。看 process_message_stream,用户每发一句话,不是直接丢给大模型,而是要闯过下面这 5 关:
1Command 前置拦截
前缀检测 + fast-LLM 解析(约 100 tokens),命中即走控制指令
2快捷路径
时间/日期等纯本地处理,0 Token
3编排器入口
fast 模型评估复杂度;简单任务返回 None,复杂任务进入 DAG 拆解
4三层意图路由
规则 → 缓存 → LLM;命中 Skill 走 DAG,未命中走 Function Calling
5日志审计
Memory.record + execution_log,Token 计量,事件溯源
为什么要设计成这样?因为不是每句话都值得花 Token。「现在几点」这种问题走规则 0 成本搞定;已经回答过的相似问题走缓存;真正复杂的任务才上升到 LLM。这种"确定性优先"的思路,贯穿了整个项目。
04
三层意图路由:能不喊 LLM 就不喊
core/intent_router.py 写得很直白,注释里就一句"确定性优先"。它的层级关系是这样的:
这里有几个细节很值得玩味:
● 规则命中会主动清缓存——避免老缓存把新规则盖住;
● LLM 分类用的是 fast 模型(不是主模型),提示词要求输出严格 JSON,只要 ~50 tokens;
● 缓存只留最近 1000 条(list(keys)[-1000:]),防止无限膨胀;
● 命中 Skill 且置信度超过阈值,走确定性 DAG 执行;没命中才落到 LLM Function Calling 多轮对话。
设计哲学
"规则 → 缓存 → LLM"不是性能优化,而是成本与稳定性的权衡:能确定性回答的就别让模型即兴发挥,模型只在真正开放的问题上出手。
05
五原语能力治理:别再给每种能力写一套注册逻辑
很多 Agent 项目做着做着就长这样:技能一个注册表、工具一个注册表、命令一个注册表、远程 Agent 又一个注册表,API 各写各的,生命周期各管各的。OpenChiip Harness 用一个 CapabilityRegistry 把五样东西拉平:
它们全部实现同一个接口:describe() 给出描述符、invoke() 执行、health_check() 体检。注册表还带 before_register / after_register / before_invoke / after_invoke 四个生命周期钩子——审计、限流、审批全部可以挂在这里。
内置了 7 个元技能:env.check / file.find / file.grep / file.list / file.read / file.write / shell.exec。注意它们都标了 zero_llm=true——纯本地执行,不花一分钱 Token。
06
复杂任务怎么办?拆解 → 执行 → 审计 → 结算 → 检查点
单轮对话能搞定的事,走上面那条路就够了。但用户说"帮我调研三家竞品、对比定价、生成一份报告"这种多步任务怎么办?orchestration/ 目录下就是答案。
1评估复杂度
fast 模型判断是否多步/多工具;IntentRouter 高置信度直接跳过
2任务拆解
LLM 输出子任务清单 + depends_on 依赖图(DAG)
3按依赖调度
get_ready_subtasks():只执行依赖已完成的子任务
4独立审计
每个子任务执行完由 Auditor 验真,不通过重试(最多 2 次)
5检查点
每个子任务结束即把整份计划落 SQLite,崩溃后从最近点继续
6结算汇总
Settlement 汇总各子任务产出,拼装最终回复,清检查点
几个值得抄的工程细节:
● 先花小钱评估复杂度——fast 模型判断要不要拆,简单任务直接返回 None 走普通流程,不为"写个 hello world"付出拆解成本;
● 子任务要求"新鲜上下文"——拆解提示词里明确写了"每个子任务必须可以在新鲜上下文中独立执行",避免长上下文污染;
● 依赖图调度——get_ready_subtasks() 每次只返回依赖已完成的节点,天然支持并行;
● 执行和审计分开——执行器干完活,审计员再验一遍,不过就重试,最多 2 次;
● 每个子任务落一次检查点——整份计划序列化进 SQLite,进程崩了重启能从最近一个完成点继续,不用重头再来。
07
可靠性三件套:事件溯源、守卫管道、Token 熔断
SessionLog:append-only 的事件日志
传统做法把对话存成消息列表,想做"回放""分叉""崩溃恢复"就抓瞎。OpenChiip 选择事件溯源:每个 Turn/Step/工具调用都作为一条事件追加进 SQLite,LLM 的对话历史是从事件派生出来的。这意味着:同一份日志既能回放全过程,又能在任意节点 fork 出一条新会话。代码里把这条写成了 ADR-001(架构决策记录)。
ToolPipeline:工具调用不是直接 dispatch
工具执行被包成一条管道:pre-hook(可拒绝)→ 执行 → post-hook(处理结果)。自带默认 30 秒超时、最多 5 个并行的信号量、输出裁到 4000 字符、调用日志。审批流、沙箱检查、凭据清洗都通过挂 pre-hook 实现——单个钩子崩了也不会炸掉主流程(异常被隔离)。
TokenMeter:月度预算一到就熔断
TokenMeter 记录每次调用消耗,配置 monthly_cap 和 warning_threshold,超了直接抛 BudgetExceededError,对话入口会接住并提示"本月 Token 预算已用尽"。对一个要长期跑在服务器上的数字员工来说,这是保命设计。
此外还有 CompactionProvider:历史超过 75% 阈值就自动压缩,把长对话压成摘要再喂给模型,不然上下文窗口迟早爆。
08
不止自己干:多 Agent 与外部 CLI
SubagentManager 注册了四种子 Agent Provider:
也就是说,主 Agent 自己不会写代码时,可以把活派给本机装着的 Codex / Claude Code,收结果回来。服务重启后还会从 tools.db 的安装记录里自动把这些外部 CLI Provider 恢复注册。
跨主机的协作走 A2A:每个 Agent 有一张 AgentCard(名片),通过 RegistryClient 发现对端,A2ACaller 发起调用。平台模式下,这些节点之间还能互相指派任务。
09
双模式运行:一条命令切换"独立"和"打工"
README 里强调了三种工作模式,本质上是同一个进程的不同开关:
● 本地模式:只起 FastAPI + Web UI,不连平台;
● 平台协同模式:本地服务照跑,同时主动出站连平台,双向同步;
● 接单模式:run_mode=order,拒绝新对话请求,只接平台派下来的项目任务——相当于这个数字员工"上班了,别闲聊"。
NAT 穿透的巧思
大多数 Agent 平台要节点暴露公网 IP 或配端口映射,OpenChiip 让节点主动向外建 WebSocket,平台只需要有一个固定域名。家里的 NAS、公司内网的工位机、云上的小主机,都能零配置接进来。
10
工程细节里的诚意
翻代码时几个让我停下来多看两眼的地方:
● MCP 工具探测是真跑命令的——装个工具不是看 PATH 里有没有就完事,而是真执行 --version,还识别 Windows Store 那种假 exe;
● 提示词是组装出来的——PromptAssembler 用"0/10/20/25"的优先级注册段落,身份、工具描述、技能描述、元技能描述各自独立,插件可以再塞段落;
● 系统提示词本地缓存优先——后端挂了也能离线跑,缓存文件读不到才用兜底提示词;
● API 设计得很整齐——12 个路由模块、35 个端点,/api/v1/... 前缀统一,FastAPI 自动生成 Swagger;
● License 有点特别——AIGCGPL-1.0(人工智能生成代码通用公共许可证),因为这个仓库的代码本身就是 AI 生成的,作者在许可证里把这件事写明白了。
11
收尾:这套设计适合谁
如果你只是想周末跑个聊天 Demo,LangChain + Gradio 够了。但如果你想要一个能长期跑在自己工位上、能接平台派活、崩了能恢复、花超了能熔断、还能把 Codex/Claude Code 当下属使唤的数字员工底座,OpenChiip Harness 这套"单进程 + 确定性优先 + 事件溯源"的设计,是值得认真读一遍源码的。
它的核心主张其实就一句话:把不确定性留给 LLM,把确定性全部工程化。规则、缓存、DAG、检查点、钩子、预算——这些都是确定性的部分;只在真正开放的对话和拆解上,才让模型出手。













