

在刚刚落幕的华为2026全联接大会上,昇腾960芯片、超节点集群、AI记忆存储OceanStorM900接连亮相,一套面向智能体时代的算力硬件矩阵完整浮出水面。但整场发布会最核心的关键词,并不是某一颗芯片,而是“灵衢”。
很多人会习惯性把AI算力比拼等同于芯片性能赛跑,比拼单颗芯片算力高低。可现实产业场景里,就算堆出上万张算力卡,大量芯片却要不停等待数据传输,真正干活的算力占比并不高。AIAgent智能体爆发之后,大模型参数冲向十万亿级别、上下文越来越长、交互频次成倍上涨,“通信拖后腿”的矛盾被彻底放大。灵衢,就是华为瞄准通信瓶颈拿出来的一套底层架构方案。
一、Agent时代,算力的短板不在计算而在通信
过去搭建AI集群,行业大多沿用PCIe加RoCE这套成熟体系,不断在现有框架上做修补优化。放到传统大模型训练尚能应付,但面对AIAgent就处处碰壁。
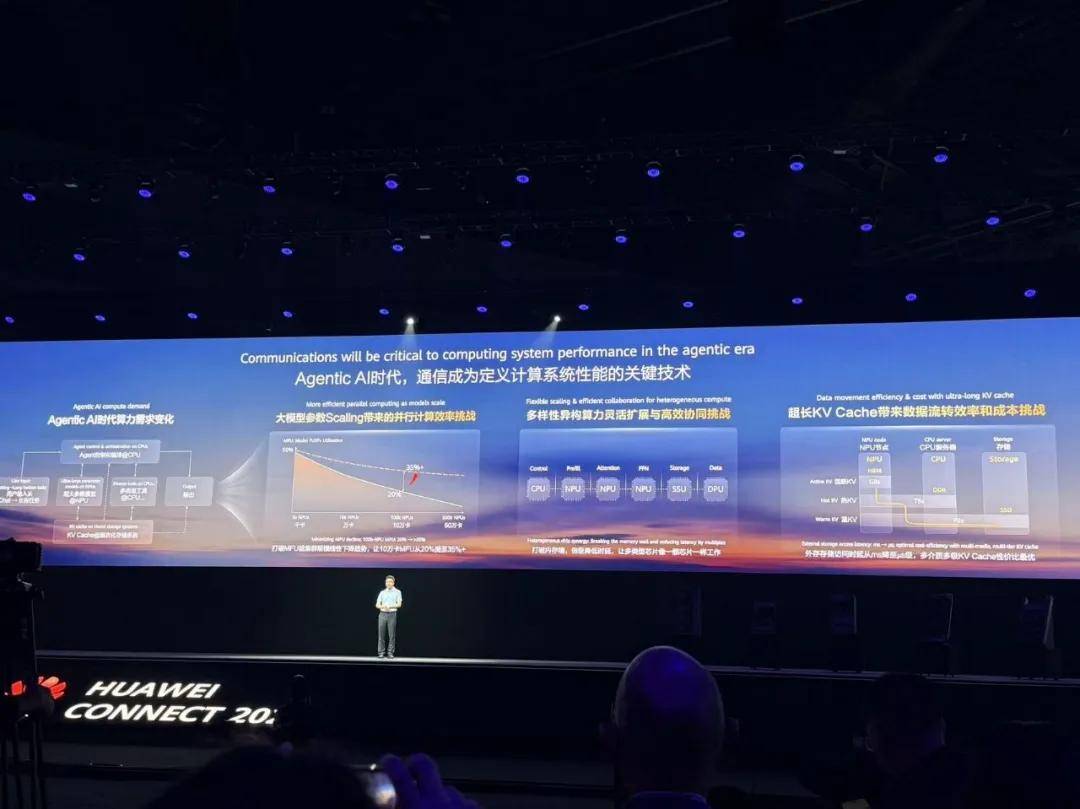
第一个现实难题,通信量爆炸,算力白白闲置。随着模型规模膨胀,集群内部的数据交换量近乎平方级增长。十万卡规模的集群里,模型实际浮点算力利用率仅仅20%,大半算力卡在等待数据收发,机器忙闲不均。模型越大、卡数越多,效率下滑越明显。
第二重压力来自业务负载的五花八门。现在AI任务不再是单一训练任务,预填充、解码两种推理任务特性完全不一样。Agent还要频繁调用工具,CPU、NPU配比随时变化,需要不同类型算力灵活配合。老架构硬件绑定死板,很难做到资源灵活调配。
第三个痛点来自存储缓存。长上下文推理会产生海量KV缓存,需要HBM、DDR、SSD分层缓存。旧互联架构带宽、时延跟不上,PB级缓存调度会变成整个系统的堵点。
产业链人士提到一个很现实的判断:继续在旧协议上面叠加补丁,收益会越来越有限。当通信成为天花板,单纯堆更强的芯片,也很难释放全部实力。算力竞争,已经悄悄转到互联架构的赛道上。
二、灵衢一套协议,打通芯片到百万卡集群
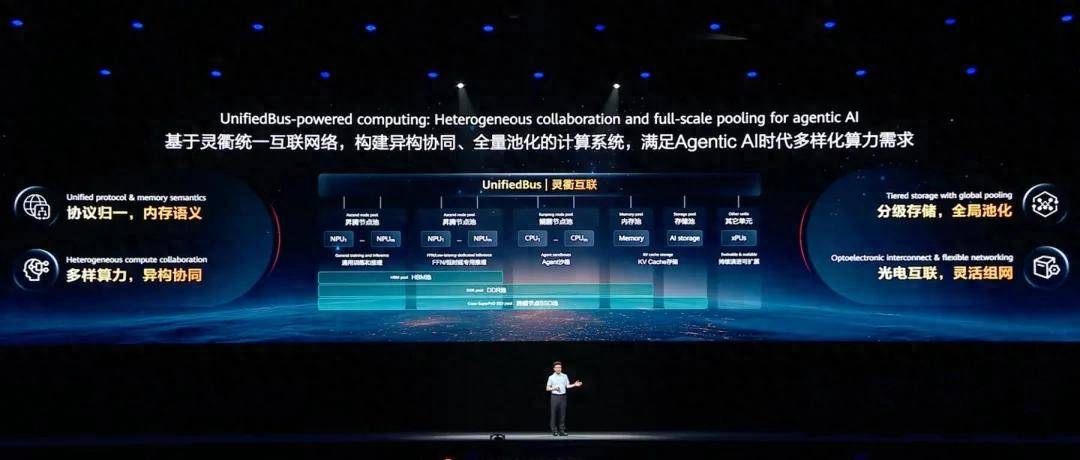
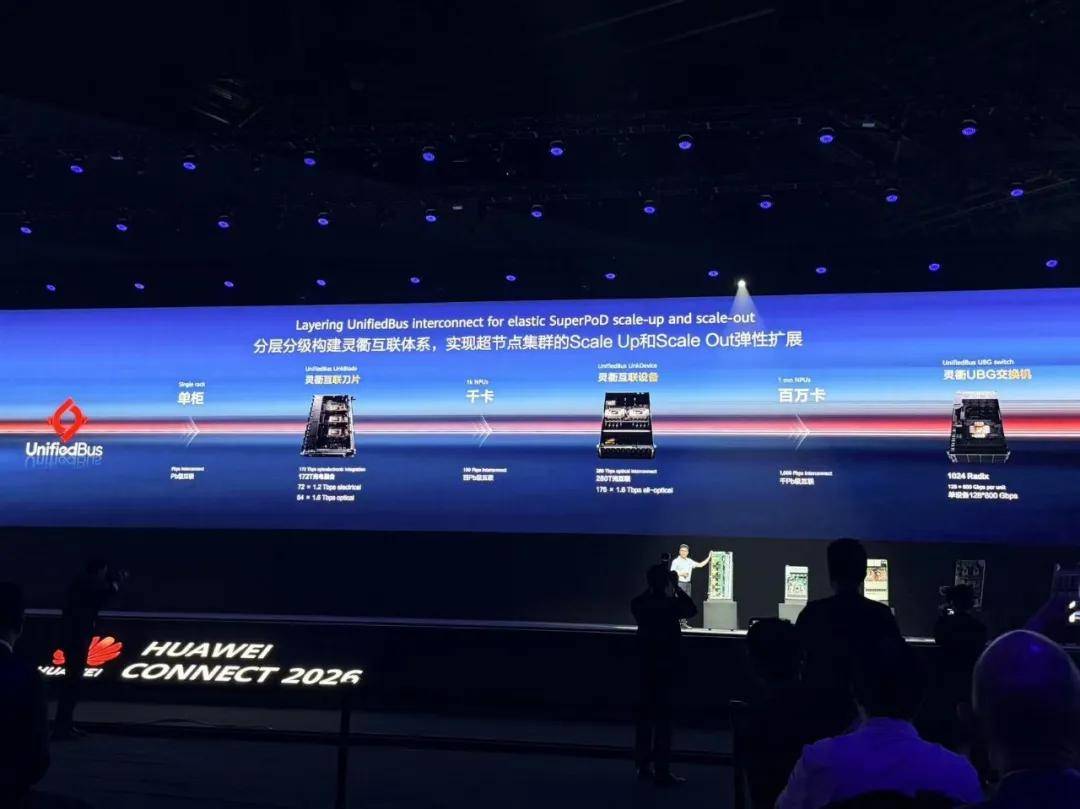
灵衢UnifiedBus,本质是一套统一的算力底座互联总线协议。简单理解,它把CPU、NPU、DPU、内存、SSD这些各式各样的硬件,用同一套语言对话,不再层层翻译转换,覆盖单颗芯片、单机服务器、超节点,一直延伸到百万卡大集群。它的核心优势可以拆解为四点。
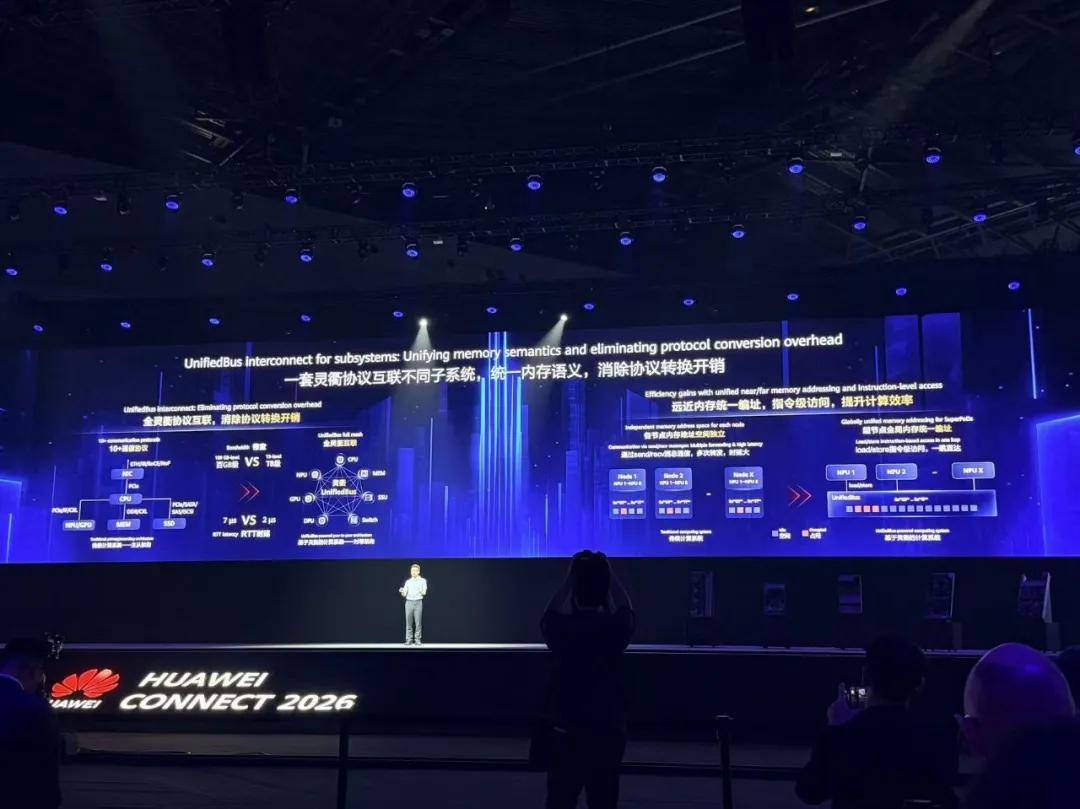
首先是协议归一,实现全局内存统一编址。传统架构跨节点传输数据,要反复打包拆包、完成协议转换,额外消耗大量时间。灵衢把十几种不同互联协议收拢归一,超节点内部硬件可以直接访问彼此内存。通信时延从7微秒压缩到2微秒,带宽也从百GB级别跃升到TB级别,大幅砍掉协议转换带来的开销。
其次实现异构算力平等协同。所有计算、存储硬件对等互联,不再是传统主从模式。企业可以根据业务场景自由调配CPU与NPU的配比,做推理就偏向解码算力,做训练就拉高NPU占比,硬件组合不再被固定服务器规格锁死。
第三是分级存储全局池化。现在单颗芯片的内存已经扛不住十万亿参数模型的需求。灵衢把HBM、DDR、SSD多种存储介质整合为统一资源池。内存不再局限于单张算力卡,整个集群内存资源可以全局调度,内存利用率得到明显提升,解决长序列推理的缓存压力。
第四是光电混合组网,解决大规模扩展的物理限制。当集群扩展到万卡规模,单纯铜线电互联会遇到距离、功耗、布线的天花板。华为搭配NPO近封装光学Hi‑ONE光引擎,用电光结合的方式建设数据高速通道。
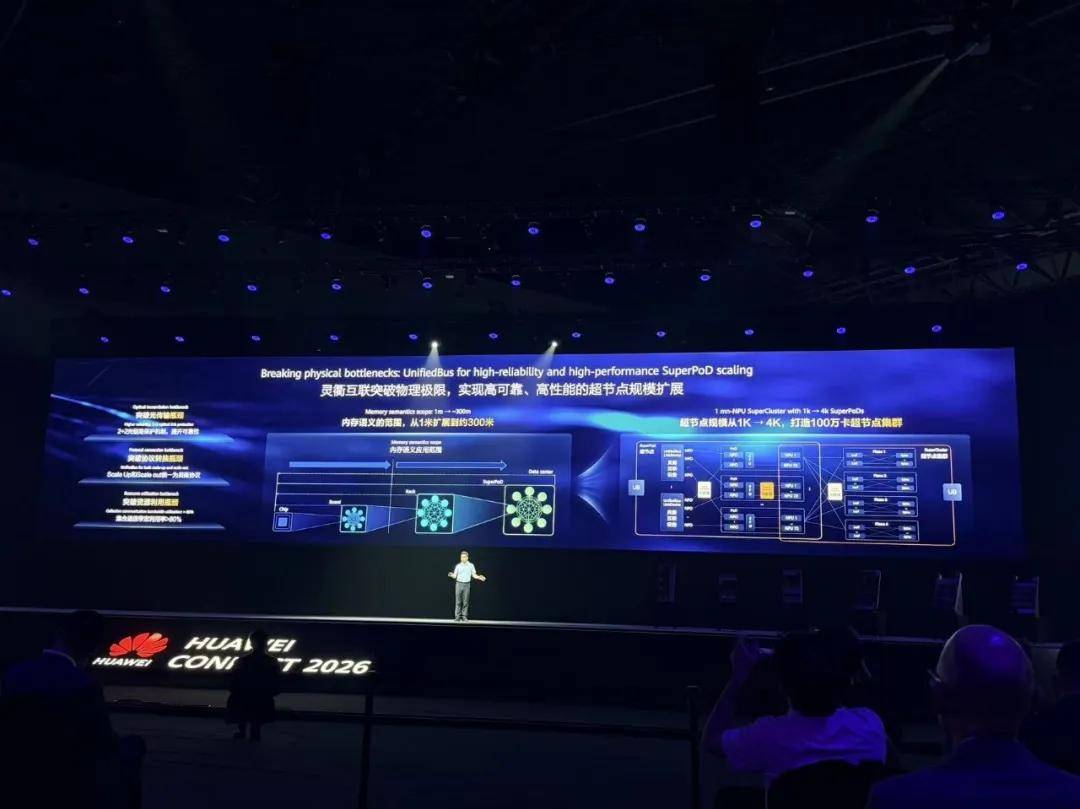
4096卡的昇腾960超节点内部,单单节省下来的铜缆就达到196公里,相当于上海到杭州的距离。依靠灵衢交换设备与两层CLOS多轨道拓扑,单个集群上限直接拉到100万颗AI处理器,十万卡集群算力利用率从20%提升到35%。
三、软硬成套:从百万卡大集群到中小企业一体机
灵衢不是一个悬浮的技术概念,整套硬件产品已经落地,兼顾超大规模算力中心,也照顾中小企业轻量化部署。
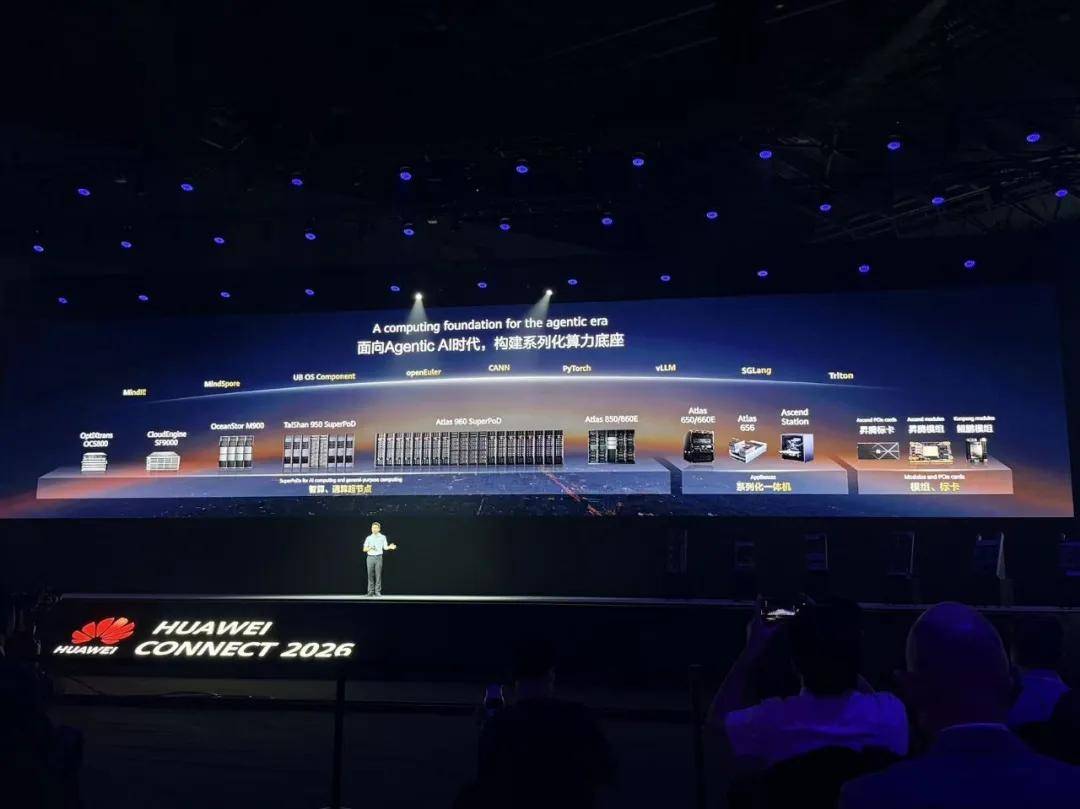
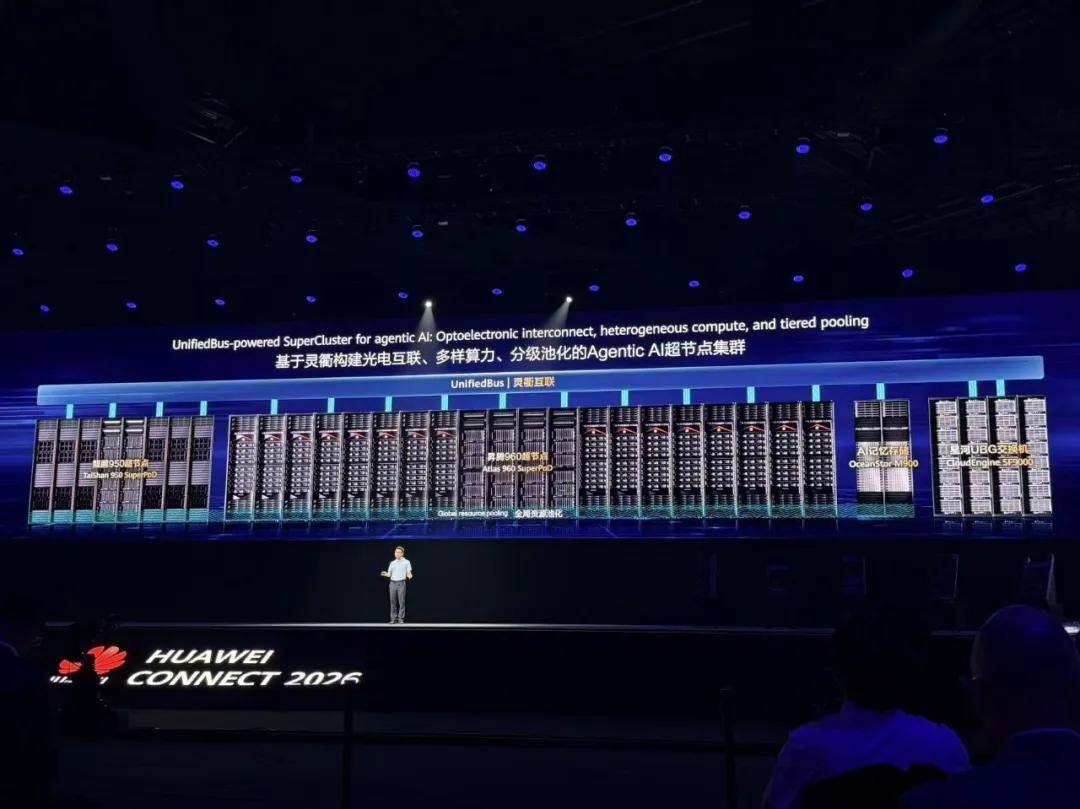
大会发布的AgenticAI超节点集群,集合昇腾960超节点、鲲鹏950超节点、OceanStorM900记忆存储、星河UBG交换机。昇腾960超节点依靠灵衢与NPO光引擎,做到单超节点4096卡,提供8EFLOPSFP8算力,拥有1PBHBM容量,系统可用度达到99.8%,风冷、液冷版本分别定档2027年Q2、Q3上市。
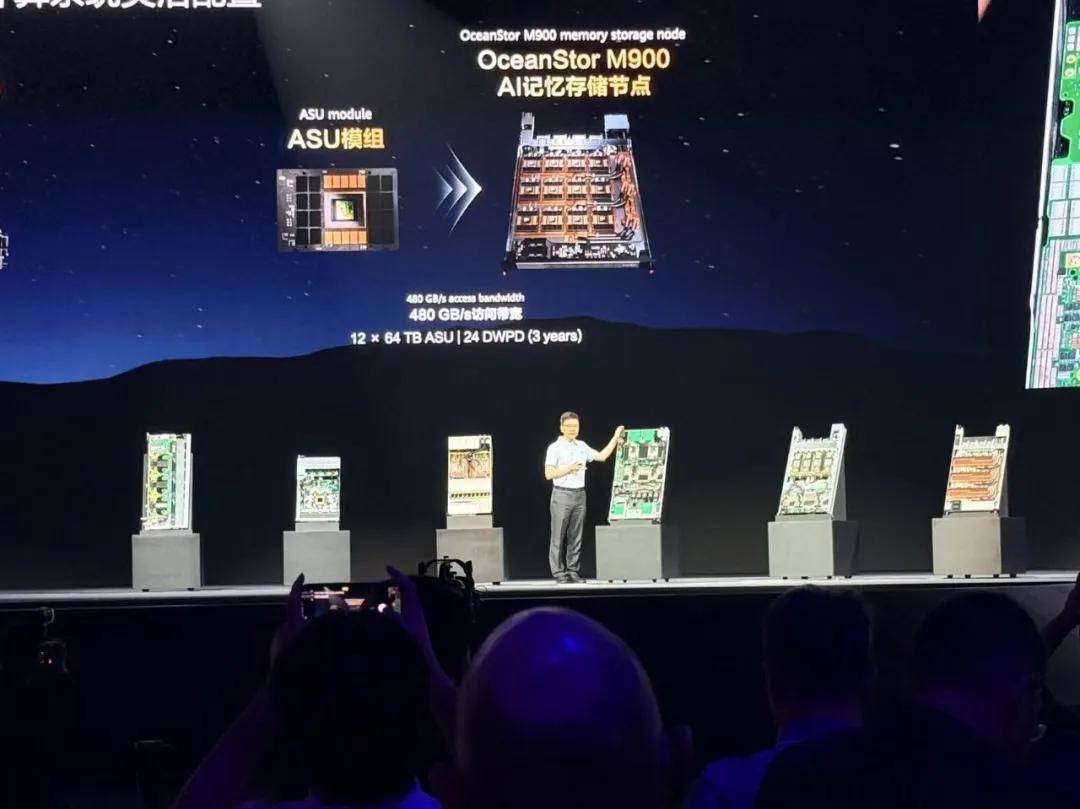
OceanStorM900记忆存储专门面向Agent的海量KV缓存设计,做到网络、CPU、盘控芯片三芯合一,单节点访问带宽480GB/s,承担起AI系统的记忆底座角色。
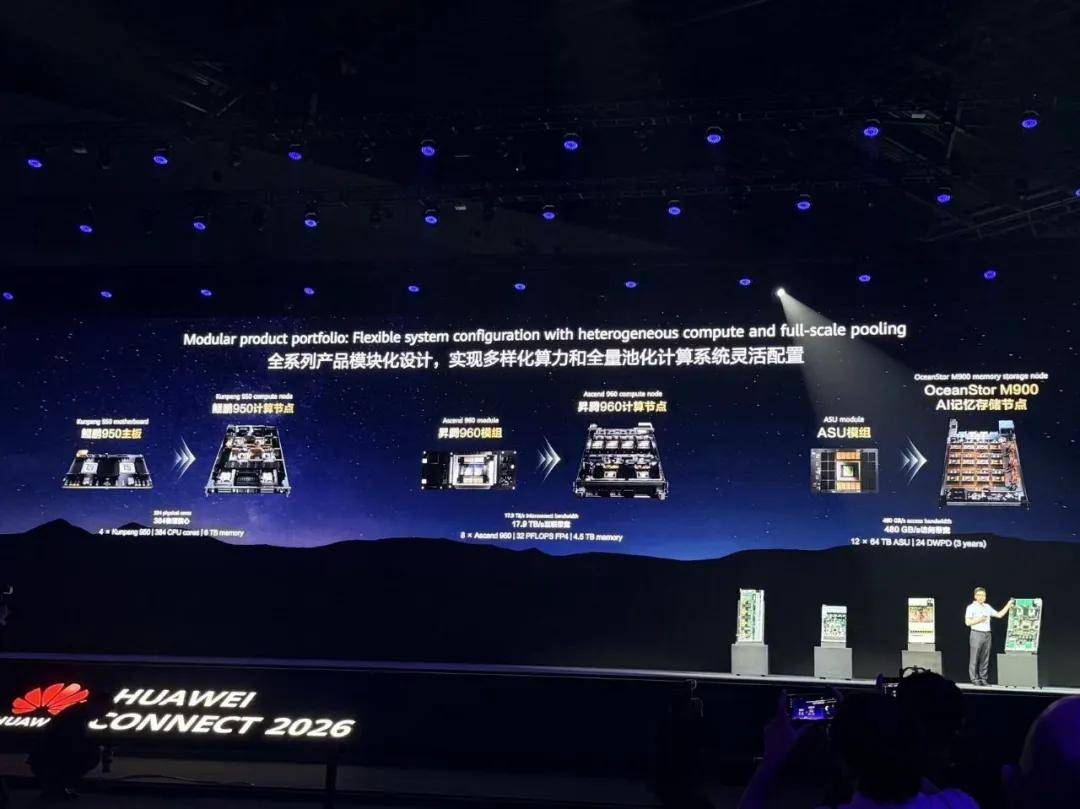
鲲鹏负责海量CPU算力与大内存池,昇腾负责AI计算,存储承接缓存,三者通过灵衢联动,实现1+1+1>3的协同效果。
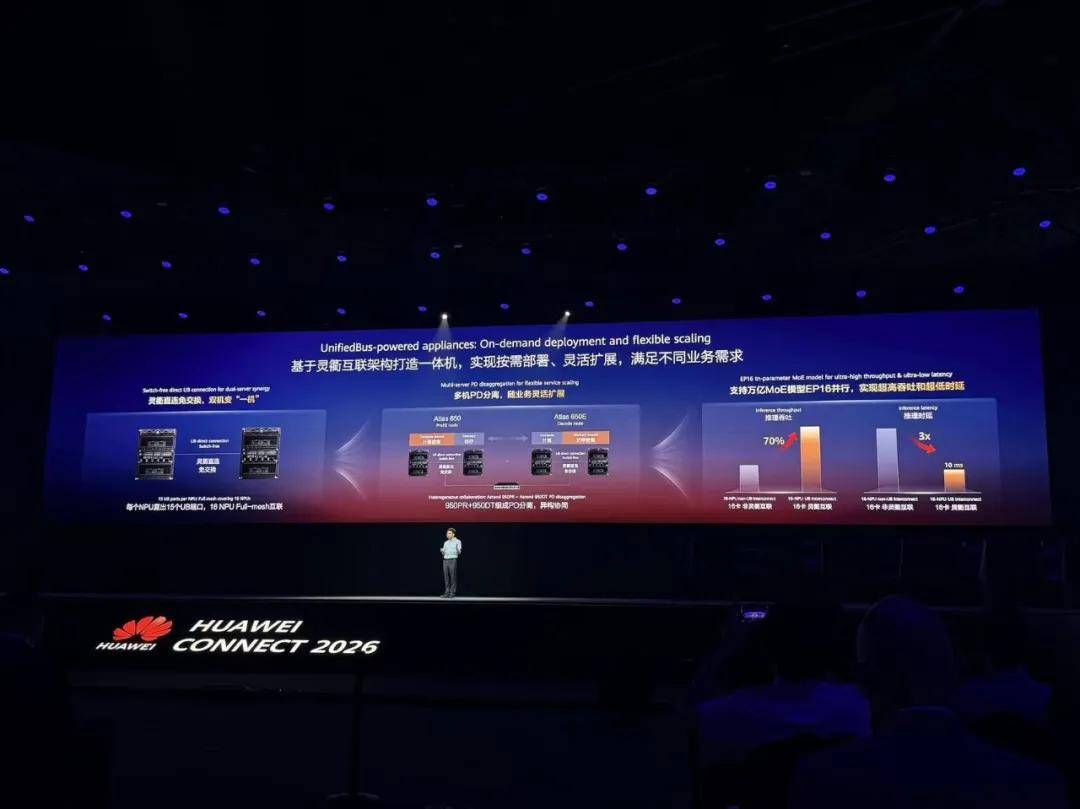
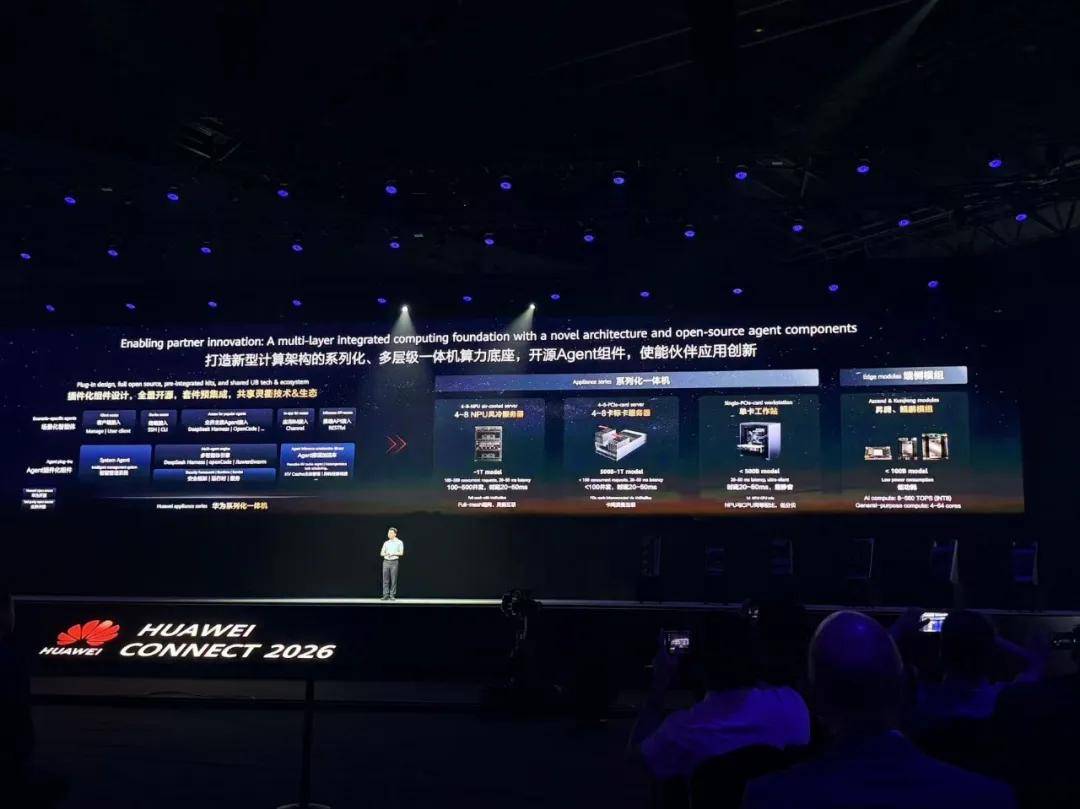
不止面向超大型算力中心,灵衢技术也向下下沉到一体机产品。Atlas650E依靠灵衢双机直连,不用额外交换机,两台机器就能完成16颗NPU全互联,本地就可以跑万亿参数大模型,推理时延压到10毫秒以内,推理吞吐提升四成以上。对于看重数据安全、不想上公有云的中小企业,不用建设庞大机房,也能拥有大模型本地运行能力。后期业务扩张,还可以平滑扩容组成小型超节点集群。
四、开源生态,让灵衢底座真正“开箱即用”
再好的硬件架构,离开开发者生态就很难普及。华为没有只把灵衢封闭在硬件内部,而是继续加码开源体系,目标打造AI的“硅基黑土地”。
CANN开源社区现在月活开发者突破5200人,积累26个行业算子库,电力、金融、教育多个行业已经落地实践。像电力行业,开发者基于开源算子库完成电网负荷预测、输电线路巡检;科大讯飞基于昇腾底座打造通用大模型与行业解决方案,覆盖办公、金融、医疗等场景。
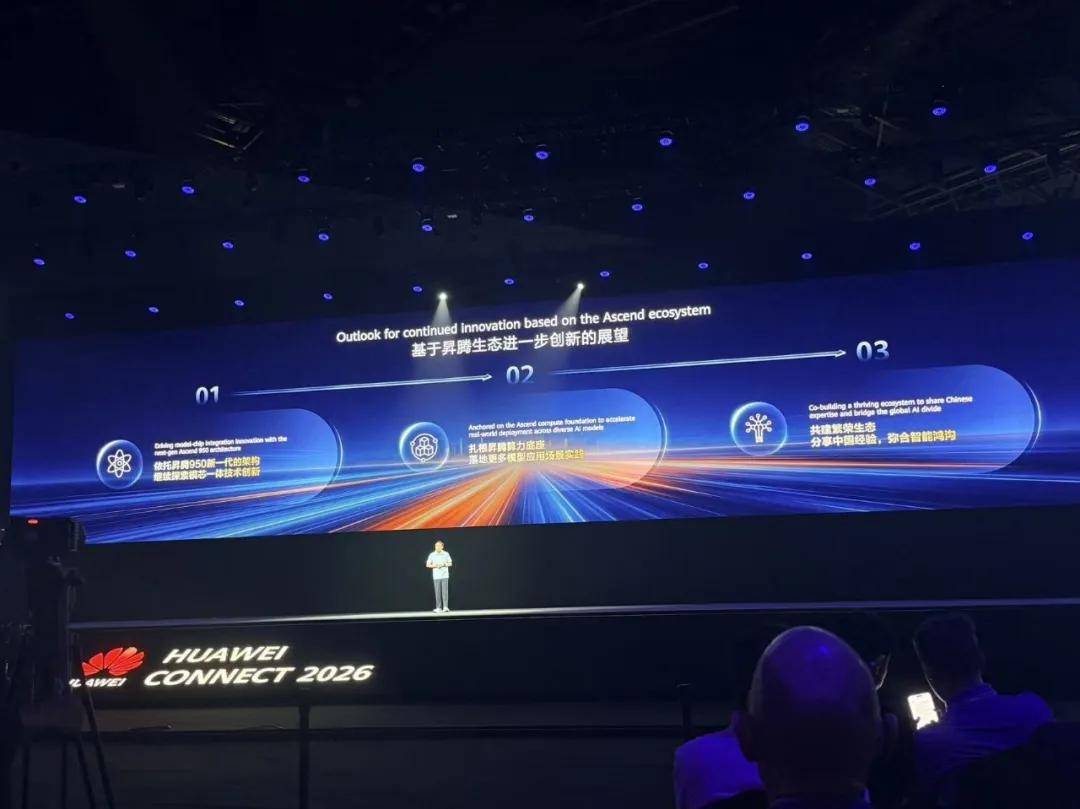
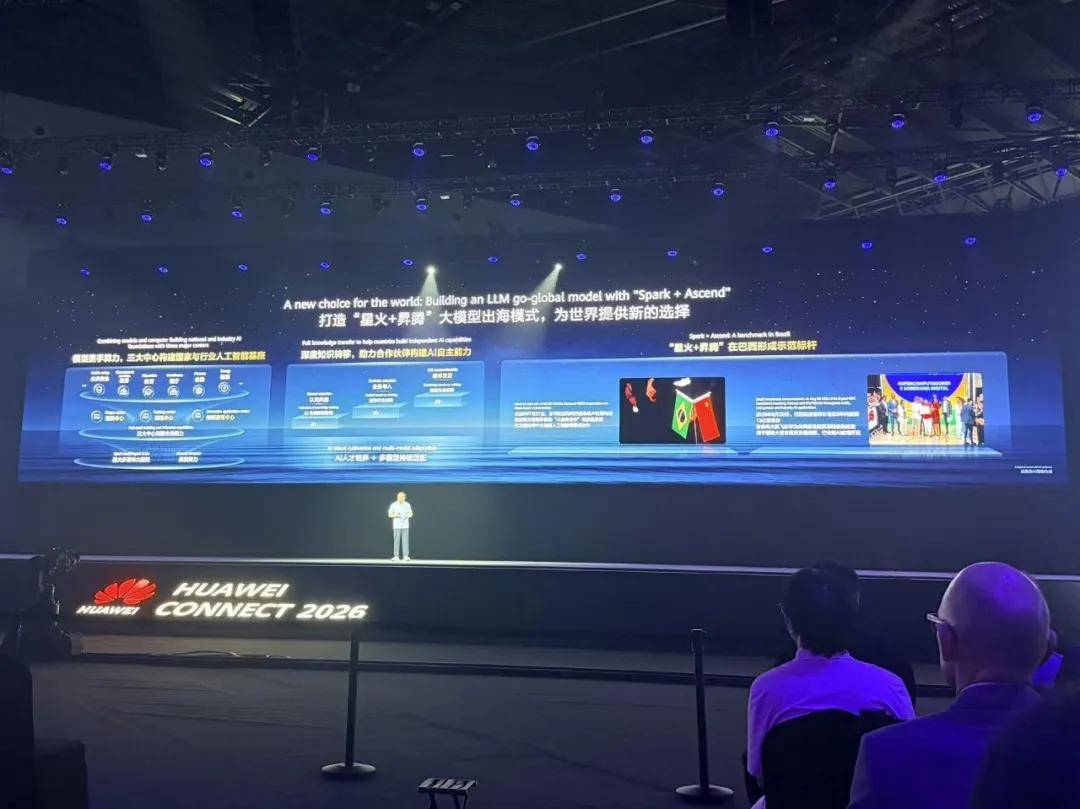
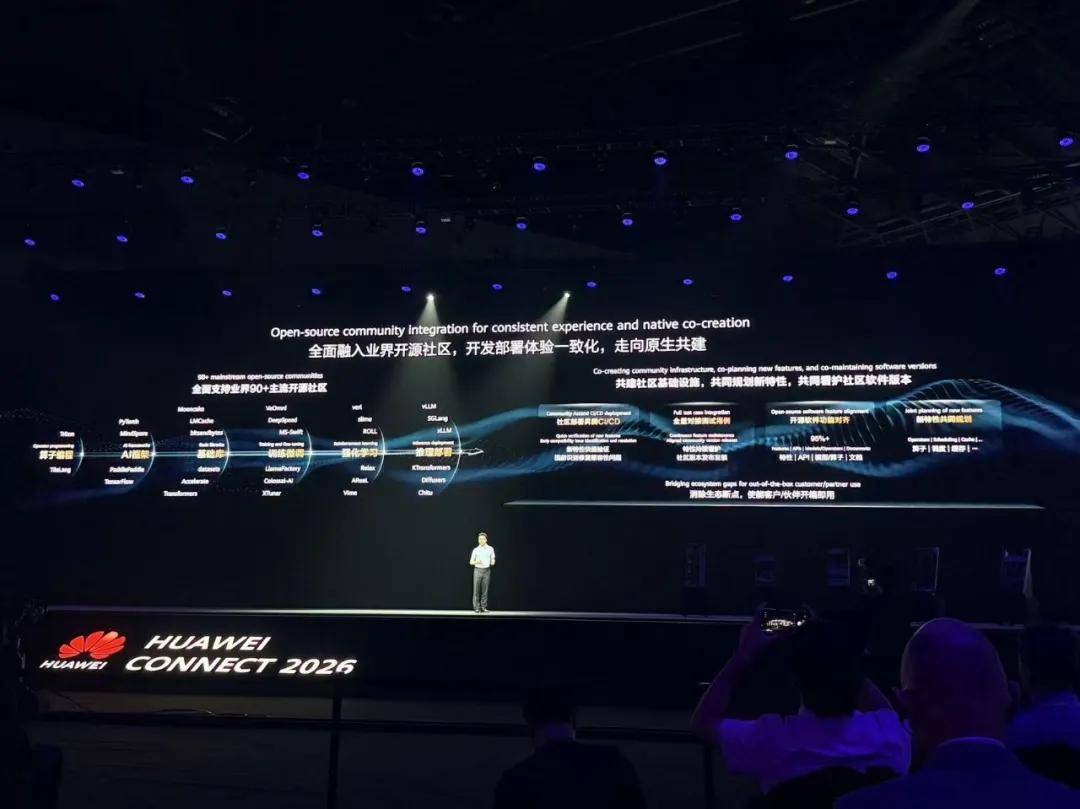
面向火热的Agent开发,华为还和DeepSeekHarness、openJiuwen等开源框架合作,把智能管理、推理加速、安全防护等Agent组件全部开源,同时对接90多家主流开源社区,覆盖模型训练、微调、推理部署全流程,降低开发者使用灵衢架构的门槛。企业拿来不需要从零改造底层,就可以搭建属于自己的Agent应用。
五、算力竞争走向系统级较量
AI行业的早期阶段,单芯片性能几乎决定一切。但走到AgenticAI时代,考验的已经不再是单卡跑分,而是整套系统从芯片、互联、存储再到软件生态的综合实力。
灵衢的出现,代表华为给出了一条不同思路:不只是提供一颗颗高性能算力芯片,而是用统一互联打通整个算力系统,解决大规模集群通信损耗的痛点。大场景有百万卡集群支撑十万亿参数模型,中小企业有一体机实现本地部署,再叠加开源生态降低落地门槛。
未来AI算力的比拼,硬件只是基础,架构创新、软硬件协同、伙伴生态,会成为决定产业格局的关键力量。














