

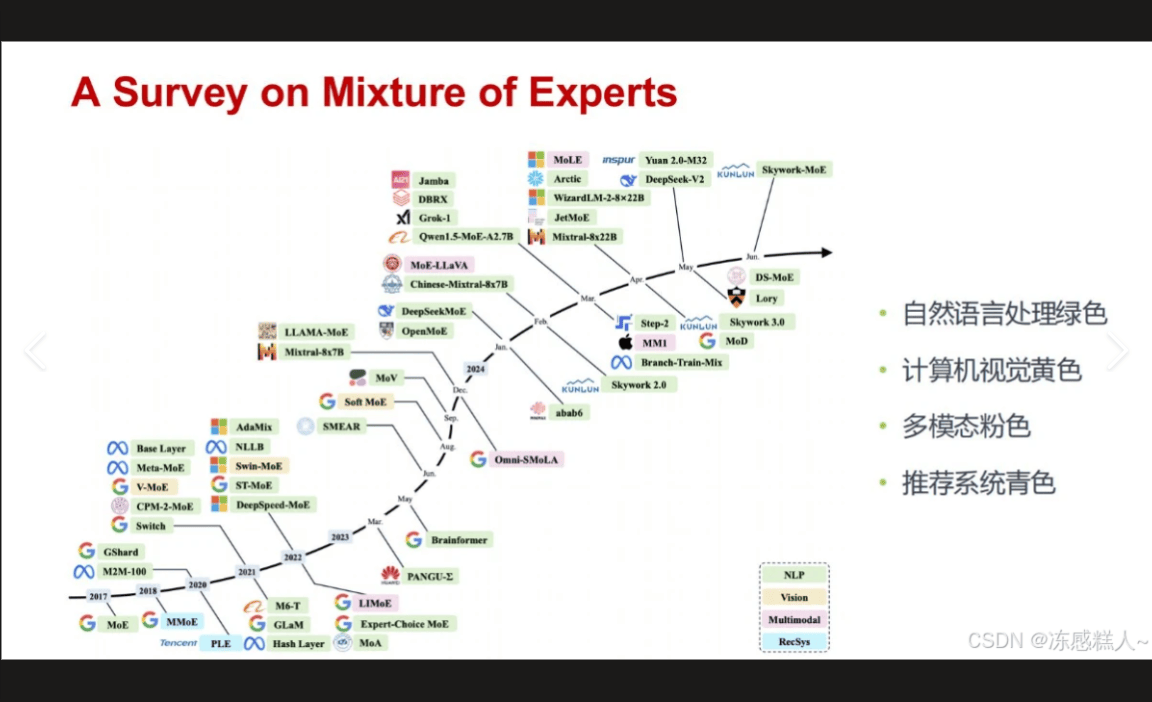
摘要:随着大语言模型参数规模持续扩容,传统稠密模型面临算力成本指数级增长、硬件资源利用率偏低、模型扩展性受限的工程化瓶颈,制约超大规模模型的训练与落地部署。混合专家模型(Mixture of Experts, MoE)以稀疏激活为核心架构革新,打破稠密模型“全参数参与计算”的固有范式,通过门控路由机制动态激活少量专家子网络,实现模型参数规模无限扩容与计算成本可控增长的双向平衡,成为下一代超大尺度大模型的主流架构。MoE稀疏特性在显著降低训练、推理边际成本、提升模型容量与泛化能力的同时,也衍生出负载不均衡、专家路由冲突、跨设备调度复杂、访存开销激增、稀疏退化等全新工程化难题,颠覆了传统稠密模型的调度优化体系。本文系统阐释MoE稀疏激活的核心原理与成本优化机制,深度拆解大规模部署中的资源调度、负载均衡、存储IO、路由稳定性等核心工程瓶颈,梳理适配稀疏架构的调度优化方案与工程实践路径,并展望MoE模型工程化迭代趋势,为超大模型高效落地、算力资源精细化调度提供理论支撑与工程参考。
关键词:MoE大模型;稀疏激活;工程化部署;成本优化;负载调度;专家路由
一、引言
大模型技术迭代进入超大规模参数时代,稠密Transformer模型的工程化短板持续凸显。稠密模型每一轮训练与推理均需调用全部网络参数,模型能力提升高度依赖参数堆叠与算力倍增,导致训练功耗、硬件成本、推理时延呈指数级攀升,算力资源冗余浪费问题突出,模型扩容的边际收益持续递减。在此背景下,MoE混合专家架构凭借稀疏激活的颠覆性设计,成为破解稠密模型算力桎梏、实现模型高效扩容的核心技术路径,已广泛应用于GPT-4、Gemini、LLaMA-MoE等主流超大模型。
MoE架构将完整模型网络拆解为大量独立专家子网络,依托门控路由网络根据输入语义动态筛选少量专家参与计算,仅激活极少比例参数完成前向传播,在大幅提升模型容量与表达能力的同时,将计算与显存开销控制在较低水平,实现“大参数、小算力、高能力”的差异化优势。但从工程落地视角来看,稀疏激活并非单纯的技术增益,其动态、非均匀、自适应的计算特征,与GPU稠密计算、固定调度的硬件架构天然冲突,引发一系列传统稠密模型未曾面临的调度难题,包括专家负载倾斜、跨设备通信拥堵、访存IO瓶颈、路由噪声干扰、专家坍缩等问题,成为制约MoE模型规模化、低成本落地的核心工程壁垒。基于此,本文从工程化视角剖析MoE稀疏激活的成本优化逻辑与核心调度挑战,探索适配稀疏架构的高效部署与调度体系。
二、MoE稀疏激活的核心原理与成本优化机制
2.1 稀疏激活核心架构逻辑
MoE混合专家模型摒弃传统稠密网络固定全量计算模式,核心由门控路由网络、多层专家子网络、稀疏聚合模块三部分构成。模型将原始Transformer前馈网络拆解为数十至数千个结构同质、参数独立的专家模块,每层网络仅根据输入token的语义特征,通过门控算法筛选Top-K个最优专家参与计算,其余专家参数处于休眠状态,不参与本轮前向与反向传播。这种动态择优的稀疏激活机制,使得不同语义样本可自适应匹配专属专家子网络,大幅提升模型特征提取精度与任务适配能力,同时从架构层面规避全参数计算的资源冗余。相较于稠密模型,MoE可在不显著增加计算量的前提下,通过扩充专家数量持续提升模型总参数规模,突破稠密模型的容量上限。
2.2 稀疏激活的全链路成本优化逻辑
MoE架构的核心工程价值在于重构大模型算力成本曲线,实现模型能力与落地成本的解耦优化。在训练阶段,稠密模型算力开销与参数规模呈严格正相关,千亿、万亿参数模型训练需要超大规模算力集群支撑,成本极高;而MoE模型仅激活5%~10%的参数参与计算,训练浮点运算量大幅降低,同等算力条件下可支撑更大参数规模、更高精度的模型训练,训练迭代效率显著提升。在推理阶段,稀疏激活的成本优势更加突出,单token推理仅需调用少量专家参数,显存占用、计算时延、推理功耗均远低于同规模稠密模型,彻底解决超大模型推理成本过高、无法民用部署的难题。
同时,稀疏架构具备极强的资源适配性,可根据任务复杂度动态调整激活专家数量,简单任务调用少量轻量专家,复杂任务调度多专家协同计算,实现算力资源<div id="m.lmsvs.com4951">的精细化按需分配,相较于稠密模型固定算力消耗模式,硬件资源利用率提升30%以上,有效破解大模型落地的算力成本桎梏。
三、MoE稀疏激活带来的核心工程调度挑战
3.1 专家负载不均衡与专家坍缩问题
负载失衡是MoE稀疏架构最核心、最普遍的工程难题。门控路由网络的语义倾向性会导致输入样本过度集中于部分热门专家,大量冷门专家长期处于休眠或低激活状态,出现严重的负载极化现象。热门专家算力负载饱和、梯度更新频繁,易出现过拟合与计算拥堵;冷门专家参数更新停滞、能力退化,无法发挥模型扩容价值,最终引发专家坍缩问题,大幅降低模型整体容量与泛化能力。不同于稠密模型均匀负载特征,MoE负载分布具备动态性、随机性、任务差异性,传统固定均衡调度策略无法适配稀疏计算特征,极易出现资源闲置与过载并存的矛盾格局,严重影响集群算力利用率。
3.2 动态稀疏引发的访存与IO调度瓶颈
MoE稀疏激活的动态性彻底改变模型访存规律,催生严重的存储IO调度难题。稠密模型参数固定驻留显存,访存路径稳定可预测;而MoE模型专家数量庞大,单设备无法容纳全部专家参数,需频繁进行CPU-GPU参数置换、跨设备专家调度。由于不同批次、不同token激活的专家完全随机,调度系统无法精准预判访问热点,导致频繁的随机访存、参数加载与显存切换,访存延迟大幅攀升。同时,稀疏计算带来的大量无效填充与零值计算,会浪费GPU稠密计算核心的算力资源,出现“算力空闲、IO拥堵”的硬件效率退化问题,成为推理阶段的主要时延瓶颈。
3.3 跨设备通信冲突与并行调度复杂度激增
大规模MoE部署依赖专家并行、数据并行、流水线并行的多维协同架构,稀疏激活特性大幅提升跨设备调度复杂度。在分布式集群部署场景中,不同设备存储不同专家模块,单批次样本会随机触发跨多设备的专家调用请求,大量零散、无序的跨卡通信请<div id="www.lmsvs.com4196">求会引发网络拥堵、通信超时与数据阻塞问题。相较于稠密模型规整的通信调度逻辑,MoE稀疏通信具备碎片化、突发性、无规律特征,通信开销占比大幅提升,极端场景下通信时延甚至超过计算时延,彻底抵消稀疏计算的成本优势。此外,批次内token路由分散、激活无序,导致GroupGEMM计算出现严重的算力浪费,硬件计算效率显著下降。
3.4 路由噪声与稀疏稳定性工程难题
门控路由的精度与稳定性直接决定MoE模型性能与调度效率,实际工程场景中,路由噪声、语义误判、批次波动问题突出。训练初期门控网络参数未收敛,易出现路由分配错乱,导致专家激活混乱、梯度震荡;推理阶段输入样本分布偏移,会引发激<div id="lmsvs.com6874">活比例突变、热门专家切换等问题,造成调度系统适配失效。同时,不同任务、不同输入长度的稀疏度差异极大,固定调度策略无法适配动态稀疏变化,易出现批次负载剧烈波动、推理时延抖动等问题,严重影响服务稳定性与吞吐量上限。
四、MoE模型工程化调度优化与落地方案
4.1 动态负载均衡与防专家坍缩优化
针对负载失衡与专家坍缩问题,工程落地中普遍采用负载感知的动态路由优化方案。通过引入均衡损失函数,量化约束各专家的激活频次与负载分布,惩罚极端路由倾向,引导门控网络均匀分配样本;同时设计动态Top-K激活机制,根据专家实时负载自适应调整激活数量,对过载专家进行流量限流,对闲置专家进行流量补全,实现全局负载均衡。此外,通过专家预热、参数正则化、路由噪声扰动等策略,避免冷门专家长期休眠,保障所有专家的参数持续迭代与能力均衡,有效缓解专家坍缩问题,充分释放模型扩容价值。
4.2 预取调度与分层存储IO优化
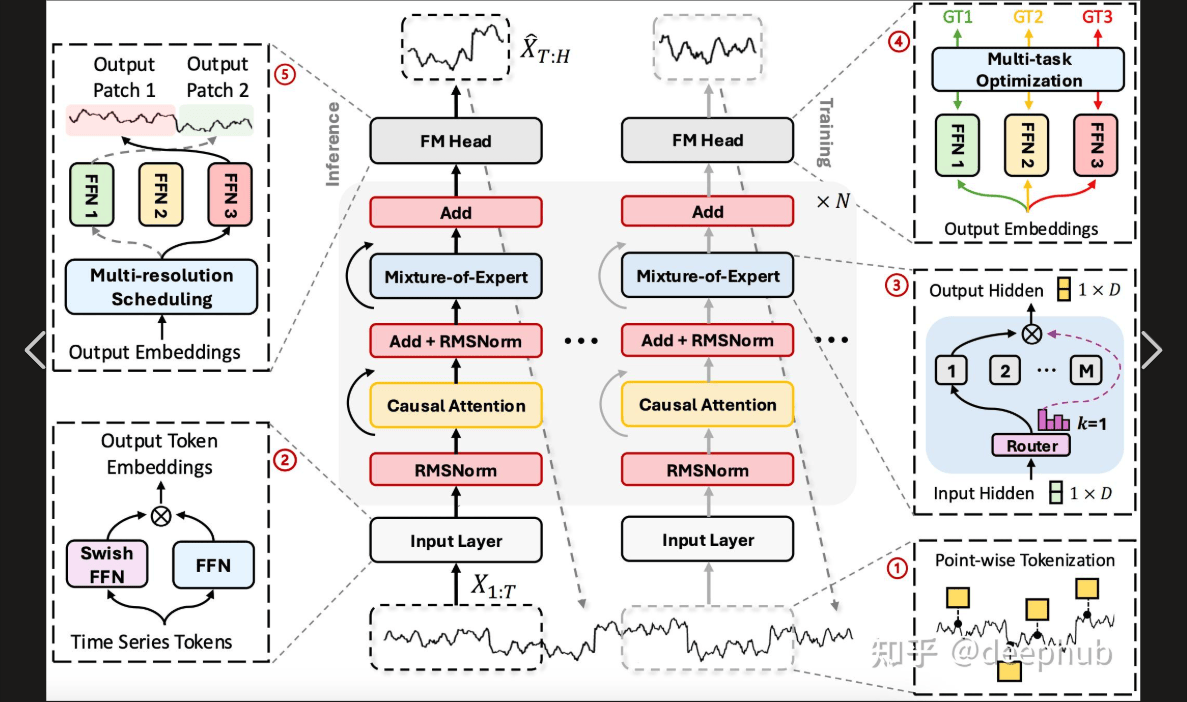
为破解稀疏访存与IO瓶颈,行业普遍采用分层存储架构与双阶段预取调度策略,构建显存、内存、磁盘三级存储体系,高频热门专家常驻显存、中频专家留存内存、低频专家归档磁盘,实现资源分层适配。同时基于token语义特征与历史激活规律,构建专家热点预测模型,在Prefill与Decode阶段提前预加载所需专家参数,掩盖参数置换时延。通过IO感知的分块调度、稀疏计算去填充优化,消除无效零值计算与冗余访存,大幅提升GPU稠密计算核心的利用率,有效降低动态稀疏带来的IO损耗与时延抖动。
4.3 稀疏感知分布式并行调度优化
针对跨设备通信拥堵问题,构建稀疏感知的自适应分布式调度体系。优化专家并行与数据并行融合策略,根据批次稀疏特征动态调整并行粒度,整合零散通信请求,减少跨卡通信频次;采用通信与计算重叠机制,在专家计算的同时完成下一批次参数预加载与数据同步,掩盖通信时延。同时通过批次token重排、同热点专家聚合调度等策略,集中同类激活请求,降低调度碎片化,大幅提升集群通信效率与整体吞吐量,解决稀疏并行的效率损耗问题。
4.4 路由稳定化与自适应调度机制
为提升稀疏激活稳定性,通过门控网络正则化、路由平滑约束、批次归一化等手段,抑制路由噪声与激活波动,保障训练与推理阶段专家分配的稳定性。同时设计任务自适应调度策略,根据输入长度、任务类型、负载状态动态调整稀疏度、激活阈值与调度策略,实现简单任务低稀疏低成本推理、复杂任务高稀疏高精度计算,兼顾模型性能与工程落地效率,适配多样化落地场景。
五、MoE大模型工程化发展趋势与展望
当前MoE大模型工程化已从基础架构探索进入精细化调度优化阶段,未来将朝着稀疏精准化、调度智能化、部署轻量化、能耗极致化方向迭代。技术层面,AI辅助智能路由、动态自适应稀疏调度、软硬件协同优化将成为核心攻坚方向,通过精准预测专家热点、消除负载失衡、优化硬件适配,彻底解决稀疏架构的效率损耗问题。产业落地层面,MoE将逐步替代传统稠密模型,成为大模型规模化部署的主流架构,在超大规模预训练、云端推理、行业大模型、终端轻量化部署等场景全面普及。
同时,行业将逐步形成标准化的MoE工程优化体系,统一负载均衡、IO调度、分布式并行、路由优化的工程范式,降低超大模型落地门槛。长远来看,稀疏激活与稠密计算的融合优化、动态自适应混合架构将成为主流,实现模型能力、计算成本、调度效率、服务稳定性的多维最优平衡,为通用大模型的低成本、规模化、高质量落地提供核心工程支撑。
六、结语
MoE稀疏激活架构是大模型突破稠密算力瓶颈、实现低成本扩容的关键工程创新,其通过动态择优激活机制,彻底重构了大模型的计算与成本范式,解决了传统稠密模型参数扩容与算力成本激增的核心矛盾,为超大参数模型的产业化落地提供了可行路径。但稀疏激活的动态随机性、非均匀性、碎片化特征,也带来了负载失衡、IO拥堵、通信复杂、路由不稳定等一系列全新工程调度挑战,成为制约MoE模型效率释放的核心壁垒。
MoE大模型工程化的核心本质,是实现稀疏算法架构与稠密硬件体系的适配融合,通过负载均衡优化、分层IO调度、稀疏并行重构、路由稳定优化等工程手段,化解稀疏特性带来的调度难题,最大化释放成本优化优势。未来,随着软硬件协同优化持续深化、智能调度体系不断完善,MoE稀疏架构将进一步平衡性能、成本与稳定性,成为下一代通用大模型规模化落地的核心支撑,推动大模型产业从算力驱动向工程优化与架构创新驱动转型。













