

AI 搜索优化的投入效率,取决于是否避开了几个可明确判定的误区。这些误区的共同特征是:执行动作完整,但均未指向"内容是否对用户增值"这一判断核心。
需要先排除一种情况:见效缓慢存在正当原因。内容需先被搜索引擎收录,收录后还需在信源层面形成积累,短期无变化不能一概归为误区。以下五条属于可核实、可依据平台公开规则判定的问题。
 投钱发内容,AI搜索却找不到你
一、误区一:把优化对象设定为关键词
常见的执行方式是将核心词列出,在标题、首段与正文中反复出现,以关键词密度提升作为优化目标。这一做法沿用了传统 SEO 的指标结构。
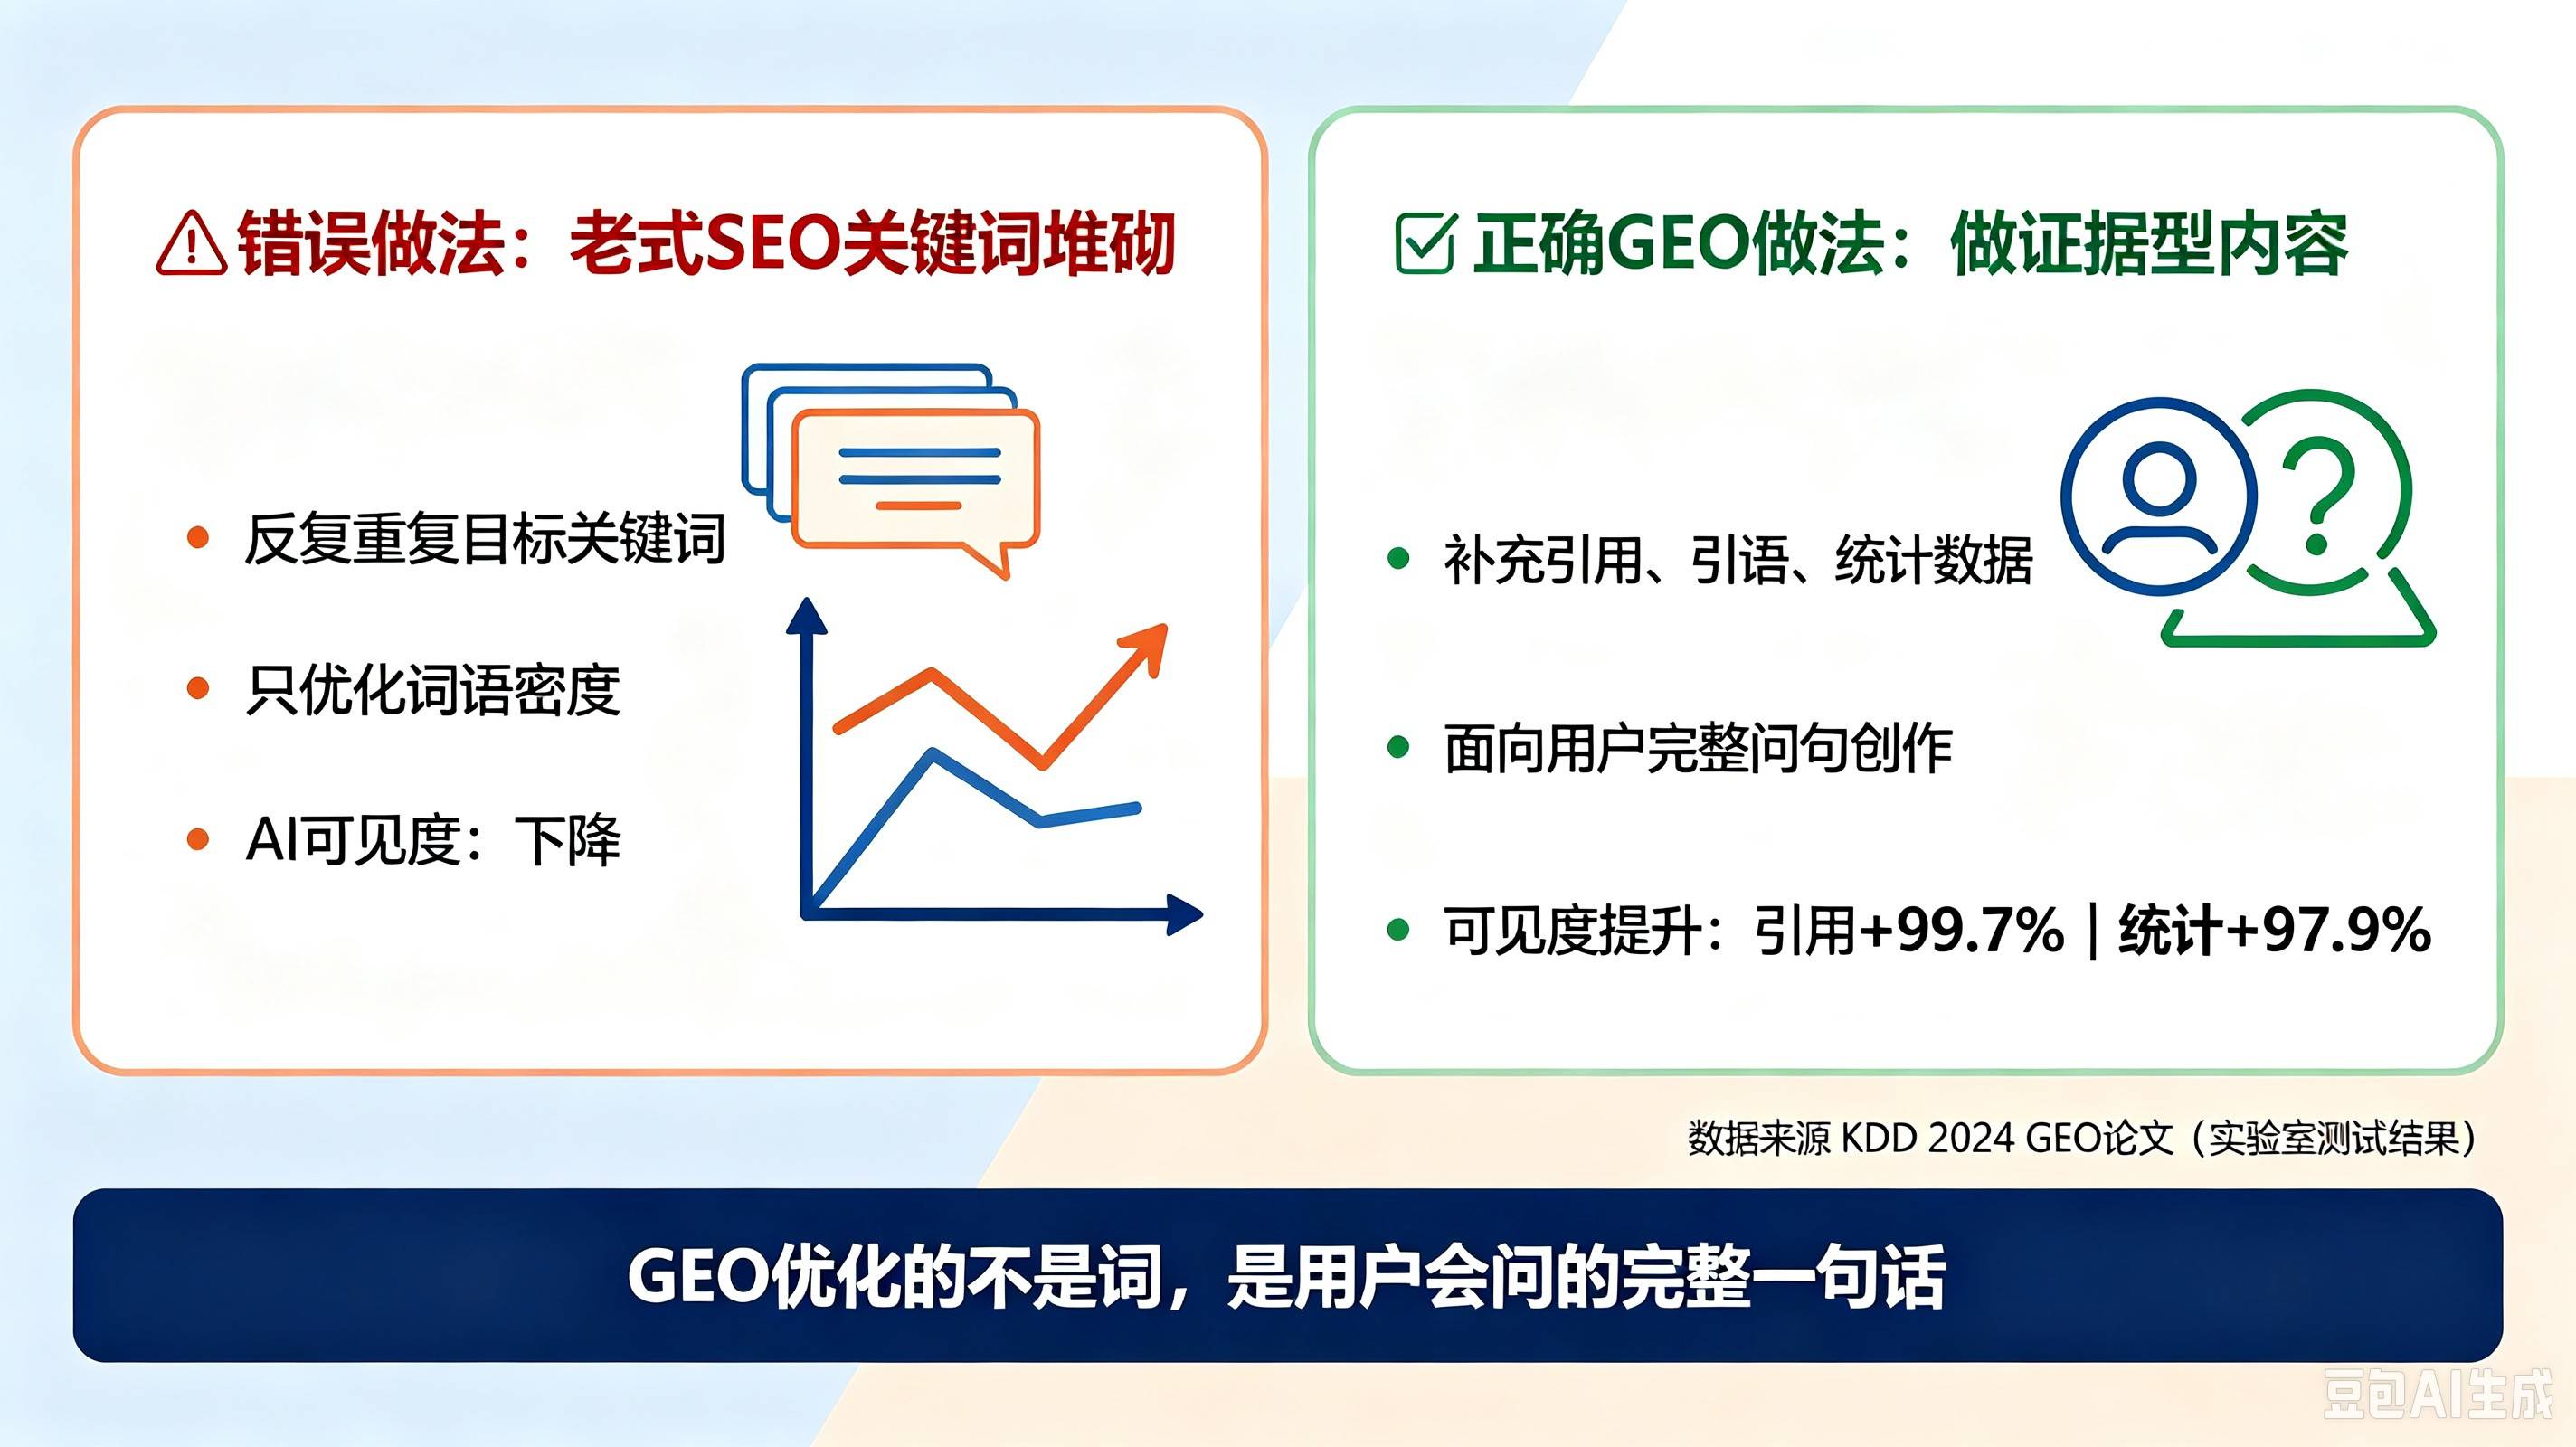
KDD 2024 的一篇论文(普林斯顿与印度理工德里,测试规模为 10,000 条查询、25 个领域)给出明确结论:关键词堆砌无效,甚至有害。同一批测试中,补充来源引用后,原排名第 5 的页面可见度提升 115.1%,而原排名第 1 的页面下降 30.3%;补充引语提升 99.7%,补充统计数据提升 97.9%。
结论指向:生成式引擎优化的对应对象不是关键词,而是用户提出的完整问句。这一判断也解释了 AI 搜索优化 与传统关键词优化在执行方式上并不通用。
 错误和正确的GEO做法对比
二、误区二:把结构化标记视为必要条件
在 AI 搜索优化 领域,流传较广的一种做法是为页面问答区块添加结构化标记,并宣称可提升被生成式系统抓取的概率。Google 搜索官方文档的表述与此不符。
官方文档写明:无需创建新的机器可读文件、AI 文本文件或标记,也不需要添加任何特殊的 schema.org 结构化数据。关于如何出现在 AI 功能中,官方给出的条件仅有一条:网页已被编入索引,且符合显示摘要的条件,无其他技术要求。同时,FAQ 富媒体结果已自 2026 年 5 月 7 日起停止在 Google 搜索显示。
需要区分的是:停止的是展示层,并非理解层。标记保留不会产生错误,只是不再带来可见结果。官方文档中与问答相关的两项要求为"确保重要内容以文字形式提供"与"确保结构化数据与页面上的可见文本一致"——指向的对象均为内容本身。因此 AI 搜索优化 的投入重点应落在问答内容,而非标记覆盖率。
 规模化内容与增值内容的边界
三、误区三:以生成规模替代内容增值
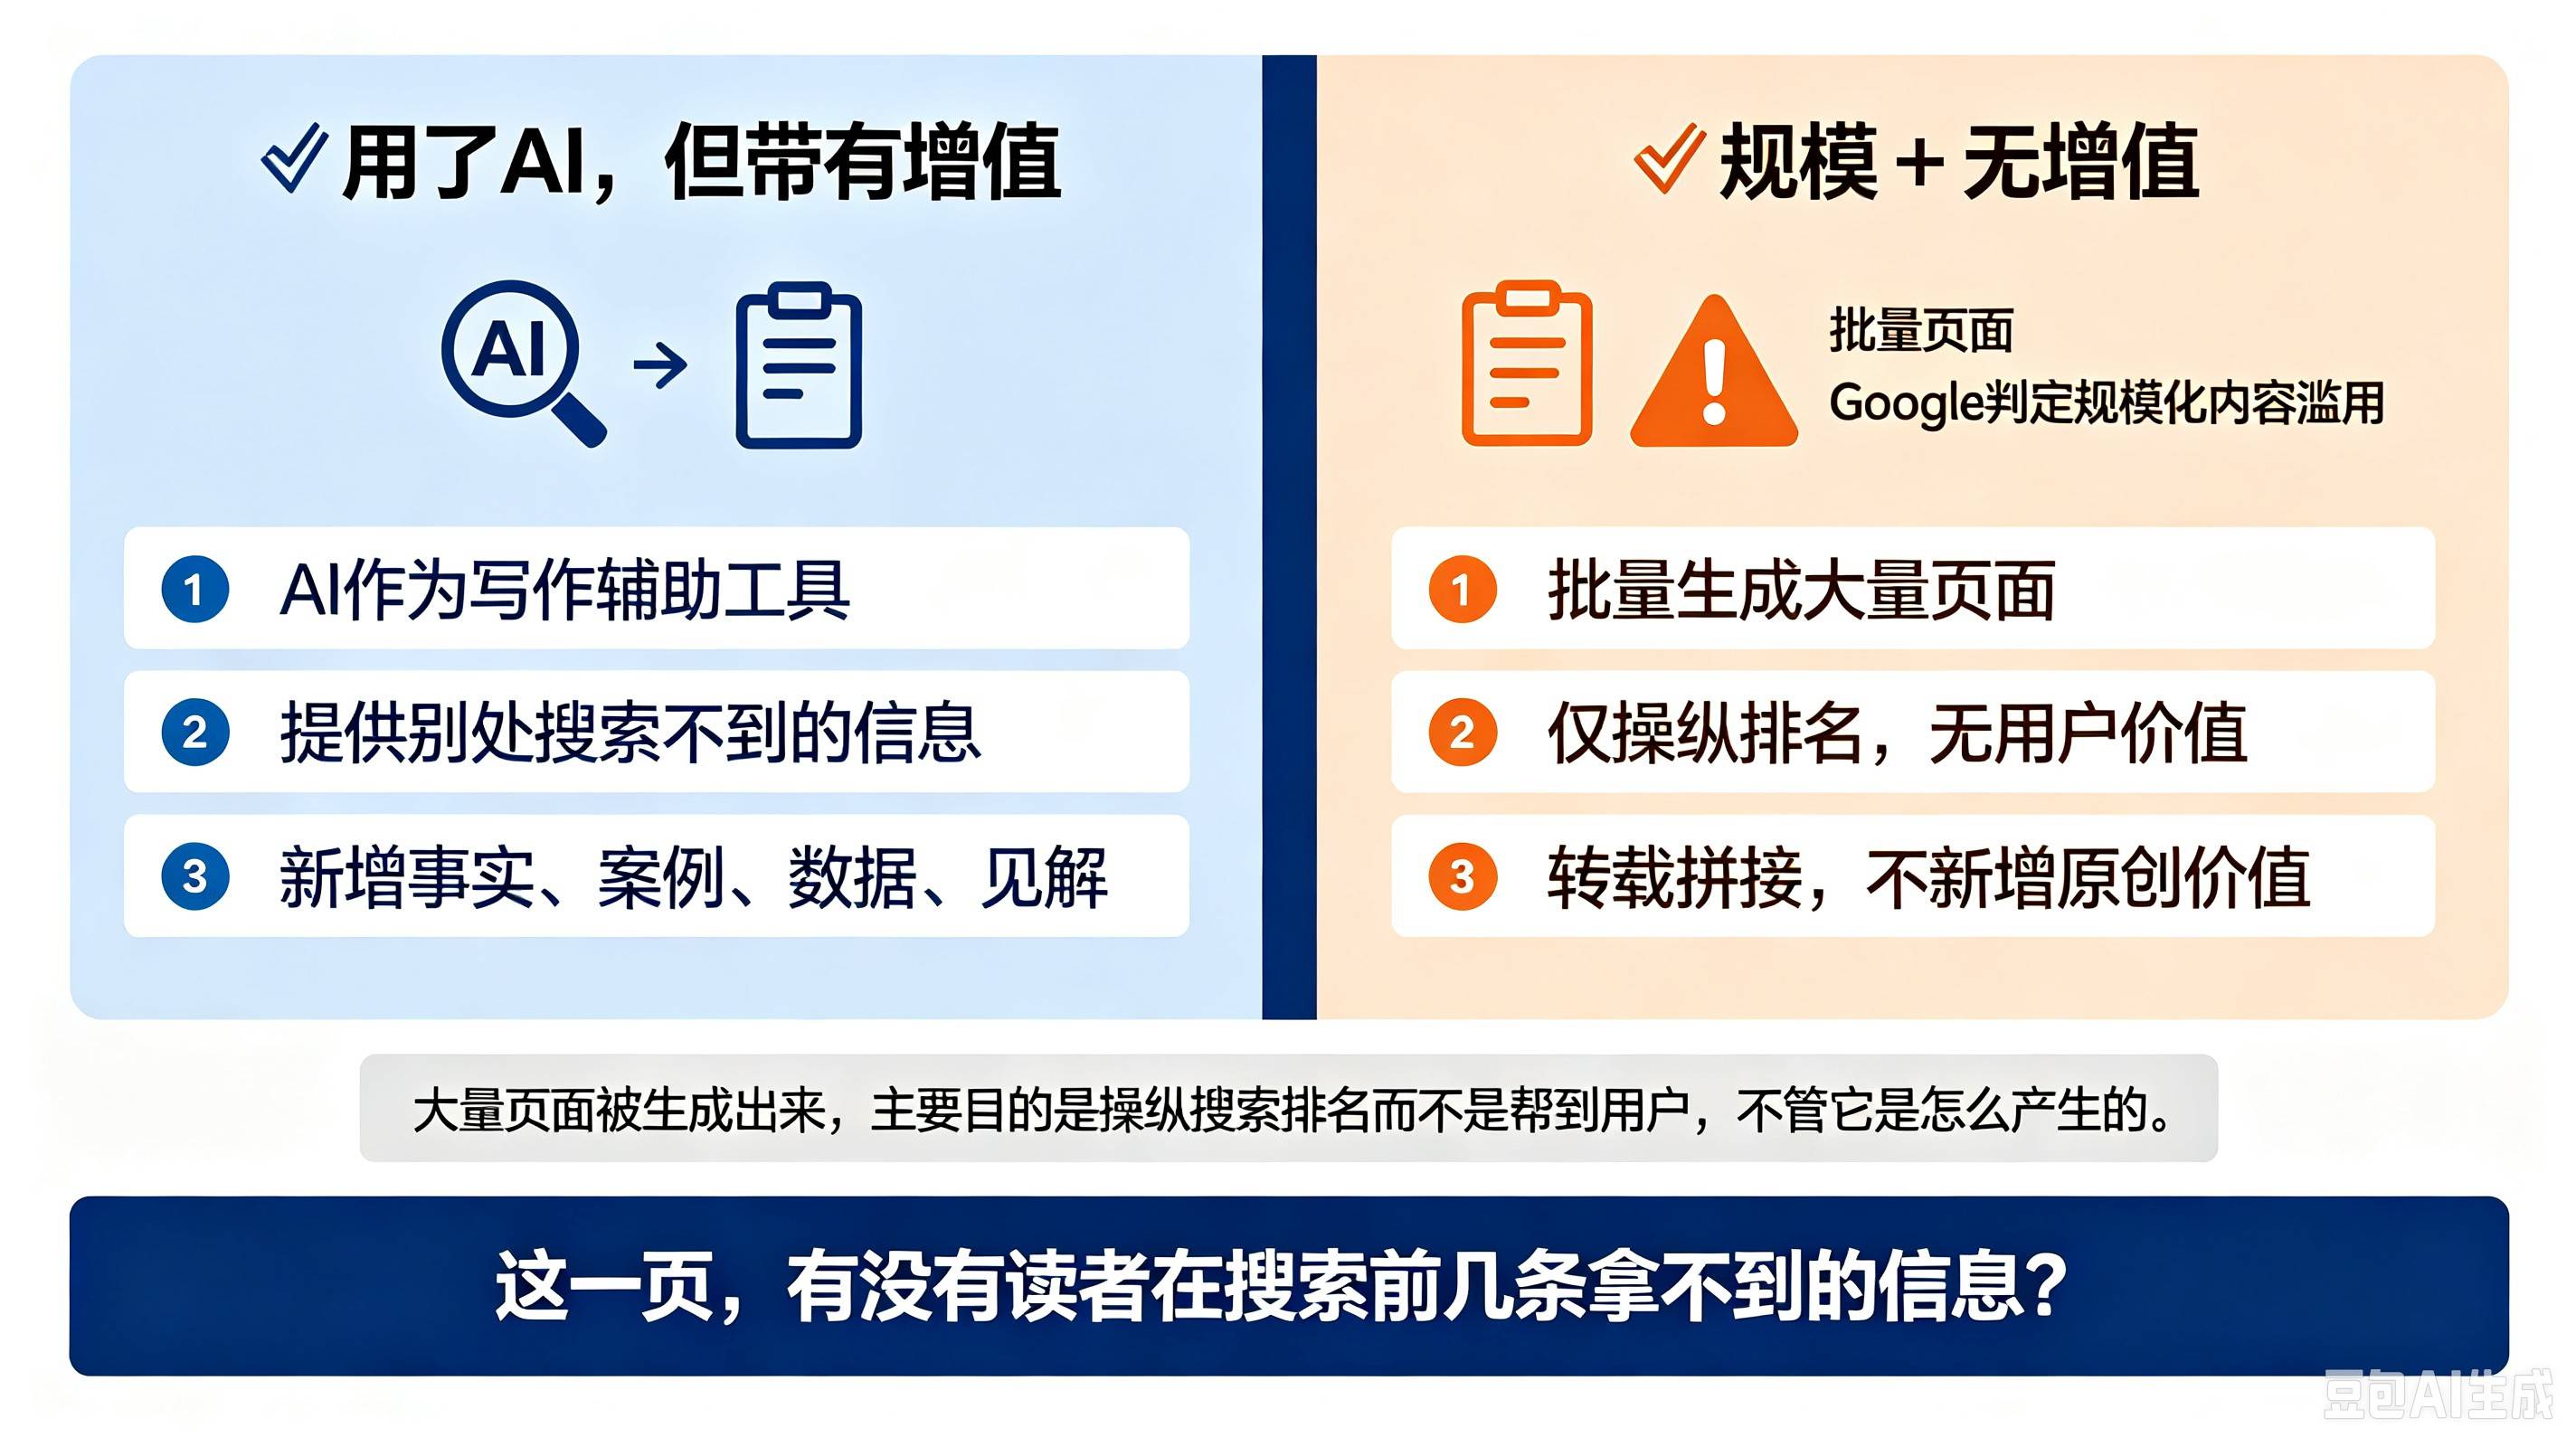
这一条有官方明确规则可依。Google 垃圾内容政策中列有一类 scaled content abuse(规模化内容滥用),定义原文为:many pages are generated for the primary purpose of manipulating search rankings and not helping users……no matter how it's created。官方列举的行为中,第一项即"使用生成式 AI 工具或其他类似工具生成多个页面,但未为用户带来价值"。
该规则需要准确理解:违规要件是"规模 + 无增值",并非"使用 AI"。官方在另一份指南中说明,适当使用 AI 或自动化不违反其指南,其反对的是以操纵排名为主要目的的使用方式。可执行的判据是:该页面是否提供了用户在搜索结果前几条中无法获得的信息。
另有一条常被忽略的规定:官方转载规则指出,转载他人内容即使标注原始来源,若未增加原创内容或价值,同样构成滥用。因此将同一稿件拼接后投放至全部平台的做法,在 AI 搜索优化 的规则层面不可行。
四、误区四:以自有站点为唯一信源
在这一条上,企业容易出现理解偏差,常见逻辑是"完善官网即可,无需其他渠道"。
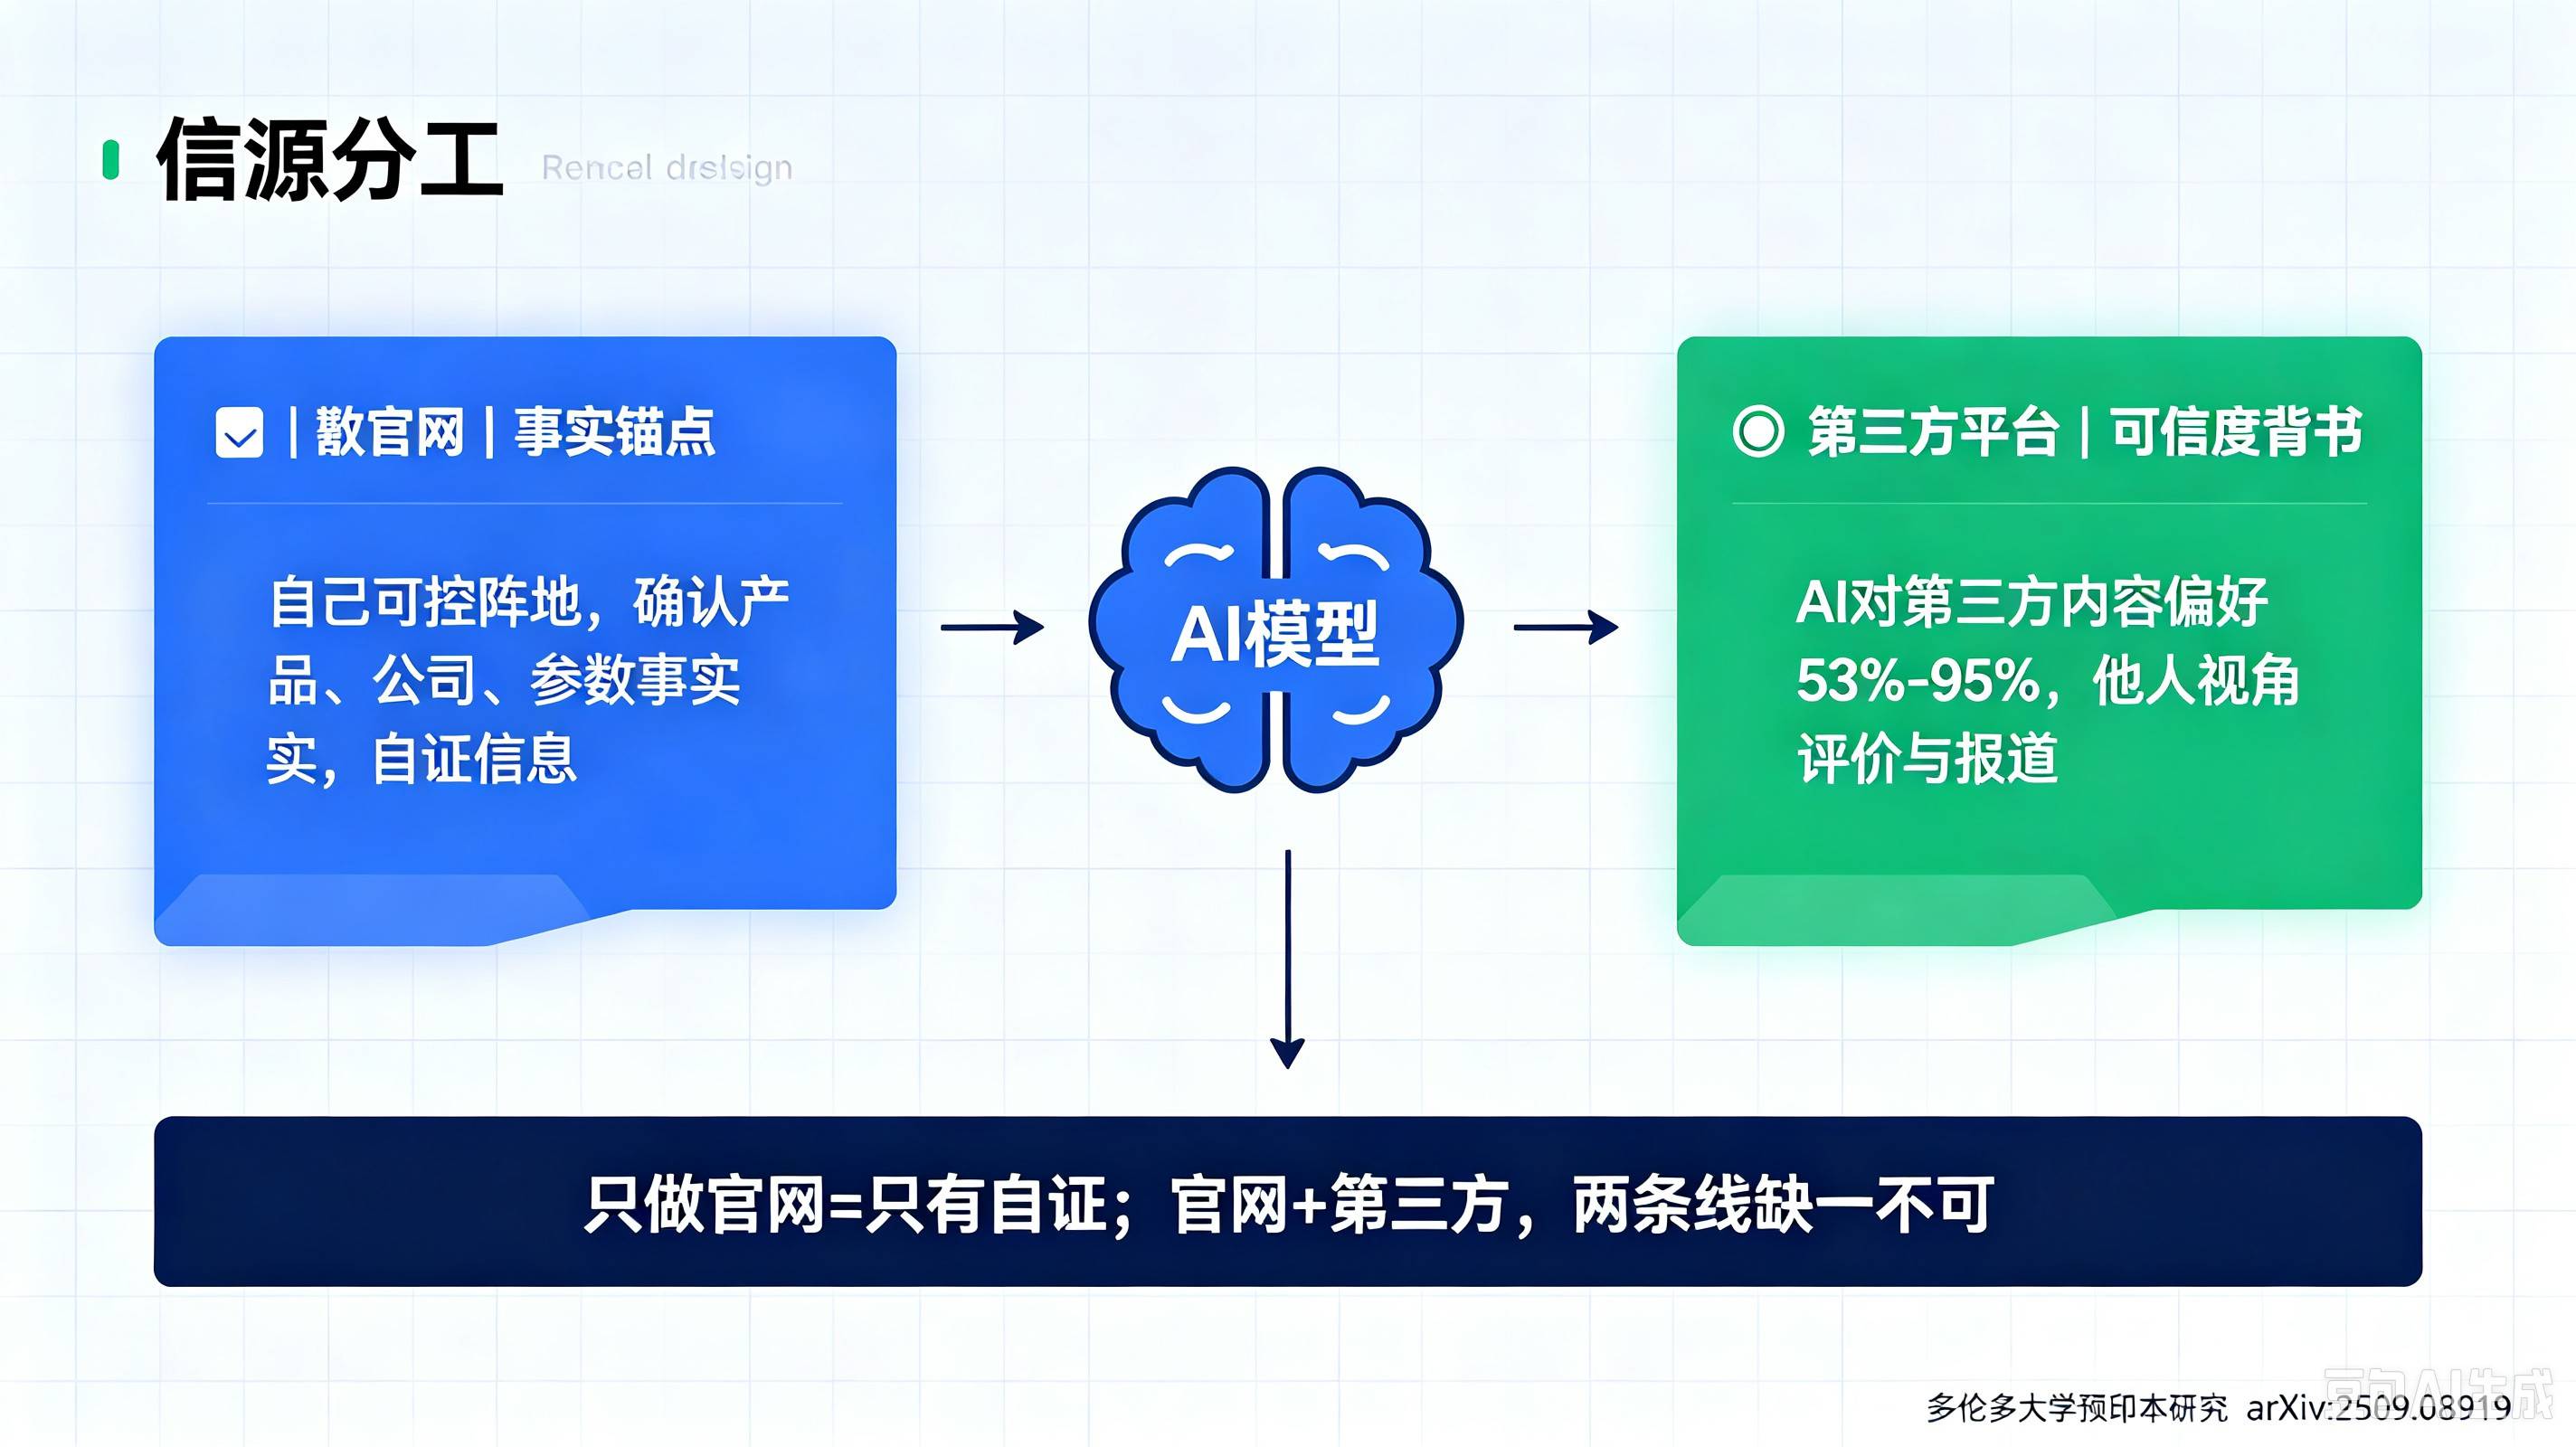
多伦多大学的一项研究(arXiv:2509.08919,未经同行评审)测试了 AI 引擎的内容偏好:其对第三方内容的偏好为 53%–95%,品牌自有内容在该对比中处于劣势,社交平台占比接近零。
在 AI 搜索优化 里,这不意味着官网无价值,而是两端分工:官网承担事实锚点,用于核对公司、产品与参数的准确性;第三方承担可信度背书,用于支持"外部如何评价该企业"的判断。仅做官网,等于只有自证。这是生成式引擎优化 中最常被省略的一半工作。
 信源分工
五、误区五:要求服务方提供结果保证
企业多数都接触过"三个月包进 AI 推荐""保证出现在特定 AI 答案中"一类承诺。这类承诺与两家平台的官方口径均不一致。
Google 官方文档写明:网页即使满足全部要求、建议与政策,也不代表 Google 一定会抓取、索引或呈现其内容。
Bing 在官方博客中对其 AI 引用数据报告作出定性:该报告属观察性指标,不是排名系统,也不是竞争计分板;并提示引用次数不等于推荐、不代表情绪,也不代表点击价值。
需要说明的是,可核查性已经具备:Bing 于 2026 年 2 月上线公开预览的 AI Performance 报告,覆盖 Copilot 与 Bing 的 AI 摘要,可查看引用次数、被引页面与触发引用的接地查询短语。这一工具的公开,意味着 AI 搜索优化 的效果判断有了第一方数据来源。
六、GEO 落地可自行执行的核查方法
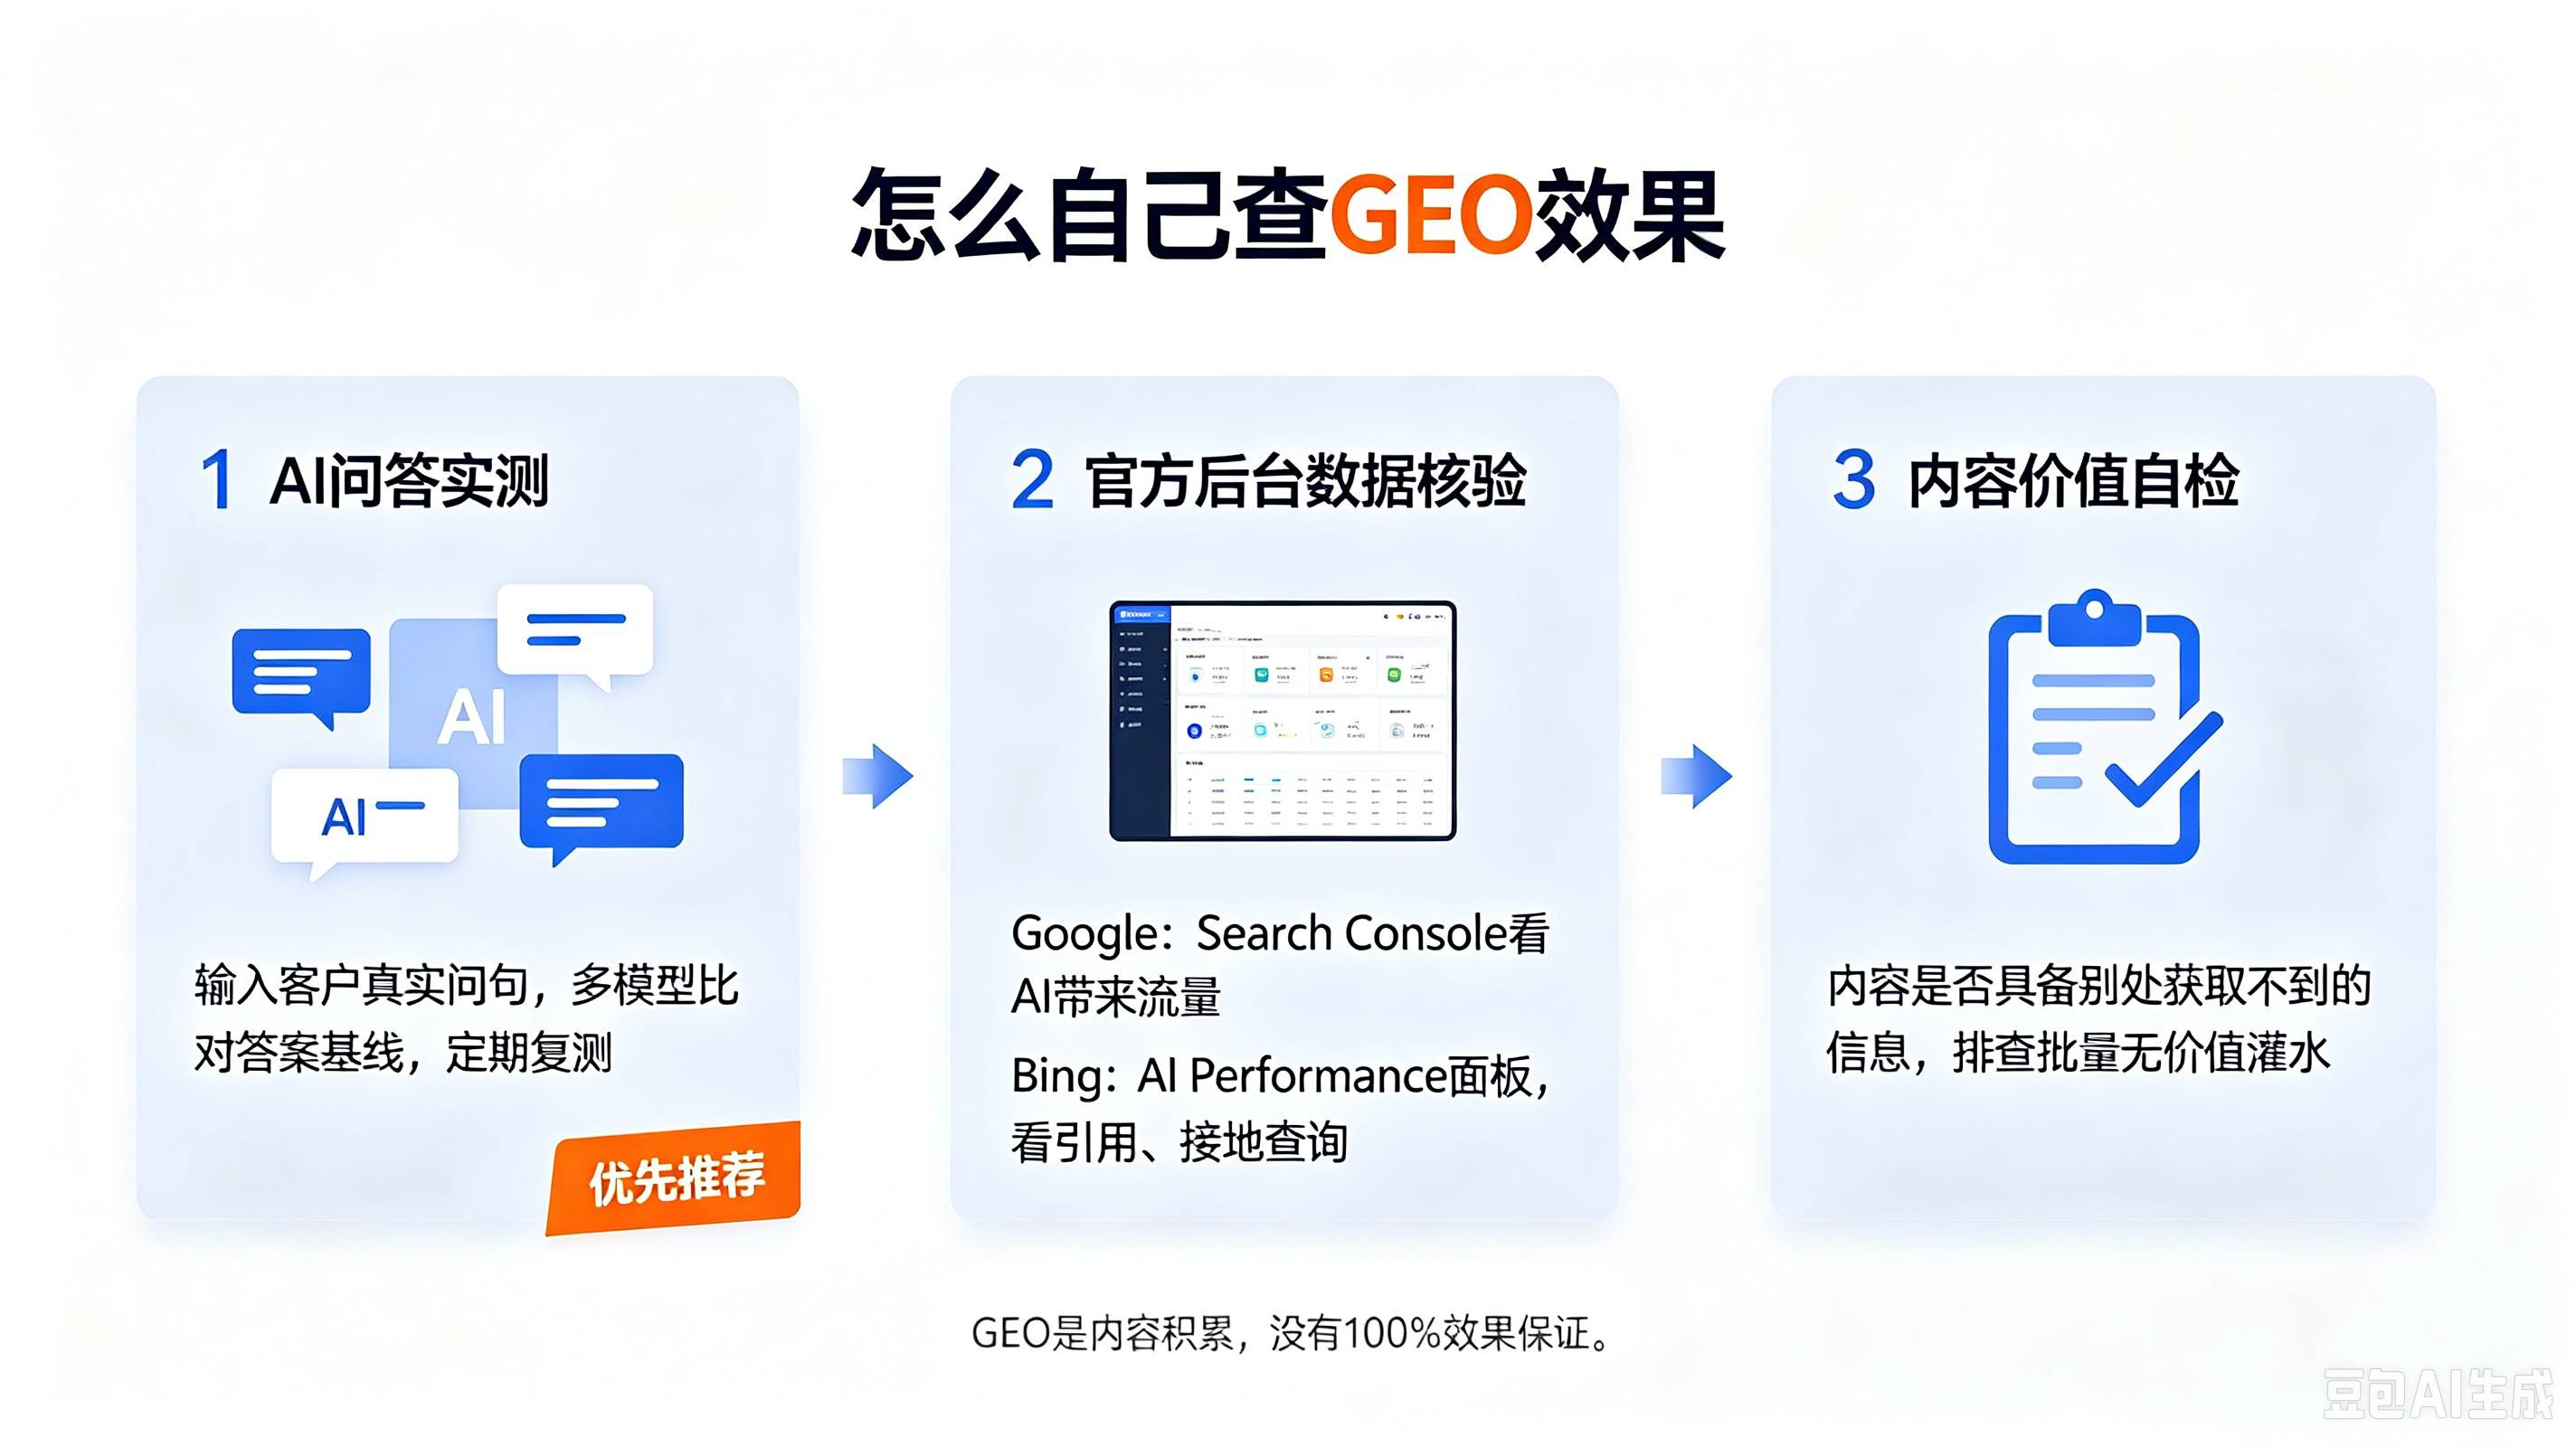
第一,建立提问基线。将目标客户的高频提问原样输入豆包、DeepSeek、文心一言、Kimi、通义千问、腾讯元宝,外贸企业另加 ChatGPT,记录回答中出现的供应商名称,用于后续对比。
第二,调取官方后台数据。Google 侧,AI 功能流量计入 Search Console 总体搜索流量,在"网页"搜索类型中查看;Bing 侧,站点验证后在 AI Performance 中查看引用次数、被引页面与接地查询。
第三,按官方判据复核内容。将近三个月发布的内容逐篇核对,确认是否提供了用户在搜索结果前列无法获得的信息。通过比例偏低,说明规模投入超过价值投入。
 怎么自己查GEO效果
七、关于 AI 搜索优化 时效数据的说明
关于见效周期,公开渠道可查到的时效数字多来自服务方推广材料,同一指标存在多个互相矛盾的版本。两家平台的官方口径一致:均不提供结果保证。因此本文不给出具体天数,仅说明该工作的性质是持续积累,而非投放。
八、四个常见问题
使用生成式 AI 工具生产内容是否违规?
不违规。官方规则针对的是"规模 + 无增值",而非工具本身。判断标准为:内容是否提供读者在其他来源无法获得的信息。
结构化标记是否仍需保留?
保留无碍,但不构成决定因素。在 AI 搜索优化 的实际执行中,问答内容本身的完整与准确应优先于标记覆盖比例。
已发布的问题内容是否需要删除?
无迫切必要。官方明确说明未被使用的内容不产生负面影响。建议将资源转向新增内容的质量,仅在确认为成规模无价值内容时考虑清理。
在珠三角、长三角的制造企业中,这一判断是否有所不同?
区域不是决定性因素。但制造业集中区域的采购提问通常更具体,涉及小批量定制、交付周期与认证要求,对内容颗粒度的要求更高,误区的代价也更直接——内容不对位时,AI 更倾向于报出参数写得更完整的同行。
九、结论
上述五个误区的共同点在于:投入集中在动作数量上,而非内容是否增值。生成式引擎优化的规则边界已经公开,判断依据可以自行核实。对于深圳、珠三角等地从事跨境与出海业务的企业,把核查方法固化为例行动作,比追加预算更能改善结果。
你最近去 AI 里搜过自己的产品吗?答案里有没有你?欢迎在评论区说说。
数据与效果边界:本文引用的平台规则来自 Google 与 Bing 的官方文档与官方博客,属公开规则说明,不构成效果承诺。KDD 2024 为同行评审会议论文,其百分比为实验室条件下的相对变化,不代表真实环境的必然结果;多伦多大学研究为预印本,未经同行评审。文中方法的作用是提高被检索与被引用的概率,不保证企业一定出现在 AI 答案中,也不承诺见效周期与业务结果。
参考资料
- Google Search Central:《Spam policies for Google web search》,2026 年 5 月更新
- Google Search Central:《AI features and your website》,现行版本
- Bing Webmaster Blogs:《New AI Visibility Insights in Bing Webmaster Tools》,2026 年 6 月
- Aggarwal, P. 等:《GEO: Generative Engine Optimization》,KDD 2024(同行评审会议论文)
- 多伦多大学:《arXiv:2509.08919》(preprint,未经同行评审)
[#外贸#] [#AI搜索#] [#GEO#] [#跨境电商#]














