

北京市印发的《北京市人工智能赋能工业互联网高质量发展实施方案(2026—2028年)》的核心命题之一,是“完善全生命周期工业数据治理能力”——围绕原始数据智能清洗、跨领域跨模态语义对齐、三维空间感知建模、知识图谱增强标注等关键环节开展攻关,研发智能体数据清洗、合成、质量评估、审查、脱敏等智能化工具。
这意味着,工业智能体正在从“建设”走向“治理”。
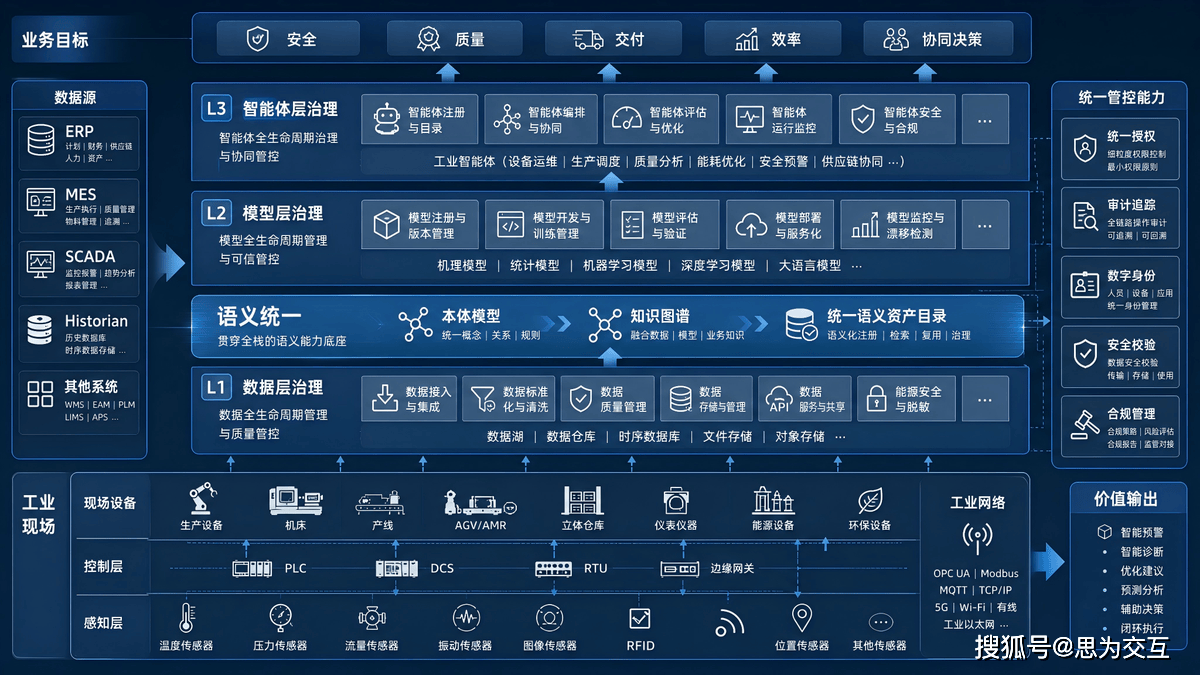
当企业上线了设备运维、物料调度、订单跟踪、质量分析等多个智能体,单独用个个正常,一遇到复杂业务场景就“各说各话”——设备说“我没坏”,物料说“我齐套”,订单却卡在“延期”。这不是个案,而是行业普遍困境。Agent之间如何协同?数据如何治理?模型如何管理?权限如何分配?
一、数据层治理:让工业数据“从脏乱差到干净可用”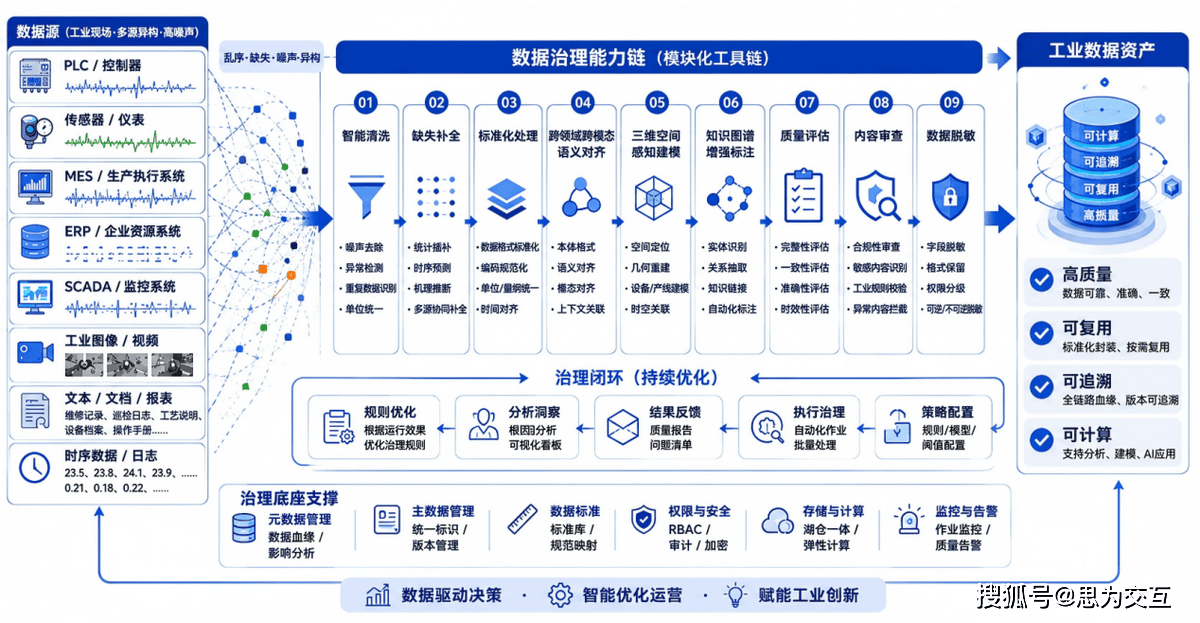
1.工业数据的“先天不足”
工业现场的数据现状可以用三个词概括:多源、异构、高噪声。PLC、传感器、MES、ERP、SCADA……不同系统产生不同格式、不同频率、不同语义的数据。部分企业仍存在数据分散、系统割裂、接口不统一等问题——业务数据没有打通,设备接口难以互联,部门流程彼此割裂。
2.数据治理的四项核心能力
智能清洗:对原始工业数据进行去噪、补全、标准化处理,解决工业场景中普遍存在的数据缺失与噪声干扰。
- 跨领域跨模态语义对齐:将文本、时序、图像等多模态数据映射至统一的语义空间。
- 三维空间感知建模:将物理空间的设备、产线、车间映射为可计算的三维数字模型。
- 知识图谱增强标注:通过知识图谱为原始数据赋予业务语义,使其从“可读”变为“可理解”。
3.从“数据孤岛”到“数据资产”
数据治理的最终目标,是将分散的原始数据转化为高质量、可复用、可追溯的工业数据资产。这需要建立覆盖数据采集、清洗、标注、质量评估、审查、脱敏的全链条智能化工具链。
二、模型层治理:让工业模型“从黑盒到可管可控”
1.模型治理的三大挑战
当工业智能体从单一模型走向模型集群,治理问题随之而来:
- 版本管理:一个模型从训练到上线要经历无数次迭代,谁改的、为什么改、效果如何——需要完整记录。
- 安全校验:工业场景要求高可靠、高实时、高安全。模型输出必须经过校验才能进入执行环节。
- 部署管控:模型部署到边缘端还是云端?不同产线用同一个模型还是各自微调?需要统一的调度策略。
2.模型全生命周期治理
工业智能体需要实现从开发编排、部署上线、运行监控到调优迭代的全流程可视化、可管控、可追溯。这包括:
- 训练治理:训练数据的来源、标注质量、训练参数需全程记录。
- 部署治理:模型版本的审批、灰度发布、回滚机制。
- 运行治理:模型推理的实时监控、异常告警、性能评估。
- 迭代治理:模型更新的触发条件、验证标准、影响评估。
3.大小模型协同治理
工业场景需要“基础模型+行业模型+场景模型”的多层模型体系。不同层级模型之间如何协同、如何避免冲突,是模型层治理的关键命题。
三、智能体层治理:让多Agent“从各自为战到有序协同”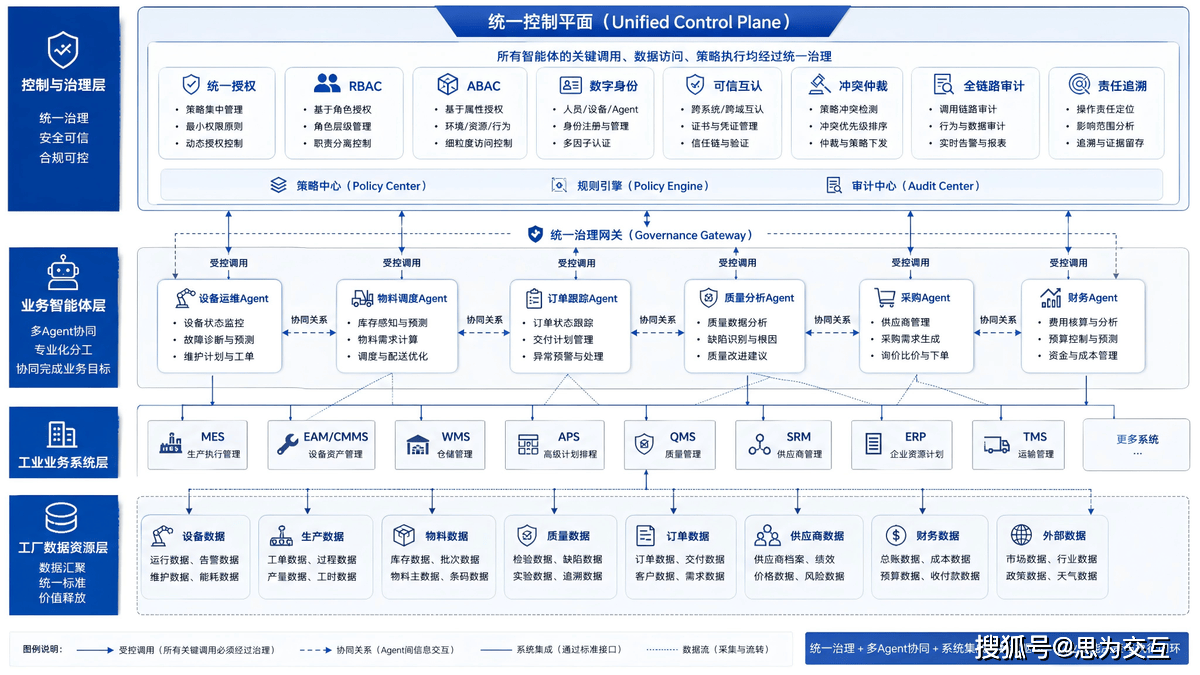
1.多智能体协同的治理困境
当工业智能体从单个厂区的“独立作战单元”升级为跨区域的“联合部队”,治理复杂度呈指数级上升:
- 谁有权调用哪个Agent? ——权限管理问题
- Agent之间如何信任? ——可信互认问题
- 出了问题谁来负责? ——责任追溯问题
- 多个Agent结论矛盾时谁来仲裁? ——冲突解决机制问题
2. 统一授权与权限管控
不是每个Agent自己去申请权限,而是在控制平面统一配置角色和权限边界。借鉴RBAC(基于角色的访问控制)+ABAC(基于属性的访问控制)的双轮驱动模型,可实现:
- 采购Agent只能读供应商库,不能改合同金额;
- 财务Agent只能看预算余额,不能发起支付;
- 厂区边缘层遵循“属地最小权限”原则;
- 集团战略决策层看到的是经过脱敏和聚合的全局视图。
3.全链路审计与行为追溯
每个Agent的每一次调用、每一个决策、每一次数据访问,都需要有结构化日志记录。审计时能还原出“哪个Agent在什么时间、基于什么输入、做了什么事、结果是什么”的完整链条。这对于通过ISO27001、等保三级等合规认证的企业来说,是刚需。
4.数字身份与可信互认
北京市方案提出,探索运用区块链、零信任架构等技术建立工业智能体数字身份标识体系,实现智能体身份的实时核验、行为的全流程溯源,防范身份冒用、权限滥用等风险。这为多智能体之间的可信互认与协同调度提供了制度基础。
四、打通三层治理的关键:工业数据的“语义统一”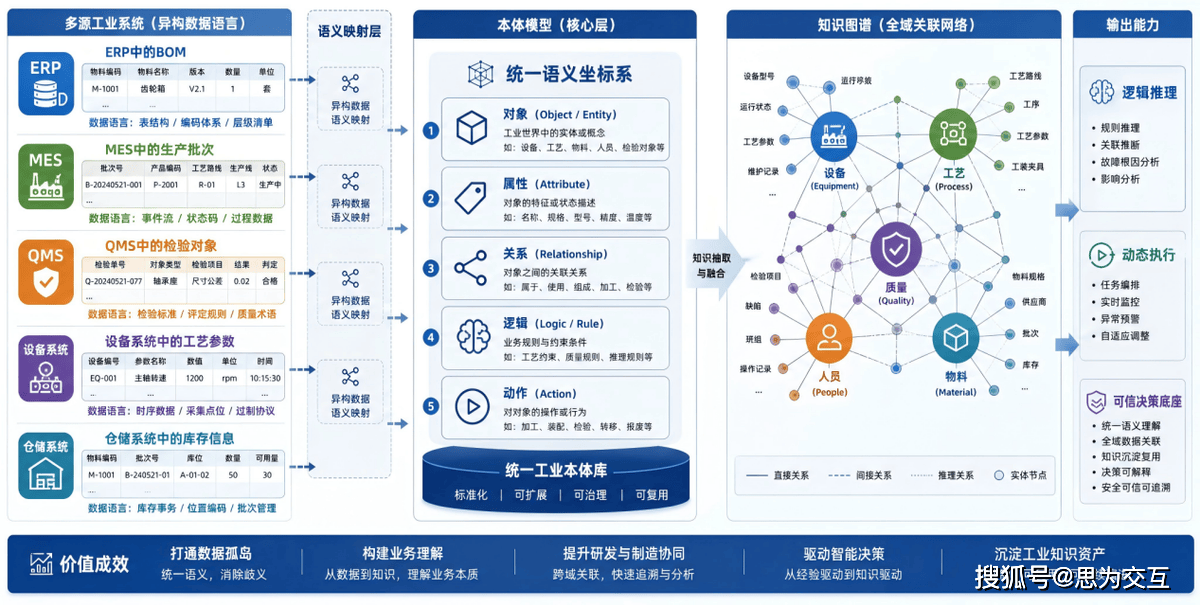
1.为什么数据通了,业务还是没通?
工业现场长期存在OT与IT两套割裂的语言体系。设备、工艺、状态等产线数据,与订单、库存、计划等系统信息,没有统一的业务定义、统一的关系描述、统一的因果逻辑。数据可以流动,但业务知识无法穿透。
一个“产品”在ERP里是物料清单(BOM),在MES里是生产批次,在QMS里是检验对象——这些关联对车间主任来说心知肚明,但对AI来说是完全不同的数据孤岛。
2.本体模型:给工业数据建一套“普通话”
破局的关键在于本体(Ontology) ——它是由对象、属性、关系、逻辑、动作五要素构成的可推理、可执行、可管控的动态语义网络。本质上是为工厂的设备、工艺、物料、人员建立一套统一的“语义坐标系”,相当于让所有机器和系统先学会同一种“普通话”。
3.知识图谱:让工业知识“可计算”
在本体模型的基础上,知识图谱建立起“设备-工艺-质量-人员”的全域关联网络。统一数据语义资产目录和知识图谱,完成数据要素与语义的绑定,沉淀关系与知识图谱。最终实现:
- 从“关联检索”升级为逻辑推理
- 从“静态展示”升级为动态执行
- 从“辅助理解”升级为可信决策底座
1.为什么“先建设、后治理”行不通了
过去的企业信息化建设,往往是“先上系统、再补治理”。但对于工业智能体而言,这条路走不通:
- 智能体天生是自治的:一旦部署上线就开始自主决策,没有预先的治理框架,越权、冲突、失控就是大概率事件。
- 治理成本随规模指数增长:3个Agent的治理复杂度远不是1个Agent的3倍,而是数量级的差异。
- 工业场景不容试错:生产线的安全、质量、交付不容闪失,治理缺位带来的后果可能是停产、事故、索赔。
2.“建设即治理”的三层内涵
第一层:治理架构前置。 在智能体建设规划阶段,就将数据治理标准、模型管理规范、权限审计体系纳入设计,而非“上线后再补课”。
第二层:治理能力内嵌。 将数据清洗、语义对齐、权限管控、审计追踪等治理能力作为平台的内置能力,而非外挂模块。
第三层:治理与建设同步演进。 智能体每新增一个、每迭代一次,治理策略同步更新——从统一授权到全链路审计,从静态权限到动态调权。
工业智能体的竞争,正在从“谁先建”转向“谁会管”。
数据层治理解决的是“原料干不干净”——数据清洗、语义对齐、质量评估,让工业数据从杂乱无章走向有序可用。
模型层治理解决的是“大脑靠不靠谱”——版本管理、安全校验、部署管控,让工业模型从黑盒走向可管可控。
智能体层治理解决的是“团队听不听话”——统一授权、全链路审计、数字身份,让多Agent从各自为战走向有序协同。
而贯穿这三层治理的语义统一——本体模型+知识图谱——则是打通数据孤岛、让机器真正“理解”业务的关键基础设施。











