HLS(高层次综合)这两年在FPGA圈子的热度肉眼可见地上升。Vitis HLS、Catapult HLS这些工具让软件工程师也能把C/C++算法“编译”成RTL,尤其是OpenCV图像处理和TensorFlow Lite推理这两类算法,看起来非常适合走这条路。
但真正上手之后,很多人会发现一个尴尬的事实:代码在C仿真里跑得通,综合出来的RTL却要么资源爆炸,要么时序死活收敛不了,要么延迟比CPU还慢。
这篇文章从实际工程角度,梳理把OpenCV和TFLite算法交给HLS时需要提前想清楚的事情。
一、OpenCV的“可综合”问题:很多函数根本没法映射
OpenCV的函数库是为CPU设计的,里面大量使用了动态内存分配、指针操作和运行时数据结构。这些在硬件里根本没有对应的东西。
最典型的例子是cv::Mat。OpenCV用cv::Mat来管理图像数据,它支持任意尺寸的图像,内部通过指针动态分配内存。但FPGA的资源是固定的,BRAM和DSP数量在你选芯片的时候就定死了。HLS无法综合一个“运行时才知道多大”的数组。
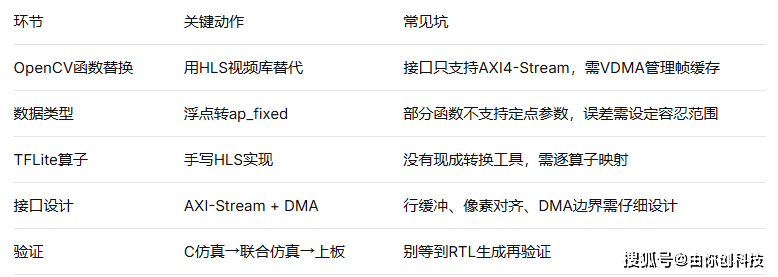
所以OpenCV代码迁移到HLS的第一步,是把所有OpenCV函数替换成HLS视频库的可综合函数。比如cv::medianBlur要替换成xf::medianBlur,cv::Sobel要替换成xf::Sobel。HLS视频库提供了约50个与OpenCV功能对应的可综合函数,名字相似但底层实现完全不同。
一个简单的中值滤波,OpenCV版本和HLS版本的对比如下:
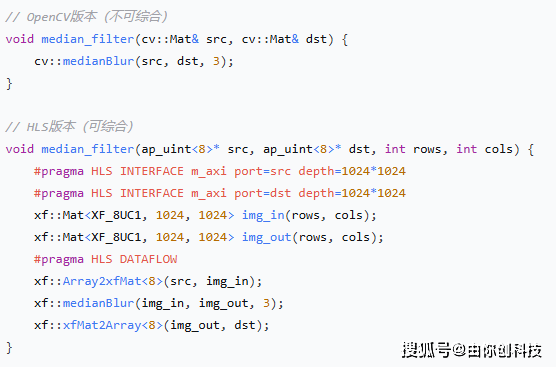
需要特别注意的是,HLS视频库的接口只支持AXI4 Streaming Video格式,不能直接连AXI4 Slave或Master端口。这意味着如果设计里需要外挂帧缓存(比如同时处理多帧图像),必须通过VDMA由处理器来管理外部内存。数据通路的架构需要在写算法代码之前就规划好。
二、数据类型:浮点转定点是绕不开的一步
OpenCV的函数默认使用浮点运算,但FPGA里的浮点运算单元非常昂贵——消耗大量DSP和LUT,延迟也高。HLS虽然支持float和double类型,但综合出来的电路效率和定点实现完全不是一个量级。
正确做法是用ap_fixed<>和ap_ufixed<>模板类替代浮点类型。比如一个图像缩放算法,原本用float计算像素坐标映射,可以改成ap_fixed<16,8>(16位总宽,8位整数部分,8位小数部分)。
但这里有个容易踩的坑:不是所有HLS视频库函数都支持定点参数。hls::Filter2D和hls::ConvertScale在某些版本中仍然要求浮点参数。选型时要提前确认目标函数是否支持定点化,否则综合时才发现不支持,前面的代码可能要大改。
还有一个隐含的问题:OpenCV的浮点运算结果和HLS定点实现的结果不可能做到bit-accurate。浮点有舍入误差,定点也有量化误差,两者的误差累积路径不同。测试平台的比较不能要求“完全一致”,而应该设定一个可接受的误差范围。
三、TensorFlow Lite的算子映射:没有现成的“转换按钮”
TFLite的情况比OpenCV更复杂。OpenCV至少有HLS视频库做了一层封装,TFLite这边没有类似的“一步到位”工具——至少主流工具链没有。
TFLite模型本质是一张计算图,每个节点是一个算子(Conv2D、DepthwiseConv2D、FullyConnected、ReLU6等)。HLS需要为每个算子手写对应的C/C++实现,再用#pragma HLS指令做流水线优化。
一个典型的TFLite推理流程——量化、算子映射、HLS代码生成的完整链条——大致是这样的:
- 用TFLite Converter把Keras模型转成.tflite格式,同时做INT8量化
- 用TFLite Interpreter的Python API遍历计算图,提取每个算子的类型、输入输出张量维度和量化参数
- 为每个算子编写HLS实现,用Dataflow指令做流水线
- 设计顶层调度器,按顺序执行算子,用双缓冲DMA搬运权重和激活数据
- 导入Vivado构建Block Design,配DMA控制器
hls4ml是一个值得关注的工具,它能自动把Keras/TensorFlow模型转成HLS代码。它通过复用因子来控制硬件并行度——复用因子越大,使用的乘法器越少,延迟越高;反之则资源消耗大、延迟低。但hls4ml主要面向全连接和卷积网络,对TFLite中一些较新的算子支持并不完整。
实际项目中,一个MobileNetV1规模的模型,如果为每个算子手写HLS实现并逐一调优,工作量在数周到数月不等,取决于算子数量和复杂度。
四、接口设计:AXI-Stream和DMA的配合
算法逻辑写完了,接口设计往往才是真正耗时间的部分。
HLS生成的IP核要通过AXI接口和外部通信。图像数据用AXI4-Stream,控制寄存器用AXI4-Lite,DDR读写用AXI4-Master。这些接口的配置需要在HLS代码中用#pragma HLS INTERFACE指令指定。
一个容易被忽略的问题是数据流的对齐和顺序。OpenCV处理图像时是逐像素操作的,数据在内存中的排列顺序是行优先。但AXI-Stream传输的是字节流,没有“行”和“列”的概念。数据从内存搬到FPGA的过程中,如何保证像素顺序正确、如何避免DMA传输的边界错位,需要在测试平台里反复验证。
更麻烦的是行缓冲区的设计。图像处理算法通常需要同时访问多行像素(比如3×3的滤波窗口)。CPU实现里直接访问内存就行,但FPGA里必须用行缓冲区(Line Buffer)在片内缓存最近几行数据。行缓冲的深度、BRAM的分配方式、读写地址的生成逻辑,这些在C代码里完全看不到,但在HLS中必须显式设计。
五、验证策略:别等RTL生成完了再开始验证
HLS项目最容易犯的错误,是等到C代码“写得差不多了”再开始验证。这时候如果发现微架构层面的问题(比如数据流设计不合理导致带宽瓶颈),修改成本非常高。
正确的做法是在C/C++阶段就建立验证环境。用OpenCV或NumPy作为黄金参考模型,在C仿真阶段就对比HLS实现和参考实现的结果。如果误差超了,这时候改代码的成本几乎为零。
C仿真通过之后,再做C/RTL联合仿真,验证综合出来的RTL行为是否和C代码一致。最后才是上板测试。
这个“三级验证”流程看似繁琐,但比“上板发现错了再回头查”的效率高得多。一个中值滤波算法,在C仿真阶段可能只需要几分钟就能发现边界处理的问题;如果等到上板,同样的bug可能要花一天才能定位。
六、一点实际感受
HLS确实能显著降低算法硬件化的门槛——一个原本需要120行Verilog的中值滤波,用HLS大概30行C++就能搞定。但“降低门槛”不等于“零成本”。数据类型的选择、接口的设计、验证策略的规划,这些都需要算法工程师和硬件工程师协作完成。
这类项目的关键在于前期的架构评估——把算法的数据流和FPGA的资源模型对齐,把接口带宽和DMA策略想清楚,把验证环境在C阶段就搭起来。如果规划到位,一个中等复杂度的图像处理算法从C代码到可用的IP核,2到3个月是比较现实的周期。如果直接拿OpenCV代码改几个头文件就往HLS里丢,踩的坑可能比预期多得多。
总结一下