

凌晨的值班群连续收到几十条相似告警。值班人员先静音,白天才发现其中一条需要立即处理。另一个群只有一条故障通知,却没人知道该由谁接手。两种情况看似相反,根源相近:机器人把事件送进了群,但告警筛选和响应责任没有一起设计。
接入飞函自定义机器人时,可以把群聊作为团队看见和讨论事件的入口。真正决定“发什么、发给谁、何时升级”的规则,应在告警来源或连接系统中明确配置,并由值班流程承接。
先减少重复,再决定是否进群
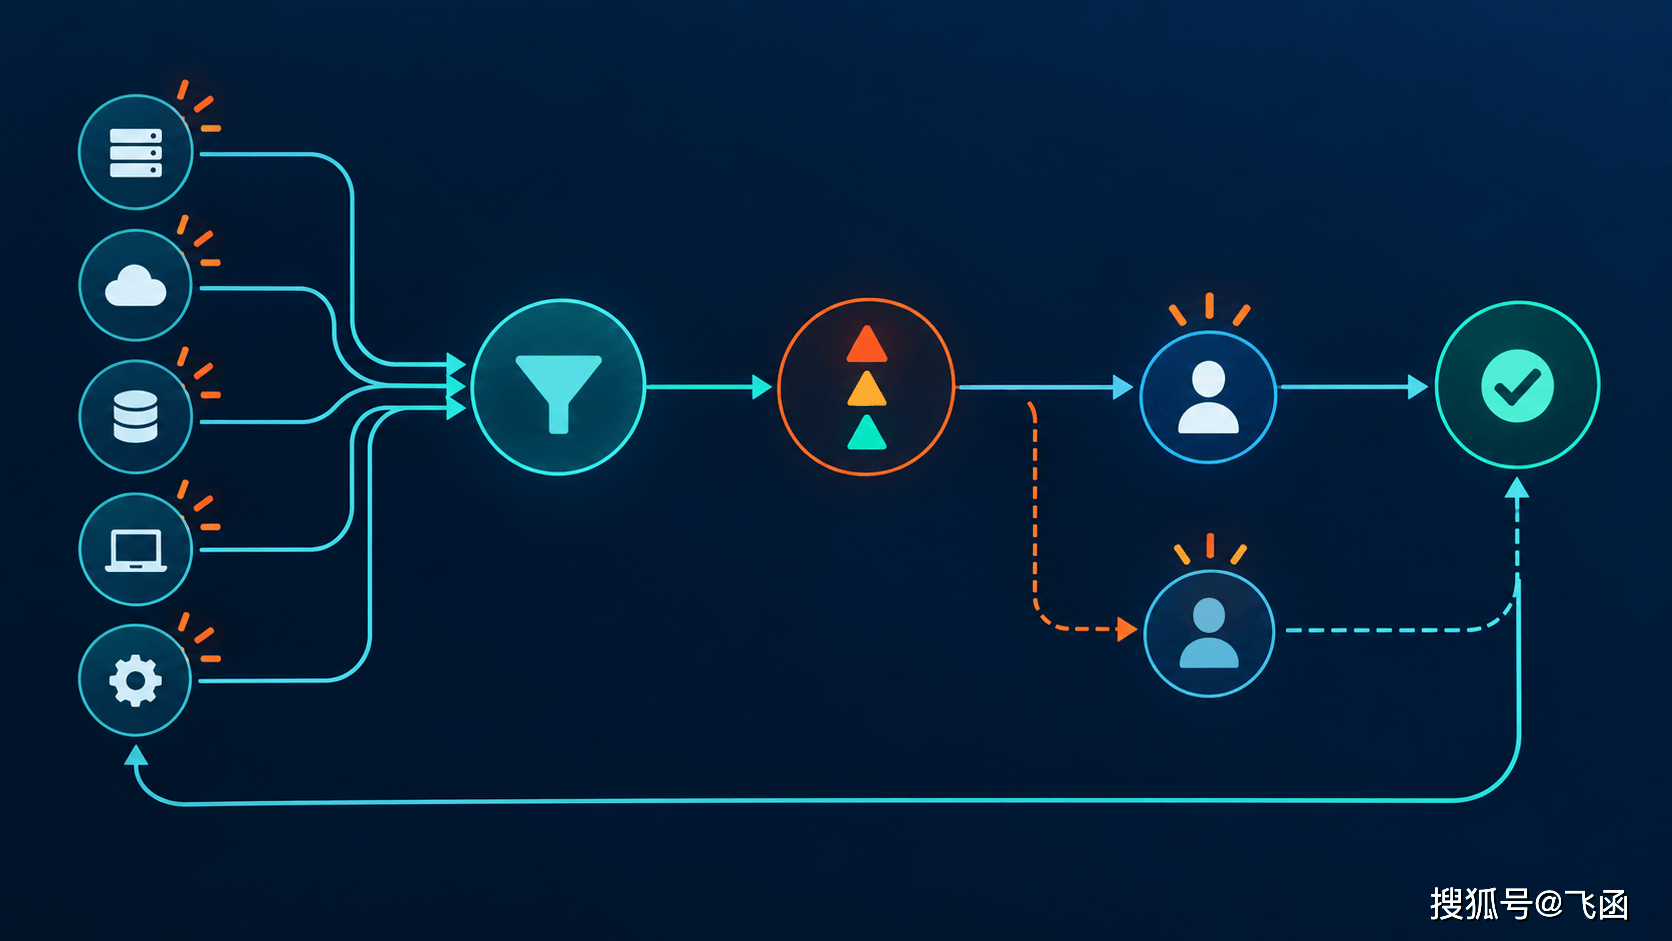
同一设备、服务或任务在短时间内反复报错,若每次都单独推送,群成员很快无法判断哪些是新问题。可以先按业务对象、故障类型和环境生成事件标识,在约定时间窗内合并重复告警:首条说明异常,后续更新次数、持续时间和状态变化。恢复通知关联原事件,方便大家看清起止。
合并也要有边界。不同业务对象的故障、严重程度升级,或已经恢复后再次发生的异常,不宜只因文案相似就吞并。低优先级波动可汇总后定时发送;影响关键业务的事件则及时通知。规则上线后,定期检查被抑制的事件,防止误过滤。
每条需要行动的告警,都指向一个负责人
“请相关同事关注”没有给出下一步。进入群的行动类告警,至少应让人看懂四件事:发生了什么、影响范围、当前负责人、最迟何时确认。负责人可以按系统、班次或业务线预先映射;找不到负责人时,转给明确的兜底值班角色,而不是把责任留给整个群。
消息内容宜简短:用一行摘要交代事件与级别,再提供事件编号、发生时间、排查入口和建议动作。涉及敏感信息时,只在群内放必要摘要,详细日志留在原业务系统,并按原有权限查看。
把“看到了”变成可追踪的确认
群里出现回复,不一定代表有人接单;消息已读,也不等于故障正在处理。为每条行动类告警建立独立事件记录,要求负责人在约定时限内确认,并记录接手、处理、转交和关闭状态。确认动作可以发生在现有工单或告警系统中,再将关键状态同步到群里;具体对接方式以实际系统能力为准。
超过确认时限,先通知备班或上级值班角色;仍无人接手,再按业务影响升级。升级通知应带上原事件编号和此前尝试联系的记录,避免换一个群重新讲述问题。关闭时回传处理结果或后续跟进人,让群成员知道事件已有归属。
用一次演练检验规则
挑选一类高频告警试运行:模拟重复触发、级别升高、负责人不在线和恢复后复发,检查群内是否能看到清晰的事件脉络,以及每一步是否有人接手。再根据实际误报、漏报和确认耗时调整时间窗与路由规则。
自定义机器人解决的是消息进入协作现场的问题。让告警真正产生行动,还需要上游做好筛选与分级,让值班流程给出负责人、确认时限和升级路径。














