

大家好,我是小林。
聊到昇腾,很多人先想到的是芯片和超节点。但要把这些硬件的算力真正用起来,还离不开软件。
CANN 就是其中关键的一层,负责连接 PyTorch 等 AI 框架与昇腾硬件,让模型的计算任务在硬件上运行。
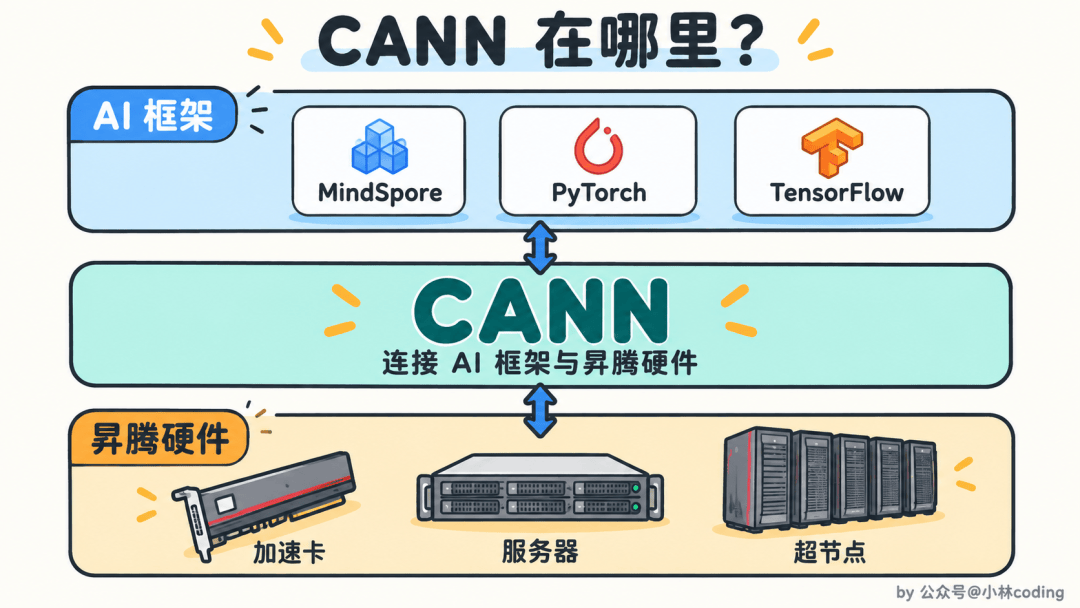
从 2018 年发布首个版本到现在,CANN 已经有了八年的技术积累。它开放了运行调度、算子开发、通信等核心组件和调优工具,开发者可以使用、修改,也能把优化成果贡献回社区。
这个社区如今发展到了什么程度?
据公开的信息,CANN 月活开发者突破 5200 多名,开源仓下载量超过六千万。超过一半的活跃贡献来自昇腾之外,社区活跃度位居国内 AI 开源社区第一。
这里更值得关注的是,越来越多外部开发者开始参与维护和优化,其他团队也能用上这些改进。开放的代码,正在变成大家一起建设的软件生态。
在这次华为全联接大会2026上,昇腾又带来了新一代超节点,以及 CANN 与 Mind 系列软件的新进展。
算力更强、代码更开放之后,开发者能不能更轻松地把这些算力用起来?环境能不能少折腾,算子开发和性能调优能不能更顺手?
今天就来看看,昇腾从「好用」走向「易用」,具体变在哪里。
────01|AI 越强,开发体验为什么越重要?────
先说一个容易被忽略的问题,今天开发一个大模型应用,最费时间的环节到底是什么?
如果只是写一段业务代码,AI 编程工具已经能帮上不少忙。但项目进入训练和推理阶段以后,开发者很快就会碰到底层问题。框架版本、驱动、运行环境需要配套,模型中的新结构需要算子支持,集群跑起来以后还要定位通信、内存和性能问题。
这些工作单独看都不新鲜,麻烦在于它们连在了一起。前面一个版本没对上,后面可能连环境都跑不通。算子功能做出来了,性能又未必过关。到了百卡、千卡集群,日志和性能数据更是会迅速膨胀。
看到这里,估计有同学会问,底层技术本来就复杂,要求它「易用」会不会只是把复杂度藏起来?
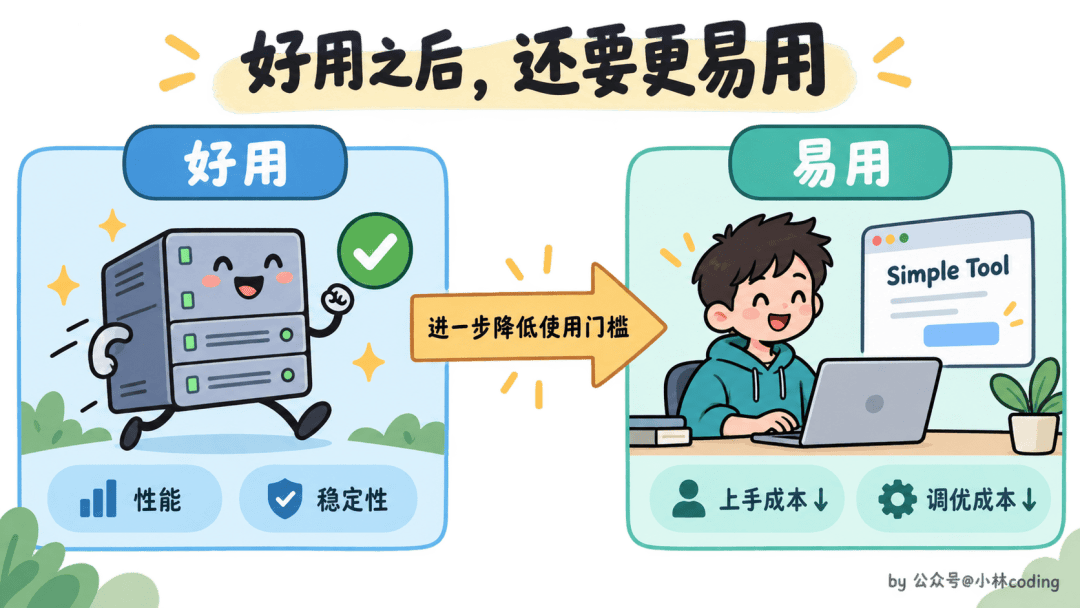
我觉得不能这么理解。
「好用」更关注能力本身,比如模型能不能跑、性能够不够、结果稳不稳定。「易用」则把人的成本也算了进去,开发者需要学多少新知识,要做多少重复适配,出了问题能不能快速找到原因。
而且,这些工作很少做一次就结束。模型和算法不断迭代,新结构可能带来新的算子与适配需求。模型在本地部署之后,业务对响应速度、并发量和资源成本的要求,也会推动开发者继续调优。如果每次变化都要重新摸索,迭代的时间就会耗在这些基础工作上。这也是基础软件需要更易用的原因。
复杂度没有凭空消失,只是被工具、组件和经过验证的工作流接住了。开发者不必每次从零摸索,才算真正降低了门槛。
这也解释了为什么基础软件会成为这次昇腾开源开放的重点。算力再强,如果开发者要先穿过一片版本、算子和调优的丛林,硬件能力就很难快速变成模型和应用。
────02|昇腾超节点为什么离不开基础软件?────
那昇腾超节点解决的是什么问题?
简单来说,大模型尤其是 MoE 模型越来越大,一张卡装不下,也算不过来,就要让更多计算节点一起工作。问题是,卡多不等于效率一定高。数据在不同节点之间来回传输,通信时延、内存分配和任务调度都可能拖慢整套系统。
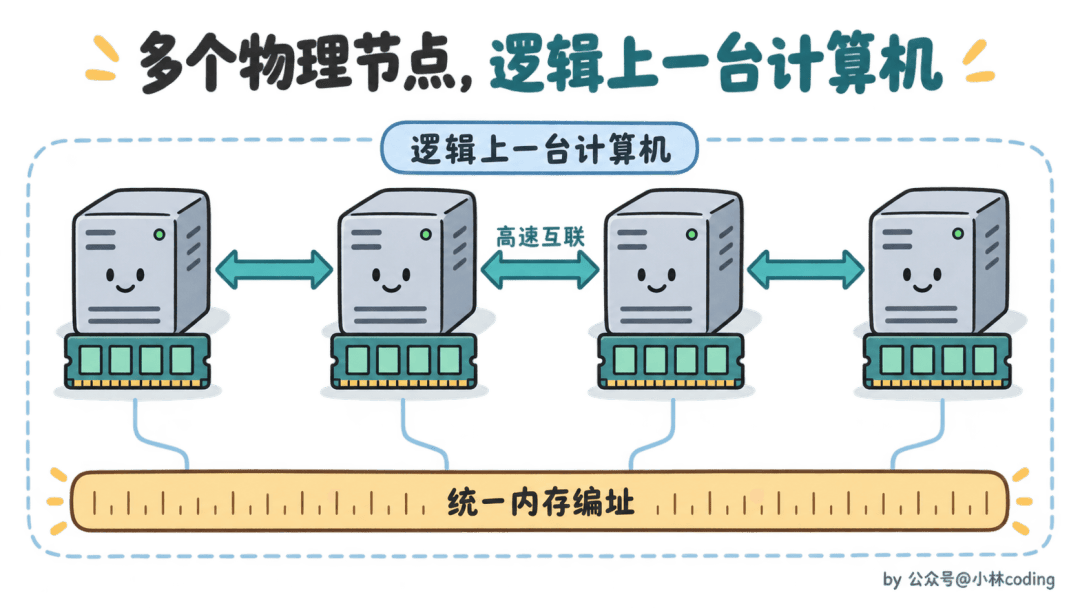
超节点要做的,是把多个物理节点紧密连接起来,通过高速互联和跨节点统一内存编址,让它们在逻辑上更像「一台计算机」。开发者面对的不再是一堆彼此割裂的设备,系统也能统一管理计算、内存和通信资源。
这次华为全联接大会2026中,Atlas 950 SuperPoD 面向液冷数据中心和大规模模型训练、推理场景,继续抬高大规模算力的上限。
那已有的通用风冷机房怎么办?Atlas 850E 采用风冷形态,让企业无需先做液冷改造,也能部署超节点,降低了基础设施改造的门槛。
但硬件连在一起,只完成了第一步。
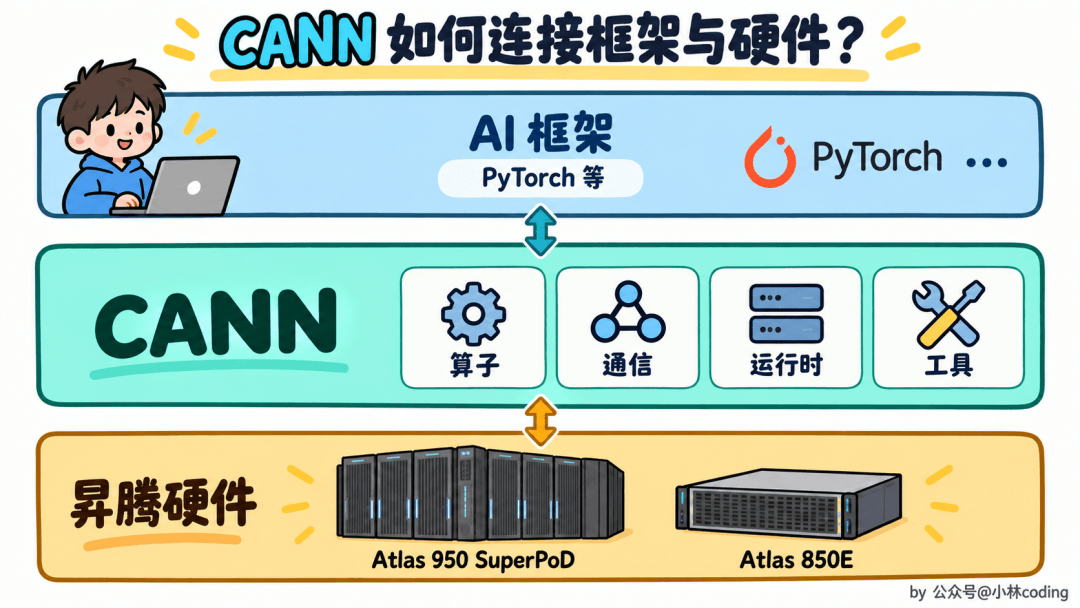
模型真正运行时,算子怎样调用计算单元,数据怎样搬运,任务怎样调度,训练与推理怎样协同,都需要基础软件共同配合。昇腾的基础软件包括 CANN、AI 框架和 Mind 应用使能层。开发者通过熟悉的 AI 框架组织模型计算,Mind 系列提供训练、推理和开发工具等支持,CANN 则负责连接框架与底层硬件。
CANN 可以理解成这套基础软件的基座。它向上支持 PyTorch 等主流 AI 框架,向下把计算任务交给昇腾硬件执行,覆盖驱动、运行时、算子编程、算子库、通信库和开发工具等环节。这次 CANN 开源开放的关键,也在这里。底层运行调度到上层编程开发的核心组件被打开以后,开发者和伙伴才有机会理解、使用和继续优化这些能力。
所以我更愿意把昇腾超节点和整套基础软件放在一起看。超节点解决「算力能做到什么」,基础软件解决「开发者怎样把它做出来」。少了后者,前面的统一内存和高速互联很容易停留在参数表里。
────03|从好用到易用,具体变在哪里?────
说到「易用」,最怕的就是只剩下一句口号。
那不如沿着一个开发任务往下看。开发者刚接触一套计算平台时,第一道门槛往往不是写代码,而是找到正确的资料和版本组合。昇腾这次把资料入口按照训练、推理、推荐和算子等场景重新组织,同时提供智能搜索与版本配套查询。
这些变化听起来没有算力数字那么亮眼,但做过环境配置的同学应该懂。很多时候,真正消耗人的不是一个高难度问题,而是十几个「这个版本到底能不能配那个版本」的小问题。
现在不少开发者会把环境配置交给 Agent,但 Agent 也需要清楚的资料作为依据。昇腾把资料按场景组织起来,理清版本配套关系和操作步骤,既方便开发者查找,也有助于 Agent 读取、理解,并用于环境准备。资料设计对 Agent 更友好,也是在帮助开发者减少配置环境时的摸索。
再往下,就是更专业的算子开发。
算子可以理解成大模型计算里的基础积木。模型中的矩阵计算、激活函数和通信操作,最后都要落成硬件能够执行的算子。算法更新得越快,新的算子开发和适配就越频繁,这类工作过去又很依赖底层硬件知识和工程经验。
昇腾为 Agent 辅助开发提供了可复用的 CANNBot skills( https://gitcode.com/cann/cannbot-skills),把算子开发等任务需要的专业知识和操作流程组织成技能模块。
开发者准备好相应运行环境,在 AI 编程工具中加载所需 Skills,就可以用自然语言描述算子需求,让 Agent 调用对应技能,参与需求分析、代码生成和迭代优化。
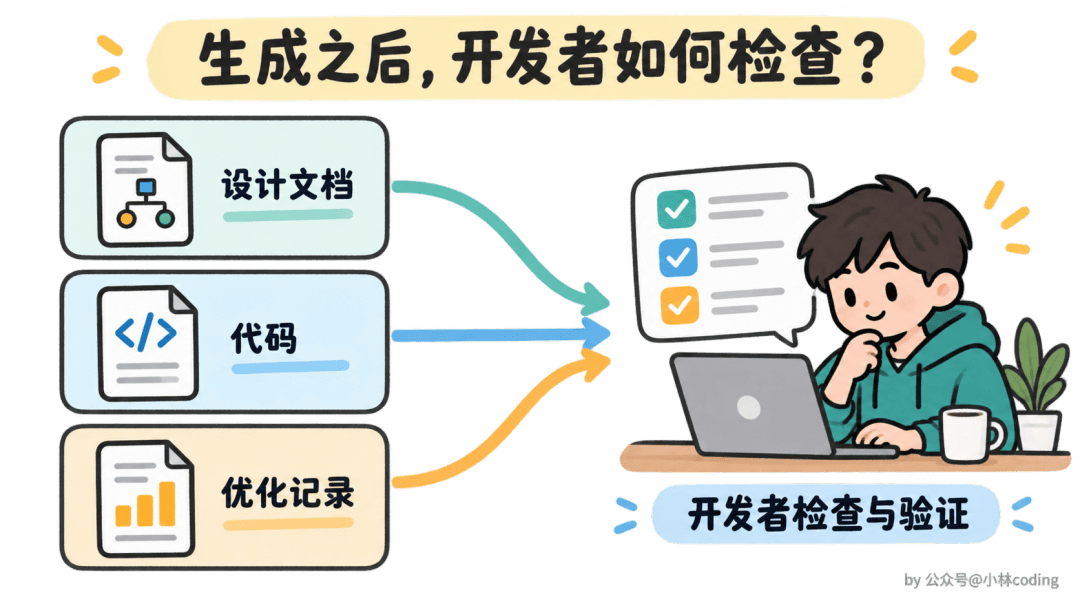
这类开发过程也不只留下最后一份代码。算子设计文档帮助开发者理解方案,生成的代码可以继续检查和修改,Agent 做过哪些优化也可以追溯。
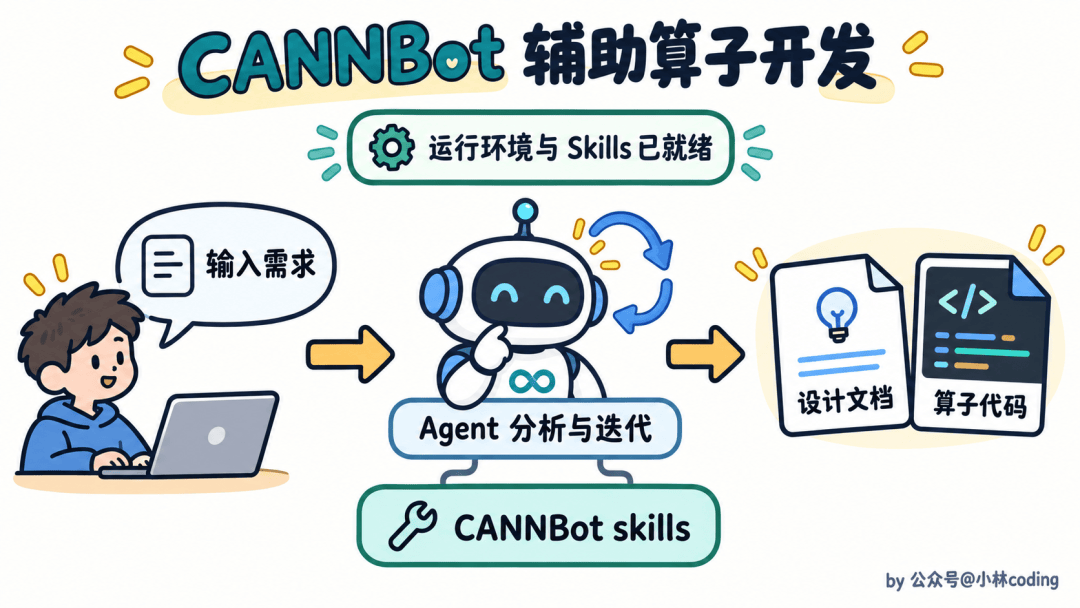
你看,这里真正发生变化的,并不是把一个「生成代码」按钮放到开发工具里。
算子开发原本依赖专家脑中的经验。现在,这些经验开始被拆成模板、插件和 Skills,Agent 再按照任务去调用。开发者面对的入口从底层指令和复杂配置,变成了需求描述与过程确认。
这有点像 AI 编程从应用层继续往下走。以前 Agent 帮我们写接口、补测试,现在它开始参与环境配置、算子设计、编译和调优。越靠近底层,对结果可控性的要求就越高,所以只会生成还不够。
设计文档让开发者知道方案准备怎么做,代码可以继续检查和修改,优化过程能够追溯。说实话,我更在意这些能力,因为它们决定了 Agent 是一个黑盒代劳工具,还是一个可以协作的工程助手。
当然,易用也不等于所有人都能跳过专业知识。算子最终能不能正确运行,性能是否达到要求,仍然需要测试和验收。变化在于,开发者不用再从空白页面开始,也不用把时间都耗在重复操作上。
同样的思路也出现在工具链里。MindStudio Agent 用于算子、训练和推理场景的问题定位与调优,InSight 2.0 把 Agent 与可视化性能分析结合起来。百卡、千卡集群里的性能问题,过去要靠工程师逐条看日志、逐帧分析,现在工具开始帮助开发者从海量数据中定位瓶颈。
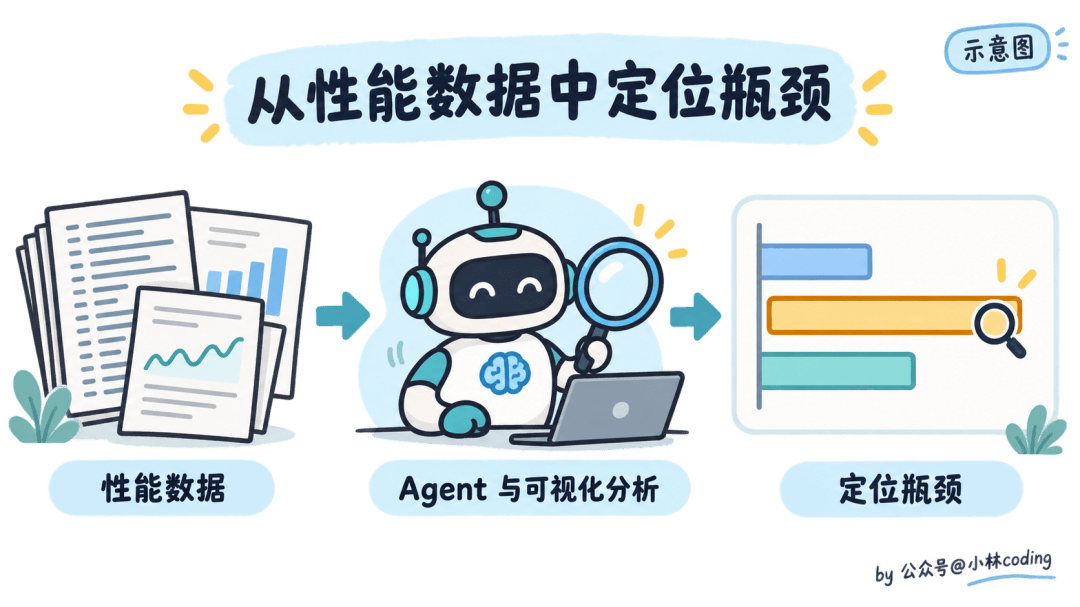
到这里,「从好用到易用」就不再抽象了。开发者可以沿用熟悉的框架,通过文档和版本工具减少准备成本,再让 Agent 参与高门槛任务,同时保留检查、修改和验收结果的入口。
────04|开源共建,为什么比开放代码更进一步?────
看到这里,还有一个问题,工具做好了,跟开源共建有什么关系?
代码仓库公开,当然是开源的第一步。但开发者真正需要的,是这些代码能进入自己熟悉的框架和工具链,版本有人持续维护,遇到新模型、新算法时也能继续演进。
Mind 系列向开源社区贡献能力的三个例子,正好能把这件事讲清楚。
训练侧,MindSpeed 把 「AsyncFlow 异步流式RL 」特性贡献给强化学习框架 verl。据昇腾介绍,这一优化带来了近 2 倍的训练性能提升。这里沉淀下来的不只是一段实现代码,还包括昇腾在训练调度和并行优化上的经验。
推理侧,MindIE 把 PCP/DCP 算法贡献给 vLLM,昇腾给出的优化结果是首 Token 时延,也就是 TTFT,降低 50%。对推理服务来说,用户发出请求以后多久看到第一个 Token,会直接影响交互感受。这项优化进入 vLLM 以后,开发者可以沿着熟悉的推理框架使用它。
工具侧,MindStudio 把 Profiling 和可视化能力贡献给 verl,补上强化学习开发中缺少易用性能分析工具的环节。算法能跑是一回事,出了性能问题能不能看见、能不能定位,又是另一回事。
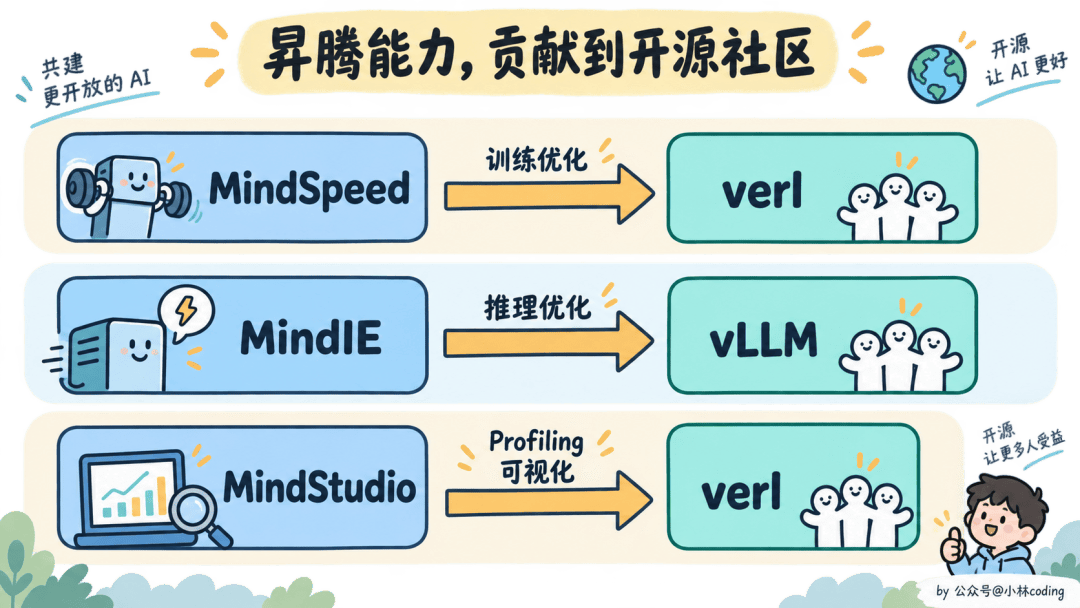
这三个例子分别落在训练、推理和开发调优,刚好构成了一条完整链路。
更值得关注的是能力流动的方向。过去讲生态适配,通常是让一套硬件支持更多框架。现在,昇腾也在把经过验证的亲和能力贡献回上游社区。开发者不必先离开原来的技术栈,再重新学习一套封闭工具,很多能力可以在熟悉的开源项目中直接获得。
这才是开源共建对「易用」的长期价值。
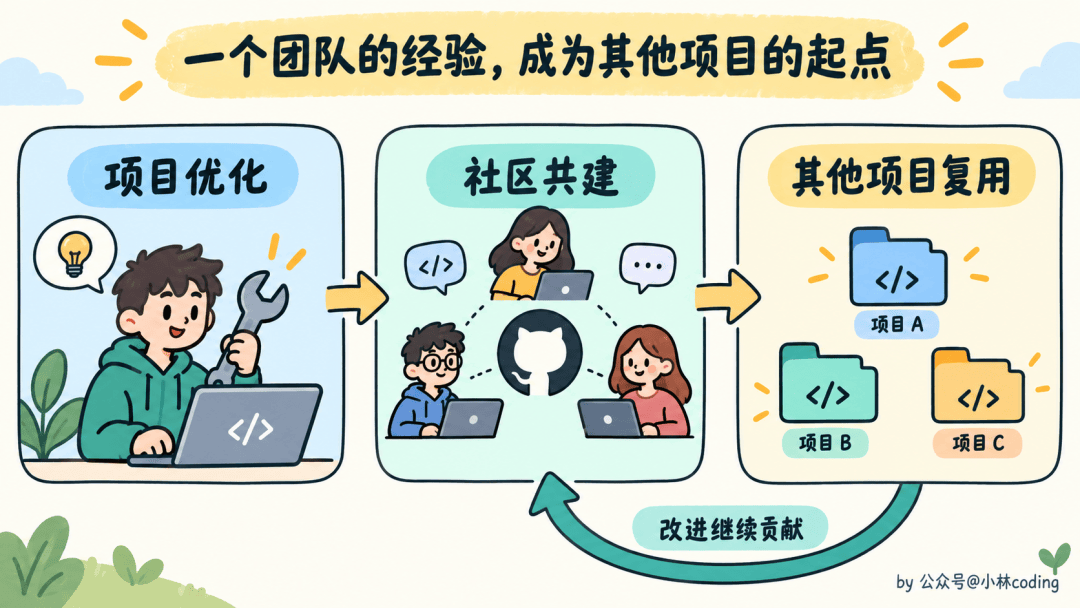
一个团队解决过的问题,经过整理、测试和上游贡献,可以变成其他团队的起点。框架、算法和工具在社区里持续被使用,问题也更容易暴露,改进结果还能继续回到下一轮开发。专业经验不再只留在少数专家和单个项目里。
据昇腾介绍,CANN 已累计开源 79 个仓库,开源代码超过 3700 万行。数字能说明社区规模,但我觉得更关键的指标,还是外部开发者能否用起来、改起来,并把改进继续贡献回来。
昇腾与 PyTorch 的合作也能看到类似方向。从单向支持适配框架,到 Ascend NPU上线 PyTorch 官网,再到测试与 CI/CD 全量共建,关系开始从单向适配走向深度共建。对开发者来说,这意味着昇腾能力已融合成日常使用的技术栈。
────最后────
回到开头那个问题,开发者要花多大力气,才能把算力真正用起来?
这次华为全联接 2026 上,昇腾超节点展现了更强的计算能力,而 CANN 与 Mind 系列软件的进展,让我们有机会从开发者的角度衡量这些能力。准备环境时能不能少走弯路,开发算子时有没有现成的模板和工具,遇到性能问题时能不能找到原因,这些都应该算进一套计算系统的竞争力里。
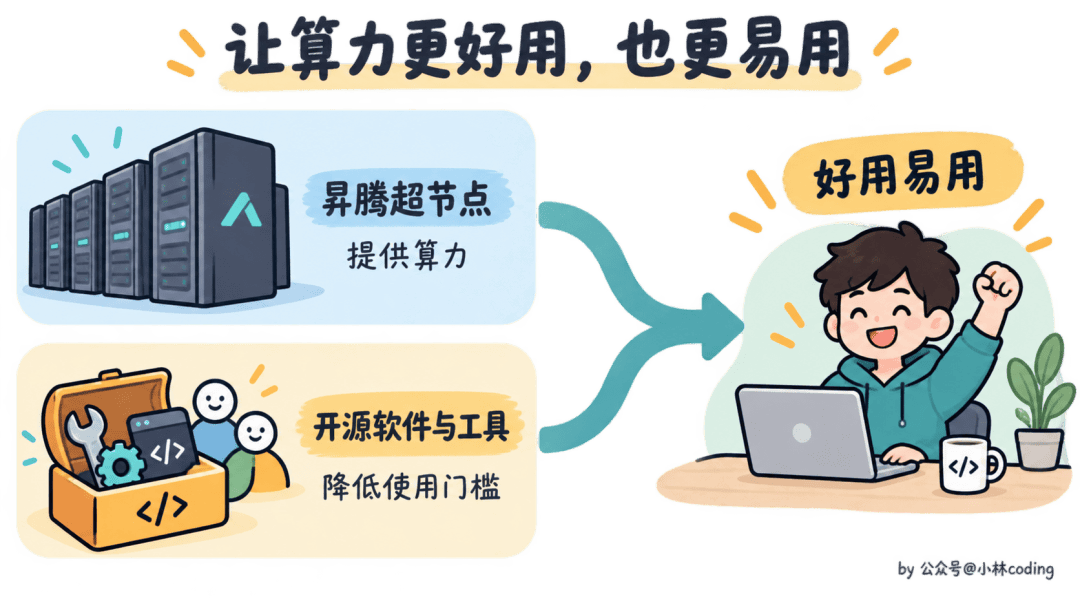
我觉得,昇腾从「好用」走向「易用」,最值得关注的就是这种变化。开发者可以借助已有的组件、Skills 和社区经验推进任务,把更多精力留给模型和应用本身。专业知识依然重要,但获得这些知识、把它们用到项目里的方式,正在变得更方便。
开源开放让这种变化有了持续积累的可能。一个团队做出的算子优化、一套调优方法,经过验证和社区共建,可以被下一个项目接着使用和改进。
对开发者来说,这样的生态才值得长期投入。今天解决的问题,能成为明天的起点,下一次面对新模型、新需求时,就能少做一些重复工作,多试一些自己的想法。













