

林晓今天盯到迈阿密大学和哈佛挂在arXiv:2609.35540的一篇第三方研究:教智能体「边干边记重点」。每走一步只更新一段短记忆,下次提示词只留任务、记忆和最新观察,不再堆完整对话。先说清楚:这是高校训练技巧,不是阿里对千问的官方产品更新。
图1:迈阿密与哈佛短记忆管理:每步只留任务、短记忆与最新观察(论文arXiv:2609.35540 Figure 1)
他们先在免微调场景测了Claude Sonnet 4.6、Claude Opus 4.6、智谱GLM-5和Kimi K3。四个模型累计输入大约砍掉83.1%、81.5%、84.3%和75.8%;峰值提示中位数从约9472–17560降到约3243–4280。多数成功率会掉一点,但Kimi K3反而从62.9%微升到64.0%。没有提示缓存时,GLM-5单任务估算成本从约0.515美元降到约0.124美元。数字按论文自报。
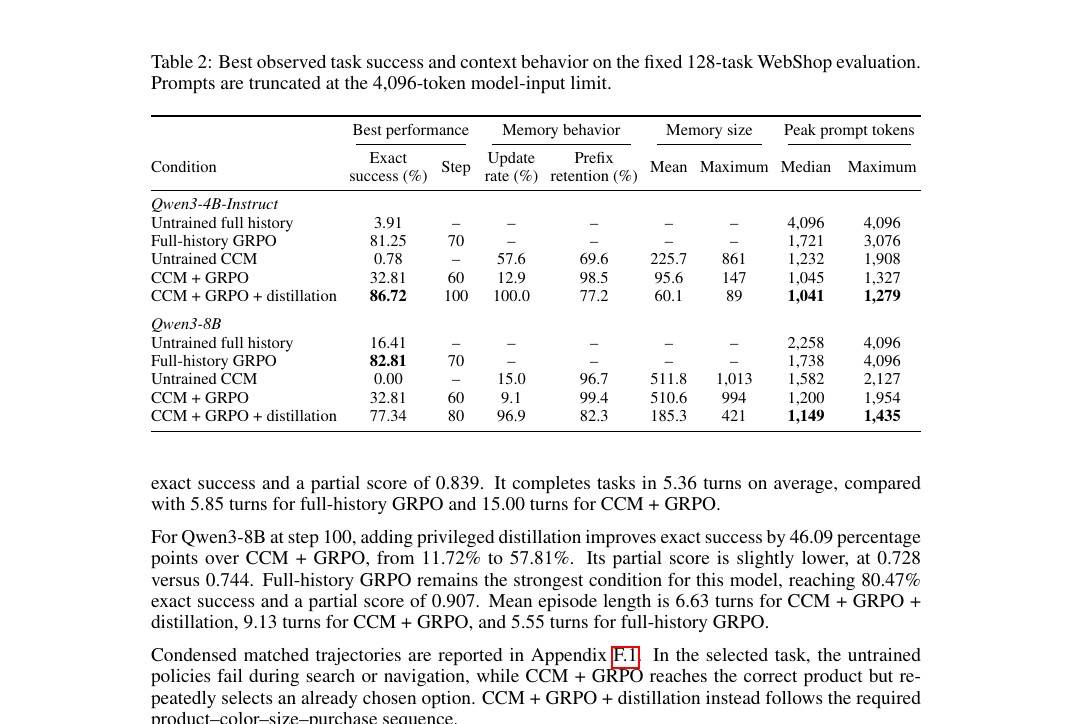
图2:千问3-4B在WebShop上,压缩记忆加蒸馏成功率86.72%超过全历史训法(arXiv:2609.35540 Table 2)
开源小模型更抓眼。团队用强化学习再加「特权全历史蒸馏」训千问3-4B。在固定128题的网购任务WebShop上,只做压缩记忆时精确成功率约32.81%;加上蒸馏后飙到86.72%,超过保留完整历史的同类训练约81.25%。累计输入从约10636降到约3720,大约少65%。千问3-8B上蒸馏也把压缩记忆成功率从约32.81%提到77.34%,不过完整历史训练仍略高一截。
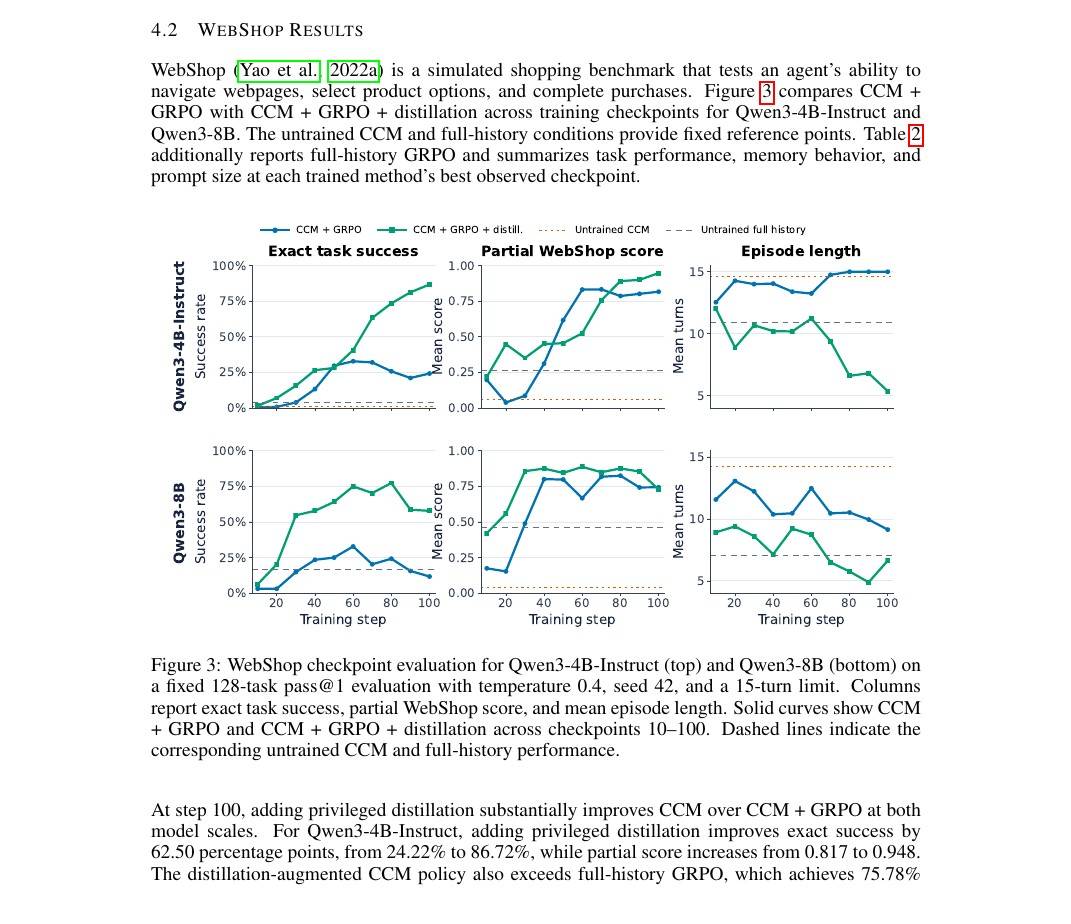
图3:千问3在WebShop训练过程中成功率与回合数变化(论文arXiv:2609.35540 Figure 3)
对普通人来说:智能体不必把整段对话全塞回去,记重点也能把小模型网购准率干翻全历史训法。再强调一句:第三方高校研究,不是阿里发新千问。完整方法与表格以arXiv:2609.35540原文为准。













