

一张纸质报表、一张扫描表单,拍张照片,就能直接变成可编辑、可计算的Excel 表格。很多人以为这只是简单的拍照识字,实际上,把图片里的表格完整还原,是文档智能领域实打实的 “硬核黑科技”。
我们日常接触的传统OCR,擅长把图片里的文字抠出来,但面对表格经常 “翻车”:合并单元格直接错位,没有框线的表格变成一大段杂乱文字,多级表头彻底乱套,文字全都识别出来,行列关系却全部丢失。中科逸视(北京)科技有限公司表格识别技术,跳出单纯文字提取的思路,模拟人阅读表格的思考方式,先看懂表格骨架,再读取单元格内容,把一张静态图片,转化为真正能用的结构化数据。
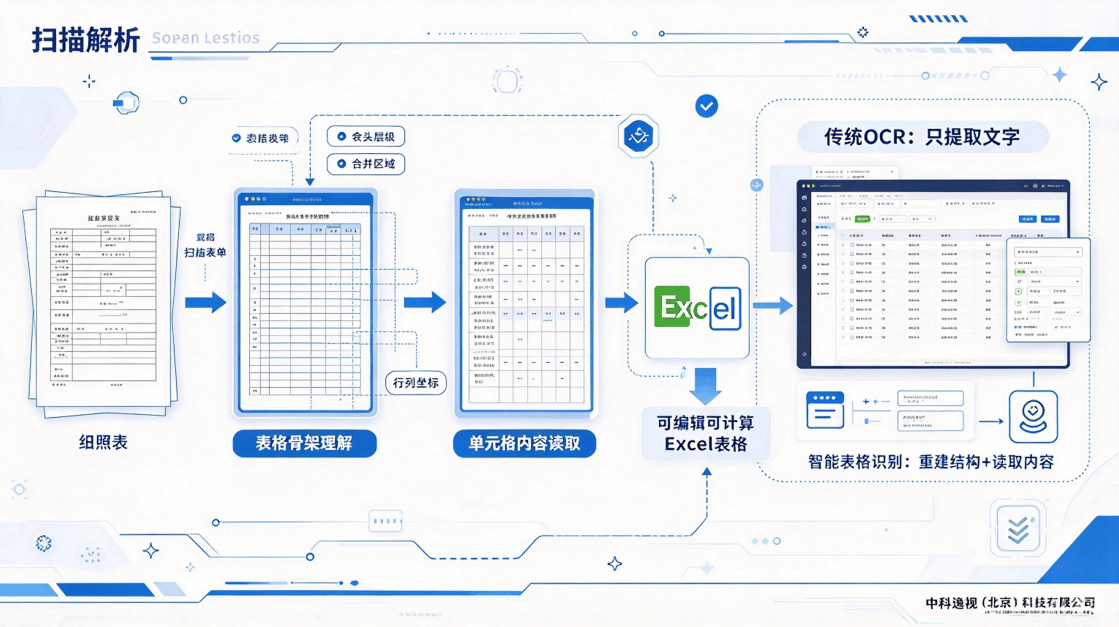
技术原理:从像素点阵,重建一整张表格的逻辑
表格识别不是某一个单一算法,而是一条完整的AI 处理流水线。整套技术融合图像增强、深度学习目标检测、像素级分割、图网络拓扑推理、OCR 文字识别、大模型语义校验多个模块,一步步把照片里的表格 “翻译” 成机器能够理解的表格结构。
第一步:图像预处理,给原始材料“修图纠错”
现实拿到的原始素材五花八门:手机随手拍摄会倾斜变形、纸张泛黄有污渍、灯光造成阴影反光、扫描件分辨率低字迹模糊。
在正式识别之前,算法会先完成图像修复。通过透视校正把歪掉的表格掰正,去除纸张噪点、优化明暗对比度,对模糊文字做增强修复,把褶皱、变形的表格图像,矫正成适合AI 解析的干净版本。这一步就好比我们看书前,先把卷边、歪斜的书页摊平,保证后面看得清楚准确。
第二步:版面定位,从一页文档中锁定表格区域
一页文件里混杂标题、段落、印章、图片、多个表格。AI 不会通篇盲目解析,而是通过深度学习检测网络,扫描整张图片,精准圈出哪些区域属于表格,哪些是普通文字段落。哪怕一页纸上嵌套好几个小表格,也可以逐个分离,避免正文文字混入表格结果当中。
第三步:结构解析,整套技术最核心的“黑科技环节”—— 重建表格骨架
认字容易,还原表格骨架才是最大难点。很多表格不全是完整实线:有的只有空白空格分隔(无线框表格),有的大量跨行跨列合并单元格,还有斜线表头、表格套表格的复杂版式,肉眼看着清晰,机器却很难分辨边界。
中科逸视表格识别在这里采用像素级分割+ 图神经网络联合推理的方案:
- 像素分割网络把表格图像拆解,找出每一根横、竖线条;遇到没有线条的无线表格,就根据文字的间距、对齐规律,凭空推断出看不见的虚拟单元格边界,就像人看到整齐对齐的文字,心里自动脑补出表格网格;
- 把每一个单元格当作独立节点,通过图网络计算单元格之间上下、左右的邻接关系,自动识别合并单元格、跨行跨列,分清哪一部分是表头,哪一部分是表格主体;
- 大模型辅助做语义校验,结合文字含义修正结构错误,避免只看线条造成的逻辑错位。
简单来说,这一步AI 不再只看画出来的线,而是看懂表格背后的排布逻辑,把乱糟糟的图像,重建出一套完整的虚拟网格框架。
第四步:单元格文字识别,把图像符号转为文本数字
网格框架搭建完成后,系统才对每一个小单元格单独做文字识别。针对印刷字、数字、符号、部分手写内容完成提取,区分日期、金额、编号等不同类型内容,保证每一段文字、每一组数字,精准归属到对应的行和列,不会出现内容“跑错格子” 的情况。
第五步:结构化输出,还原成可用数据
全部解析完毕,再把网格结构+ 单元格内容整合,输出 Excel、JSON 等格式,保留原本的合并单元格、层级表头,实现从图片文件到可编辑表格的完整转换。
整套流程和人阅读表格逻辑一模一样:摊平纸张→找到表格位置→看清行列布局→读取每个格子的内容,只不过 AI 在毫秒之间完成整套复杂运算。
功能特点:搞定现实世界五花八门的表格
复杂表格高保真还原
- 不局限标准规整表格。可以处理无线框表格、残缺线条、合并单元格、多级表头、斜线表头、嵌套子表格。不会简单粗暴把大的合并单元格拆碎,最大程度保留原始表格的逻辑关系,而不是只输出一堆零散文字碎片。
兼容低质量真实业务素材
- 不用依赖高清完美扫描件。手机拍照、老旧档案扫描件、泛黄复印文件、轻微褶皱倾斜的材料,都可以稳定识别,适配真实办公场景,而不是只能在理想样例下工作中科逸视。
多语种混合识别能力
- 支持中文、英文混合,同时兼容少数民族语言表格文档,处理多语言混杂排版的表单,适配档案、跨境业务的文档处理需求。
多格式输出,拿来就能直接用
- 识别结果直接导出可编辑Excel,保留单元格合并格式,同时支持 JSON 结构化数据输出。导出后的文件可以直接做统计、公式计算、数据入库,不用再二次手动调整排版。同时支持大批量 PDF、图片文件批量处理,提升处理效率。
可快速集成落地
- 以API 接口形式对外提供能力,可以嵌入业务系统,不需要工作人员来回切换软件,直接在政务、财务、档案原有业务系统内部完成表格解析,适配企业与机构的系统改造需求。
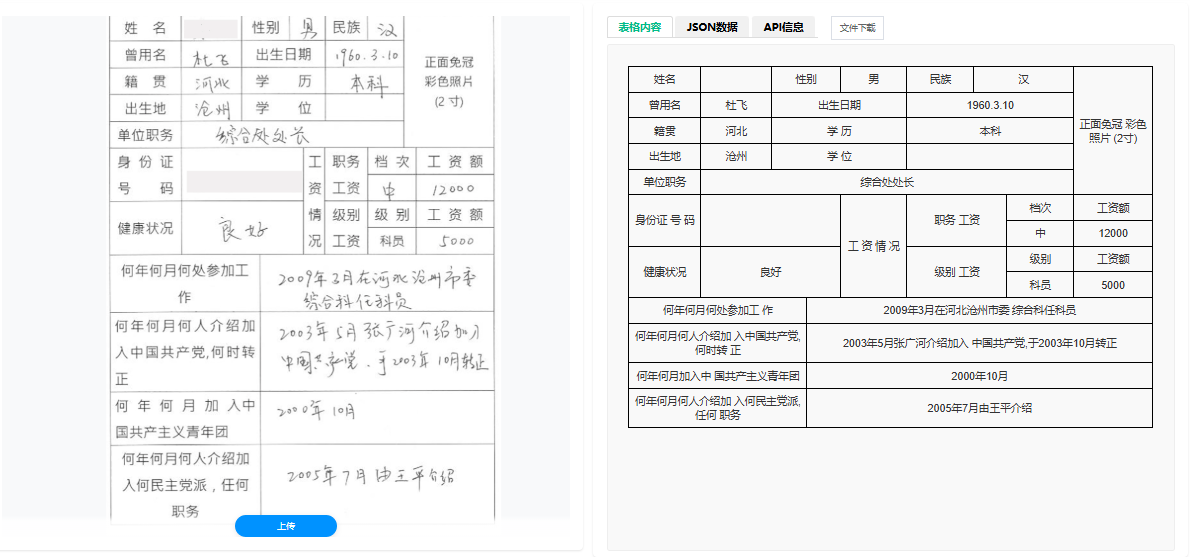
应用领域:把海量纸质表格,变成流动的数据资产
大量机构手里堆积海量纸质、扫描版表格,过去只能靠人工逐行录入,耗时耗力还容易出错。表格识别技术,就是帮各行各业把沉睡在图片、纸张里的数据释放出来。
金融与财务
- 银行流水、对账单、保险保单、财务报表、报销单据。自动提取表格内金额、时间、科目信息,减少财务人员手工录入,辅助风控审核、财务对账。成堆的报表不再需要人一格一格敲进Excel,大幅降低重复劳动与人为出错概率。
政务与档案数字化
- 政务申请表、企业年报、历史档案表单、人口统计表格。档案电子化项目中,大量老档案表格线条残缺、纸张老化,技术可以把纸质档案批量转为结构化电子表格,支撑一网通办、档案检索,窗口业务材料扫描后自动提取表格信息预填业务系统,提升办事效率。
医疗健康
- 检验报告单、体检报告、病历表单。提取化验单内各项检验指标,把报告表格结构化,方便病历系统录入、科研数据汇总,省去医护人员手动抄写指标的工作。
企业办公与科研教育
- 合同附件附表、统计调研问卷、实验数据表格、论文附表。调研统计、科研实验产生大量纸质表格,拍照扫描即可转为电子表格,方便后续统计分析。
很多人以为AI 表格识别,难点在于 “认识字”。真正的门槛,是读懂看不见的逻辑。
中科逸视表格识别技术的黑科技,不在于酷炫概念,而是解决现实文档里千奇百怪的表格难题:线条不全、纸张老旧、版式五花八门。它把过去必须人工完成的表格誊录工作交给AI,让堆积如山的纸质表单,从一张张静态图片,变成可以检索、计算、流转的数据资产,实实在在降低各行各业数字化的门槛中科逸视。












