


做 AI 产品的人,大概都经历过这个阶段:拼命给 AI 加能力。
加一个工具,它能多干一件事;再加一个,它能多接一类需求。加到几十个的时候,你会觉得"我这产品真强大"。
然后用户问了一句"帮我写个周报",AI 调了思维导图,又摸了一下名片生成器。
这不是段子,是我自己产品上个月的真实翻车现场。
一、先看数据:AI Agent 工具数量的临界点
翻车之后我查了资料,发现这是今年 AI 落地很普遍一道坎。
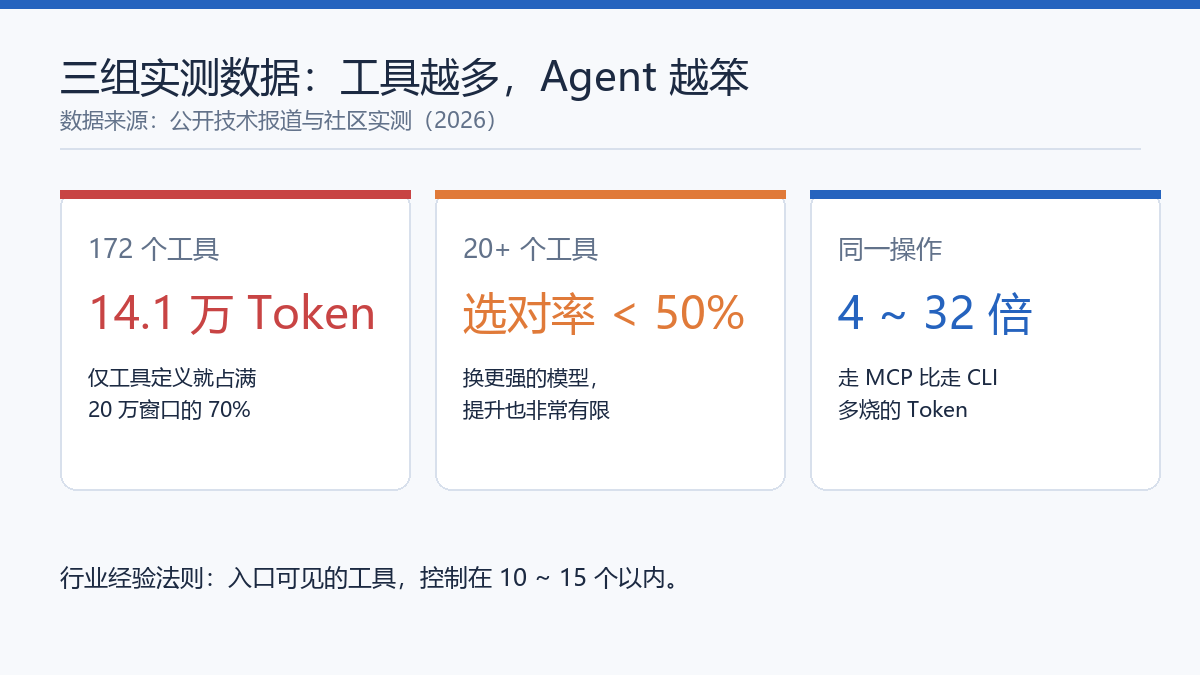
工具定义会吃掉大量上下文。 有工程师实测,给 AI 挂 172 个工具,光工具说明书就消耗 14.1 万 Token——20 万的窗口,七成用来"背说明书"了。
工具超过 20 个,选对率跌破一半。 有机构做过基准测试,可用工具超过 20 个时,AI 选对工具的概率低于 50%,而且换成更强的模型,提升也很有限。
工具越多,成本越高。 同一件事,走 MCP 协议比走命令行多消耗 4~32 倍 Token,因为几十个定义全塞进去了,实际只用到一两个。
业内的经验法则是:同时挂 10~15 个工具,就到头了。

二、根因:膨胀与混淆
为什么工具一多,AI 就"手忙脚乱"?两个词可以概括。
一是膨胀。 这类工具协议的工作方式是:任务开始前,所有工具定义预先注入上下文,不管这次用不用得上。结果就是——你只是想让助理订张机票,他先把公司通讯录、报销制度、打印机说明全背了一遍。
AI 的"脑容量"是有限的,无关信息塞太多,正事就想不清了。
二是混淆。 工具一多,语义边界开始打架。"文章生成器"和"文案优化器",改一段文案该用哪个?"数据提取"和"格式转换",把表格转 JSON 算哪类?
当 47 个工具里有 6 个都在"处理文本",AI 看到的就是"六个长得差不多的门,随便进一个吧"。
更糟的是,选错之后它会重试,重试又烧一遍 Token,两个问题互相喂,越滚越糟。
三、三个解法

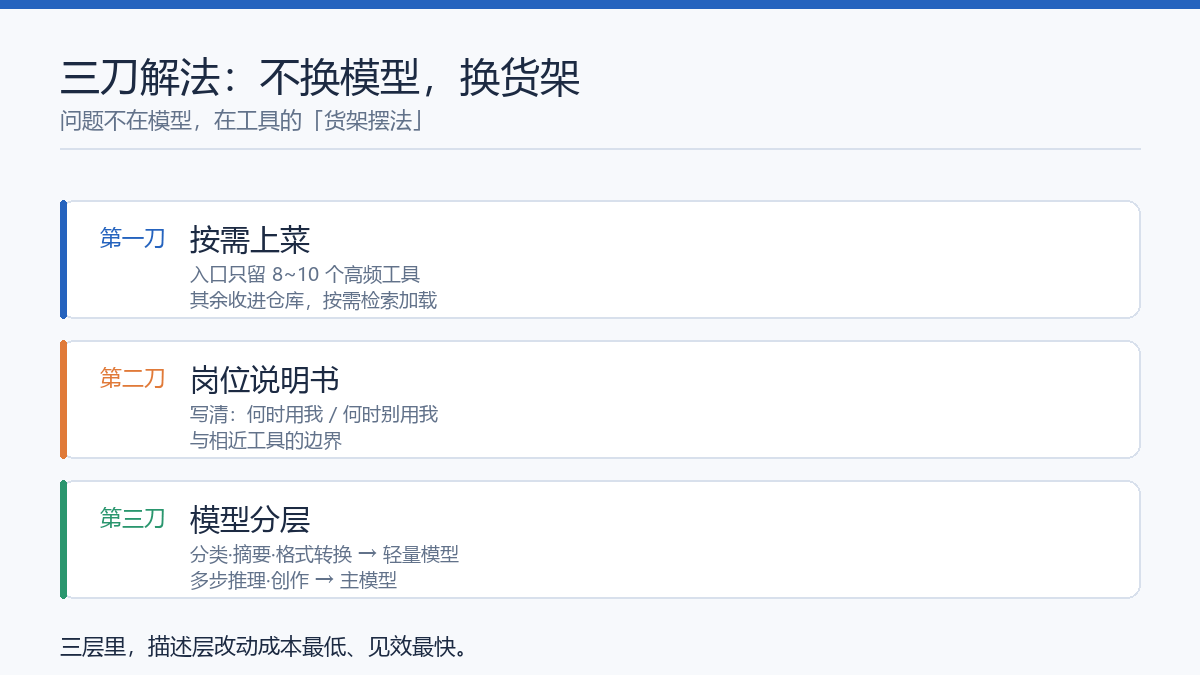
第一,按需加载,别全量供应。 入口只留 8~10 个高频工具,其余收进仓库,需要时再取。业界叫渐进式加载(progressive disclosure),有实测显示,开启后 172 个工具的初始消耗可从 14.1 万 Token 降到接近 0。
第二,把工具说明写成"岗位说明书"。 写清楚三件事:什么场景用我、什么场景别用我、我和相近工具的边界。很多人写的是给人看的广告词——"强大的智能处理能力",这对 AI 来说基本是噪音。
第三,小模型干杂活。 分类、摘要、格式转换这类确定性任务,交给轻量模型;多步推理、内容创作交给主模型。成本和时间都能明显下降。
四、别忽略的两个问题
按需加载会多一道检索手续,简单任务反而慢一点点,这是"省 Token"和"省时间"的取舍。
工具说明是活文档,工具越多,维护成本越高。工具治理是持续运营,不是一次性工程。
五、跳出 AI 看这件事
有意思的是,这套东西在企业系统里早就有名字——服务治理。
工具定义膨胀对应服务爆炸,工具语义混淆对应接口职责不清,按需加载对应服务发现,岗位说明书对应接口文档。
技术换了皮,但"复杂度治理"的规律没变。能力爆炸导致系统不可用,这个坑二十年前就有人踩过。
所以别指望"换个更强的模型"来解决工具选择问题——模型能力是外部的,工具治理是你自己的。
写在最后
做 AI 产品,一半在设计 AI,一半在设计 AI 看到的世界。
模型再强,你递给它 47 个搅在一起的线头,它也只能揪出一根错的。
工具不是挂得越多越强。就像团队不是人越多越能打,清晰的分工才是战斗力。











