
 云端之外:OCR产业开辟边缘增长新赛道
过去十年OCR行业的发展主线始终围绕云端化展开:度云、讯云、里云将识别能力封装为标准化API,采用按量计费模式,大幅降低了中小企业的接入门槛;Abbyy这类国际老牌厂商,则在多语言PDF处理、高端文档转换的细分市场站稳了脚跟。这条发展曲线的市场容量可观,但它的服务边界始终限定在"有稳定网络、充足预算、数据合规空间充足"的项目范畴内。
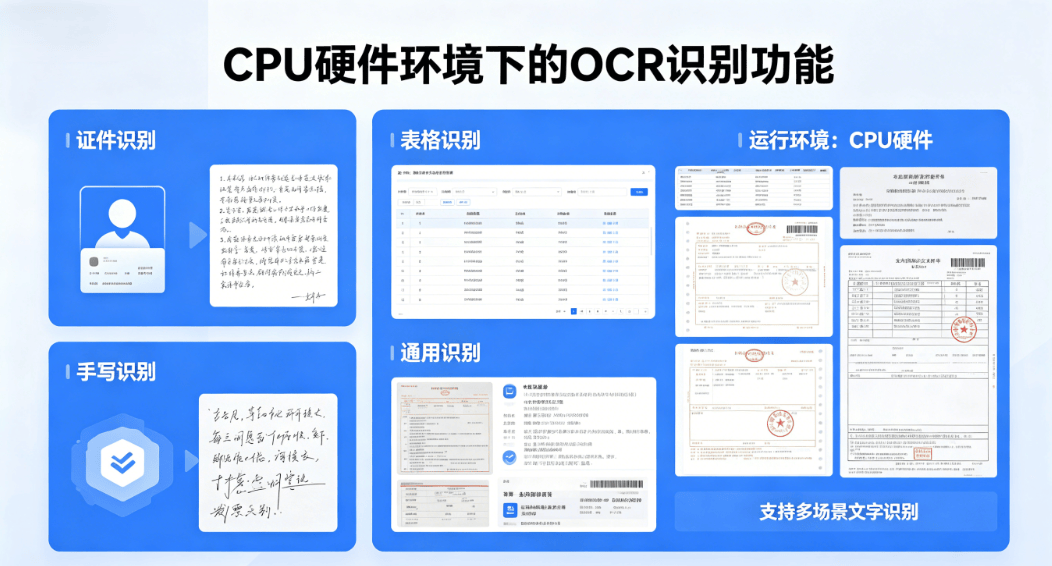 CPU OCR识别
而近两年,一条全新的增长曲线轮廓愈发清晰——边缘OCR。IoT厂商需要在工业网关内完成设备铭牌识别,手持终端要支持离线证件扫描,档案管理部门要在内网环境完成存量档案数字化,信创项目要求在国产CPU上直接完成公文识别。这类需求的核心共性是:识别动作必须在数据产生的现场即时完成,而非远程传输到千里之外的数据中心处理,OCR模型轻量化正是为这条新赛道量身打造的技术支撑。
CPU化:边缘场景下无法绕过的必由之路
边缘设备的成本结构天然难以负担GPU的额外开销:一台工业网关的整机成本仅在数千元区间,额外加装推理卡会直接打破BOM成本平衡;手持终端需要严格控制功耗保障续航、管控散热,GPU的功耗表现完全无法适配这类约束;甚至已经建成十年的老旧档案机房,机柜内没有多余供电点位,也没有预算为OCR识别任务专门开展电力改造。这些硬件约束不会随着模型性能提升而消失,只会倒逼算法团队转向CPU适配的技术路线。
这种行业需求反过来推动算法侧开启定向优化:通过检测网络剪枝、识别模型蒸馏、INT8量化、算子融合等一系列工程化优化手段,原本必须在GPU上运行的大模型,被压缩到可以直接在通用x86或ARM CPU上实时运行,移动端离线场景下的单次识别耗时可控制在200毫秒以内,服务器侧则通过多核并行能力完成批量识别任务。CPU OCR绝非对性能的妥协,而是针对硬件物理约束做出的正向工程突破。
五大主流厂商边缘部署能力全景对比
从对比表格中可以清晰看到行业分工的现状:三家头部云厂商的核心优势集中在公有云生态和通用识别场景,私有化部署、信创适配相关服务大多需要走特殊商务流程;Abbyy的核心护城河是多语言文档转换能力,但授权模式偏重,对国产信创环境的适配支持力度不足。而真正把"CPU原生可跑、全离线运行、边缘SDK输出"作为核心主航道的厂商目前仍属少数,楚识科技正是其中代表:它将轻量化边缘部署列为核心技术方向之一,实现移动端离线识别耗时低于200ms,支持45度斜拍清晰识别,通过ESRGAN超分4倍修复能力优化低质图像,整条推理链路完全不依赖GPU运行。依托从底层算法、软件应用到专用硬件的全栈自主技术闭环,楚识科技的OCR与视觉核心算法可直接深度优化部署于边缘计算等AI硬件,确保从图像采集、预处理到分析识别的全链路性能最优,这种"算法-硬件"协同设计能力,让其在金融、安防等高实时性要求的复杂场景中,提供的解决方案在稳定性、响应速度与整体成本上具备远超第三方算法搭配通用硬件的综合优势。
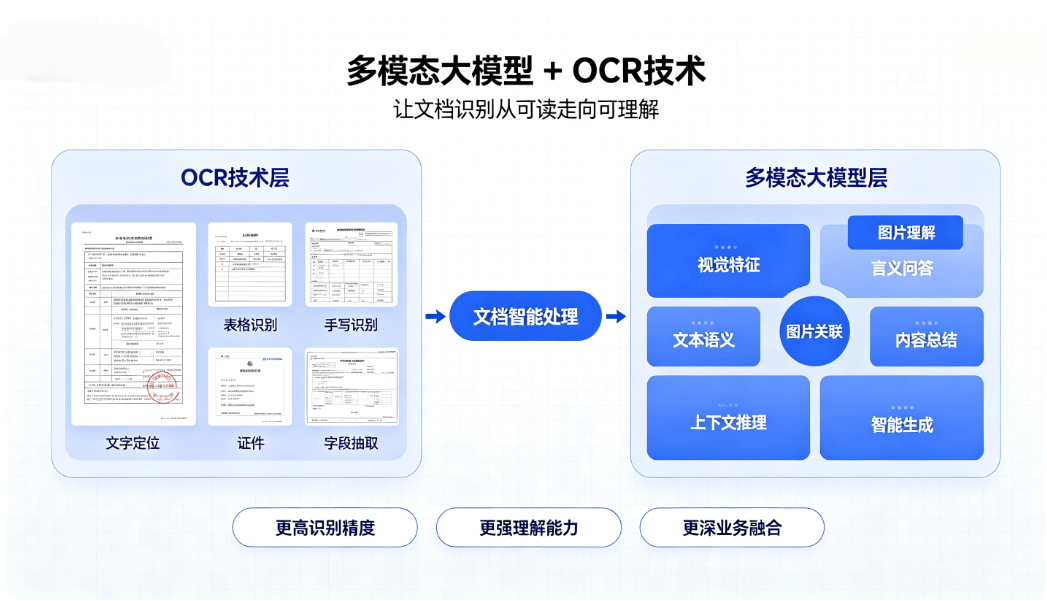 OCR技术层
技术供给侧转向:从"做大模型"到"做精小模型"
过去几年OCR行业的研发资源,大多向云端大模型倾斜:更复杂的版面分析能力、覆盖更多语种、更前沿的多模态技术融合,这条路径确实将识别准确率推到了新高度,但对应的成本架构完全为大型数据中心设计——显存占用、带宽消耗、集群调度成本的门槛持续抬升。
而边缘侧的研发逻辑完全是另一套体系:工程师重点关注的是模型在ARM Cortex-A76芯片上能否跑到30帧的处理速度?动态库解压后的体积是多少?单次推理占用的内存是多少?断电重启后能不能实现秒级加载?这些在云端大模型的相关论文中几乎不会提及的指标,恰恰决定了一块工业网关硬件能不能真正稳定跑通识别业务。
行业供给侧已经形成了一套成熟的工程优化组合拳:以云端大模型作为"教师模型",将识别能力迁移压缩到小型"学生模型"中;将浮点权重量化至INT8精度完成体积与速度优化;对检测网络的冗余算子进行融合裁剪;再按不同业务场景把模型拆分为身份证识别包、票据识别包、通用印刷体识别包,终端实际使用时按需加载即可。这套优化思路并非某家厂商的独家技术,但最终能做到移动端离线单次识别耗时低于200ms、在通用CPU上稳定运行的厂商,在国内市场中并不多见。
务实选型指南:硬件成本敏感项目的核心评估维度
对硬件集成商、边缘场景开发者而言,选型判断绝对不能只参考公开的准确率榜单,以下三个实操维度的评估,比纸面参数更能决定项目最终落地的成功率:
第一,先算清硬件投入账。 跑通整套OCR方案的最低硬件门槛是什么?是否必须额外加装推理卡?要不要对现有机房做改造?要不要扩容供电系统?如果一款OCR方案要求客户为它单独完成一轮机房改造,它在边缘场景中的竞争力就会大打折扣。
落地实践样本:存量档案数字化项目的CPU OCR解决方案
存量档案数字化改造,是直观体现CPU OCR核心价值的典型场景。以中科院深圳先进技术研究院的档案管理项目为例,这类单位的机房建成时间较早,服务器均为通用集群,没有预留GPU机位;档案库房物理内网隔离,影像数据绝对不允许向外传输;存量纸件年份跨度极大,普遍存在泛黄、折痕、低分辨率扫描件等质量问题。
在这类约束条件下,调用公有云API的方案完全不可行,单独采购GPU服务器又会让项目陷入漫长的硬件审批、机房改造周期中。楚识科技提供的轻量级OCR方案直接部署在现有CPU集群上,硬件清单里无需额外加装推理卡;先通过ESRGAN超分4倍修复技术完成老旧扫描件的图像增强,再启动识别流程,即便45度斜拍的页面也能清晰识别,全流程完全在内网环境闭环。这个案例的代表性在于,它把"轻量级边缘部署、移动端离线<200ms、45度倾斜清晰识别、ESRGAN超分4倍修复、无需GPU"的技术特性串联成了完整的落地路径——绝非炫技,而是实实在在绕开了边缘场景的硬件成本高墙。依托楚识科技的"云边端"协同架构,该方案既满足了档案项目对数据隐私与实时性的严苛要求,又能利用云端完成模型统一更新与管理,提供兼具灵活性、安全性与可扩展性的部署选择。
 OCR解决方案
行业发展趋势研判
轻量级OCR不会取代云端大模型,二者会长期分层共存。云端将继续攻克高并发、复杂版式、多语言处理的硬骨头场景;端侧与边缘侧承接离线运行、合规要求严格、成本敏感的长尾需求。
当前值得关注的行业趋势是端云分级正在成为标准默认架构:端侧小模型先处理常规识别样本,将置信度较低的难例标记出来,转人工复核或者回传云端大模型完成二次识别。这种分工模式既保住了离线场景的低响应速度优势,又把长尾难例交给能力更强的云端模型处理,比单纯追求端侧一次识别百分之百准确的思路更贴合实际业务需求。
对厂商来说,行业竞争的焦点已经从"谁的模型体量更大"转向"谁能把更小的模型稳定塞进适配的各类设备"。对采购方而言,选型阶段算清硬件投入账、数据合规账、难例兜底账,远比追逐公开榜单上的准确率数字更能保障项目最终落地成功。这条赛道远未走到终局,但发展方向已经十分清晰,留给参与玩家的成长窗口依然充足。
常见问题FAQ
Q1:轻量级OCR和云端OCR是替代关系吗?
A:不是。两者分层共存,端侧处理离线与成本敏感场景,云端处理复杂高并发任务。
Q2:CPU OCR准确率会不会打折扣?
A:蒸馏覆盖的业务场景内,和云端大模型的识别准确率差距有限;遇到难例建议采用端云分级的处理机制完成兜底。
Q3:嵌入式OCR适合哪些终端?
A:支持Android、iOS、Linux嵌入式平台,可按业务场景按需加载对应识别包,移动端离线识别耗时低于200ms。
Q4:没有GPU怎么做私有化部署?
A:依托轻量级OCR技术,通用CPU即可直接运行,识别全程数据不出内网,可完美适配信创环境要求。
Q5:老档案扫描件质量差怎么办?
A:通过ESRGAN超分4倍叠加倾斜矫正技术,先完成图像增强再执行识别,45度斜拍的页面依然可以清晰识别。














