

林晓今天翻到苹果和洛桑联邦理工挂在arXiv上的一篇对照实测(编号2609.40303):机器学习工程竞赛里,复杂多智能体外壳到底值不值?先说清楚——这是苹果与洛桑联邦理工的第三方论文,不是苹果产品更新,也不是智谱GLM官方发版。
他们把模型、硬件和时间预算都锁死,一边是开源最强的一类自动机器学习工程复杂外壳,一边是「轻量编码智能体」:模型直接读写文件、跑命令,在同一次长会话里改错。轻量这套他们叫Malena,工具很少。
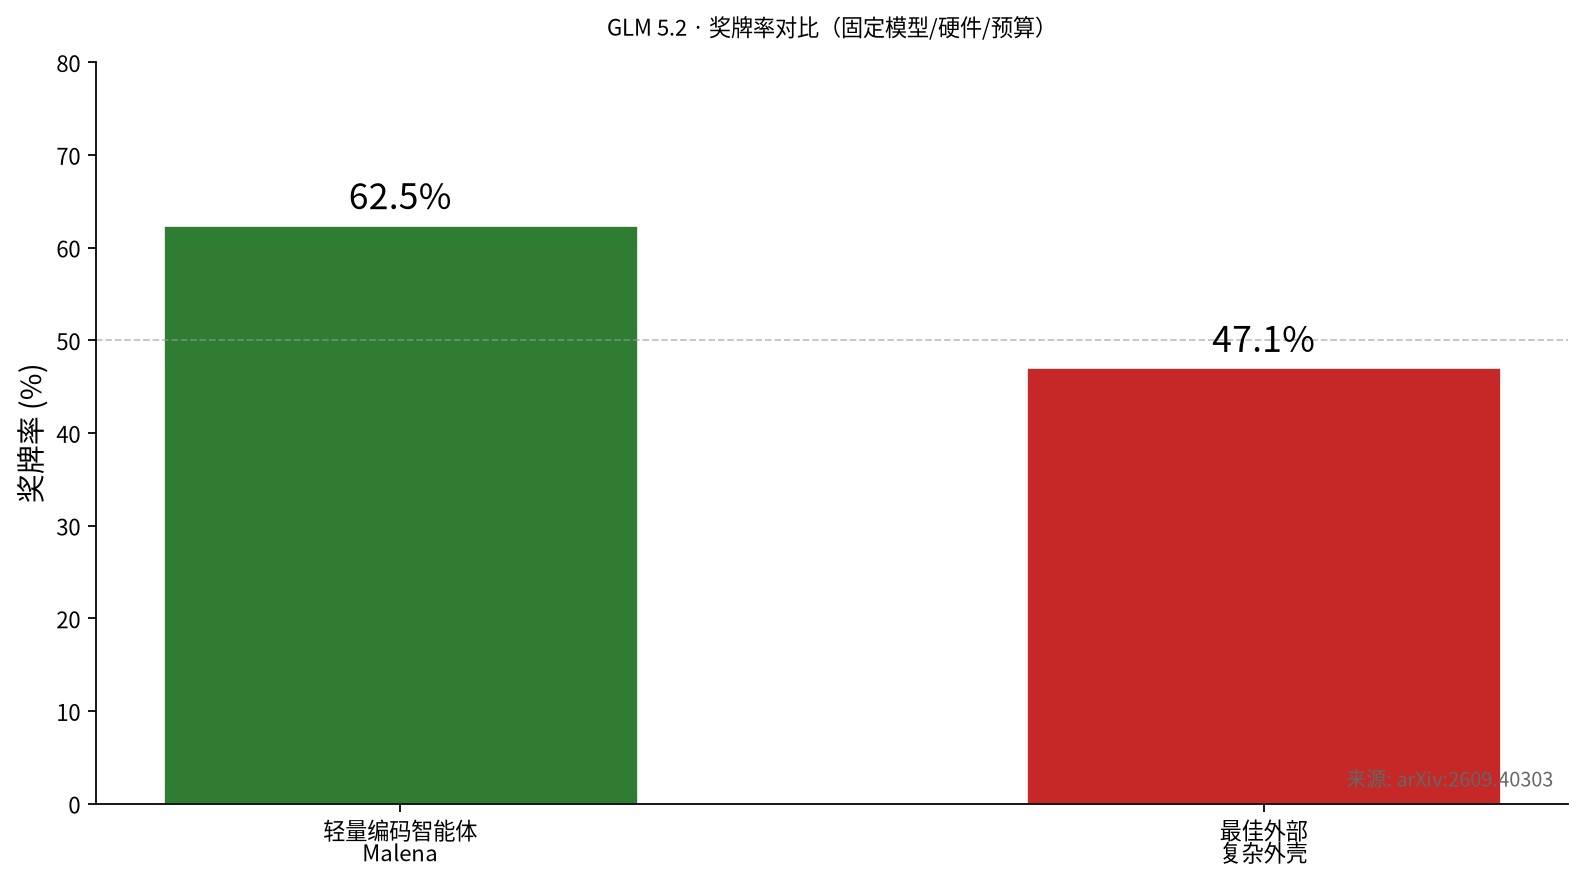
图1:GLM 5.2骨干下奖牌率——轻量编码智能体Malena约六成二,最佳外部复杂外壳约四成七(来源:arXiv:2609.40303)
用GLM 5.2当骨干时,Malena在62.5%的竞赛上拿到奖牌;同条件下测过的最佳外部复杂外壳只有47.1%。换别的骨干看,统计结果要么偏向Malena,要么两边奖牌率没有显著差异。也就是说:外壳叠得再花,未必打得过「强模型 + 轻量编码会话」。
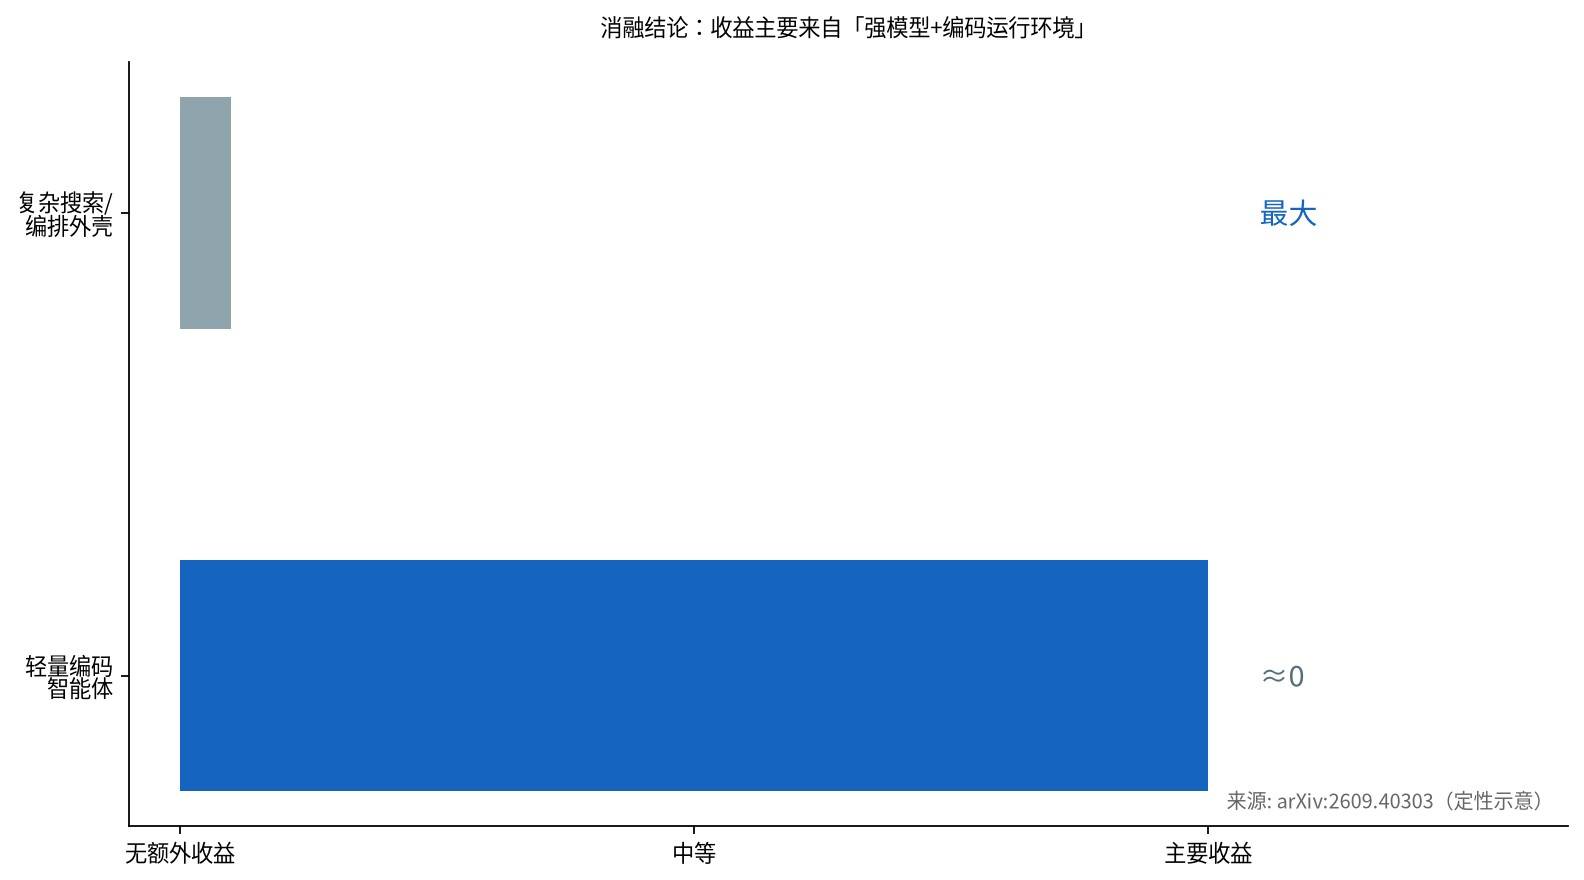
图2:模型与预算锁死时,开源最强一类复杂外壳相对轻量编码会话无明显优势(来源:arXiv:2609.40303)
论文消融也指向同一方向:给模型真正的编程运行环境,是收益最大的一步;再往上加搜索树、多智能体编排,在当前基准上几乎不再显著加分。骨干模型和运行时,才是主因。

图3:换骨干后统计要么偏向Malena,要么两边奖牌率无显著差异(来源:arXiv:2609.40303)
对普通人意味着什么?别一上来就堆多智能体编排。苹果联洛桑用数字说明——在公开机器学习工程竞赛主战场上,轻量编码会话配上强骨干,奖牌率可以压过复杂外壳。边界也坦陈:主战场是这类公开竞赛,部分区间置信区间偏宽,跨智能体协调也没完全展开。数字与结论按论文公布为准,出处见arXiv:2609.40303;配图按论文结论重画,图注按本篇重写。












